(一)背景
MyTopling 是基于 ToplingDB 的 MySQL,分叉自 MyRocks,ToplingDB 则分叉自 RocksDB,兼容 RocksDB 接口,从而 MyTopling 可以复用 MyRocks 的大部分成果。
ToplingDB 早已开源,MyTopling 也会于近期开源。
(二)rocords_in_range
MySQL 查询规划(Query Plan)中有一个操作:预估待查询的范围中有多少条数据。这个操作下推到存储引擎:
- 在 InnoDB 这样的 BTree 中,只需要看一下靠近根部的结点就可以了。
- RocksDB 中,通过 ApproximateSize(startKey, endKey) 来实现,得到 size 之后,再除以 KV 的平均尺寸就可以了,这个信息在 BlockBasedTable 通过二分搜索 SST 中的 BlockIndex 就可以得到
在 ToplingDB 中,只要兼容 RocksDB API,对我们自己的 SST 类型,就要实现自己的 ApproximateSize,然后所有上层代码就不用任何改动,从而复用整个 RocksDB 的生态系统。
ToplingDB 有两种 SST 必须实现 ApproximateSize:
2.1 Topling Fast Table
对 Fast Table,它使用的 CSPP 索引不是 BTree,CSPP 为了结构的紧凑和并发性能,其结点没有存储任何冗余信息,从而不能象 BTree 一样,仅通过靠近根部的结点就能得到近似的信息,好在 CSPP 的搜索极快,所以能快速地定位到具体的 Key,然后得到其中存储的 ValueOffset,就能计算出 Value 的 ApproximateSize 了,为了更准确,我们还得把 CSPP 索引所占的空间平摊到每条 KV 上,总体上还是比较简单的。
2.2 Topling Zip Table
对于 Topling Zip Table,情况稍微复杂一些,实际上,Topling Zip Table 的 ApproximateSize 是 (approximate)rocords_in_range 语义,只是因为 RocksDB 没有 rocords_in_range API,而整个 RocksDB 生态系统都用 ApproximateSize 来模拟 (approximate)rocords_in_range 语义,所以在 Topling Zip Table 中,为兼容 RocksDB 生态而实现的 ApproximateSize,饶了一个圈,又回到了应用更关心的 (approximate)rocords_in_range 语义……
Topling Zip Table 有多种索引类型,每种索引都支持 Key 的 Bytewise Order Rank,我们简称为 KeyRank:
- 对 NLT 索引,它支持精确的 KeyRank 操作,但这个操作很慢,比搜索还要慢 3 倍左右
- 对 UintIndex,它能以最简单快捷的方式,支持精确的 KeyRank 操作
- 对 带有 双数组 DoubleArray Trie Cache 的 FixLenKeyIndex
- 第一时间想到的方案是仅搜索 DoubleArray Trie Cache,这也是极快的操作,大多数情况下,只有 3~5 次(在 Cache 中随机的)内存访问
- 但是 DoubleArray Trie Cache 在不同路径上的深度可能不同,导致这样计算的(Approximate)KeyRank 不是按 Key 单调递增的
所以 NLT 和
FixLenKeyIndex 都需要优化 KeyRank,我们的处理方式也非常简单直接:对 Index Key 按一定比例(默认
0.1%)等间隔采样,然后放到一个定长 Key 数组中,当然这个数组不需要保存每条完整的 Key,只需要保存
最短可区分前缀就可以了。
(三)拖后腿的调用链开销
在 ToplingDB 中,性能墙最终总会收敛到 RocksDB,但是,要兼容复用 RocksDB 生态,这是必须付出的代价,哪怕是 ApproximateSize 这样的 API,也不例外。我们在火焰图中发现:
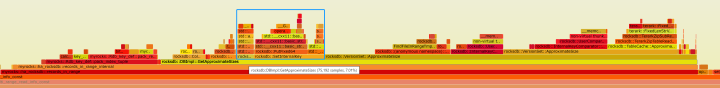
蓝框中的代码,竟然不可思议地是 这两行:
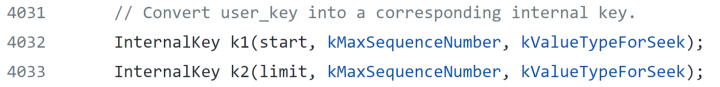
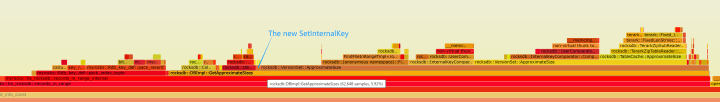
它占的时间,竟然比真正干活的代码还要多!好在这个问题很好解决,代码改动也不大,所以,我在 ToplingDB 中修改并验证后,顺便给 RocksDB 提了一个 Pull Request: Optimize.db impl.get approximate sizes by rockeet · Pull Request #10634。
这个改进,把 GetApproximateSize 的时间占比,从
7.01%降到了
5.91%, 降幅
16% :
(四)把 去虚拟化 进行到底
在上面那个火焰图中我们还可以看到,Compare 虚函数的调用开销也挺大的,这个问题我们之前通过 去虚拟化(devirtualization) 得到了数量级的性能提升。以之前的去虚拟化为基础,在这里 直接套用一下就行,然后我们看新的火焰图:

GetApproximateSize 的时间占比,从
5.91% 降到了
4.88% ,降幅
17%,跟初始版本相比,是从 7.01% 降到
4.88% ,降幅
30%!
ToplingDB 的核心竞争力,不光是云原生架构和算法的创新,还有这些看似不起眼的点点滴滴……
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70013015/viewspace-2913507/ ,如需转载,请注明出处,否则将追究法律责任。

