ToplingDB 分布式 Compact 中 Client-Server 交互,使用了 topling-zip 中的序列化框架,该序列化框架初版完成于 2006 年,后来命名为 febird 库在 google code 上开源,再后来 google code 停止服务,febird 迁移到 github,有段时间重命名为 nark,之后重命名为 terark,目前 topling-zip 中代码的 namespace 仍是 terark。从 2006 年至今,除 namespace 名称之外,该序列化框架的接口一直保持稳定,2016 年的时候,针对 C++11 进行了模板推导相关的大幅优化,但仍保持了接口的稳定。以下为原文正文,排版有轻微改动。
原文: febird.dataio vs boost.serialization 运行性能对比
作者: csdn-whinah
发表日期: 2009年04月06日
分类: C++序列化
评论: 4 条
阅读次数: 9,076 次
代码表示的是数据格式,DATA_IO_LOAD_SAVE 定义在 <febird/io/DataIO.h> 中。
对于
boost.serialization,
DATA_IO_LOAD_SAVE 的定义相当于:
#define DATA_IO_LOAD_SAVE(Class, Members) \ friend class boost::serialization::access; \ template<class Archive> \ void serialize(Archive & ar, const unsigned int version) \ { ar Members; }(一)数据格式
struct MyData1 {
    uint32_t a, b, c;
    uint32_t d[5];
    DATA_IO_LOAD_SAVE(MyData1, &a&b&c&d)};struct MyData2 {
    uint32_t a, b, c, d;
    MyData1 e;
    DATA_IO_LOAD_SAVE(MyData2, &a&b&c&d&e)};struct MyData3 {
    uint32_t a, b, c;
    uint32_t d;};DATA_IO_DUMP_RAW_MEM(MyData3)struct VarIntD {
    var_uint32_t a, b, c, d, e, f;
    VarIntD() {
        a = 127;
        b = 128;
        c = 128*128;
        d = 128*128*128;
        e = 128*128*128*128;
        f = 1;
    }
    DATA_IO_LOAD_SAVE(VarIntD, &a&b&c&d&e&f)};typedef pair<MyData2, MyData3> MyData23;
(二)写入性能(序列化)
写入,即
序列化(serialize),
保存(save)
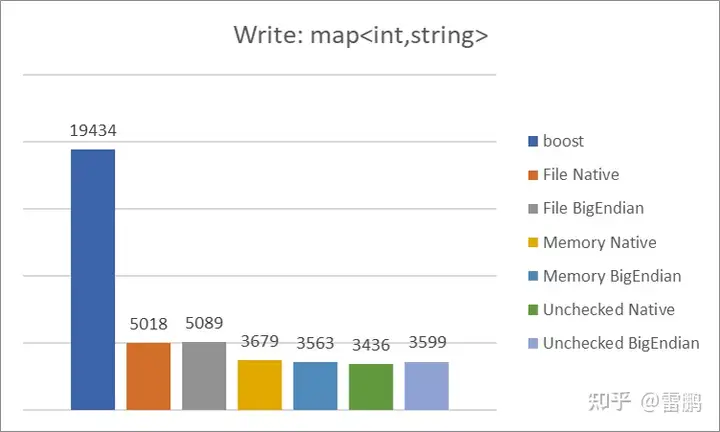
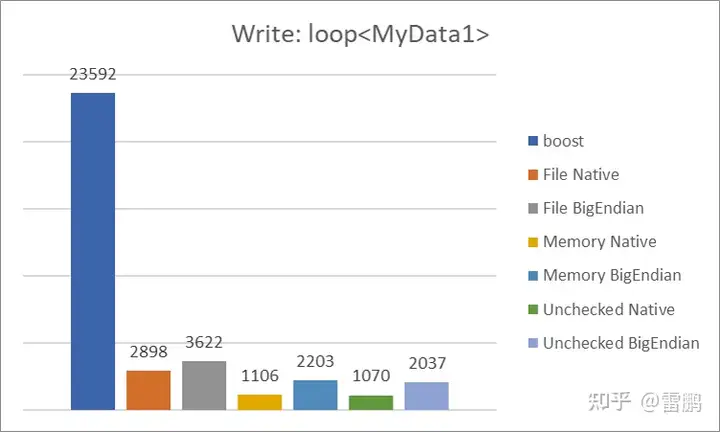
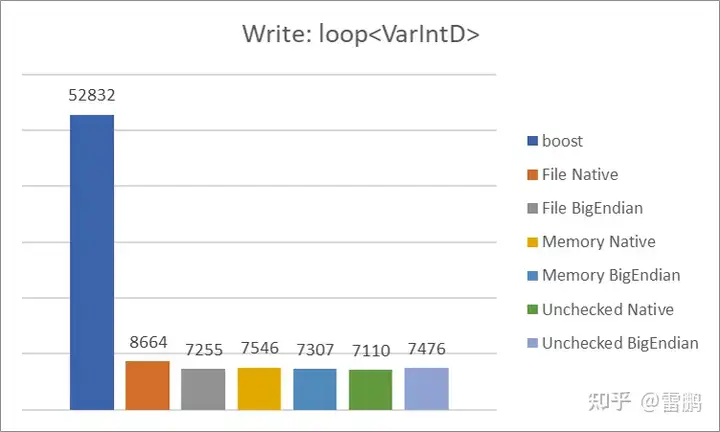
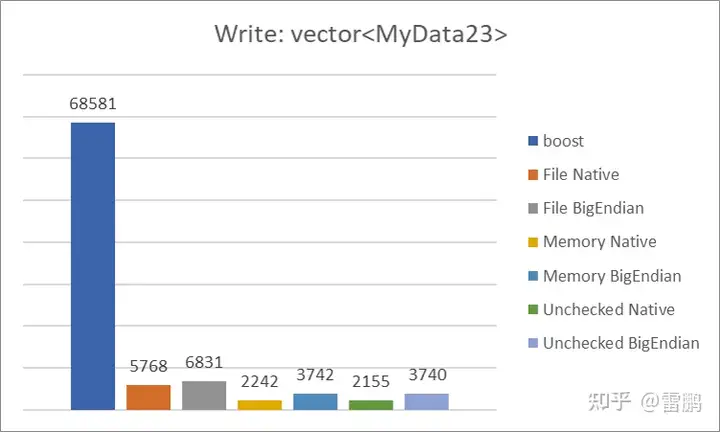
表1:
写入性能,时间单位是
微秒(us),loop 表示相同的数据重复写
count 次,而不是写 .size() 个不同的数据
比 boost 快 10 倍以上的项目标红,快
30 倍以上的
粗体红
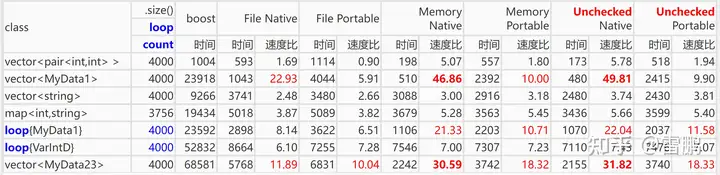
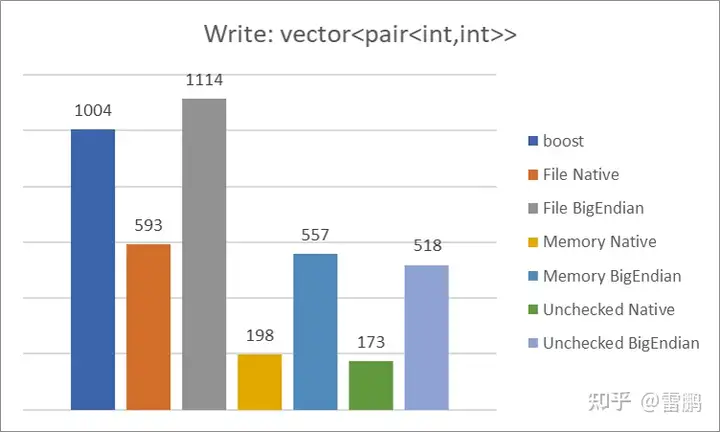
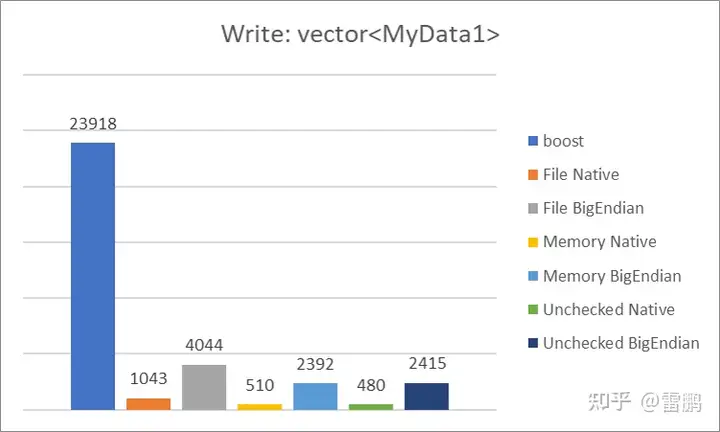
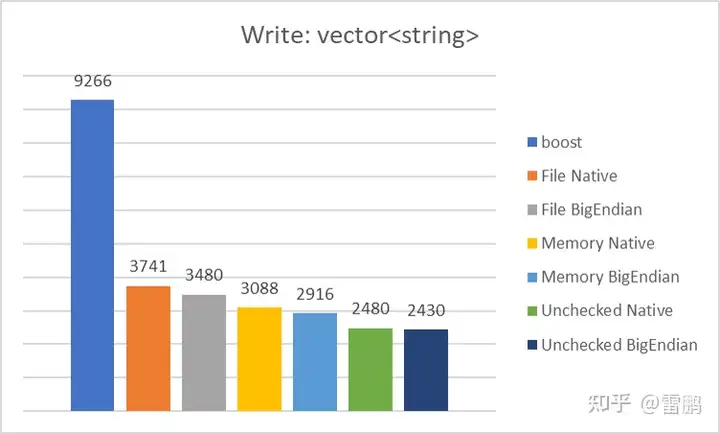
取该表格中的 时间项,生成柱状图如下(越小越好):
(三)读取性能(反序列化)
读取,即
反序列化(deserialize),
加载(load)
表2:
读取性能,时间单位是
微秒(us), loop 表示相同的数据重复读 count 次,而不是读 .size() 个不同的数据
比 boost 快 20 倍以上的项目 标红,快
50 倍以上的
粗体红
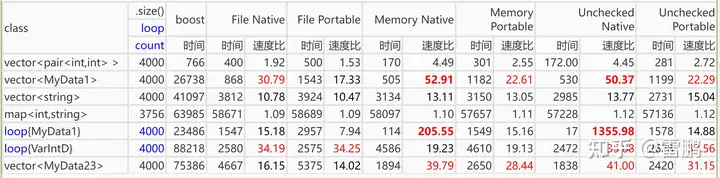
其中,
205.55 和
1355.98 这两个数字,我自己也非常吃惊,甚至感觉有点不可思议,但是,这就是实测结果!
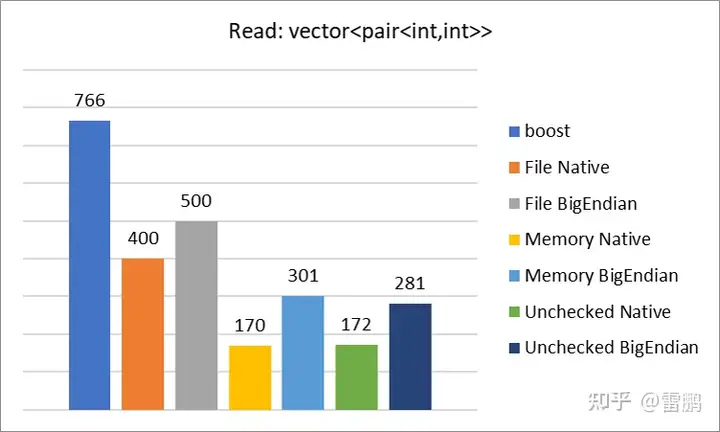
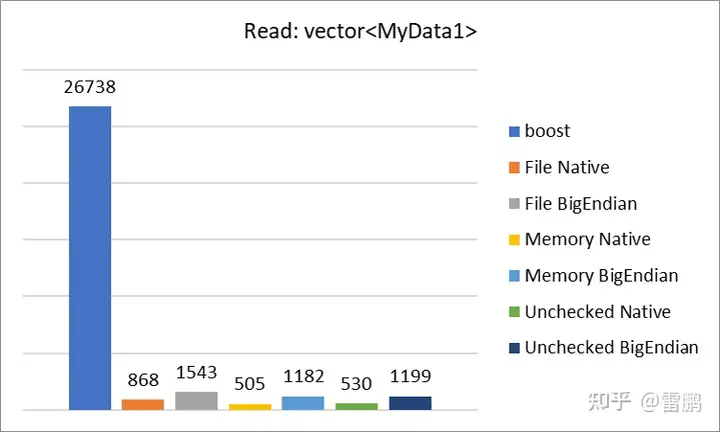
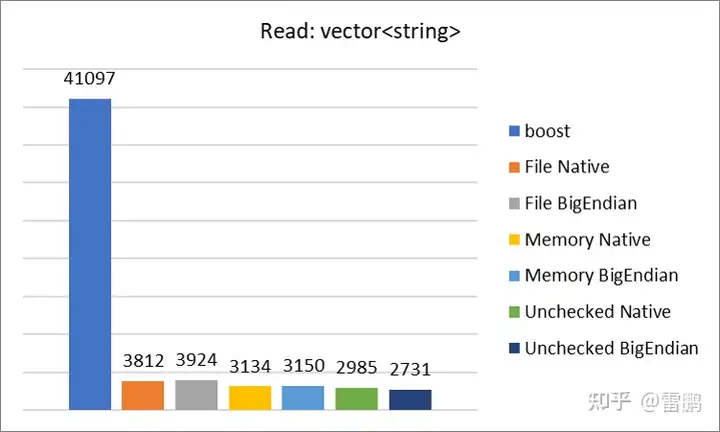
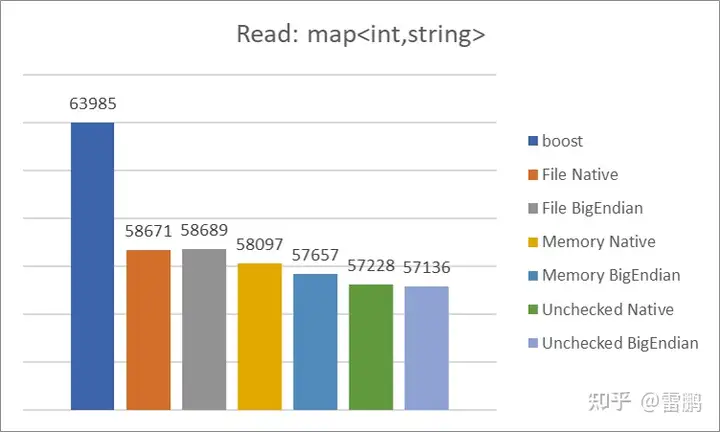
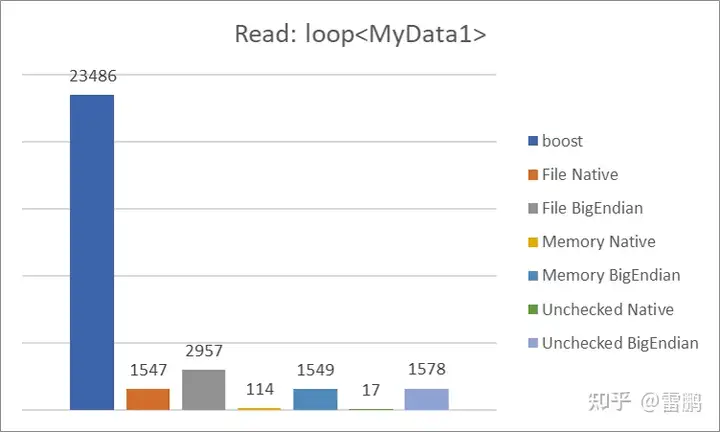
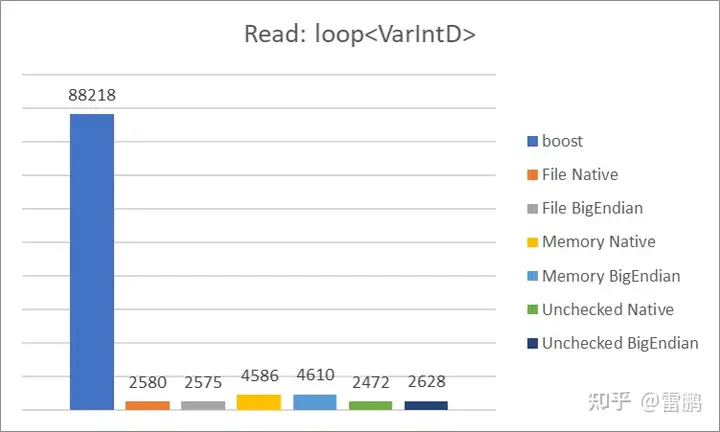
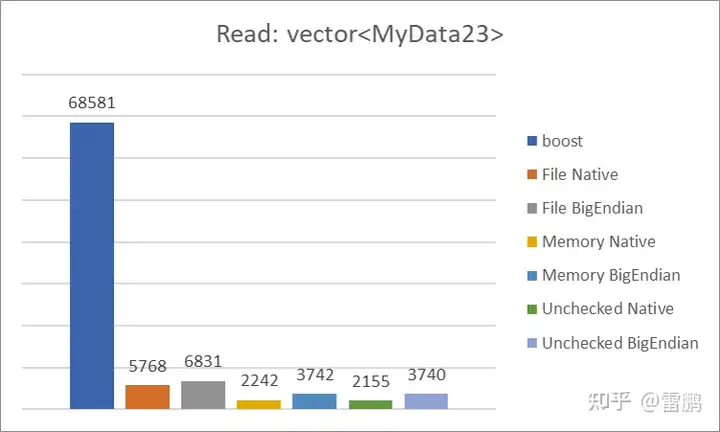
取该表格中的
时间项,生成柱状图如下(越小越好):
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70013015/viewspace-2924636/ ,如需转载,请注明出处,否则将追究法律责任。

