MultiGet IO 并发在 ToplingDB 中的协程实现,以及在 MyTopling 中的落地应用
(一)背景
三年前,我 用 Fiber(协程) 实现了 TerarkDB 中 MultiGet 的 IO 并发,因为 TerarkDB 分叉自 RocksDB 5.18,其 MultiGet 实现简单直接,所以我可以用 10 行代码就对其完成 Fiber(协程) 改造,并获得数量级的性能提升。
但是在 ToplingDB 中,为了充分借助社区力量,吸收社区成果,我们总是在 RocksDB 的最新版上展开工作,基本上每一两个月就会合并一次 RocksDB 上游代码。然而最近两三年,上游 RocksDB 对 MultiGet 进行了 大规模的修改:
- 1.针对每个 SST 的 MultiRead,在
FSRandomReadFile中增加了 MultiRead 接口 - 1.因为 MultiGet 中多个 Key 落到同一个 SST 的概率太低,从而对单个 SST 的 MultiRead 收益太小
- 2.所以 RocksDB 又在
FSRandomReadFile中增加了ReadAsync接口 - 3.MultiGet 的整个执行链路都进行了相应修改以支持
MultiRead和ReadAsync - 1.其中用到了
folly::Coroutine和 C++20 的 Coroutine - 2.默认情况下
Coroutine选项是关闭的(控制 宏USE_COROUTINES) - 3.Coroutine 选项打开时,同时会打开
USE_FOLLY - 4.通过另一个宏
WITH_COROUTINES来生成整个调用链路上的所有相关函数的异步版: -
1.TableCache::MultiGet的异步版MultiGetAsync -
2.Version::MultiGetFromSST的异步版MultiGetFromSSTAsync -
3.TableCache::MultiGet的异步版MultiGetAsync -
4.BlockBasedTable::RetrieveMultipleBlocks的异步版RetrieveMultipleBlocksAsync - 4.在调用实际干活的 MultiGet 之前,还需要复杂的 Prepare 操作
- 1.构造专门的
MultiGetContext对象,调用链上的函数都增加MultiGetContext::Range参数 - 2.MultiGet 增加了额外的参数 is_sorted,表示要 MultiGet 的多个 Key 是否已经排序,如果未排序,就要先进行排序
- 5.就连不需要 IO 的 MemTable 也增加了 MultiGet 接口
所有这些下来,相关的代码修改 数以万行计,并且因为不必要的计算太多,对性能有较大影响,在 Cache 命中的情况下(不需要 IO),反而对性能有很大的负面影响。
BTW: 甚至于连 Linux kernel io_uring 的作者 Jens Axboe 也 给 RocksDB 当外援 :

(二) ToplingDB 怎么办
ToplingDB 中有三种 SST:
| Topling Fast Table(SST) | 极速,一般常驻内存,并且仅用于 L0 和 L1 |
|---|---|
| Topling Zip Table(SST) | 使用可检索内存压缩算法,直接在压缩的数据上执行搜索。
压缩率和性能都远高于 RocksDB BlockBasedTable(不管它是用 zstd 还是 gzip/bzip)。 用于 L2 及更下层 |
| Topling Auto Sort Table(SST) | 允许输入的数据无序,用于 MyTopling(MySQL on ToplingDB) 中索引创建以及批量加载 |
在这三种 SST 中,只有 Topling Zip Table 需要 IO 异步(实现 IO 并发),如果也按照 RocksDB 那一套来实现,会有诸多问题:
- 1.如前所述,Cache 命中时,性能反而大幅降低
- 2.需要的代码修改太多,RocksDB 有全球顶级的强大的研发团队,即便是走在错误的道路上,也可以堆人,堆资源,硬是凭借大力出奇迹,而我们显然不能那样干
- 3.RocksDB 的这个异步机制仍在 Experiment 状态,不光稳定性存疑,而且处在不断的变化演进中,在它这个异步框架内实现,就要带着它这个包袱,它有 Bug,我们也遭殃,它改了接口,我们也得跟着改
按照我 事半功倍的信条: 改最少的代码,获最大的收益,这个收益,不仅仅是性能上的收益,还有代码的模块化、可读性、可维护性、可复用性……
所以,经过仔细思考与权衡,ToplingDB 的 MultiGet 还是得由我自己来亲自实现。
(三)实现方案
协程分无栈协程和有栈协程,无栈协程理论上性能更好,但是一来需要编译器支持,二来 需要修改全链路代码。
RocksDB 的 Async IO 实现其实是个有栈协程和无栈协程的混合体。
编译器支持还好说,现在主流编译器(gcc,clang,msvc)都支持 C++20 的协程,但是 修改全链路代码这是不能忍受的。
所以我们必须使用有栈协程,仍然延续之前 TerarkDB 的选择: boost fiber(再加上 我的改进 )。
有栈协程理论上性能不如无栈协程,但是凭借优良的实现,其性能代价(协程切换)已经低到大致等同于一个函数调用。但有栈协程最大的优势其实是几近完美的兼容性:不需要编译器支持,不需要修改现有代码,甚至连现有二进制库都可以完全复用。
io 模型上,三年前使用的是 linux aio,现在自然要使用 io_uring,但是对外的函数接口没变,依然是:
ssize_t fiber_aio_read(int fd, void* buf, size_t len, off_t offset);
这个函数原型跟 posix pread 完全相同:
ssize_t pread(int fd, void *buf, size_t count, off_t offset);
只要上层代码开启多个 fiber 执行 fiber_aio_read,就自动获得了 io 并发的能力,在 MultiGet 中:
 if (read_options.async_io)
    gt_fiber_pool.update_fiber_count(read_options.async_queue_depth);
 size_t memtab_miss = 0;
 for (size_t i = 0; i < num_keys; i++) {
   if (!ctx_vec[i].done) { // was not found in MemTable, try get_in_sst     if (read_options.async_io)
       gt_fiber_pool.push({TERARK_C_CALLBACK(get_in_sst), i});
     else
       get_in_sst(i);
     memtab_miss++;
   }
 }
 while (counting < memtab_miss) gt_fiber_pool.unchecked_yield();
关键代码,在 fiber_pool 中执行 get_in_sst(i):
gt_fiber_pool.push({TERARK_C_CALLBACK(get_in_sst), i});
get_in_sst
调用 Version::Get(这个函数有 14 个参数,在 RocksDB 中是稀疏平常),完全复用了现有代码,Version::Get 最终会调用到
TableReader::Get,例如 BlockBasedTable::Get,或者 ToplingZipTable::Get,在 ToplingZipTable 中:
static const byte_t* // remove error check for simplicityFiberAsyncRead(void* vself, size_t offset, size_t len, valvec<byte_t>* buf) {
  buf->resize_no_init(len);
  auto self = (ToplingZipTableReader*)vself;
  if (auto stats = self->stats_) {
    auto t0 = qtime::now();
    fiber_aio_read(self->storeFD_, buf->data(), len, offset);
    auto t1 = qtime::now();
    stats->recordInHistogram(SST_READ_MICROS, t0.us(t1));
  } else {
    fiber_aio_read(self->storeFD_, buf->data(), len, offset);
  }
  return buf->data();}
FiberAsyncRead 是个回调函数,会被 topling-zip 的抽象存储接口 BlobStore::fspread_record_append 调用。
(四)fiber_aio_read 实现原理
接下来,我们看 fiber_aio_read 是怎么使用 fiber 和 io uring 的,io uring 的原理和用法,有很多非常优秀的介绍文章,所以这里我就不再唠叨了。我们把关注点放在 fiber_aio_read 本身。
必须注意:只有在一个线程中的多个 fiber 中调用 fiber_aio_read,才能起到预期的 IO 并发的效果,仅仅把 pread 改成 fiber_aio_read 是不行的!
fiber_aio_read 核心代码(为简化起见,省略了错误处理 ):
intptr_t exec_io(int fd, void* buf, size_t len, off_t offset, int cmd) {
    io_return io_ret = {nullptr, 0, 0, false};
    io_uring_sqe* sqe;
    while ((sqe = io_uring_get_sqe(&ring)) == nullptr) io_reap();
    io_uring_prep_rw(cmd, sqe, fd, buf, len, offset);
    io_uring_sqe_set_data(sqe, &io_ret);
    tobe_submit++;
    m_fy.unchecked_wait(&io_ret.fctx);
    return io_ret.len;
}
可以看到,在获取到 sqe 并设置好内容之后,就调用了
m_fy.unchecked_wait,这个函数的作用是挂起当前 fiber,把当前 fiber 的 context 指针
放到 io_ret.fctx 中,其作用相当于把当前 fiber 放入 boost fiber 的等待队列(但是代价更低,这个是我对 boost fiber 的一个改进),然后切换到
下一个 fiber 继续执行。这里的下一个 fiber,就是线程的主 fiber,于是代码回到 MultiGet 中:
gt_fiber_pool.push({TERARK_C_CALLBACK(get_in_sst), i});的下一行,从而继续把下一个
get_in_sst(i) 放到另一个 fiber 中执行,直到 fiber_pool 中的 fiber 数量上限,或者到达 MultiGet 中的:
while (counting < memtab_miss) gt_fiber_pool.unchecked_yield();这两种情况下都会进入 fiber_aio_read 中的另一段代码(为简化起见,省略了错误处理):
void io_reap() {
    if (tobe_submit > 0) {
      int submitted = io_uring_submit_and_wait(&ring, io_reqnum ? 0 : 1);
      tobe_submit -= submitted;
      io_reqnum += submitted;
    }
    while (io_reqnum) {
      io_uring_cqe* cqe = nullptr;
      io_uring_wait_cqe(&ring, &cqe);
      io_return* io_ret = (io_return*)io_uring_cqe_get_data(cqe);
      io_ret->len = cqe->res;
      io_uring_cqe_seen(&ring, cqe);
      io_reqnum--;
      m_fy.unchecked_notify(&io_ret->fctx);
    }
}
有个单独的 fiber 执行执行 io_reap,这其中的 IO 并发来自于
io_uring_submit_and_wait,在其它 fiber (gt_fiber_pool.push 触发的,调用 fiber_aio_read 的 fiber) 中每个 fiber 已经创建了一个 sqe,到这里就通过
io_uring_submit_and_wait 把那些 sqe 一次性全部提交,io uring 就在 linux 内核中
并发执行这些 io!
io_uring_submit_and_wait 返回后,我们就开始收割 io 执行的结果,对于每一个 io 执行的结果(我们自定义的io_return),我们切换回(
m_fy.unchecked_notify(&io_ret->fctx))这个 io 所在的 fiber 继续执行。
以这样的方式,整个执行链路上的代码无需任何改动,具体到我们这个 MultiGet 实现,就是 get_in_sst(i) 调用的 Version::Get, Version::Get 的现有代码被我们完全复用了,没有任何改动!对比原版 RocksDB 的 MultiGet 实现,需要的工程量,算上 fiber_aio_read 本身的实现和我对 boost fiber 的改进,百分之一都不到!
(五)实测效果
我们先用 db_bench 进行测试(将
ReadOptions::async_io 设为 true 或 fales):
./db_bench -json sideplugin/rockside/sample-conf/lcompact_enterprise.yaml \
           -benchmarks=multireadrandom -num 100000000 -reads 20000 \
           -multiread_batched=true -multiread_check=false \
           -multiread_async=true -multiread_async_qd=128 -batch_size=128
db_bench 测试的数据是
10亿条,数据总量
110G,用
-benchmarks=seqfill 准备数据,使用 ToplingZipTable 压缩后为
16G。
对 PageCache
全命中的测试,我们使用的是 64 核 768G内存的物理机,存储是本地 NVMe XFS 文件系统;
对 PageCache
不命中的测试,我们使用了一台 4 核 4G 的 VMware 虚拟机,并且通过 NFS 访问远端 NVMe XFS 文件系统。
测试结果如下:
| PageCache 全命中 | PageCache 不命中 | |
|---|---|---|
| async_io = true | 3.845 micros/op
260067 ops/sec 0.077 seconds 19968 operations; 28.8 MB/s (19968 of 19968 found) |
51.138 micros/op
19554 ops/sec 1.021 seconds 19968 operations; 2.2 MB/s (19968 of 19968 found) |
| async_io = false | 3.829 micros/op
261142 ops/sec 0.076 seconds 19968 operations; 28.9 MB/s (19968 of 19968 found) |
622.804 micros/op
1605 ops/sec 12.436 seconds 19968 operations; 0.2 MB/s (19968 of 19968 found) |
可以看出,在 PageCache 全命中的场景下,ToplingDB async_io 的 MultiGet 和同步 IO 几乎没有差别,而PageCache 不命中的情况下,相差了 11 倍!并且,在 PageCache 全命中的情况下,几乎没有性能退化(RocksDB 的 Async IO 实现在 Cache 全命中的情况下性能有不少退化,见下面截图)。
再看下 RocksDB 的测试结果(摘自 RocksDB 官方提交记录):
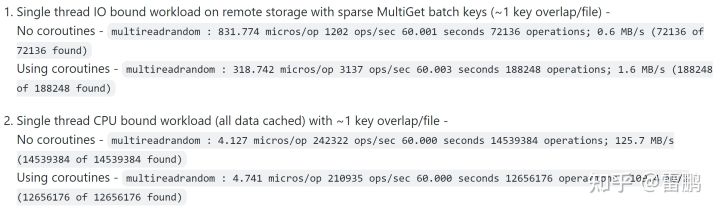
ToplingDB 的简单实现,性能远高于 RocksDB 数以万行的复杂实现!这就是 大道至简, 事半功倍!
(六)应用到 MyTopling MRR
MyTopling 是把 MySQL 架构在 ToplingDB 之上的云原生数据库,拥有 ToplingDB 的分布式 Compact,以及 CSPP 事务引擎、Topling Zip 可检索内存压缩……,自然也能充分地利用 ToplingDB 的 MultiGet,这在 MySQL 的世界中叫做 MRR(Multi Range Read),简单说就是在一些 Query 中,需要访问多条记录,MySQL 执行规划就认为,先拿到多条记录(ROW)的主键,把这些主键一股脑下推到存储引擎层,由存储引擎来决定如何用尽可能高效的方式拿到这些记录(ROW),最简单直接的 Query 就是:
select * from SomeTable where id in (..... /* 比如这里有 1000 个 ID */);如果存储引擎不做任何优化,一次一条地拿就可以了,例如对于 MEMORY 存储引擎,因为不牵涉到 IO,一次拿一条,简单直接。
但是对于 InnoDB 或 MyTopling 存储引擎,几乎必然会有 IO 操作,MRR 就提供了一个优化 IO 的机会。在 MyTopling 中,自然就是 ToplingDB 的 MultiGet 了,我们用 sysbench 测试,通过设置适当的命令参数,构造了一些会产生 IO,并且触发 MRR 的 Query:
sysbench select_random_points run --tables=1 --table_size=200000000 \
         --mysql-user=***** --mysql-password=***** --mysql-host=***** \
         --mysql-port=3306 --mysql-db=***** --time=300 --threads=10 \
         --mysql_storage_engine='rocksdb default charset latin1' \
         --rand-type=uniform --random_points=256
用这个 sysbench 测试,数据库服务器统一使用 8 核 32G 的规格,对比了几个(在阿里云上运行的)主流 MySQL (变体)及不同存储配置的指标:
| QPS 对比 | 线程数=4 | 线程数=10 | QPS 对比 | 线程数=4 | 线程数=10 |
| 网络存储 MyTopling | 132 | 193 | 本地 SSD MyTopling | 750 | 1243 |
| 网络存储 MyRocks | 17 | 29 | 本地 SSD MyRocks | 162 | 351 |
| 网络存储 InnoDB | 14 | 34 | 本地 SSD InnoDB | 158 | 302 |
| RDMA存储 PolarDB | 116 | 285 | PolarDB 无本地 SSD |
|
|
注:QPS 看着很低,但一次读 256 条,所以 QPS 乘以 256,才是每秒钟读的数据条数。
从中可以看到,不管是在网络存储上,还是在本地 SSD 文件系统上,MyTopling 优势特别突出。
跟 PolarDB 相比,MyTopling 使用的网络存储是阿里云 NAS,自然没法跟 PolarDB 的 RDMA 存储相比。4 线程时,MyTopling 相比 PolarDB 还勉强有微弱的优势(132 <=> 116),这纯粹是靠软件上的并发 IO 取胜的,到10 线程时,PolarDB 硬件上的优势就无法用软件取胜了!
但是本地 SSD 版,MyTopling 就是一枝独秀了!
用火焰图来看,一目了然:

我们先聚焦到 MySQL 对 MultiGet 的调用:
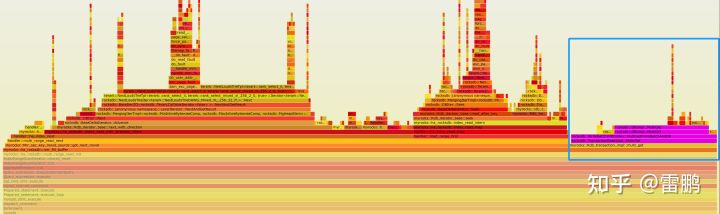
图中蓝框之外的部分是为 MRR 准备数据(ID主键),蓝框之内的,是线程主 fiber 中的 MultiGet,我们再聚焦:
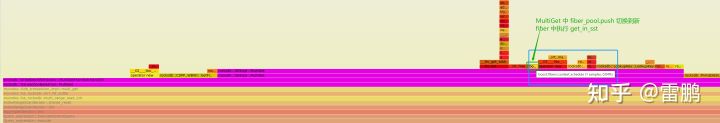
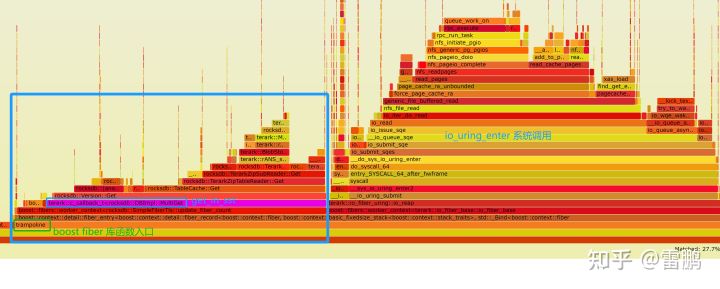
MultiGet 中通过 fiber_pool.push 切换到 fiber_pool 中的 fiber 执行 get_in_sst,所以,这个栈中是看不到 get_in_sst 的,get_in_sst 是在第一张图右边的:
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70013015/viewspace-2912182/ ,如需转载,请注明出处,否则将追究法律责任。

