1、 公司介绍
枢衍是北京长远佳信息科技有限公司旗下品牌,聚焦 AI原生自主数据工程,打造面向企业的“AI数据工程团队”。依托数据编织与性能加速能力,结合数据科学模型和智能体协同,连接企业私域数据与AI应用,支持从传统数仓治理与人工ETL向AI原生数据工程转变。
枢衍深耕医疗健康、金融服务、数字政务和能源制造等行业,提供从底层数据基础设施到 AI-Ready的端到端AI数据工程服务,支持企业核心业务洞察与智能决策。
2、产品服务介绍:
枢衍提供DataAI Infra, 以 “1个Model+2项Skills”为核心 ,将数据科学模型Data Science Model与AI Fabric、AI Acceleration两项数据技能结合,由AI数据工程系统统一组织调用,覆盖数据接入和加工建模,并衔接治理管控与服务运维。
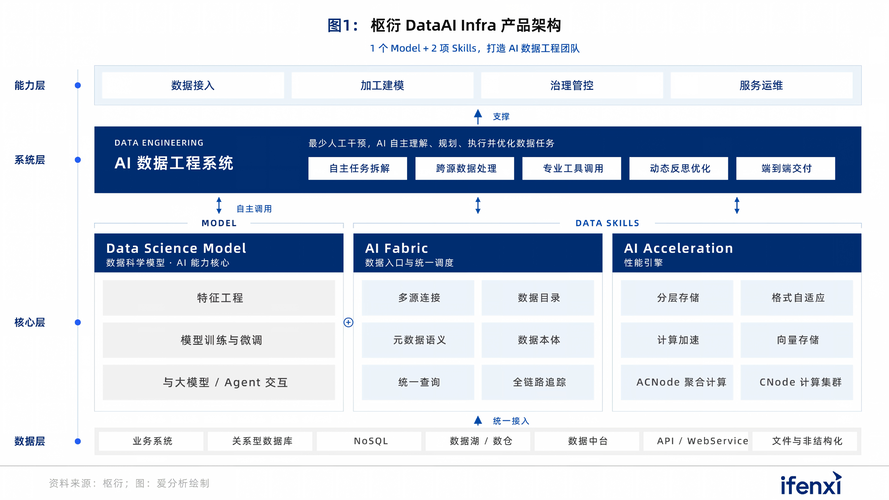
在数据层,平台面向企业已有数据环境做统一接入: 既包括承载业务流程的业务系统及其背后的关系型数据库,也包括 NoSQL 存储与既有的数据湖、数据仓库; 已建数据中台的环境,可将中台作为逻辑数据源纳入。接入方式上,除数据库连接外,也可通过 API、WebService 获取外部系统供给的数据,影像、文档等非结构化数据经文件通道读取。各类数据均保留在原位置,不要求预先集中搬迁,接入后由上层统一调度。
AI Fabric承担数据入口与统一调度职责,通过多源连接和统一查询组织分散数据。平台结合数据目录与元数据语义,描述数据的位置、结构及业务含义,并通过数据本体组织关联关系,利用全链路追踪保留数据处理依据。结合虚拟化数据编织,平台可以在获得源系统访问授权的条件下使用原有数据,降低对预先集中搬迁和重复整合的依赖。
Data Science Model是平台的AI能力核心,承担特征工程以及 个性化 模型训练与微调,并与大模型或其他Agent交互。 数据 科学 模型结合数据结构、业务语义和行业规则,将用户需求转化为具体的数据处理任务,支持多模态数据加工及高质量数据准备,为科研分析和模型训练等场景提供数据基础。
AI Acceleration作为性能引擎,提供分层存储与格式自适应能力,结合计算加速和向量存储支持不同类型的数据任务。 其中,ACNode承担聚合计算,CNode计算集群提供计算支撑。该模块与模型及数据编织能力协同,支持识别数据使用中的性能瓶颈,优化数据访问与处理配置。
在系统层,AI数据工程系统根据用户需求拆解 数据 任务,组织跨源数据处理并调用专业工具,结合执行结果进行反思优化,形成端到端的数据成果交付。AI承担可自动化的工程操作,人员则参与业务规则确认、关键成果审核及异常处置,使自动化执行与人工控制相结合。
面向使用者,DataAI Studio提供自然语言交互和工具使用入口。业务人员可以描述需求或提交需求表,技术人员也可以通过MCP服务及工具套件开发工作流与智能体。数据成果通过API等方式对接企业已有BI和第三方应用。
在交付方式上,枢衍采用AI BPO模式,将平台部署与持续数据工程服务结合。 前期评估客户数据基础及资源配置,完成接入和部署;后续跟进新增系统及数据变化,维护相关语义与血缘,并持续更新模型和技能包,支持企业数据工程能力随业务需求演进。
3、厂商评估:
爱分析认为,枢衍在 AI 数据工程市场的主要特点, 是把数据工程从项目制的交付方式转为持续供给: 以 数据编织与语义理解作为基础,通过Agent协作承接数据准备和持续供给任务。 其产品定位聚焦数据团队自身的工作效率,将重复性工程劳动转交给AI,让人员更多参与需求确认、规则设计和成果审核。
一、主动数据感知与虚拟化编织结合,减少数据整合和资产维护负担
企业推进AI应用时,最先遇到的往往不是模型能力,而是数据供给形态与合规要求之间的错配。AI需要相对集中的语义化输入,而数据分散在业务系统、关系型数据库、数据湖与数据仓库中,结构、口径和更新方式各不相同;医疗、金融、政务等机构还要求数据不出院、不出域,集中式整合在合规上难以推进。传统抽取以批量调度为主,时效也很难支撑实时决策。
根据爱分析调研,枢衍通过AI解析源系统结构,生成分类及语义标签,建立数据资产目录 ;数据访问采用虚拟查询,在获得源系统授权的条件下直接读取原有数据,不做物理搬迁。新增系统接入后,平台持续识别其数据结构,维护与既有资产的关联及血缘关系,使资产目录能够参与后续任务,而非仅供人工检索。据厂商介绍,其连接器覆盖 200余个数据源,实际可用范围仍取决于源系统的开放程度与授权条件。
这一方式适合存量系统较多、合规约束较强、且持续产生新数据需求的机构。 客户通常在三种情况下开始评估此类方案:一是监管或行业要求数据不出域,集中式方案不可行;二是业务要求实时响应,批量调度失效;三是 AI项目数量增加,而数据工程师供给不足。需要注意的是,虚拟化访问仍以数据访问授权与系统连接条件为前提,跨系统查询的实际性能会受到源系统负载的影响。
二、语义理解与按需加工结合,降低业务需求转化为数据任务的成本
数据接通后,业务术语与底层字段之间仍存在距离。科研或分析指标发生变化时,业务人员通常需要与技术团队反复确认,再修改加工流程,数据准备容易成为业务推进的瓶颈。
枢衍将语义标签、数据关联及行业规则纳入DSM,结合用户需求开展数据提取和加工。业务人员既可以通过自然语言提出任务,也可以将研究指标整理为模型可理解的需求表,减少业务描述与工程实现之间的转换工作。
以医疗科研场景 为例, 面对病历文本、影像等不同类型的数据,先完成资产梳理及语义组织,再根据研究指标提取相关数据,形成后续可用的数据成果。需求变化时,可以复用已有数据基础,减少重新协调多个系统和重复开发的工作。专业规则及结果有效性仍需业务人员审核。
三、将性能优化纳入数据工程链路,兼顾数据准备与后续使用
数据治理完成后,如果查询缓慢或计算任务无法稳定执行,业务人员仍难以持续使用。对于历史数据量较大、分析需求变化频繁的客户,性能问题还会增加数据团队的排查和维护负担。
枢衍将性能优化与数据加工结合,由模型辅助识别访问和计算瓶颈,推荐相应的优化配置,使性能问题能够在数据使用过程中被发现和处理。加工成果再通过API及工具服务对接上层应用,减少不同应用分别组织数据处理流程的工作。
这种能力组合使数据工程的交付范围从 “准备一批数据”延伸到支持持续使用。 同一套数据基础可以服务已有BI,也可支持新增Agent应用。具体性能表现取决于源系统、数据规模及计算环境,需要结合客户任务验证。
四、以 AI BPO持续服务,承接数据环境变化带来的长期工作
数据工程并非一次交付。系统新增、字段变化和业务规则调整,都会持续产生维护需求。如果客户仅获得软件工具,仍需自行组织人员完成这些工作。
枢衍通过AI BPO提供持续服务,将数据接入后的变化识别、 个性化 模型更新及技能维护纳入服务过程。根据访谈介绍,其模型和技能包会持续迭代,客户能够在使用过程中获得更新后的能力。
这一模式的价值,在于将产品能力与长期工程支持结合,使客户的成本结构由固定人力投入转向按需支出,减轻客户自行配置专门团队的压力。 对于数据需求持续增长的机构,平台可承担重复性和工程复杂度高的工作 , 人员则集中处理业务规则及异常情况。其长期效果应结合自动化任务占比、持续服务投入和客户实际使用情况衡量,不能简单等同于完全替代数据团队。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69993021/viewspace-3187599/ ,如需转载,请注明出处,否则将追究法律责任。

