大厂的Token业务正在进入最好的时代。火山引擎等头部云厂商的Token收入ARR已迈过百亿关口,正向千亿规模进发 。 百倍增长靠的是生态繁荣 , 更多开发者在云上构建应用,更多应用消耗更多Token。
与此同时,这也是大厂Token业务最危险的时刻 , 模型能力越强,Token调用量越大,生态伙伴的生存空间反而越窄。爱分析观察到, 支撑 Token 增长的生态正在被 云大厂自身的模型 吃掉。
云大厂每一次模型迭代,都在系统性地吸收开发者在应用层验证过的价值。 爱分析 将这一矛盾定义为 Token业务的偷猎者悖论 : 云大厂Token增长依赖生态繁荣,但模型 迭代 的 内 在逻辑就是消化生态已验证的需求, 偷猎者由此陷入两难境地 。
01 Token增长靠应用繁荣,模型迭代却在吸收应用
云大厂Token业务面临一个根本矛盾。要增长,就得有足够多的开发者在平台上构建应用、创造Token消费场景。但 一旦场景验证成功,模型就会依靠平台积累的数据,将应用能力迭代到下一版模型之中,进而消灭了这部分开发者的价值。
此刻的云大厂就是典型的 偷猎者 。所谓偷猎者, 就是同时拥有用户数据和自建应用能力的主体。
用户数据是模型迭代的燃料。每一次用户与模型的交互都在标注 ——什么需求成立、任务怎么拆、需要调用什么知识。比如用户使用视频生成,每一次调整提示词是在标注创作偏好,每一次重新生成是在标注质量标准,每一次放弃输出是在标注需求边界。 这些 交互数据 会 进入下一轮 模型 训练,模型就学会了更精准地响应。
自建应用的能力是另一块拼图。拥有自建应用意味着可以直接运营终端场景,拿到第一手用户交互数据,形成数据闭环。
两样合在一起构成完整的偷猎能力: 用自建应用获取数据,用数据迭代模型,模型升级后再吸收更多应用层已验证的价值,循环往复 ,欲罢不能 。

图 1:偷猎者循环机制
这个循环与移动互联网时代的生态逻辑有本质区别。在移动生态中, 大厂 不会因为小程序验证了一个高频需求就把它变成系统原生功能。但模型会 , 模型的 迭代 方式就是消化数据,被市场验证过的需求恰恰是 最有价值的数据。 每一次用户说这个应用好用,模型就在学习 吸收 这个应用。
火山引擎MaaS业务 目标已经 冲向数千亿元 ,百倍增长的 背后, 都是应用层验证过的需求进入了模型层。爱分析认为, 偷猎者悖论由模型进步方式决定,不会自行消失。
02 偷猎不止云大厂一家,三类玩家同步逼近
偷猎已经发生,偷猎者不止云大厂自己。三类同时拥有用户数据和自建应用能力的主体,正在从不同方向逼近同一件事。

图 2:三类偷猎者
云大厂是 浮在水面的 偷猎 者, 全栈能力让用户数据和自建应用都 把握 在 云大厂 手里。Token增长依赖生态繁荣,模型迭代同时在吸收生态 , 悖论在云大厂身上 最为 尖锐。
模型厂商是潜猎者 , 他们 今天不以大规模自建应用为目标,但这不等于明天不下场。DeepSeek 大幅降价 ,不只是抢市场 ,更是在抢数据 。 对于模型厂商而言, 更多开发者接入意味着更多交互数据回流。当模型厂商手里积累了足够多的开发者行为数据,随时可以把高频需求从应用层抽进模型层。
Cursor的遭遇就是一次清晰演示。Cursor曾是 Anthropic 最大的API客户 , A厂 推出自研 Claude Code 后,6个月ARR达到25亿美元,超过了Cursor的20亿美元年营收。Cursor被迫自研底层模型,最终于2026年6月以600亿美元卖身。当第三方应用处在模型和用户之间,其业务数据就是 模型 下一次迭代的燃料。
运营商是最被低估的偷猎者。 运营商 手握数亿消费者用户,又 做政企总集, 其 承接的不只是AIDC 建设与运营 ,而是从网络建设到系统集成到运维的完整业务流。 企业业务中, AI 怎么拆任务、怎么走审批、怎么对接系统,这些端到端的业务流程数据都在运营商手里。
同时, 开源模型与闭源模型的能力差距 并不大 ,数据 已经 超过模型本身成为核心壁垒。手握 消费者资源、 政企全流程数据、客户渠道和 最强 开源模型,运营商入场没有障碍。 当模型能力不再是优势,谁有数据谁就有模型 迭代 的燃料。
03 新场景匮乏,Token增长动力不再
当三类偷猎者同时在吸收生态数据,后果不止于某个应用消失 , 更深层的问题是, 整个创新结构的预期在逆转。
预期逆转的链条十分清晰:开发者形成共识,任何在 偷猎者 平台上做起来的方向最终都会被吸收,于是不再做长期创新。新应用类别变少,新消费场景枯竭, 偷猎者 Token增长退化为仅靠模型效率提升。 而这个单一增长 引擎 , 撑不起万亿Token的故事。
预期逆转 的影响极为严重, 一旦开发者形成共识,这个方向不会自行恢复。当下Token收入的数字还在涨,但水面之下,新应用类别在变少,新消费场景在变稀薄。竞品降价可以应对,开源追赶可以应对 , 开发者的信心 悄无声息的消失了, 这才是应对不了的事。
爱分析在 与 AI厂商交流 中反复听到一个共同的困惑:目前真正在消耗Token的只有Coding和视频生成两个场景 , 下一个场景是什么,受访者普遍表示没人知道,也看不到趋势。 当一个生态的创新方向被压缩到两个场景,Token增长从应用繁荣驱动退化为模型单引擎驱动 , 只是时间问题。
这种方向感的缺失指向一个更深的困境 , 应用层自身也找不到下一个能被模型吸收的突破口了。当增量全部来自模型效率提升,新场景没有贡献增长, 又会回到互相卷的恶劣竞争环境。
04 囚徒困境下,偷猎者们无法克制
如果只有云大厂一家在偷猎,克制还有可能。但模型厂商和运营商同时在逼近,克制的窗口就彻底关上了。
偷猎者悖论本质上是一个囚徒困境 :即便 云大厂想选 择 克制,对手 也 不会配合。
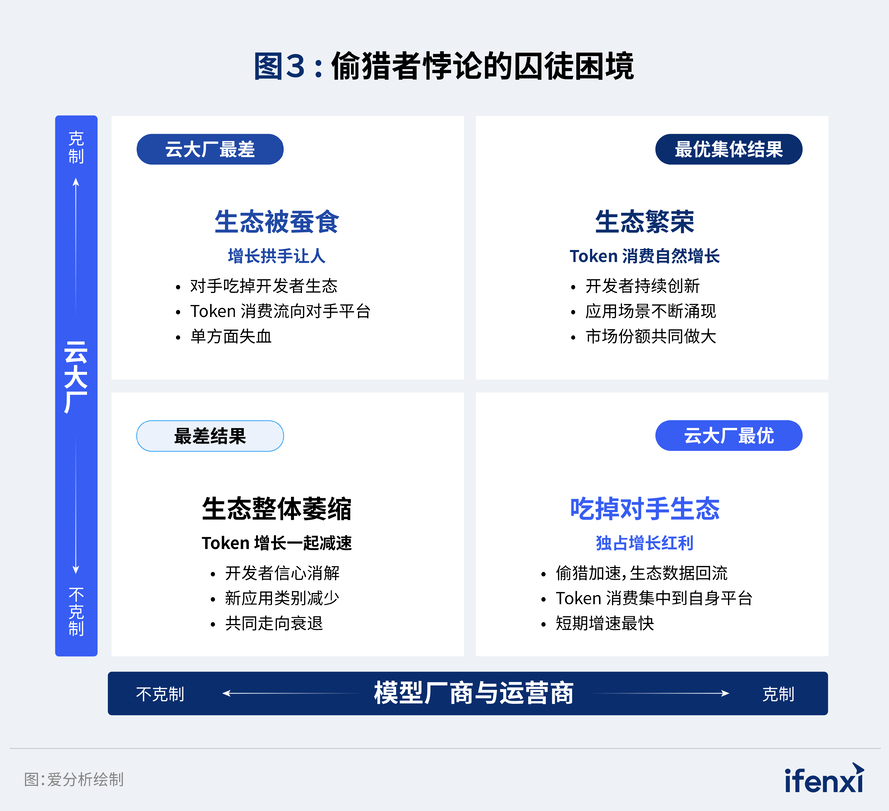
图 3:偷猎者悖论的囚徒困境
无论对手怎么选,不克制永远是云大厂自己的最优策略。对手克制时,不克制能吃掉对手生态。对手不克制时,克制等于把生态拱手让人。这不取决于战略选择,格局已经锁死了答案。
更现实的是,即使三方都选择克制,模型自身仍在通过公开数据、学术研究和开源社区持续迭代。克制只是减速器,不是刹车。
模型厂商降价抢开发者,就是在积累偷猎数据。运营商做总集,就是在沉淀政企应用数据。每一方都在往偷猎方向走,且每一方都没有理由停下。
爱分析认为, 偷猎者悖论没有终极解法。云大厂想克制,但对手的行动已经封死了这条路。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69993021/viewspace-3183185/ ,如需转载,请注明出处,否则将追究法律责任。

