原文链接: http://tecdat.cn/?p=6851
教育或医学的标准情况是我们有一个持续的衡量标准,但随后我们对那些具有临床/实际意义的连续措施有了切入点。一个例子是BMI。您可以通过70分作为成绩测试进行成绩测试。当这种情况发生时,研究人员有时可能会对BMI模型超过30或通过/失败感兴趣。实质性问题通常属于模拟某人超过/低于该临床显着阈值的概率的线条。因此,我们使用逻辑回归等方法对连续测量进行二分,并分析新的二元变量。
那么这种方法在实践中如何运作?任何尝试在使用逻辑回归进行分析之前在不同阈值下对连续变量进行二分法的人都会知道估计的系数会发生变化并且可能会发生很大变化,这是否与声称结果不应取决于阈值一致?我们可以使用模拟。首先,我将介绍数据生成过程:
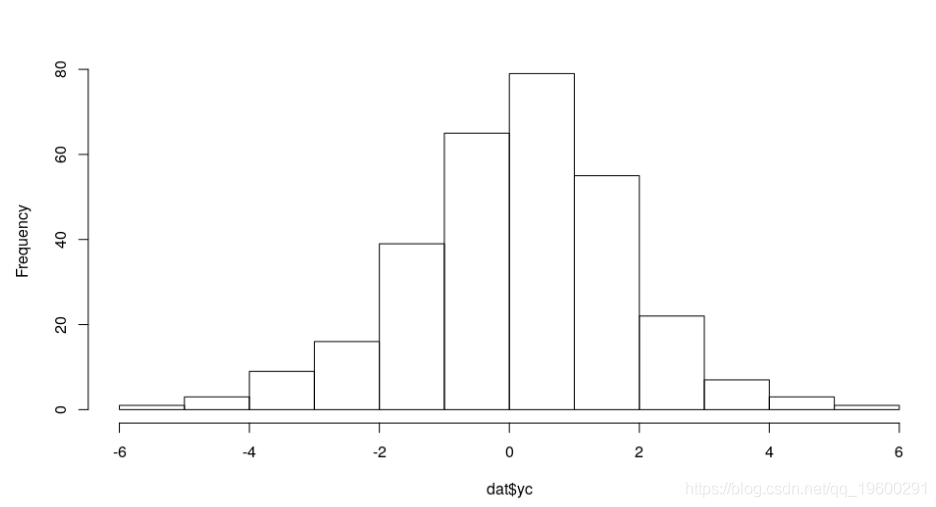
dat <- data.frame(x = rbinom(300, 1, .5))# Outcome ys = intercept of -0.5, the coefficient of x is 1 and there is logistic errordat$yc <- -.5 + dat$x + rlogis(nrow(dat))
hist(dat$yc, main = "")
然后,我们可以
yc在不同点上对结果进行二分,以确定这是否会影响
x我们使用逻辑回归的估计系数:
coef(glm((yc > -2) ~ x, binomial, dat))["x"] # Cut it at extreme -2x0.9619012coef(glm((yc > 0) ~ x, binomial, dat))["x"] # Cut it at midpoint 0x1.002632coef(glm((yc > 2) ~ x, binomial, dat))["x"] # Cut it at extreme 2x0.8382662
如果我们
yc直接应用线性回归怎么办?
# First, we create an equation to extract the coefficients and# transform them using the transform to logit formula above.trans <- function (fit, scale = pi / sqrt(3)) {scale * coef(fit) / sigma(fit)}trans(lm(yc ~ x, dat))["x"]x1.157362
所有这些数字彼此并没有太大的不同。现在我们可以多次重复此过程来比较结果中的模式。我会重复2500次:
colMeans(res <- t(replicate(2500, {dat <- data.frame(x = rbinom(300, 1, .5))dat$yc <- -.5 + dat$x + rlogis(nrow(dat))# v for very; l/m/h for low/middle/high; and t for threshold; ols for regular regressionc(vlt = coef(glm((yc > -2) ~ x, binomial, dat))["x"],lt = coef(glm((yc > -1) ~ x, binomial, dat))["x"],mt = coef(glm((yc > 0) ~ x, binomial, dat))["x"],ht = coef(glm((yc > 1) ~ x, binomial, dat))["x"],vht = coef(glm((yc > 2) ~ x, binomial, dat))["x"],ols = trans(lm(yc ~ x, dat))["x"])})))vlt.x lt.x mt.x ht.x vht.x ols.x1.0252116 1.0020822 1.0049156 1.0101613 1.0267511 0.9983772
这些数字是不同方法的平均回归系数。
boxplot(res)
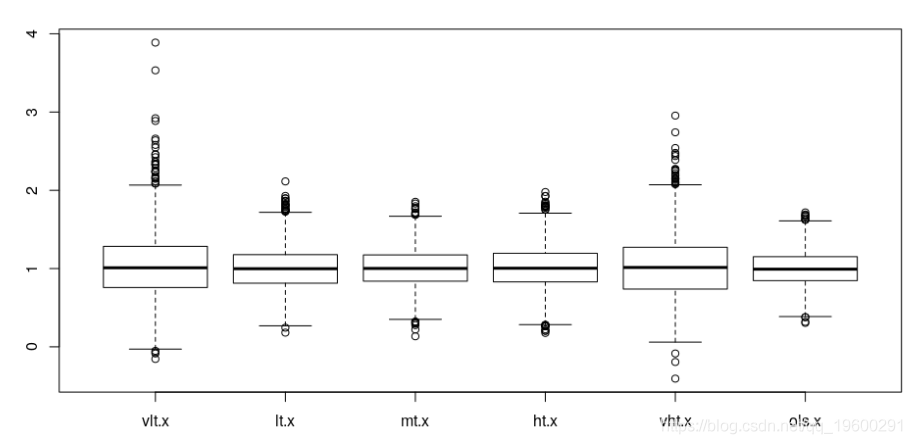
我们看到虽然平均值大致相同,但当阈值极端时,估计的系数变化更大。最小变量系数是变换后的线性回归系数,因此当我们使用线性回归方法时,结果稳定。
不同方法之间的估计系数模式如何?
ggpairs(as.data.frame(res))
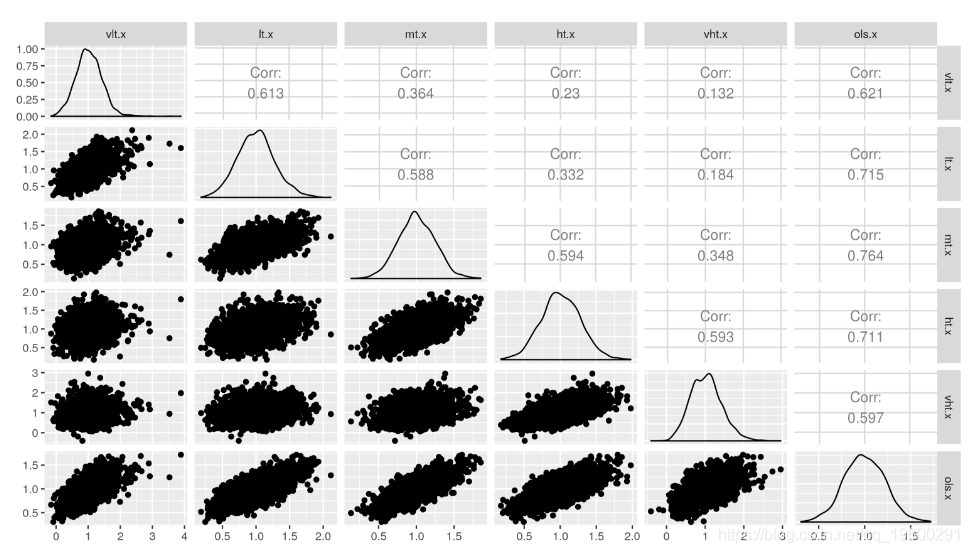
我们看到当阈值非常低时估计系数与阈值非常高时的估计系数非常弱相关(.13)。这些差异只是反映了阈值,在实际数据分析中可能会产生误导。
基于这些结果,预测因子与结果之间的关系也可能因结果的不同分位数而不同--分位数回归探讨的情况。可以使用分位数回归方法来查看原始连续结果中是否存在这种情况。
非常感谢您阅读本文,有任何问题请在下面留言!
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69982319/viewspace-2728505/ ,如需转载,请注明出处,否则将追究法律责任。

