航空发动机故障诊断智能体:面向高不平衡场景的持续对比强化学习方法
在民用航空运行过程中,航空发动机长期处于高温、高压及交变载荷的复杂工作环境,故障样本具有发生概率低、类别多样且高度不平衡的特点,同时伴随着日常执飞航次的增加,监测数据呈现动态持续增长的特性。发表在期刊《Advanced Engineering Informatics》上的论文《 Continual contrastive reinforcement learning: Towards stronger agent for environment-aware fault diagnosis of aero-engines through long-term optimization under highly imbalance scenarios 》提出了一种融合环境交互与持续动态演化的航空发动机故障诊断方法。该方法构建了持续对比强化学习(Continual Contrastive Reinforcement Learning, CCRL)框架,重点解决实际运维环境下故障样本稀缺、正负样本对不平衡以及诊断模型难以随环境自适应更新的问题。
一、 状态数据获取与时序样本构建
该方法的数据处理流程涵盖发动机多通道参数采集、制造商报告匹配以及滑动窗口采样三个主要步骤。
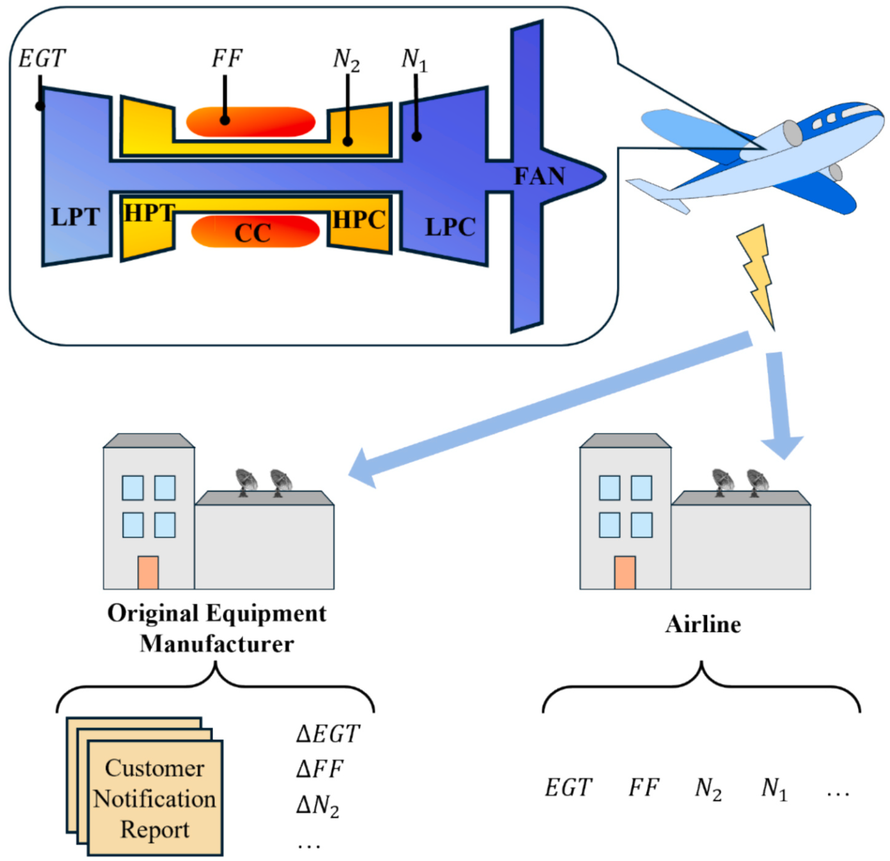
图1 航空发动机结构与传感器数据采集转换过程
1. 多源参数采集与衍生计算:以常见的双转子涡扇发动机为监测对象,利用机载通信寻址与报告系统,采集巡航等关键飞行阶段的气路传感器数据。监测指标涵盖排气温度偏差、核心机转速偏差、燃油流量偏差以及风扇转速。原始传感器读数结合设备制造商的修正计算,形成反映发动机气路状态的衍生监测参数序列。
2. 基于故障报告的状态标注:通过发动机制造商提供的客户通告报告匹配故障记录,获取异常事件类别、参数超限时段及最终维保确认结论。本研究针对可变放气阀系统故障、排气温度不平衡、总温传感器故障三类典型异常以及发动机正常运行状态展开分析。
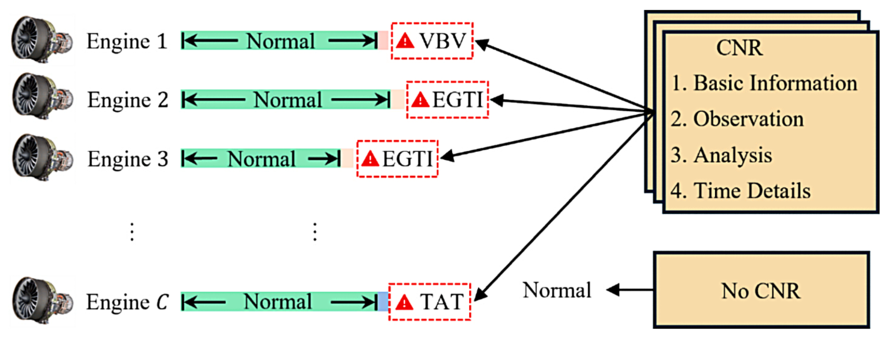
图2 航空发动机全寿命运行与故障数据采集流程
3. 滑动窗口时序样本采样:对于发生故障的发动机,根据通报的故障发生时段,截取故障出现前固定航次长度的时序监测片段作为故障样本;对于无故障运行的发动机,在排除初始磨合与末期异常的平稳运行区间内截取等长片段作为正常样本,所有特征序列最终进行极值归一化处理。
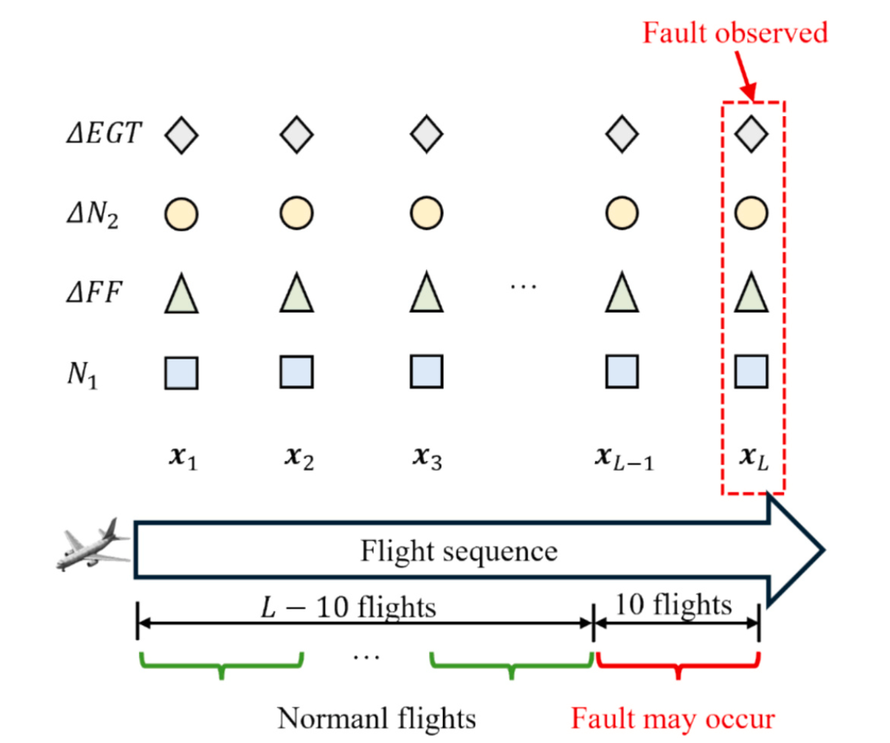
图3 飞行数据时序采样与数据集构建机制
二、 业务闭环与持续强化学习框架
为实现模型与实际机队运营场景的长期协同演进,该方法将航空公司的日常维保流程抽象为强化学习的交互环境。
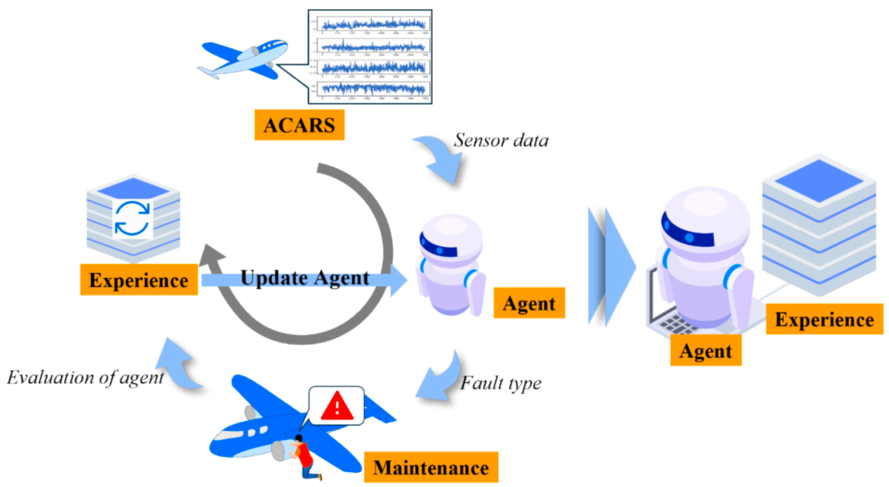
图4 持续对比强化学习诊断系统与业务流程交互示意图
整体系统运行步骤如下:
1. 状态输入:单次航班飞行结束后,地面系统接收下传的时序状态特征矩阵,作为环境提供给诊断智能体的当前状态。
2. 动作决策:智能体根据输入的运行状态进行前向推理,输出对该发动机当前健康状态的诊断决策动作,即判断其属于正常状态或某种特定故障类型。
3. 维保校验与反馈生成:地面工程专家结合人工排查与试车结果对智能体的诊断输出进行核验,环境根据实际状态与诊断结论的比对结果,按照预设规则向智能体返回数值奖励信号及下一阶段状态。
4. 经验回放与持续优化:输入特征、智能体诊断动作、反馈奖励与后续状态等交互数据存入经验回放池;当回放池样本累积达到触发阈值后,智能体通过离线更新机制迭代内部网络参数,进而适应机队服役时间推移带来的参数漂移与新型故障形态。
三、 特征区分模块:自编码预训练与加权对比学习
由于真实工况下各故障类型样本量极小,若直接进行有监督分类或常规对比学习,模型难以稳定提取区分性表征。特征区分模块通过两阶段方式实现特征提取能力的构建。
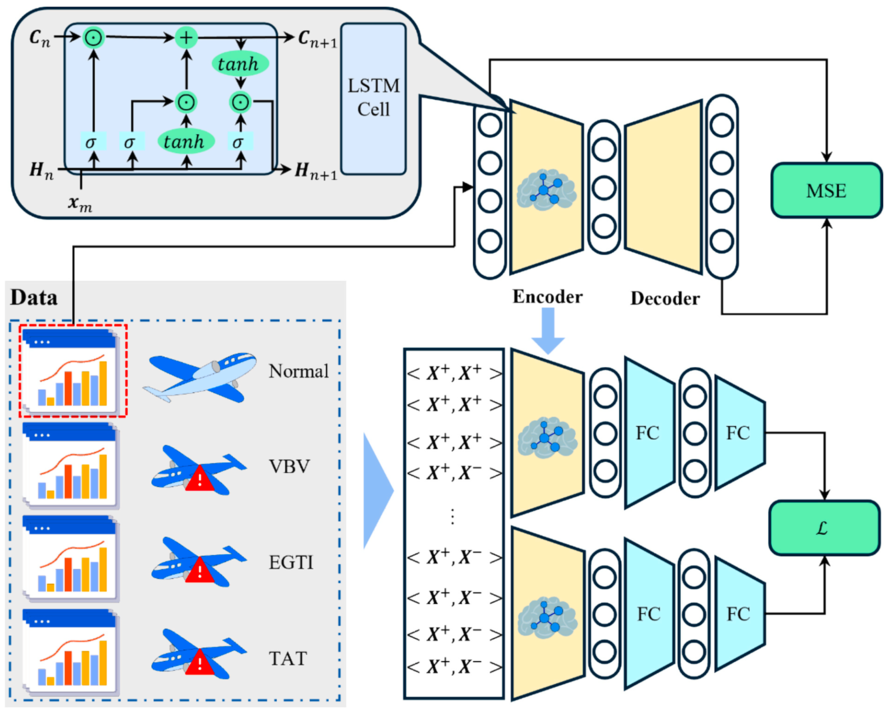 图5 特征区分模块自编码预训练与对比学习微调结构示意图
1. 正常样本自编码器预训练:
首先构建由长短期记忆网络(LSTM)构成的自编码器网络,仅输入数量充足的正常飞行样本进行无监督重构训练。
利用隐藏层的循环门控机制压缩多维时间序列,并以均方误差最小化为目标优化网络权重。该步骤使编码器充分掌握正常工况下的普遍时序退化基线,避免因故障数据稀缺而引起特征提取器过拟合。
2. 无合成扩增的真实样本对构建:
传统对比学习依赖对单一样本的人工数据增强生成正样本对,但在发动机物理时序数据中难以保证合成序列的物理合理性。该方法直接采用真实数据构建样本对:相同故障类型的不同真实样本组合为正样本对,不同故障类型的样本组合为负样本对。
3. 加权对比损失微调:
将预训练完成的编码器连接由全连接层构成的投影头,基于余弦相似度计算表征距离。
鉴于实际批次中同类正样本对数量远小于异类负样本对数量,在对比损失函数中引入平衡正负样本贡献的权重调节系数,提升同类样本聚集效应并约束异类样本过度排斥。
训练阶段为编码器设置微小的学习率进行微调,为投影层设置较大学习率更新表征空间,训练完成后冻结该模块的编码器权重,输出低维时序特征向量。
四、 类型辨识模块:决斗双深度Q网络与非平衡奖励机制
类型辨识模块承接特征区分模块提取的深层表征,完成各运行状态与故障类别的最终判决。
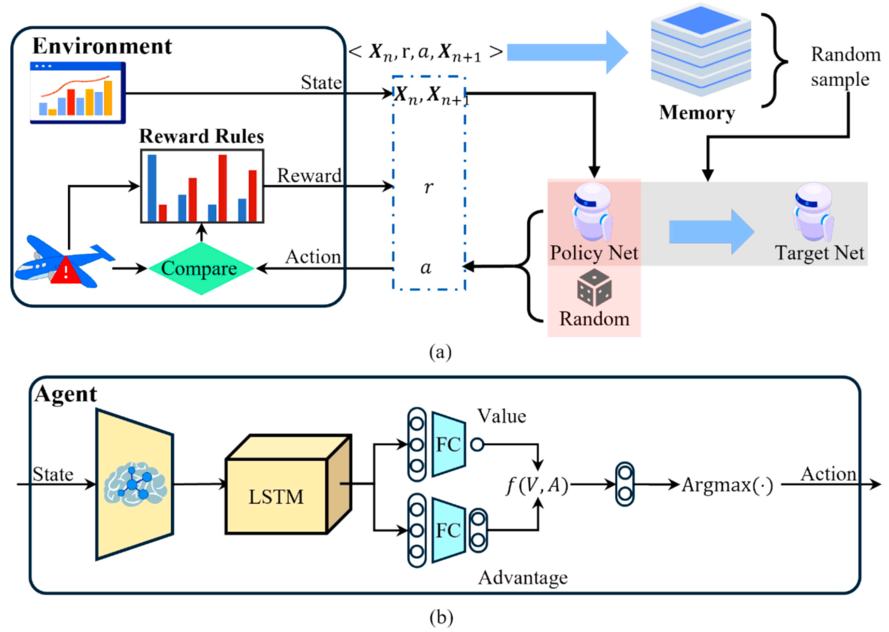
图6 类型辨识模块交互训练流程与双网络结构示意图
1. 智能体决斗网络架构(Dueling Network):
-
智能体的前端直接接入前序阶段训练并冻结的特征编码器,后接单层长短期记忆网络主干,提取最终时序隐藏状态。
-
输出端解耦为状态价值分支与动作优势分支:状态价值分支输出标量,用于评估当前输入状态本身的基准价值;优势分支输出与故障类别数等长的向量,用于评估各个具体诊断动作相对于基准水平的相对增益。
-
将状态价值与扣除均值后的优势向量相加,合成最终各动作的评估值,选取数值最高项对应的索引作为最终判决类别。
2. 基于类别频次倒数的动态奖励设计:
-
针对正常样本较多、故障样本极少的分布特征,环境向智能体反馈的奖励绝对值与训练集中各类别样本数量的倒数成正比,并经过归一化处理。
-
当智能体正确识别出现频次较低的罕见故障时,环境返回较大的正向奖励;若将其误判,则施加同等幅度的负向惩罚。对于高频出现的样本类别,单次判别的正负奖励幅度相应缩减,促使智能体在长周期优化中关注少数类故障特征。
3. 双网络更新与平稳迭代机制:
-
建立结构一致的策略网络与目标网络。策略网络用于动作选择并实时通过反向传播更新;目标网络参数保持固定,仅在达到预定训练步数后整体复制策略网络权重,以此解耦动作选择与目标估值计算,抑制动作价值的高估偏置。
-
在训练初始阶段设置较高的随机动作选择概率以促进探索,伴随训练步数增加,探索概率逐步线性衰减至固定的极低水平,保证后期以利用已学习策略为主。由于不同航次数据之间在时间跨度上相对独立,时间差分更新中的未来折扣因子设为较小数值,重点依据当前单步诊断的即时反馈优化网络参数。
参考文献:
Continual contrastive reinforcement learning: Towards stronger agent for environment-aware fault diagnosis of aero-engines through long-term optimization under highly imbalance scenarios[J]. Advanced Engineering Informatics, 2025.
https://www.sciencedirect.com/science/article/abs/pii/S1474034625001909
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31557240/viewspace-3188140/ ,如需转载,请注明出处,否则将追究法律责任。

