持续对比强化学习:高不平衡与数据动态增长下的航空发动机故障诊断
针对航空发动机故障样本极度匮乏、故障类别多样以及运行监测数据持续累积的工程实际,论文《Continual contrastive reinforcement learning: Towards stronger agent for environment-aware fault diagnosis of aero-engines through long-term optimization under highly imbalance scenarios》提出了一种持续对比强化学习(CCRL)框架。该方法致力于通过环境交互与对比特征提取,解决长周期运行中的模型适应性与样本不平衡分类问题。
一、整体运行与持续学习框架
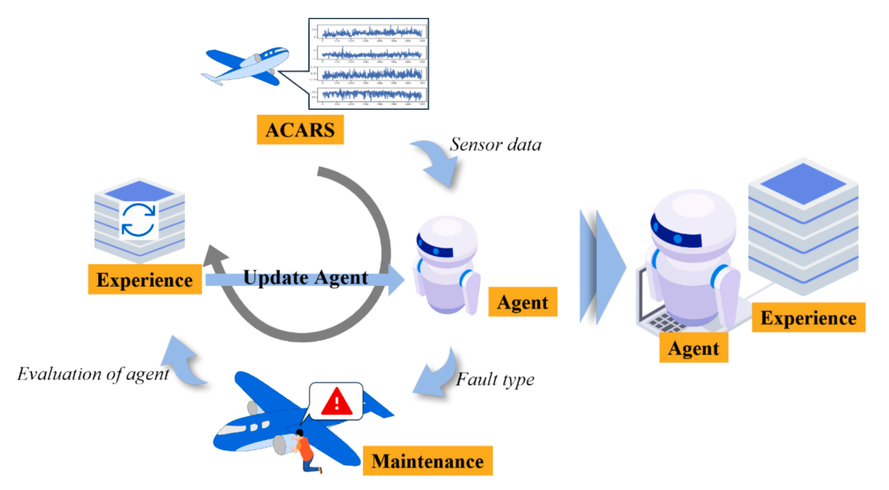
在民航实际运行中,发动机传感器数据由机载通信系统回传并归档。传统的离线训练模式难以随数据增长灵活演进。CCRL 将航空公司的实际运营流程抽象为强化学习环境:
-
环境与状态提供:环境向智能体提供由连续多个飞行循环组成的性能监测序列作为当前状态。
-
决策与人工复核:智能体输出预判的故障类别,工程技术人员结合制造厂商的故障通知报告与维护经验进行排故核实。
-
经验积累与动态迭代:判定结果与真实反馈被存入经验回放池,智能体依据长期累积的数据持续更新,使诊断策略与实际工况保持动态同步。
二、特征区分模块:预训练与加权对比学习
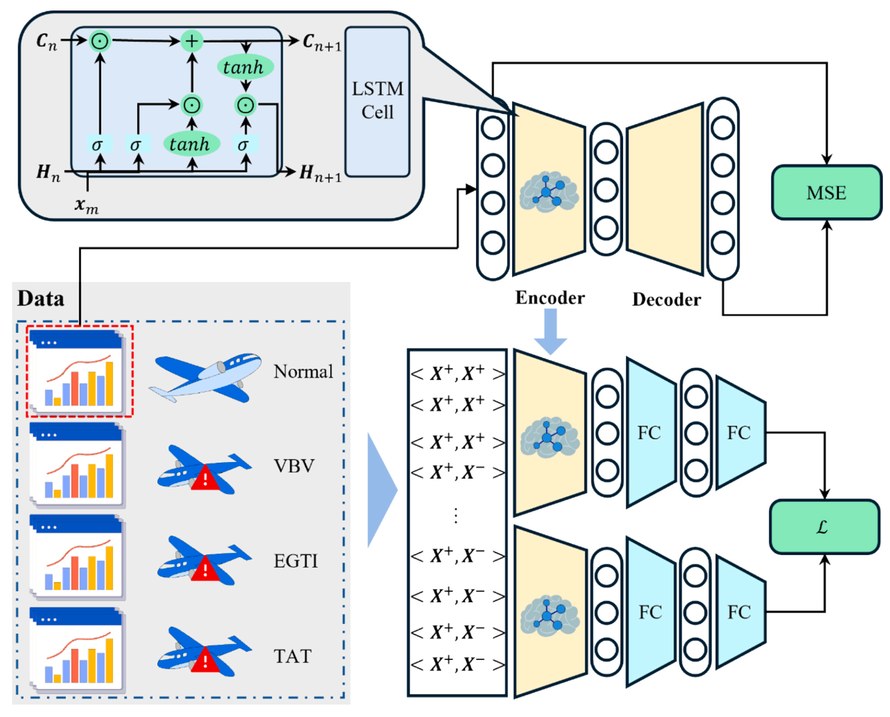
发动机数据以正常运行为主,各故障模式样本极少。直接使用生成式方法合成时序数据容易引入失真先验。为此,CCRL 设计了专用的特征区分模块:
-
自编码器先验提取:首先仅利用海量正常样本对长短期记忆网络(LSTM)自编码器进行无监督重构训练,使编码器充分掌握正常工况的降维压缩特征,避免模型过早对有限的故障样本产生偏好。
-
基于真实样本的对比微调:将预训练的编码器作为主干,接投影层构成对比网络。同类故障样本作为正样本对,异类故障作为负样本对。
-
样本量加权调整:鉴于时序参数在不同故障间也存在共有工况模式,损失函数对正、负样本对施加差异化权重,提升同类投影特征的聚合程度,同时适度弱化非同类时序规律的强行推离,保证特征空间分布的稳健性。
三、类型识别模块:样本量自适应的强化学习决策
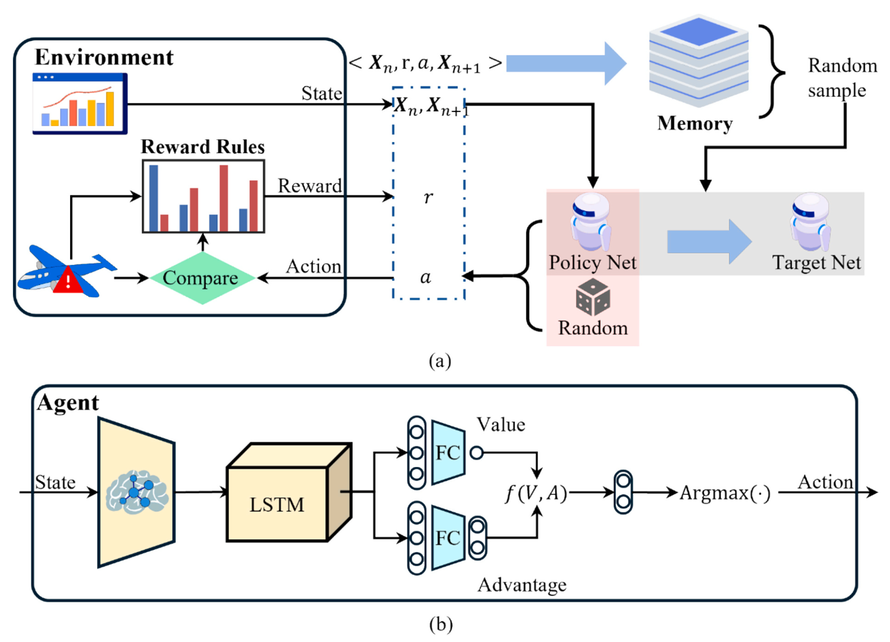
在特征提取完成后,编码层参数被固定,输入至决斗双重深度Q网络(D3QN)进行故障类型判断:
-
决斗网络解耦估值:智能体网络将特征分别送入状态价值支路与动作优势支路,最终组合计算各动作评价值,降低状态本身绝对差异对动作选择的干扰。
-
逆频次奖励分配机制:为抑制多数类样本导致的诊断偏置,环境反馈的奖励绝对值根据训练集各类别样本数量的倒数进行归一化计算。样本数量越少的故障类型,正确或错误识别时获得的奖惩幅度越大,引导智能体兼顾稀有故障模式。
-
双网络协同与探索衰减:利用策略网络实时选动作、目标网络延迟更新计算目标值,抑制强化学习中的价值过估计现象;同时采用阶段性递减的探索策略,确保前期充分搜寻策略空间、后期稳定收敛。
该架构将特征表征学习与序贯决策相结合,为稀缺故障诊断及数据长期持续演进提供了一种模块化的实现思路。
参考文献:
Continual contrastive reinforcement learning: Towards stronger agent for environment-aware fault diagnosis of aero-engines through long-term optimization under highly imbalance scenarios[J]. Advanced Engineering Informatics, 2025, 65(C): 103297.
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31557240/viewspace-3183963/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 变工况故障诊断该怎么解决?一种引入控制信号的控制感知域对抗网络
- 大功率二冲程船用柴油机燃烧室多故障模拟:基于宏观热物理参数微调的系统级响应建模
- 从船机到风机/电机/机床:“控诊协同”在各大高端装备上的迁移应用指南
- 【论文分享】做故障诊断,为什么要盯紧控制系统的指令?
- 基于Deep attention SMOTE的燃气轮机不平衡异常检测论文分享
- 基于Feature-level SMOTE的燃气轮机不平衡故障诊断论文分享
- 基于自注意力深度迁移学习的跨工况小样本电池SOH在线估计论文分享
- 船用柴油机控制-诊断协同论文分享
- 控诊协同:迈向更加智能的船舶柴油机故障诊断
- 航空发动机故障诊断智能体的核心步骤
