基于Feature-level SMOTE的燃气轮机不平衡故障诊断论文分享
本期分享发表于《Expert Systems With Applications》的研究成果,论文标题为《Feature-level SMOTE: Augmenting fault samples in learnable feature space for imbalanced fault diagnosis of gas turbines》。针对工业燃气轮机的故障诊断任务,实际工程中通常面临两项典型挑战:一是已标记的故障样本量极少,与大量正常样本构成严重的类别不平衡;二是早期或轻微故障的表现与正常运行状态接近,导致两类样本在原始数据分布中存在明显的类间重叠。
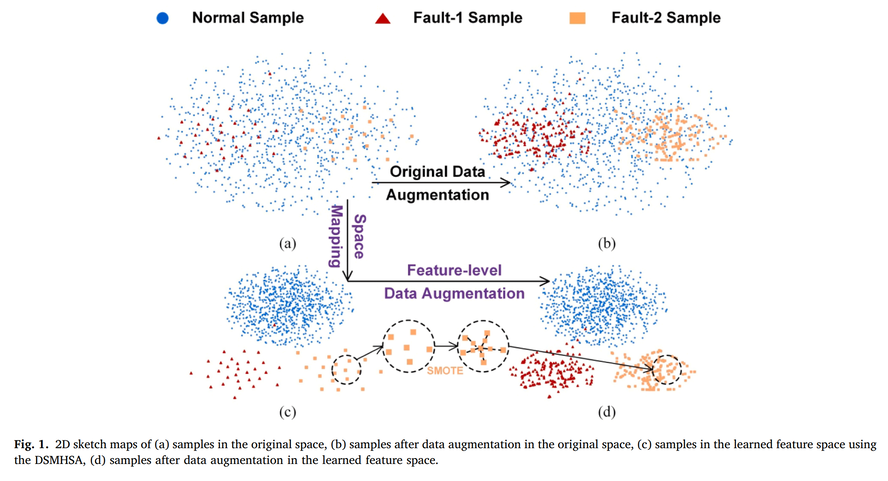
如图1所示,传统的合成少数类过采样技术(SMOTE)及其多数衍生算法通常直接在原始数据空间进行邻域线性插值。当样本分布存在重叠时,直接在原始空间合成新样本往往会在重叠区域引入噪声,甚至生成具有歧义的假边缘样本,进而影响分类器的判别性能。针对这一问题,论文提出了在可学习的特征空间中进行样本扩充的诊断方案(Feature-level SMOTE)。
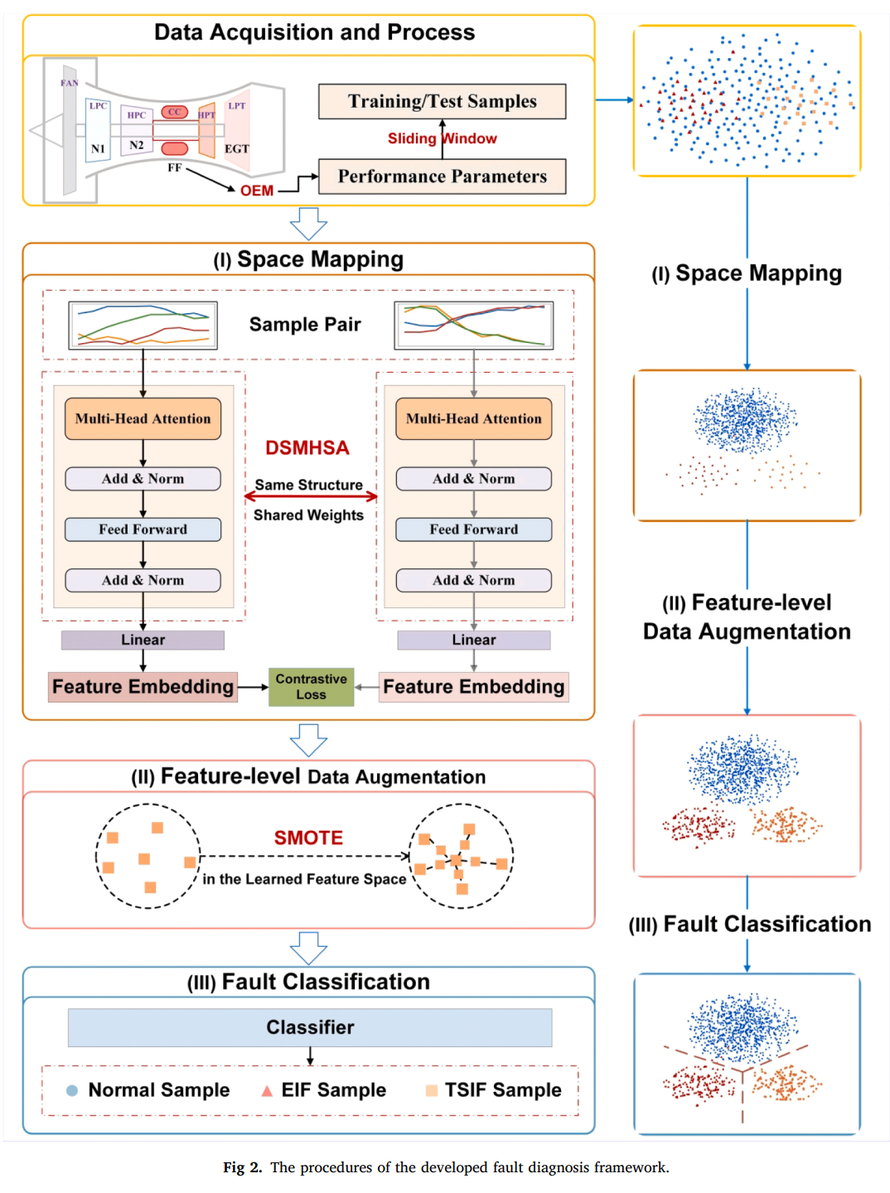
如图2所示,该诊断框架在技术实现上主要包含以下三个步骤:
-
基于深度孪生网络的空间映射 :针对燃气轮机多维时间序列状态参数的动态特性,构建以多头自注意力网络为骨干的深度孪生模型。多头自注意力模块用于自适应提取时间序列中不同尺度的关联特征;网络采用参数共享的双分支孪生架构,并使用对比损失函数进行端到端优化。在该损失的引导下,同类样本在隐空间中相互拉近,异类样本之间保持给定的间隔距离,从而将原始重叠数据映射到具备良好类间可分性的特征空间。
-
特征级数据扩充 :在映射得到的特征空间中应用SMOTE算法。算法在各故障类别的近邻特征之间进行插值,生成人造故障特征向量,并将其与原始训练特征合并。由于特征空间中的类间间距已被拉大,该过程避免了在正常状态与故障状态的交界区域盲目插值,有效抑制了伪边界噪声的产生,实现了训练集在表征层面的类别平衡。
-
状态诊断与分类 :利用平衡后的特征数据集训练分类模型,使用训练完成的网络对燃气轮机不同的健康与故障状态进行分类判别。
该方案将度量学习与传统重采样算法相结合,把样本生成过程由易产生混叠的原始信号空间转移至高可分的潜在表征空间,为解决复杂装备在不平衡与类间重叠条件下的智能诊断问题提供了清晰的技术参考。
参考文献:
Feature-level SMOTE: Augmenting Fault Samples in Learnable Feature Space for Imbalanced Fault Diagnosis of Gas Turbines[J]. Expert Systems with Applications, 2024, 238(F): 122023.
https://www.sciencedirect.com/science/article/pii/S0957417423025253
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31557240/viewspace-3183944/ ,如需转载,请注明出处,否则将追究法律责任。

