胖头鱼的技术专栏-468 JSON改一个字段,凭什么要重写整篇?(20260910)
作者:胖头鱼的鱼缸(尹海文)
Oracle ACE Pro: Database
PostgreSQL ACE
10年+数据库行业经验
拥有OCM 11g/12c/19c、MySQL 8.0 OCP、Exadata、CDP等认证
墨天轮MVP,ITPUB认证专家
圈内拥有“总监”称号,非著 名社恐(社交恐怖分子)
全网同名:胖头鱼的鱼缸
ITPUB:yhw1809
除授权转载并标明出处外,均为“非法”抄袭

话说,最近这段时间,遇到好几个性能相关的问题,类型还挺集中: JSON 字段高频更新导致数据库 CPU、IO、内存一起告警。
有做电商的,商品 SKU 详情动辄几 KB,每次改个库存、改个价格,库就要重写整个 JSON;还有些做游戏背包、订单详情、物流轨迹的,场景不一,但症状高度相似:开发的抱怨基本都是"我明明只改了一个字段",数据库这边却在偷偷干着重写整篇文档的活。
这事儿不怪写代码的——JSON 的写入语义本来就是"替换整个值", 问题出在底层到底有没有给你"只动改了的部分"的本事。
本期把这事儿掰开聊,顺便把 MongoDB、PostgreSQL、Oracle 三家在该场景下的表现摆出来做个横评,给出一些"我的选择",以及几个"退而求其次"的方案。
老规矩,先打个预防针:这是一篇纯粹的从写放大和查询路径两个维度做技术对比的文章,不讨论技术路线的优劣,也限定为高频更新 + 查询的应用场景。
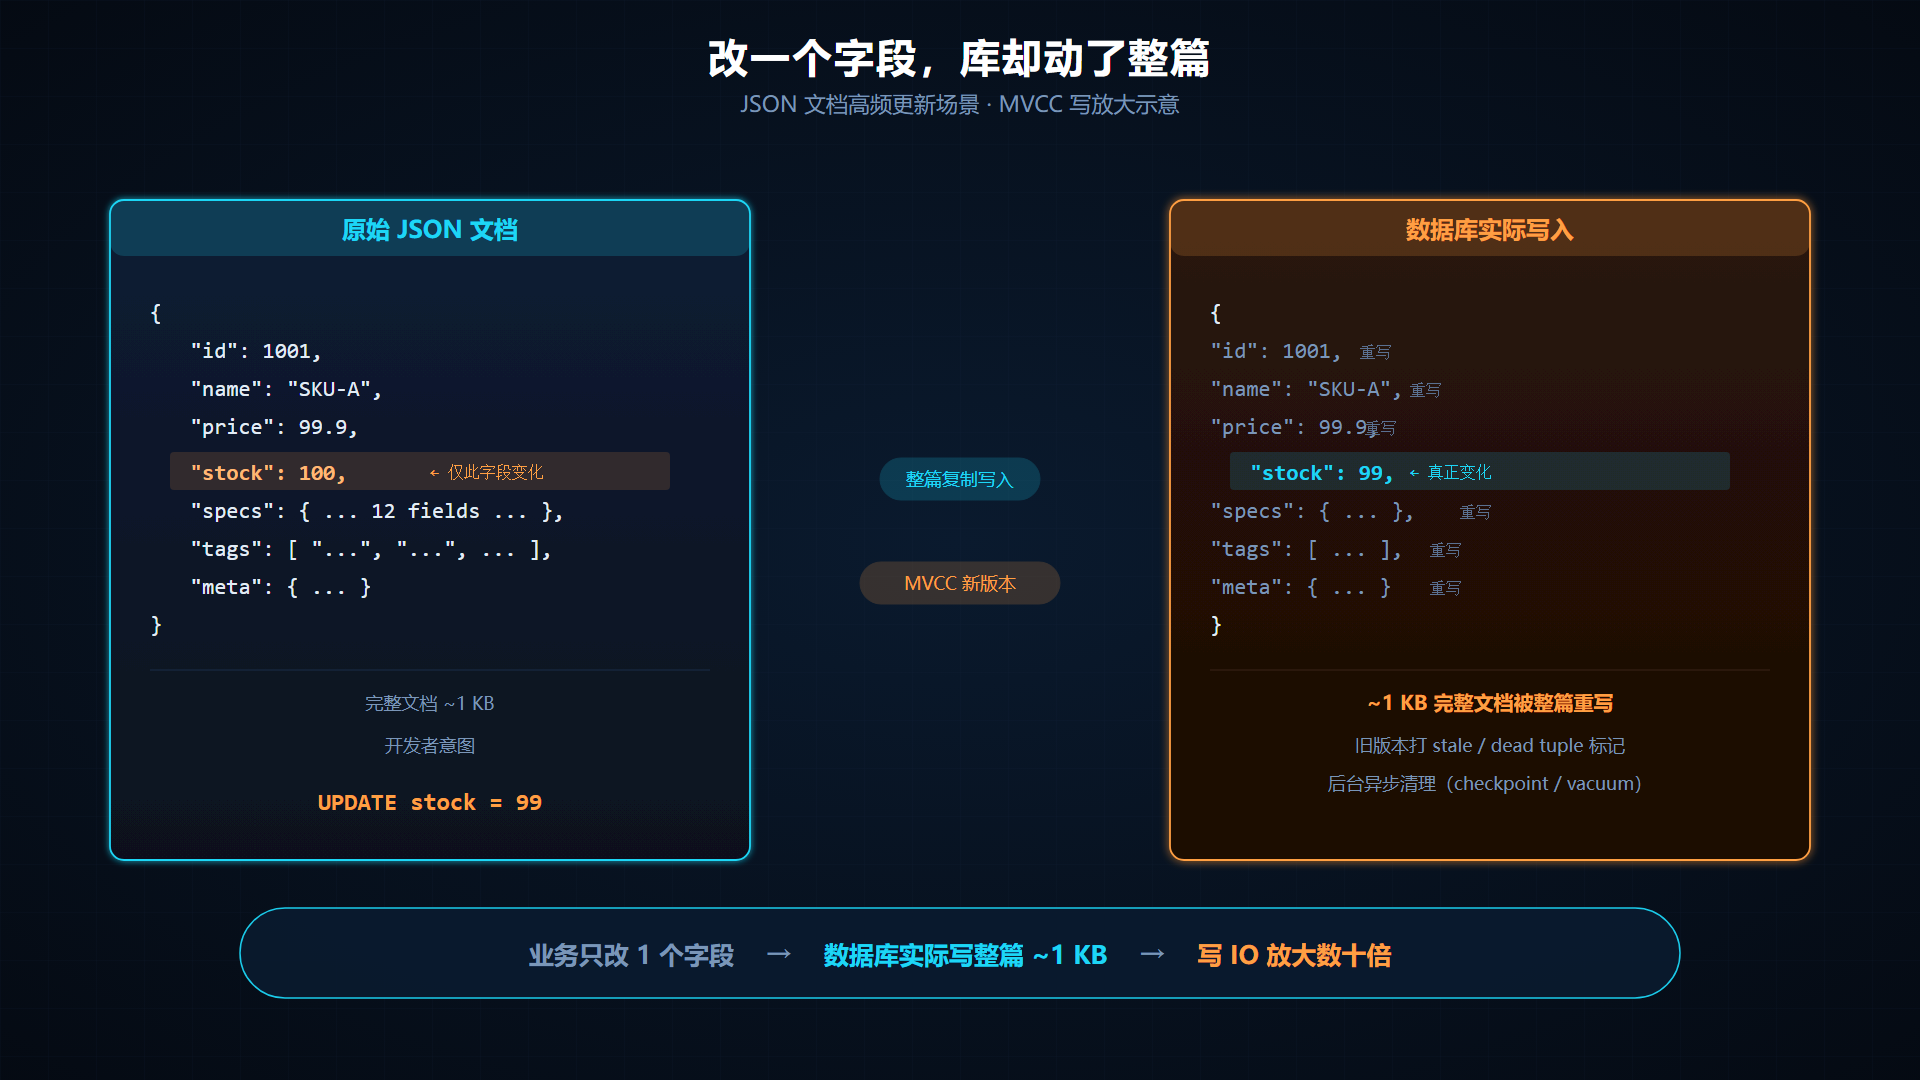
一、为什么"改一个字段"会变成"重写整篇"
在开始对比之前,先把一个底层的事说清楚—— “改一个字段,库为什么动了整篇”。
这事其实跟 MongoDB、PostgreSQL、Oracle 都是 MVCC 数据库有关。MVCC(多版本并发控制)的好处是读不阻塞写、写不阻塞读,代价是 每一次写都要生成新版本。具体到 JSON 文档,就是:
- WiredTiger(MongoDB 默认引擎):每次 update 写新版本 BSON 到新位置,旧版本打 stale 标记,由 checkpoint / compaction 异步清理;
- PostgreSQL JSONB:UPDATE 整条 tuple 写到 heap 的新位置(旧 CTID),旧 tuple 打 dead tuple 标记,由 autovacuum 回收;
- Oracle OSON(原生 JSON):undo 存前镜像,data block 写入新版本 OSON,旧 block 内容随后被新事务覆盖。
所以不管用哪家, 单从"JSON 字段更新"的角度看,都会触发整篇文档的写 IO——这是 MVCC 的天然代价,问题只是谁家额外给了你一层优化。
引用 Franck Pachot 在 DEV.to 上公开的实测数据:PostgreSQL 更新 10000 个 JSONB 文档生成 641088 个 WAL 记录(约 64/文档),写 57413 个 block(约 46KB/文档)——远大于实际逻辑变更。
换句话说,业务逻辑改了 1KB 的字段,PostgreSQL 实际写了 46 倍的数据。中间被 WAL 放大、TOAST 压缩放大、各种 buffer / page 操作放大——这些都是账。
下面这张表,先把三家的默认存储摆一下:
| 数据库 | 默认存储引擎 | JSON 类型 | 物理存储格式 |
|---|---|---|---|
| MongoDB | WiredTiger | BSON | BSON 二进制,写入 B-Tree 新位置 |
| PostgreSQL | heap + MVCC | JSONB | 二进制 + TOAST 压缩 |
| Oracle | heap + undo | OSON | 二进制 + LOB 存储 |
光看类型不够,下面把"更新时各家到底干了什么"逐个拆开。
二、四种方案逐个拆
下面要对比的不是三个库,而是 四种应对方式:MongoDB 原生、PostgreSQL JSONB 原生、Oracle 原生 OSON,以及 Oracle 26ai 新引入的 JSON Relational Duality View。第三种和第四种都源自于 Oracle,但因为对于 JSON 的使用与实现机制完全不同,所以单独拆开讲。

方案一:MongoDB 原生(BSON + WiredTiger)
原理:MongoDB 文档写入走 WiredTiger 的 B-Tree,每次 update 都把整个 BSON 文档写到新位置(旧位置打 stale),后台 checkpoint / compaction 异步清理。
优点:
- 模型直观,BSON 直接就是 JSON,开发友好
- 写入吞吐天花板高,亿级文档单机也能扛
- 副本集、Change Stream 等生态成熟
缺点:
- 单字段更新 = 整篇文档重写。1KB 文档改 1 个字段,写入数据量基本就是 1KB + 索引更新 + WAL
- 旧版本清理靠后台,磁盘膨胀时要靠手动
compact,高峰期会影响业务 - 频繁部分更新的场景下,磁盘 IO 是真实业务 IO 的 N 倍(N 由文档大小决定)
适用场景:文档天生独立、不需要跨文档事务、单文档写入吞吐优先于部分更新性能的场景。
方案二:PostgreSQL 原生(JSONB + heap)
原理:JSONB 是二进制格式 + TOAST 压缩存储,
UPDATE 整条 tuple 写到 heap 新位置,旧 tuple 标记 dead tuple,autovacuum 异步清理。
优点:
- ACID 强,关系数据 + JSONB 可以在同一事务里操作
- 索引能力强(GIN、表达式索引、
jsonb_path_ops) - 生态成熟,
pgvector、Apache AGE 等扩展可在同库共存
缺点:
- 部分字段更新 = 整条 tuple 重写(含 JSONB 整块)。前文实测:10000 文档 ~64 WAL 记录/文档,写放大明显
- 频繁更新 + JSONB 文档偏大 → 表膨胀,autovacuum 压力大
- PostgreSQL 17 之前没有任何"只改 JSONB 部分字段"的内部优化
适用场景:JSONB 文档中等大小(KB 级),半静态属性 + 少量高频字段,且接受 autovacuum 调优的场景。
方案三:Oracle 原生(OSON)
原理:Oracle 12c 起引入 OSON(二进制 JSON 格式),存储为普通 LOB 列。更新走 undo + block 覆盖,部分场景可走 OSON Partial Update 优化——只重写 JSON 内部变更的字节段。
优点:
- ACID 强,企业级事务、并发、容灾开箱即用
- OSON Partial Update 可以在不动整个 JSON 块的前提下重写部分字节(条件较苛刻)
- SQL/JSON 函数丰富,
json_value、json_exists、json_transform等
缺点:
- Partial Update 适用范围窄:必须用 OSON 格式 + 表上有 JSON 搜索索引 + 不能改 JSON 结构。三者缺一就退化为整块写入
- 即便走 Partial Update,OSON 列本身的 IO 模型仍是 LOB,大量小更新并不比 BSON 便宜
- 走原生 JSON API 时,应用要承担"自己保证字段语义正确"的负担
适用场景:JSON 列内容半静态(配置、扩展属性),少数字段偶尔修改 + 整体读多写少的场景。
方案四:Oracle 26ai JSON Relational Duality View 🆕
原理:把"JSON 文档"从物理存储降级为访问层—— 物理存储仍然是规范化的关系表,JSON 只是 duality view 这层抽象。一份数据、两套访问接口(JSON 文档视图 / 标准 SQL 关系表)。
优点:
-
JSON Patch → 关系 DML:通过
json_mergepatch更新 duality view 时,Oracle 把 JSON Patch (RFC 6902) 翻译成底层关系表的 DML,改哪个字段就 UPDATE 哪个列;嵌套数组 diff 后只动子表的对应行 - 查询自动改写:JSON 查询被改写为关系查询,直接命中底层列和 B-Tree 索引, 仅在最终返回时才构造 JSON——中间过程零 JSON 序列化开销
- 零数据冗余:与 MongoDB 的"文档独立存储"或混合架构的"两边各存一份"不同,duality view 是同一份关系数据的多面投影
-
ETag 乐观并发:内置基于
ORA_ROWSCN的乐观锁,并发更新无需应用层手动控制 - ACID 事务、并发控制、安全审计全部走 Oracle 原生能力
缺点:
- 学习曲线:要理解 GraphQL 风格的 view 定义语法、字段映射关系
- 嵌套过深(5+ 层)+ 频繁 PATCH 时,分解 JSON 的 CPU 开销可能高于直接写关系表
- 底层表上的 BEFORE UPDATE 触发器在 duality view 更新路径中可能不触发(MOS 标注 by design,审计要走 FGA)
- 开启 Flashback Data Archive 时 ETag 生成开销增加 ~15%
适用场景:JSON 文档背后有跨表关联 + 单字段高频更新 + 大量查询需要命中索引 + 不能容忍数据冗余的场景。

三、四方案横评
上面聊完了每个方案的原理和优劣,下面用几张表把关键维度拉通对比。
3.1 核心能力矩阵
| 维度 | MongoDB 原生 | PostgreSQL JSONB | Oracle 原生 OSON | Oracle 26ai Duality View |
|---|---|---|---|---|
| 单字段更新 | 整篇重写 | 整篇重写(PG17 前) | 视条件 Partial Update | 只 UPDATE 对应列 |
| 数组元素变更 | 整篇重写 | 整篇重写 | 整篇重写 | diff 后只动子表对应行 |
| 查询路径 | 文档直接读取 | JSONB 索引查找 | JSON 搜索索引 | 自动改写为 SQL,命中底层 B-Tree |
| 跨文档一致性 | 弱(事务或多文档事务) | 强(事务),但写放大 | 强(事务),但写放大 | 强(事务),零数据冗余 |
| 写放大(参考) | 中等 | 严重(实测 ~64 WAL/文档) | 中等 | 接近普通关系表 UPDATE |
| 查询路径上的 JSON 构造 | 无 | 无 | 有(OSON 反序列化) | 仅在最终返回时构造 |
| 并发控制 | 文档级 MVCC + WiredTiger 快照 | tuple 级 MVCC | block 级 + undo | ETag 乐观锁(ORA_ROWSCN) |
| 部分更新优化成熟度 | 无 | 无 | 窄条件适用 | 内核级原生支持 |
| 学习曲线 | 低 | 低 | 中 | 中~高 |
3.2 成本与运维对比
| 维度 | MongoDB 原生 | PostgreSQL JSONB | Oracle 原生 OSON | Oracle 26ai Duality View |
|---|---|---|---|---|
| 部署门槛 | 低(单机起步) | 低 | 中(实例 + 许可) | 中(实例 + 许可 + 26ai 版本) |
| 运维复杂度 | 中(replica set / sharding) | 低~中 | 中~高(Oracle DBA 技能) | 中~高 |
| 部分更新场景的运维代价 | 监控磁盘膨胀 + 手动 compact | 监控表膨胀 + autovacuum 调优 | 监控 LOB + JSON 索引 | 与普通关系表基本一致 |
| 生态工具 | 丰富(Change Stream、Driver 多) | 丰富(pgvector、AGE、psql 等) | 丰富(SQL Developer、ORDS) | 丰富 + Oracle MongoDB API 兼容 |
3.3 适用场景速查
| 你的情况 | 推荐方案 |
|---|---|
| 文档独立、无跨文档关联、写吞吐优先 | 方案一:MongoDB |
| 已有 PostgreSQL 栈,JSONB 文档中等,半静态属性为主 | 方案二:PostgreSQL JSONB |
| Oracle 现有用户,JSON 列做配置/扩展属性 | 方案三:Oracle OSON |
| JSON 背后有跨表关联 + 高频单字段更新 + 不能容忍冗余 | 方案四:Oracle 26ai Duality View ⭐ |
| 团队无 Oracle 经验,又想要 Duality View 类似的"规范化+JSON 视图"效果 | "退而求其次"方案(见下文) |
四、如果让我来设计
上面聊完了四家的优劣,这里直接说我关于高频更新的 JSON 业务场景选型的立场。
核心结论:单字段高频更新的场景,Duality View 是当前唯一在"写放大"这个维度上真正消灭了 JSON 整篇重写的方案——因为它根本不让 JSON 成为物理存储单元。其他三家不管怎么调优,本质上都是在和 MVCC 的"整篇重写"做对抗,而 Duality View 是把这层代价从物理存储里彻底拿掉了。
具体到选型,我的判断是这样的:
- 如果业务文档天生独立、无跨文档关联——比如纯日志、纯 IoT 原始数据流,MongoDB 仍然是首选。不要为了"高级特性"硬上 Duality View,那是给自己找麻烦;
- 如果已有 PostgreSQL 栈,且 JSONB 文档控制在 KB 级、字段更新频率可承受——方案二性价比最高,别折腾;
- 如果已经是 Oracle 用户,文档做半静态配置 + 偶尔字段更新——方案三足矣;
- 如果是新建系统、JSON 文档背后有跨表关联、单字段更新是核心痛点、查询要命中索引—— 直接上 Oracle 26ai Duality View。前期投入多一点,后面省掉的写放大和运维债是真实的钱。
理由有三:
- 写放大真正归零:JSON Patch → 单列 UPDATE,跟普通关系表的写代价一致。1KB 字段改 1 字节,写的就是 1 字节的 column;
- 查询路径最干净:JSON 查询被自动改写为关系查询,直接命中底层 B-Tree,CPU 和 IO 都跟普通 SQL 一致;
- 一致性最强:单源数据,ACID 事务、并发控制、审计、安全——Oracle 原生能力全套继承,不用像混合架构那样自己拼胶水层。
SIGMOD 2025 论文公开的数据:Duality View vs Hibernate ORM,吞吐量 2-3 倍;vs 某主流文档数据库,TPC-C 变体下 2 倍以上。这不是营销话,是数据库顶会论文中的实测结果。
五、退而求其次
现实是残酷的——不是谁都有 Oracle 26ai 的环境(特别是数据库国产化的大环境下),也不是谁都能说动老板换库。这里说的"没有 Oracle 26ai",准确讲是**没有 JSON 关系二元性视图(JSON Relational Duality View)**这个能力(不排除以后有其他数据库会跟进这一功能),而是那套"JSON 文档 ↔ 规范化关系表"映射你没法用。如果你卡在 PostgreSQL 或 MongoDB 上,又遇到高频 JSON 更新场景,下面这几个方案可以参考。
场景 A:你只能用 PostgreSQL
做法:把高频更新的字段 拆出来做 top-level column,JSONB 只存半静态属性。
-- 反例:所有字段都塞 JSONBCREATE TABLE products (    id BIGINT PRIMARY KEY,
    metadata JSONB  -- 库存、价格、状态全在这里);-- 正例:高频字段拆出来CREATE TABLE products (    id BIGINT PRIMARY KEY,
    stock INT,                  -- 高频改
    price NUMERIC(10,2),        -- 高频改
    status SMALLINT,            -- 高频改
    metadata JSONB              -- 半静态属性、规格参数、扩展字段);
代价:放弃了"JSON 一把梭"的便利,换来的是 autovacuum 不再是瓶颈。
额外建议:
- JSONB 文档大小控制在 4KB 以内,超过这个量级,TOAST + WAL 放大会显著放大;
- 高频更新字段考虑 单独建表 + 关联,彻底避开 JSONB 的更新路径;
- 监控
pg_stat_user_tables.n_dead_tup,autovacuum 调优(autovacuum_vacuum_scale_factor调到 0.05 以下)。
场景 B:你只能用 MongoDB
做法:同样思路—— 高频字段拆出来做 top-level field,嵌套结构只放半静态数据。
// 反例db.products.insertOne({    _id: 1001,    metadata: {        stock: 100,        price: 99.9,        status: "on_sale",        specs: { /* 一堆规格 */ }
    }
});// 正例db.products.insertOne({    _id: 1001,    stock: 100,          // 顶层字段
    price: 99.9,         // 顶层字段
    status: "on_sale",   // 顶层字段
    specs: { /* 半静态规格 */ }
});
代价:牺牲了文档"内聚性",换来的是每次只更新对应的 top-level 字段,写入数据量就是字段本身大小。
额外建议:
- 监控
db.stats().storageSize与indexSize的比值,磁盘膨胀超 30% 跑一次compact; - 真要保留嵌套文档,写更新用
$set而非整个文档replaceOne——虽然底层效果一样,但应用层语义更清晰; - 单文档大小控制在 16KB 以内(MongoDB 文档硬限制是 16MB,但单文档越大,写放大越严重)。
场景 C:你愿意尝试 PostgreSQL 18 的新特性
PostgreSQL 18 在 JSONB 部分更新上做了一些优化(
MERGE 语句、
jsonb_set 在某些路径上的增量改写),加上
pgvector、Apache AGE 等扩展,
某种程度上能在 PostgreSQL 上模拟 Duality View 的部分能力——但需要明确知道它不是同一类解决方案:
- JSONB 仍然是物理存储格式,部分更新仍然受 TOAST / WAL 放大影响;
- 没有"自动改写 JSON 查询为 SQL 查询"的能力;
- ACID 是有的,但视图层不会帮你做 JSON Patch → DML 的翻译。
也就是说, PG18 能让你更舒服地用 JSONB,但不能从根上解决写放大问题。如果你真的被这个问题困扰,DBMS 升级之外还是得考虑结构调整。
场景 D:你愿意尝试 MongoDB API for Oracle 26ai
先说清楚:场景 D 其实又回到了 Oracle 26ai——它严格来说不算"退而求其次",而更像一个"绕回正主"的选项。因为在 Oracle 26ai 中,除了上面方案四那种 SQL 层的 Duality View,还有一个 Duality View 的增强用法:MongoDB 协议兼容 API。
Oracle 26ai 提供了这个 MongoDB 协议兼容 API——老的 MongoDB 应用可以直接对接 Oracle 26ai,MongoDB 那边发的 JSON 写入会被 Oracle 自动落库为规范化的关系表,并通过 Duality View 暴露给老应用。换句话说, 你不用重写应用,就能吃到 Duality View 单列更新的红利——这是 Duality View 在"访问层"上的延伸,本质还是把 JSON 当视图、关系表当物理存储。
适用场景:
- 老系统是 MongoDB 写的,不想改应用;
- 想要 Duality View 的好处,又不想切换 driver;
- 有一定迁移窗口期愿意配合 Oracle 的
JSON-to-Duality Migrator。
代价:既然绕回 Oracle 26ai,就依赖它的部署、许可;新团队需要补 Oracle DBA 能力。它唯一省下的是"改应用"那一刀——但库仍然得是 Oracle 26ai。
总结
回到开头那个问题—— JSON 改一个字段,凭什么要重写整篇?
答案分两层:
- 物理层:MVCC 的天然代价,三家都不可避免;
- 抽象层:Oracle 26ai Duality View 把"JSON 文档"从物理存储降级为访问层, 单字段更新 = 单列 UPDATE, 写放大从根上消除。
所以如果你问我推荐哪个方案,我的回答很直白:
新建系统、JSON 背后有跨表关联、单字段高频更新是核心痛点——直接上 Oracle 26ai Duality View(或使用有类似能力的数据库)。不是(或不能) Oracle 26ai / 没有其他数据库有这一能力的场景,按前面说到的的"退而求其次"方案做结构调整,把高频字段拆出 JSON。
Duality View 不是万 能的——它解决的是"JSON 文档 + 高频单字段更新 + 不能容忍冗余"这个特定组合。 文档独立、无跨表关联的场景,MongoDB 仍然更省事;JSONB 文档小、半静态的场景,PostgreSQL 性价比最高。选型永远没有银弹,关键是先搞清楚自己的核心诉求是什么,然后对照上面的矩阵选那个短板最少、跟你团队技能树最匹配的方案。
类似的话题我之前在数据库系列里聊过,本期算是在 JSON 高频更新这个具体场景里再展开一次——本质上还是那句老话: 让数据库把该扛的扛住,别把成本转嫁到应用层。
老规矩,知道写了些啥。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31466763/viewspace-3182008/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 胖头鱼的技术专栏-478 Agent 成了新用户,数据库要接住它的下一步(20261014)
- 胖头鱼的技术专栏-477 26ai新特性实战:表达式分区(20261013)
- 胖头鱼的技术专栏-476 26ai新特性实战:聚合过滤(20261012)
- 胖头鱼的技术专栏-475 蹭到最后,就没人摆摊了(20261010)
- 胖头鱼的技术专栏-474 从能跑到能上线:PG SplitJSON 0.2.0 和 0.1.0 差在哪
- 胖头鱼的技术专栏-473 26ai新特性实战:日历函数(20261004)
- 胖头鱼的技术专栏-473 改JSON的一个字段不再重写整篇:我给PostgreSQL 18写了个扩展
- 胖头鱼的技术专栏-472 26ai新特性实战:无 FROM 子句的 SELECT 语句(20261003)
- 胖头鱼的技术专栏-471 数据库优化的三层楼——为什么多数人总在第二层打转
- 胖头鱼的技术专栏-470 那条跑了半年的 SQL,怎么说慢就慢了(20260925)
