胖头鱼的技术专栏-469 事务号也会用完:从操作系统的 3.25GB 内存说起(20260914)
胖头鱼的技术专栏-469 事务号也会用完:从操作系统的 3.25GB 内存说起(20260914)
作者:胖头鱼的鱼缸(尹海文)
Oracle ACE Pro: Database
PostgreSQL ACE
10年+数据库行业经验
拥有OCM 11g/12c/19c、MySQL 8.0 OCP、Exadata、CDP等认证
墨天轮MVP,ITPUB认证专家
圈内拥有“总监”称号,非著 名社恐(社交恐怖分子)
全网同名:胖头鱼的鱼缸
ITPUB:yhw1809
除授权转载并标明出处外,均为“非法”抄袭

数据库给事务发编号,这个编号是会发完的——你想过没有?不是那种"理论上会用完",是真的会走到头,走到头还可能引起一些严重问题。
最近翻金仓 KES V9 的新版说明书(V009R002C016),在"可用性"那一节看到这么一句:
支持 64 位事务 ID(XID),避免因 32 位事务 ID 回收不及时或长事务阻塞导致的业务中断问题。
这段不是很长的内容一眼就能扫过去了。我盯着它看了半天,这不是加个功能,这是换地基。
打个比方你就明白为什么。二十年前装 Windows 那会儿—— 内存条插满了,系统只认 3.25GB。
一、先说当年那 3.25GB
那会儿满世界都是 32 位系统。32 位能表示 2³² 个地址,换算下来正好 4GB。听着挺合适——买 4GB 内存,刚好用满,谁也不浪费。
但现实情况是:想得美!
这些地址空间,并不是全留给内存的。显卡、网卡、BIOS 这些硬件也得在里面占一块做映射(MMIO),一般要切走 0.5 到 0.75GB 所对应的地址空间。结果就是:插 4GB,系统属性里写 3.25GB;就算你不服,加钱插 8GB——还是 3.25GB。
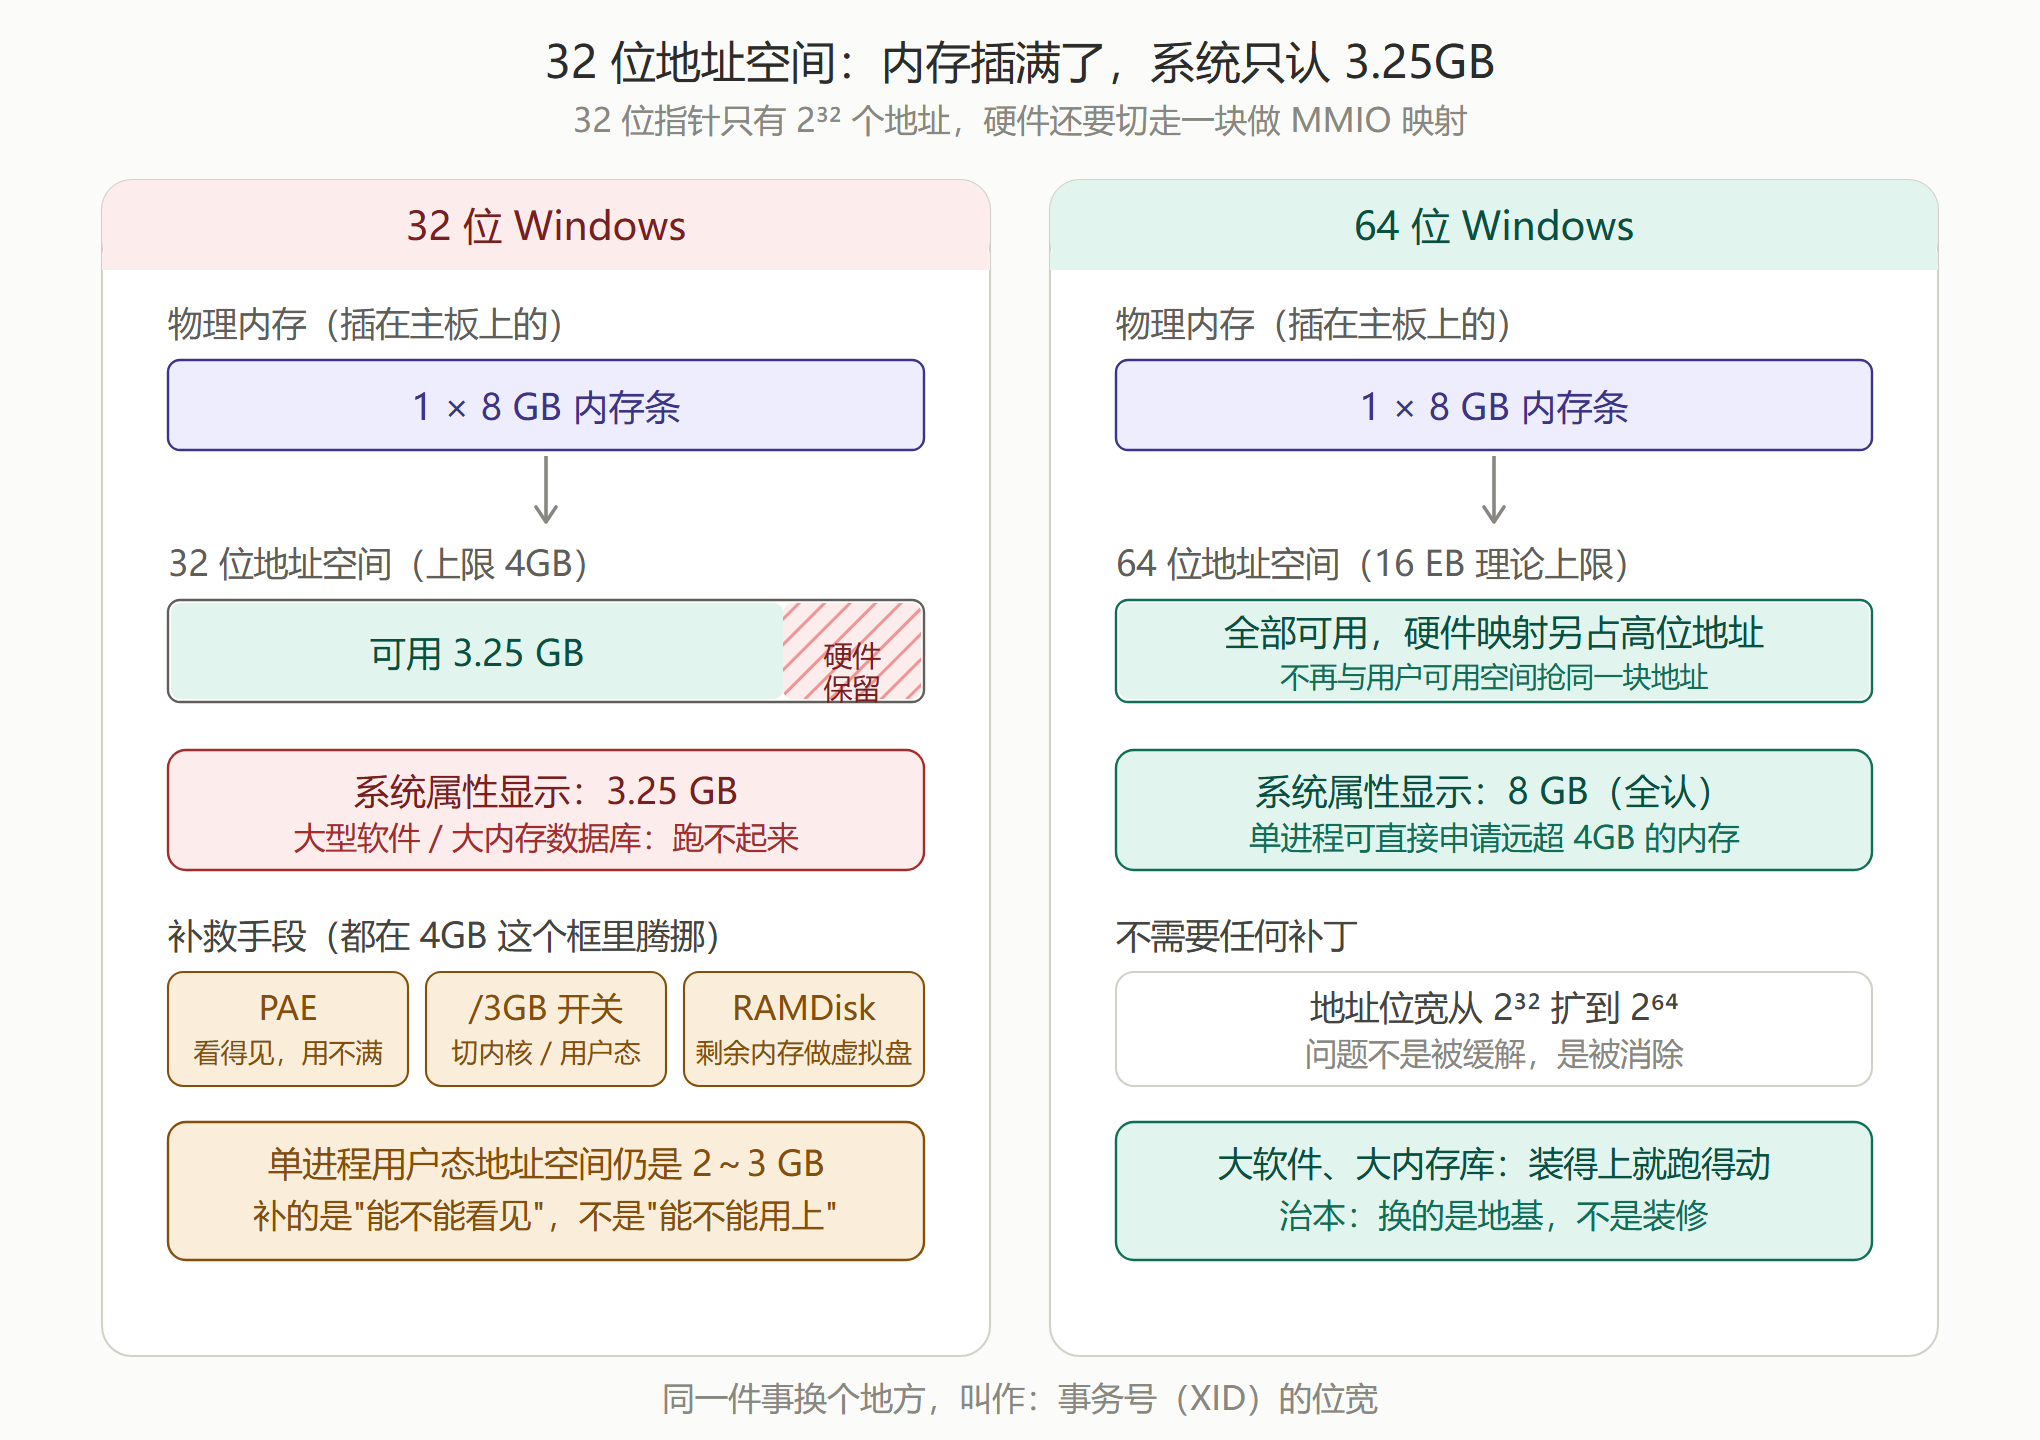
当时大家是怎么自救的?
- PAE(物理地址扩展):系统倒是"看得见"4GB 以上的内存了,可单个 32 位进程的用户态还是 2~3GB,这依然导致大软件该跑不动还是跑不动;
- /3GB 启动开关:把用户态和内核态的划分从 2/2 掰成 3/1,内核空间被挤瘦了,系统反倒更容易抽风;
- RAMDisk:认不出来的那截内存做成虚拟盘,放放临时文件。这只能说是聊胜于无。
你发现没有,这几招有个共同点: 全在 4GB 这个框里打转。治得了"看不见",治不了"用不上"。
那这事儿最后是怎么了结的?不是通过某个逆天的补丁解决的,而是 64 位系统普及了。地址位宽从 2³² 撑到 2⁶⁴,硬件映射挪去高位地址,不再跟用户可用空间抢地盘,"3.25GB"这个词就这么进了历史书。
一句话: 打补丁是让你看得见,换地基是让你用得上。咱们去看数据库里一个长得几乎一模一样的坑。
二、数据库里也有个"32 位地址空间"
先说事务号(XID)是干嘛的。
众所周知,用 MVCC 的数据库,读写互不堵,靠的就是给每个事务发一个递增的号:事务,开头领号,数据行身上记着"谁创建了我"“谁删了我”,查询时拿快照跟这些号比大小,号比我小的,看得见;号比我大的,看不见。
(MVCC 的账我之前在 《胖头鱼的技术专栏-468 JSON改一个字段,凭什么要重写整篇?(20260910)》那篇里算过一次——旧版本要清理、写入有放大,这次算另一头: 发出来的号本身也会不够用。)
32 位事务号一共 2³² ≈ 42.9 亿个。听着不少吧?问题是它发完了不停,回到 0 接着发—— 是个环。
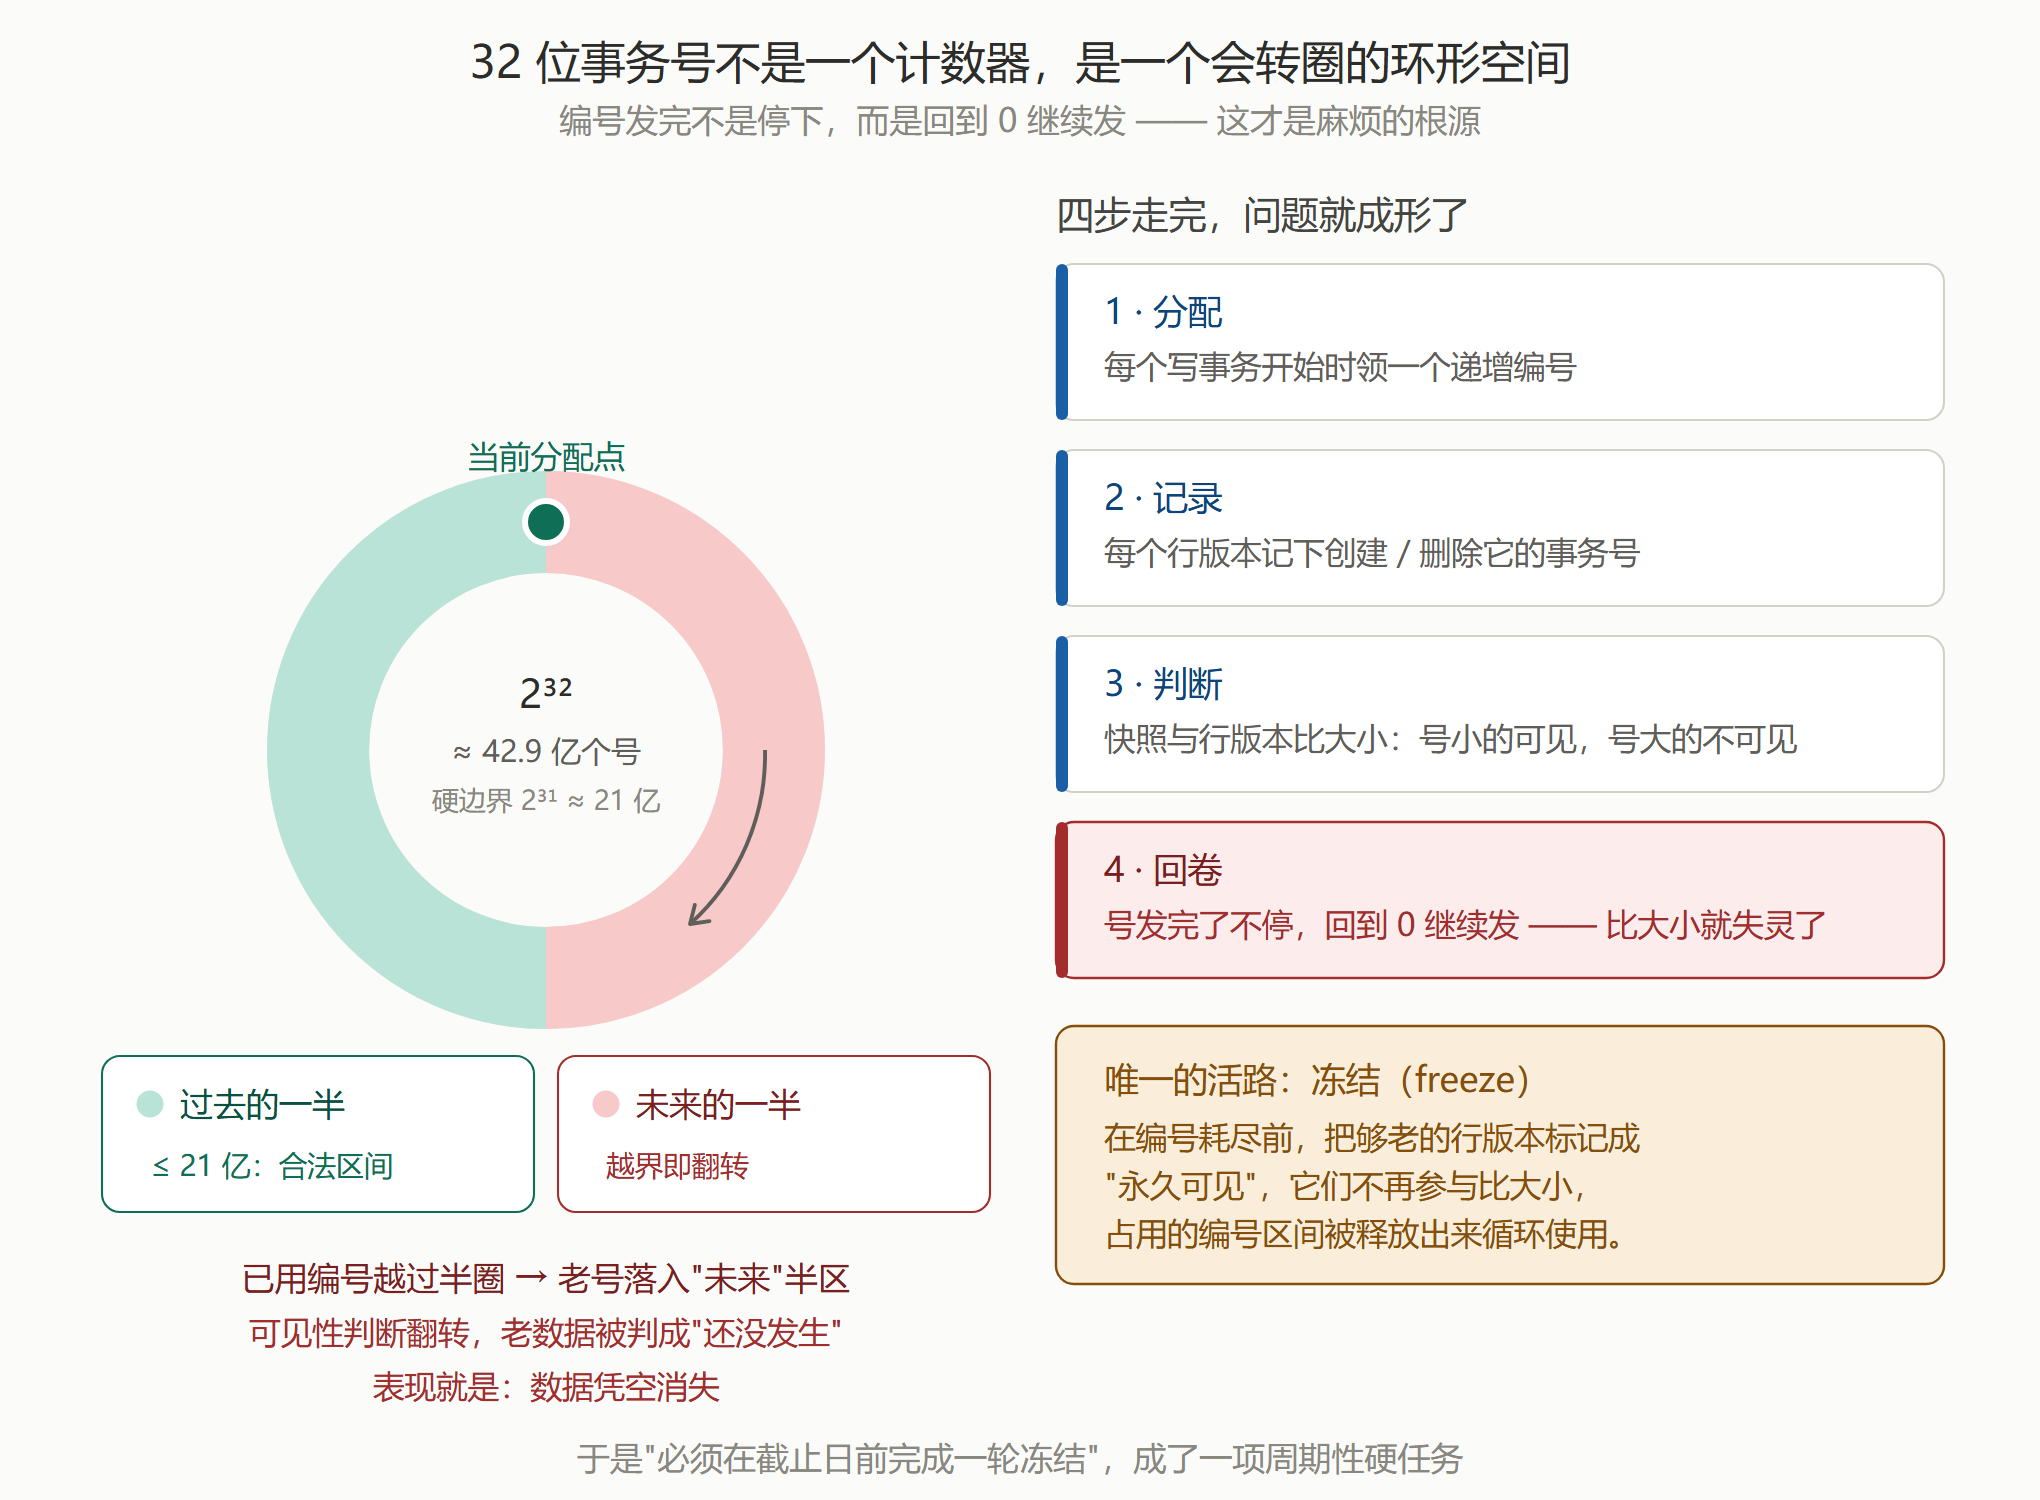
是环,就意味着会绕回来。绕回来的那一刻,昨天提交的那个事务号,在新坐标系里就变成"未来"了。可见性判断当场翻转—— 老数据被判成"还没发生",直接消失。
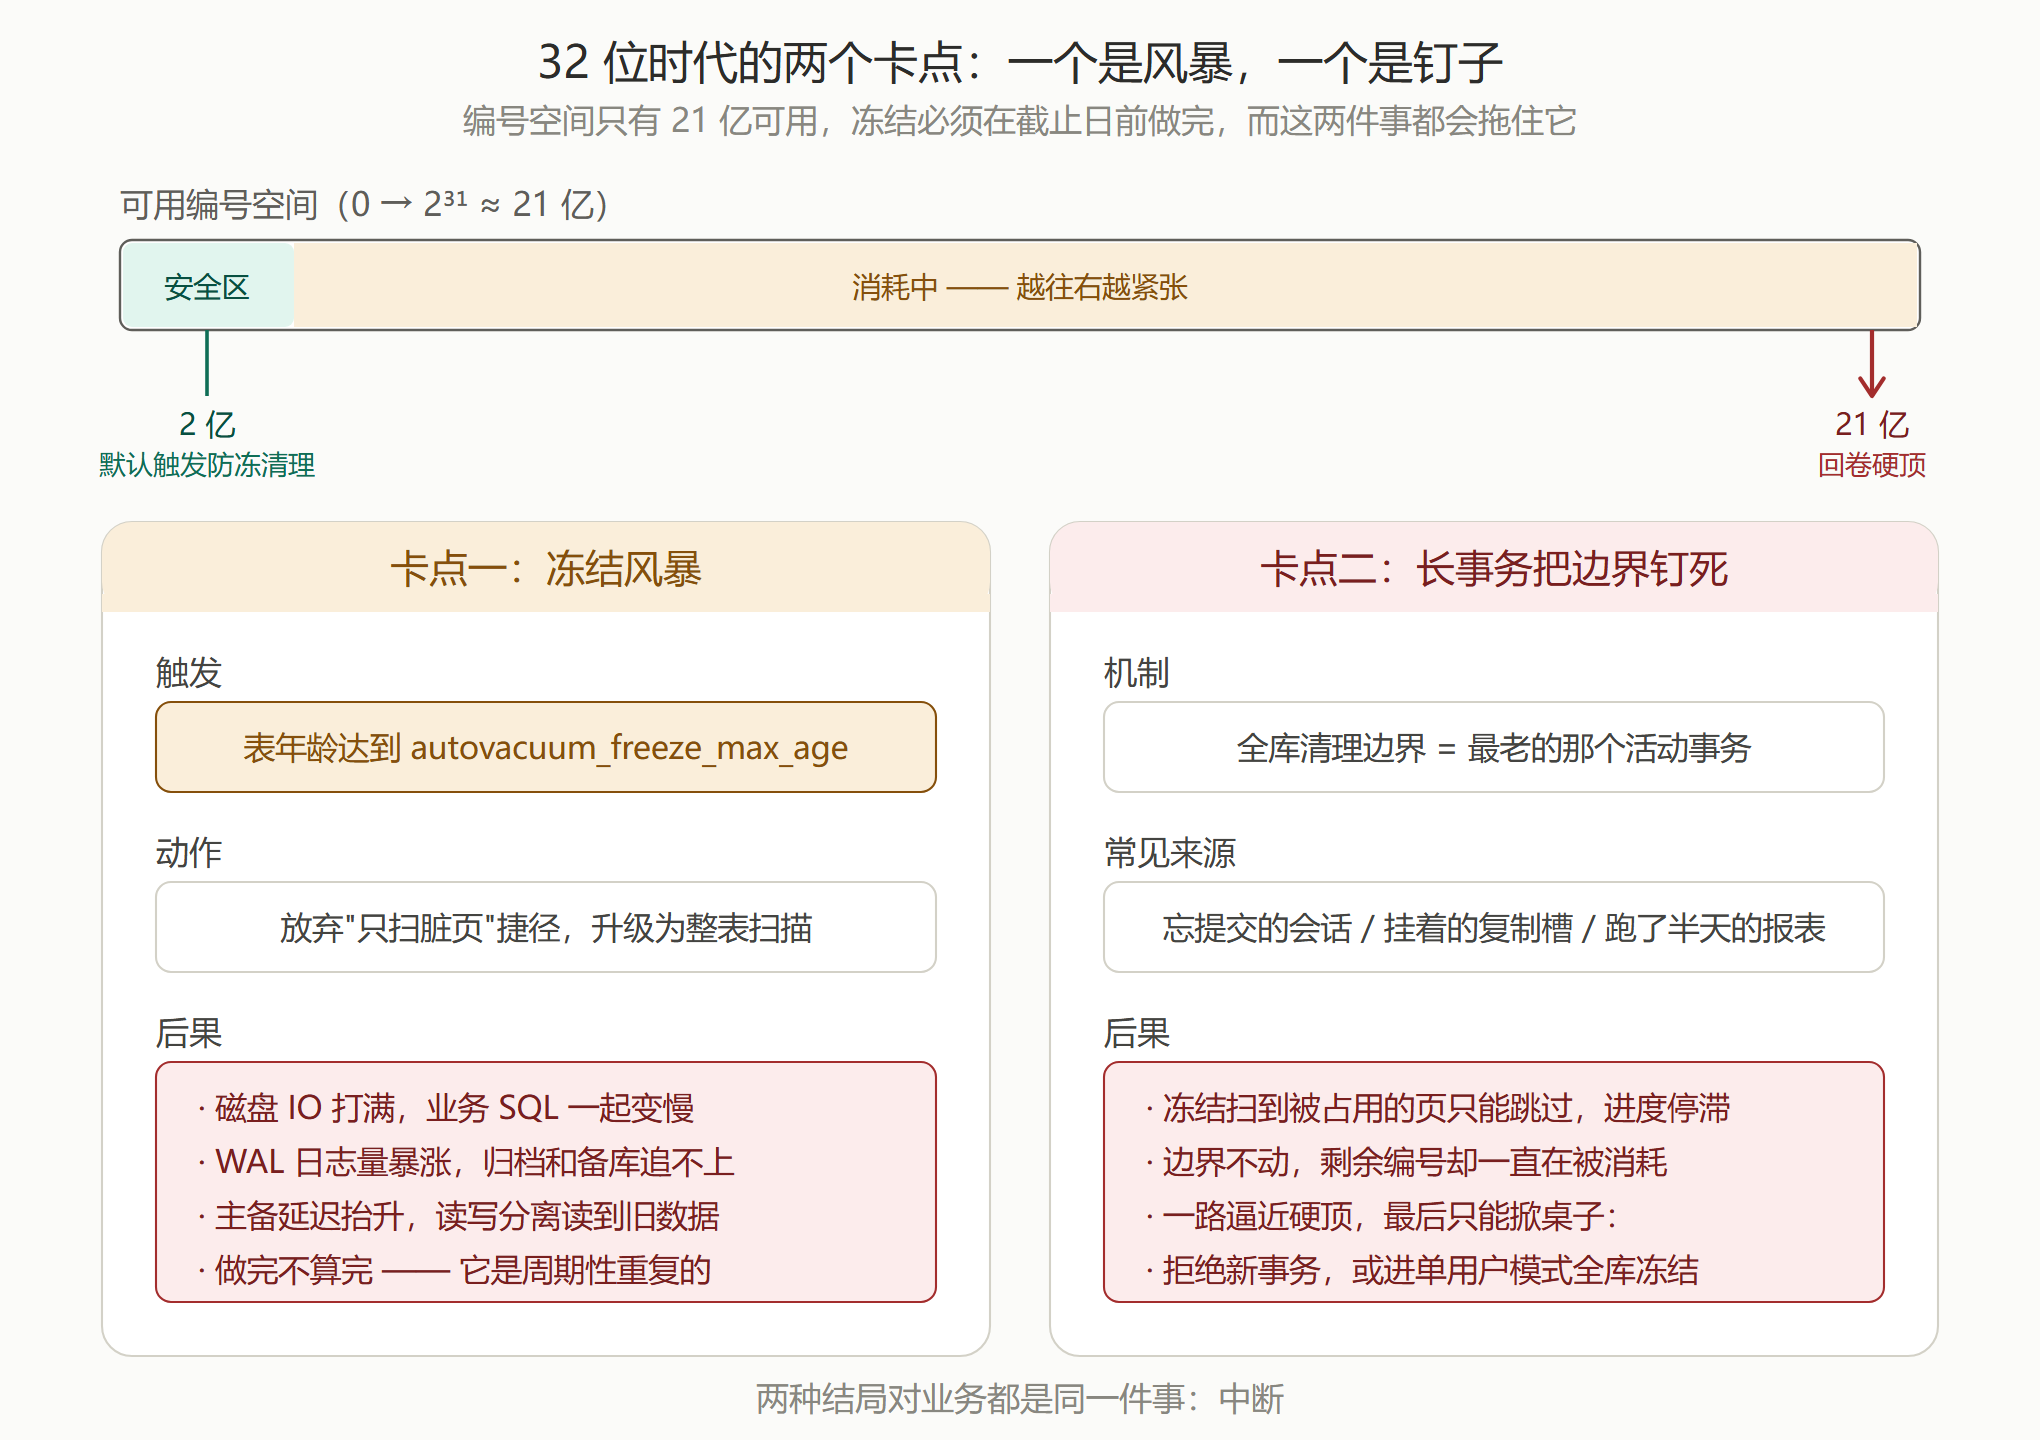
所以这类数据库有条铁律:编号空间对半砍,任何时候只认"过去的那半"(约 21 亿)。到线就得处理。
处理的办法叫 冻结(freeze):把够老的行版本标成"永 久可见",它们从此不参与比大小,占着的号段也就腾出来循环用了。
于是乎,“必须在截止日之前跑完一轮冻结”,成了这类数据库躲不掉的家务活。
三、那些年都是怎么熬过来的
道理不复杂,真干起来是另一回事。这活儿有三个坑,一个比一个难缠。
坑一:冻结风暴。
表的年龄摸到 autovacuum_freeze_max_age,强制清理就来了。平时清理只扫脏页,为了冻结得整表扫。一旦遇上大表就容易导致磁盘 IO 打满、WAL 蹭蹭涨、主备延迟往上蹿,关键它还不止来一次,是周期性来。
坑二:长事务把边界钉死。
全库能清理到哪儿,取决于最老的那个活动事务。一个忘了提交的会话、一个晾着的复制槽、一个跑半天的报表——随便哪个都能让冻结进度杵在原地。边界一动不动,编号却在哗哗地烧。
坑三:真到边界只能掀桌子。
逼近硬顶又来不及冻结,数据库只剩两条路:拒绝新事务,或者进单用户模式全库冻结。听起来不一样操作单独业务来说是一回事:中断!
顺手算笔账。编号什么时候烧完,只看累计事务量,跟并发高不高关系不大:
| 持续写入速率 | 32 位(2³²)编号耗尽时间 |
|---|---|
| 50 TPS | 约 2.7 年 |
| 500 TPS | 约 99 天 |
| 5,000 TPS | 约 9.9 天 |
| 50,000 TPS | 约 1.0 天 |
这张表最该盯的是第一行。 50 TPS,一天也就 432 万笔,挺不起眼吧?42.9 亿个号照样只够用两年多。 所以回卷这事儿从来不是高并发系统的专利,只要你的库打算长期跑,就躲不开。
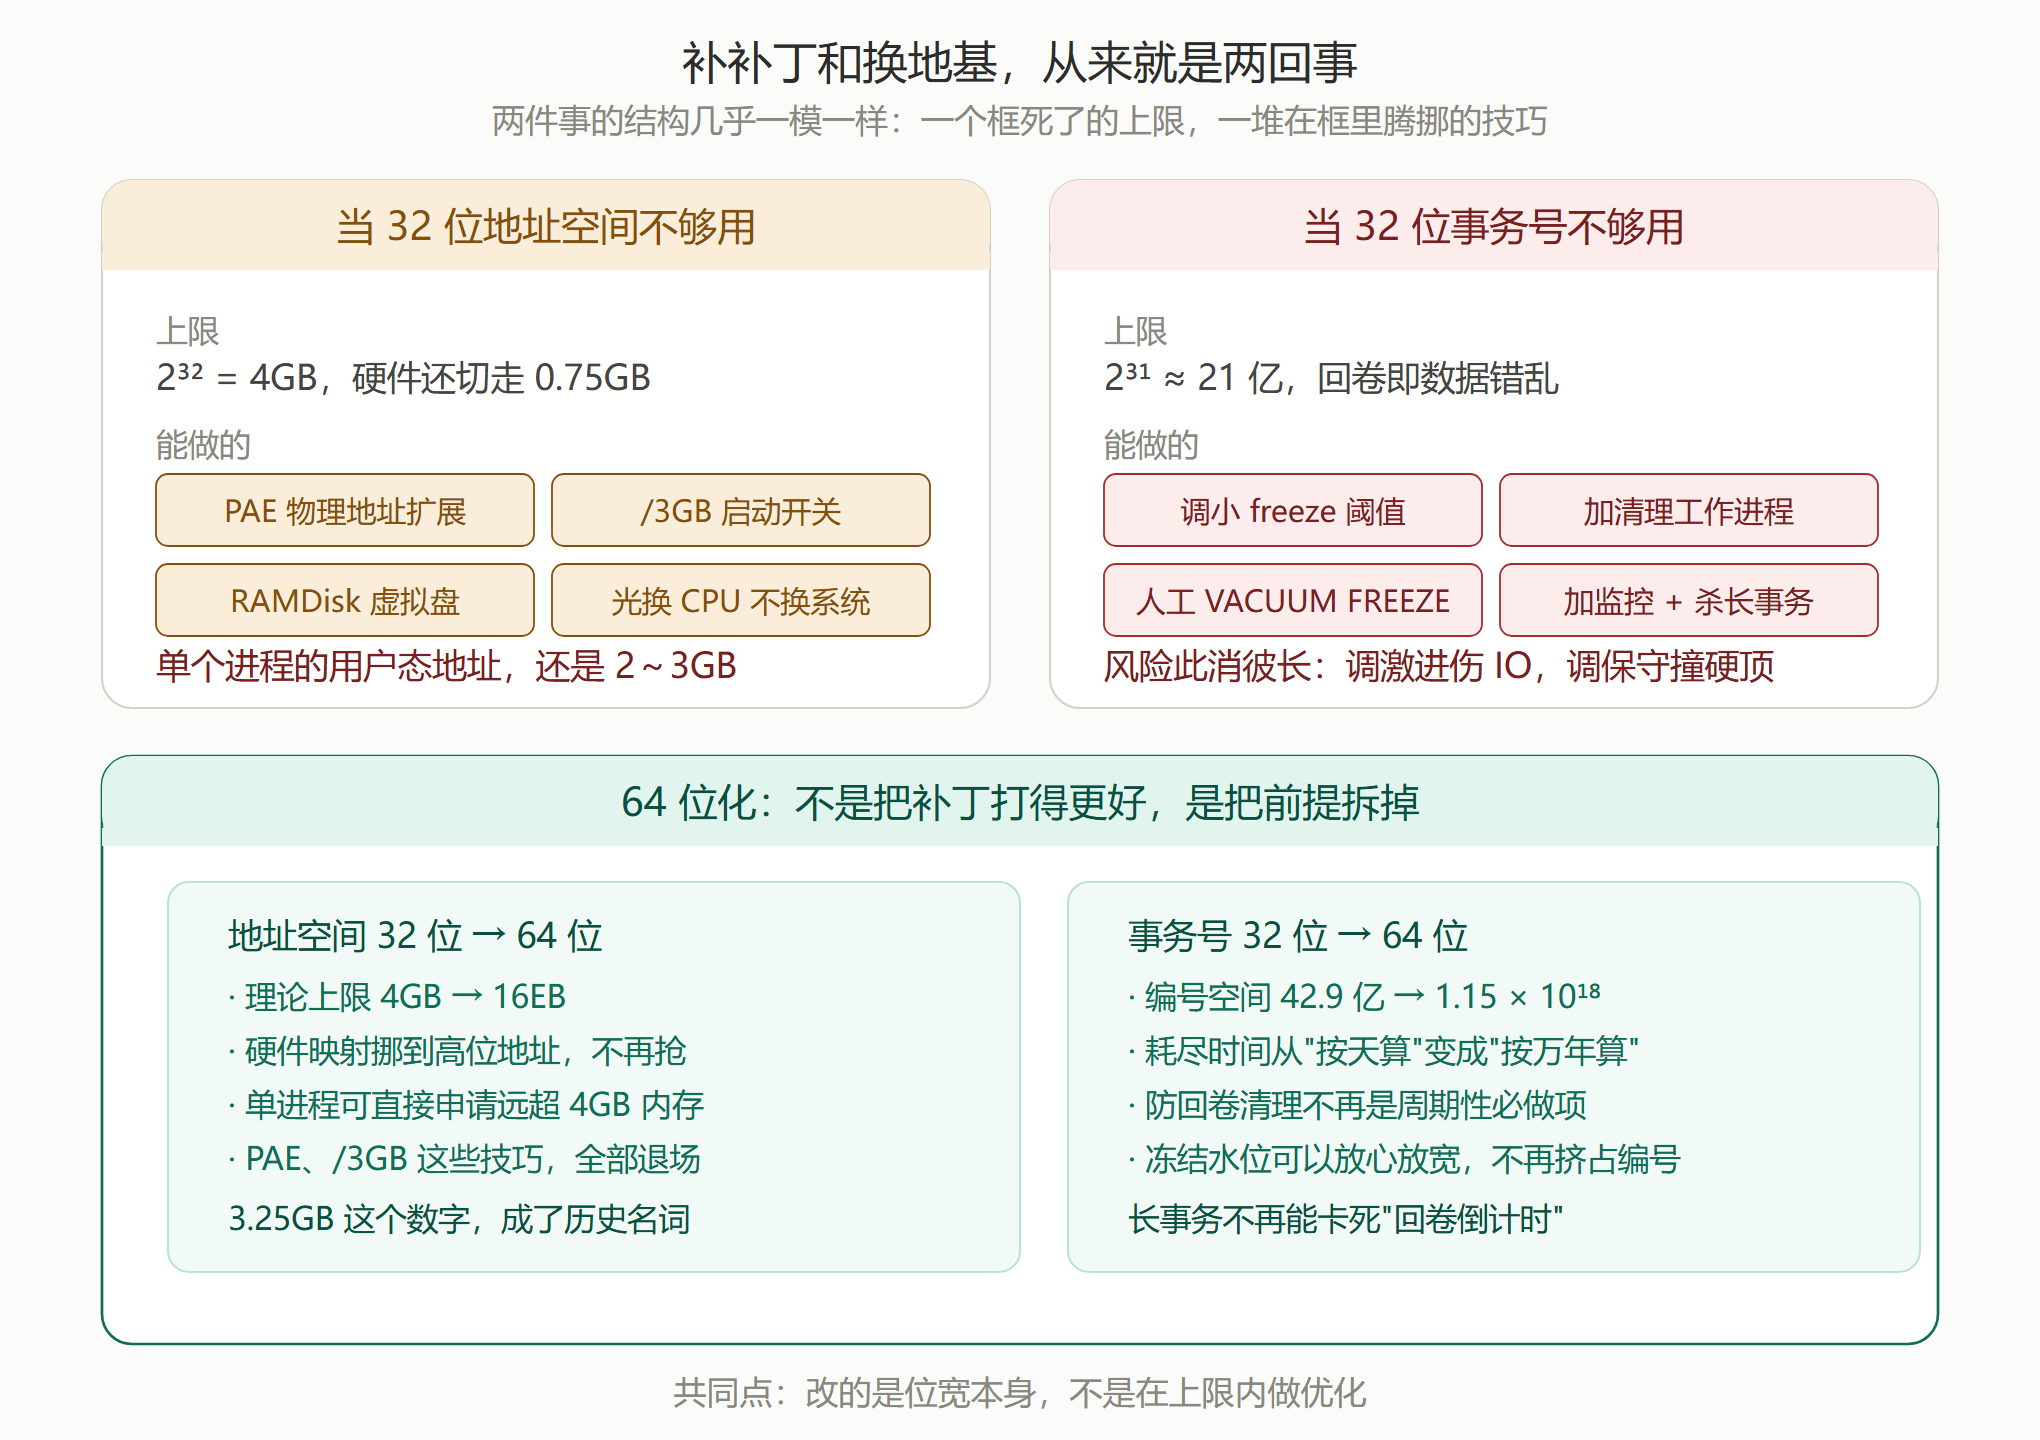
于是 32 位那几年攒下了一整套手艺:调小 autovacuum_freeze_max_age 让清理勤快点、多开几个清理进程、半夜人工 VACUUM FREEZE、盯监控、杀长事务……
有用吗?有用。但都在 21 亿这个框里腾挪,而且 按下葫芦浮起瓢,调得激进,冻结风暴来得更勤;调得保守,离硬顶更近。
眼熟不?这像不像数据库版的 PAE、/3GB 和 RAMDisk。
四、64 位:把天花板直接掀了
V009R002C016 干的事,跟当年 64 位系统普及是一个路数—— 不陪你打补丁,直接换地基。
编号空间从 2³² 一路放到 2⁶⁰ − 1:
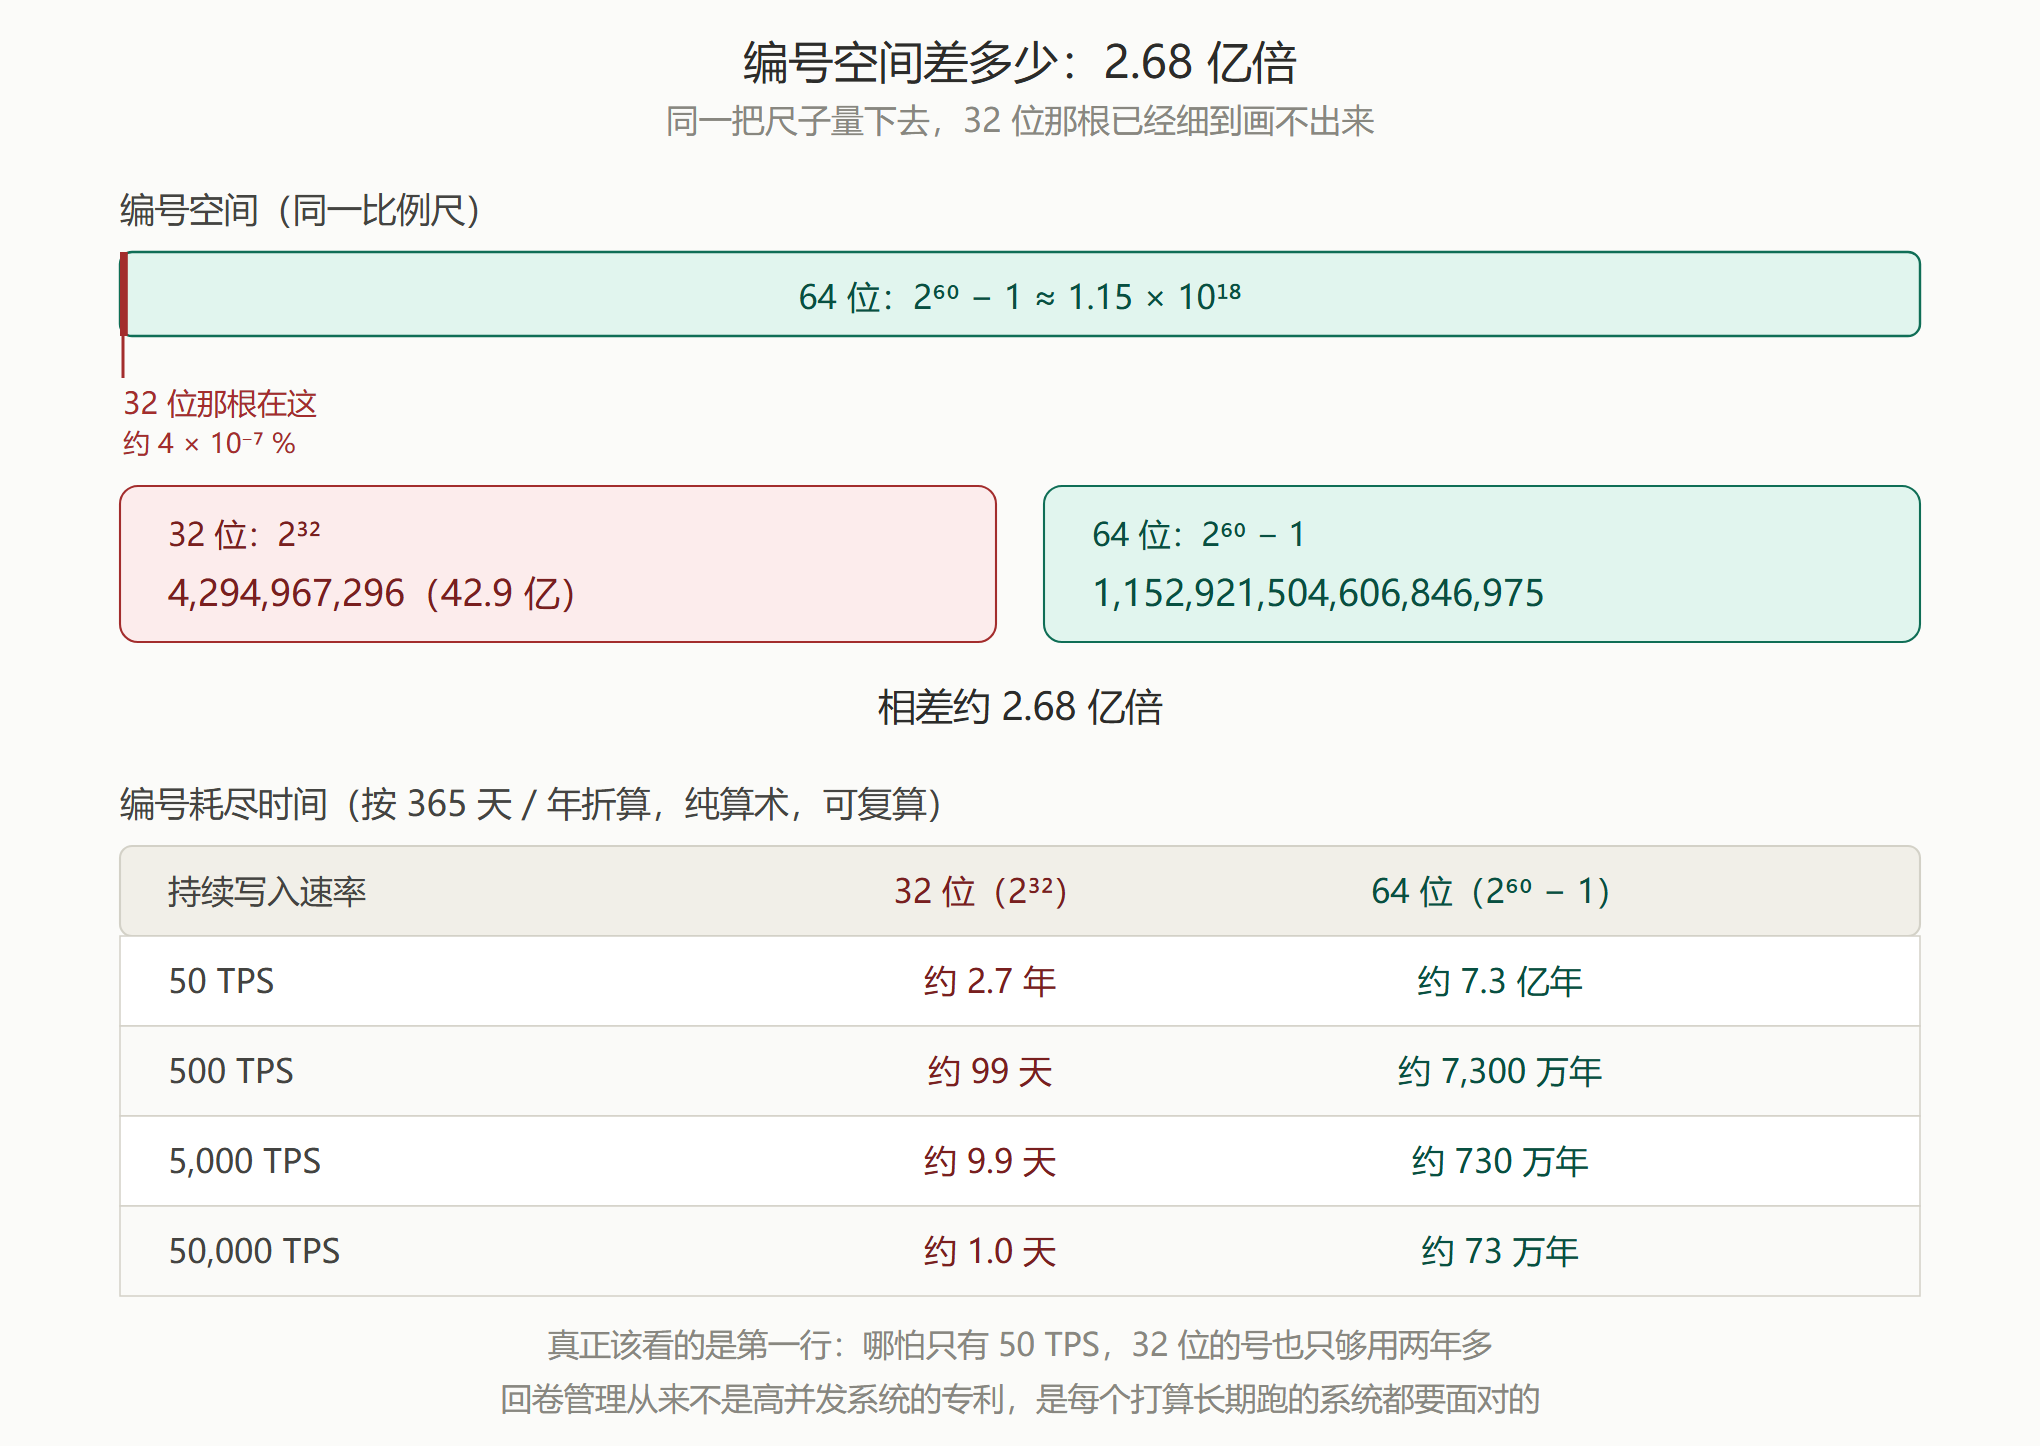
同一把尺子量下去,32 位那根已经细得画不出来了。
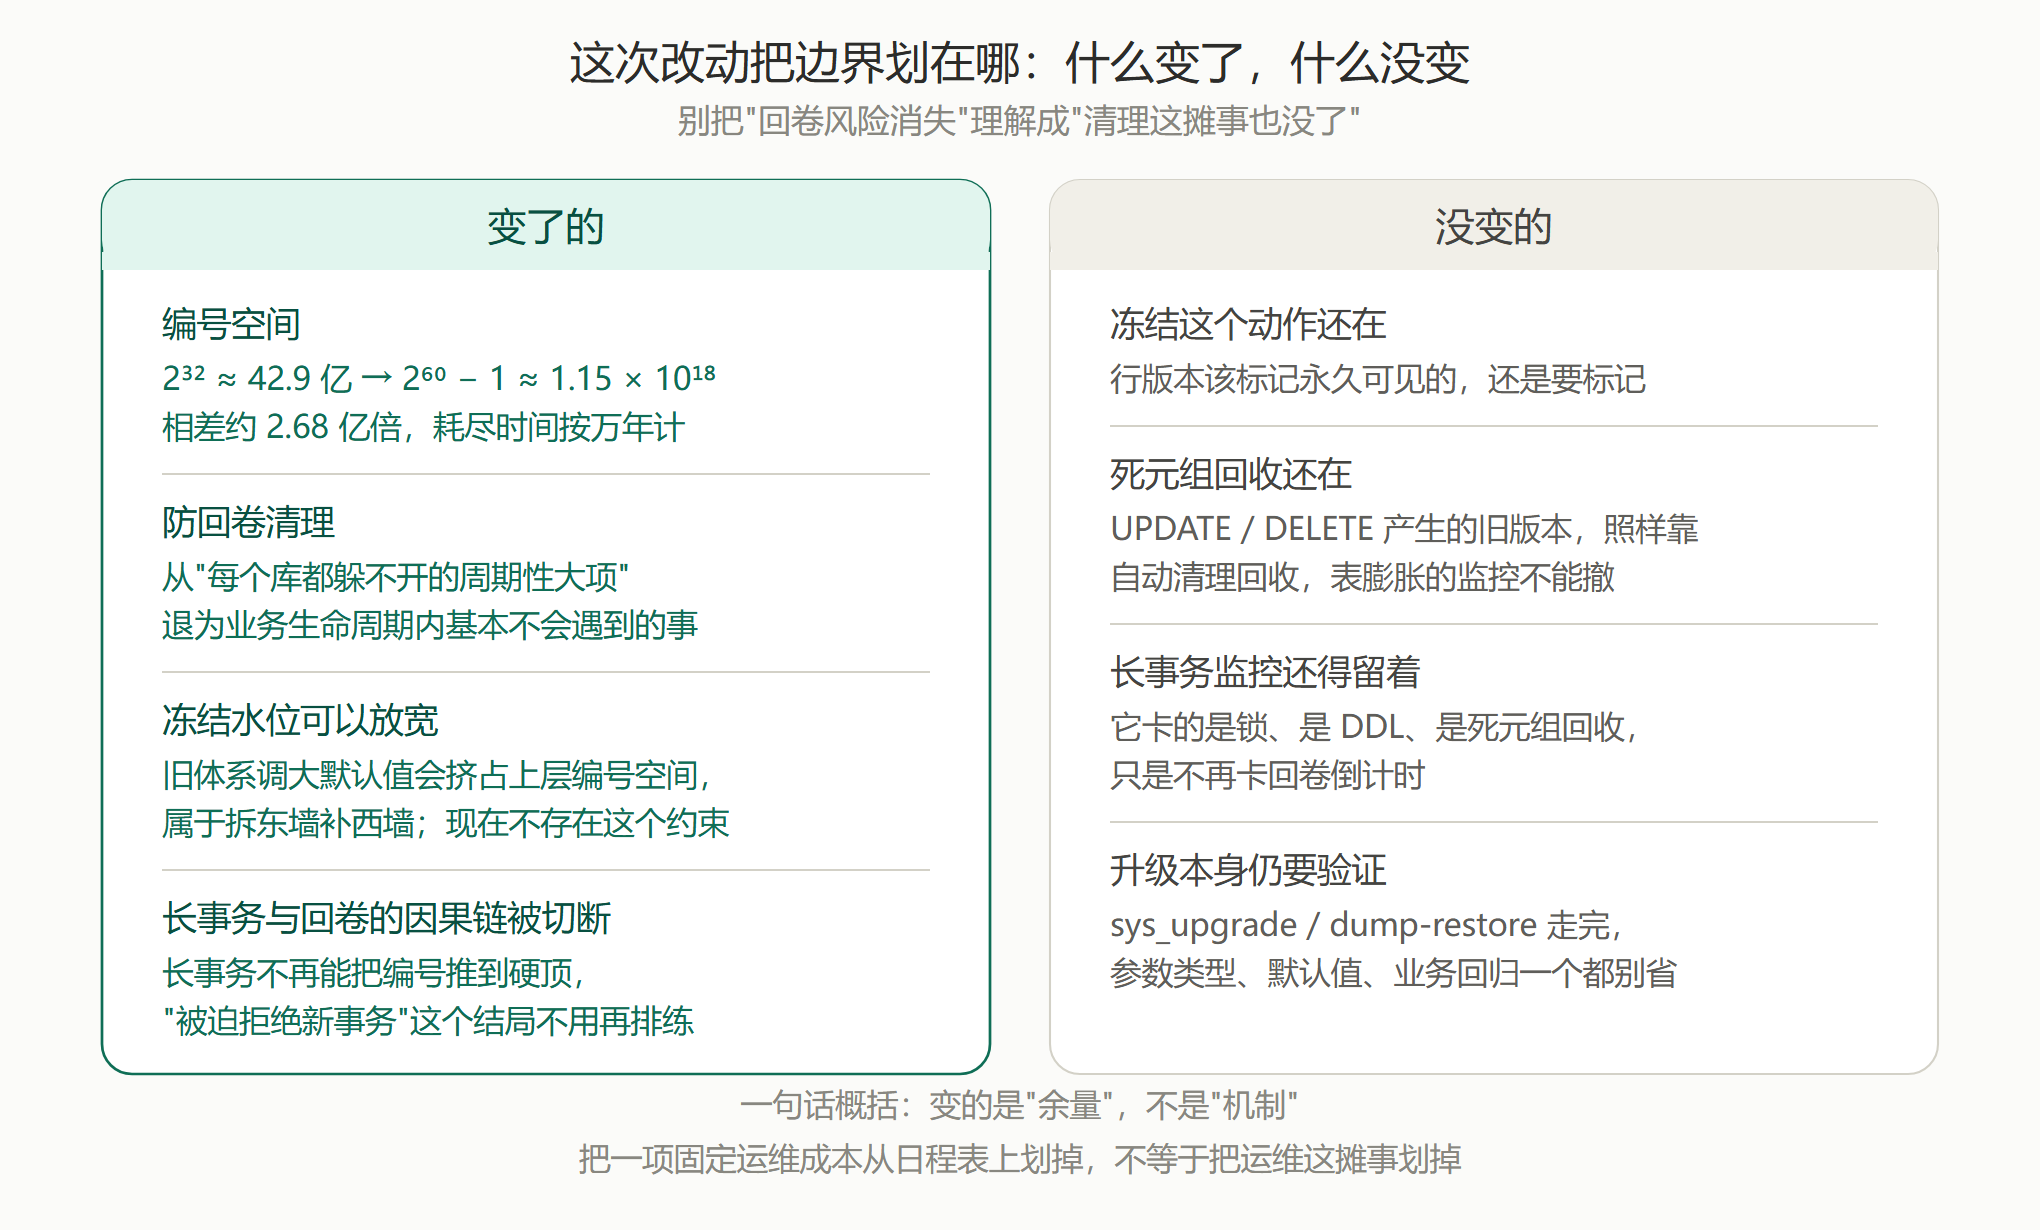
变化落到运维上,其实就是两句话:
- 防回卷清理从"每个库都躲不开的周期性大项",变成"业务生命周期里基本碰不上的事";
- 长事务再也没本事把编号推到硬顶,"被迫拒绝新事务"这个剧本可以撕了。
不过有话得说前头——别把这事儿想岔了:
- 冻结这个动作还在。 该标"永 久可见"的行版本照样要标,只是不用掐着截止日赶工;
- 死元组回收还在。 UPDATE / DELETE 产生的旧版本还得靠自动清理收,表膨胀的监控不能撤;
- 长事务还得盯。 它卡的是锁、是 DDL、是死元组回收,只是不再卡回卷倒计时;
- 升级该测还得测。 sys_upgrade 也好 dump-restore 也好,走完之后参数类型、默认值、业务回归一个都别省。
说到底: 变的是余量,不是机制。 把一项固定运维成本从日程表上划掉,不等于把运维这摊事也划掉。
五、七个参数
这次跟着变的还有 7 个 VACUUM / 自动清理参数,类型和取值范围一起升级了。别当成"数字变大"的清单扫一眼就过——那样会读漏。
这 7 个参数其实是自动清理在"冻结"这件事上的 三道水位线,外带一条延迟带:
| 水位线 | 参数 | 它管什么 |
|---|---|---|
| 行级起冻线 | vacuum_freeze_min_age | 行版本的事务号多"老"才值得改写冻结标记 |
| 表级全表线 | vacuum_freeze_table_age | 越过此线,清理放弃只扫脏页,升级为整表扫描 |
| 库级强制线 | autovacuum_freeze_max_age | 最后一道防线:到龄强制启动防回卷清理 |
| 延迟带 | vacuum_defer_cleanup_age | 清理动作的保险带,为备库仍依赖旧版本的场景留缓冲 |
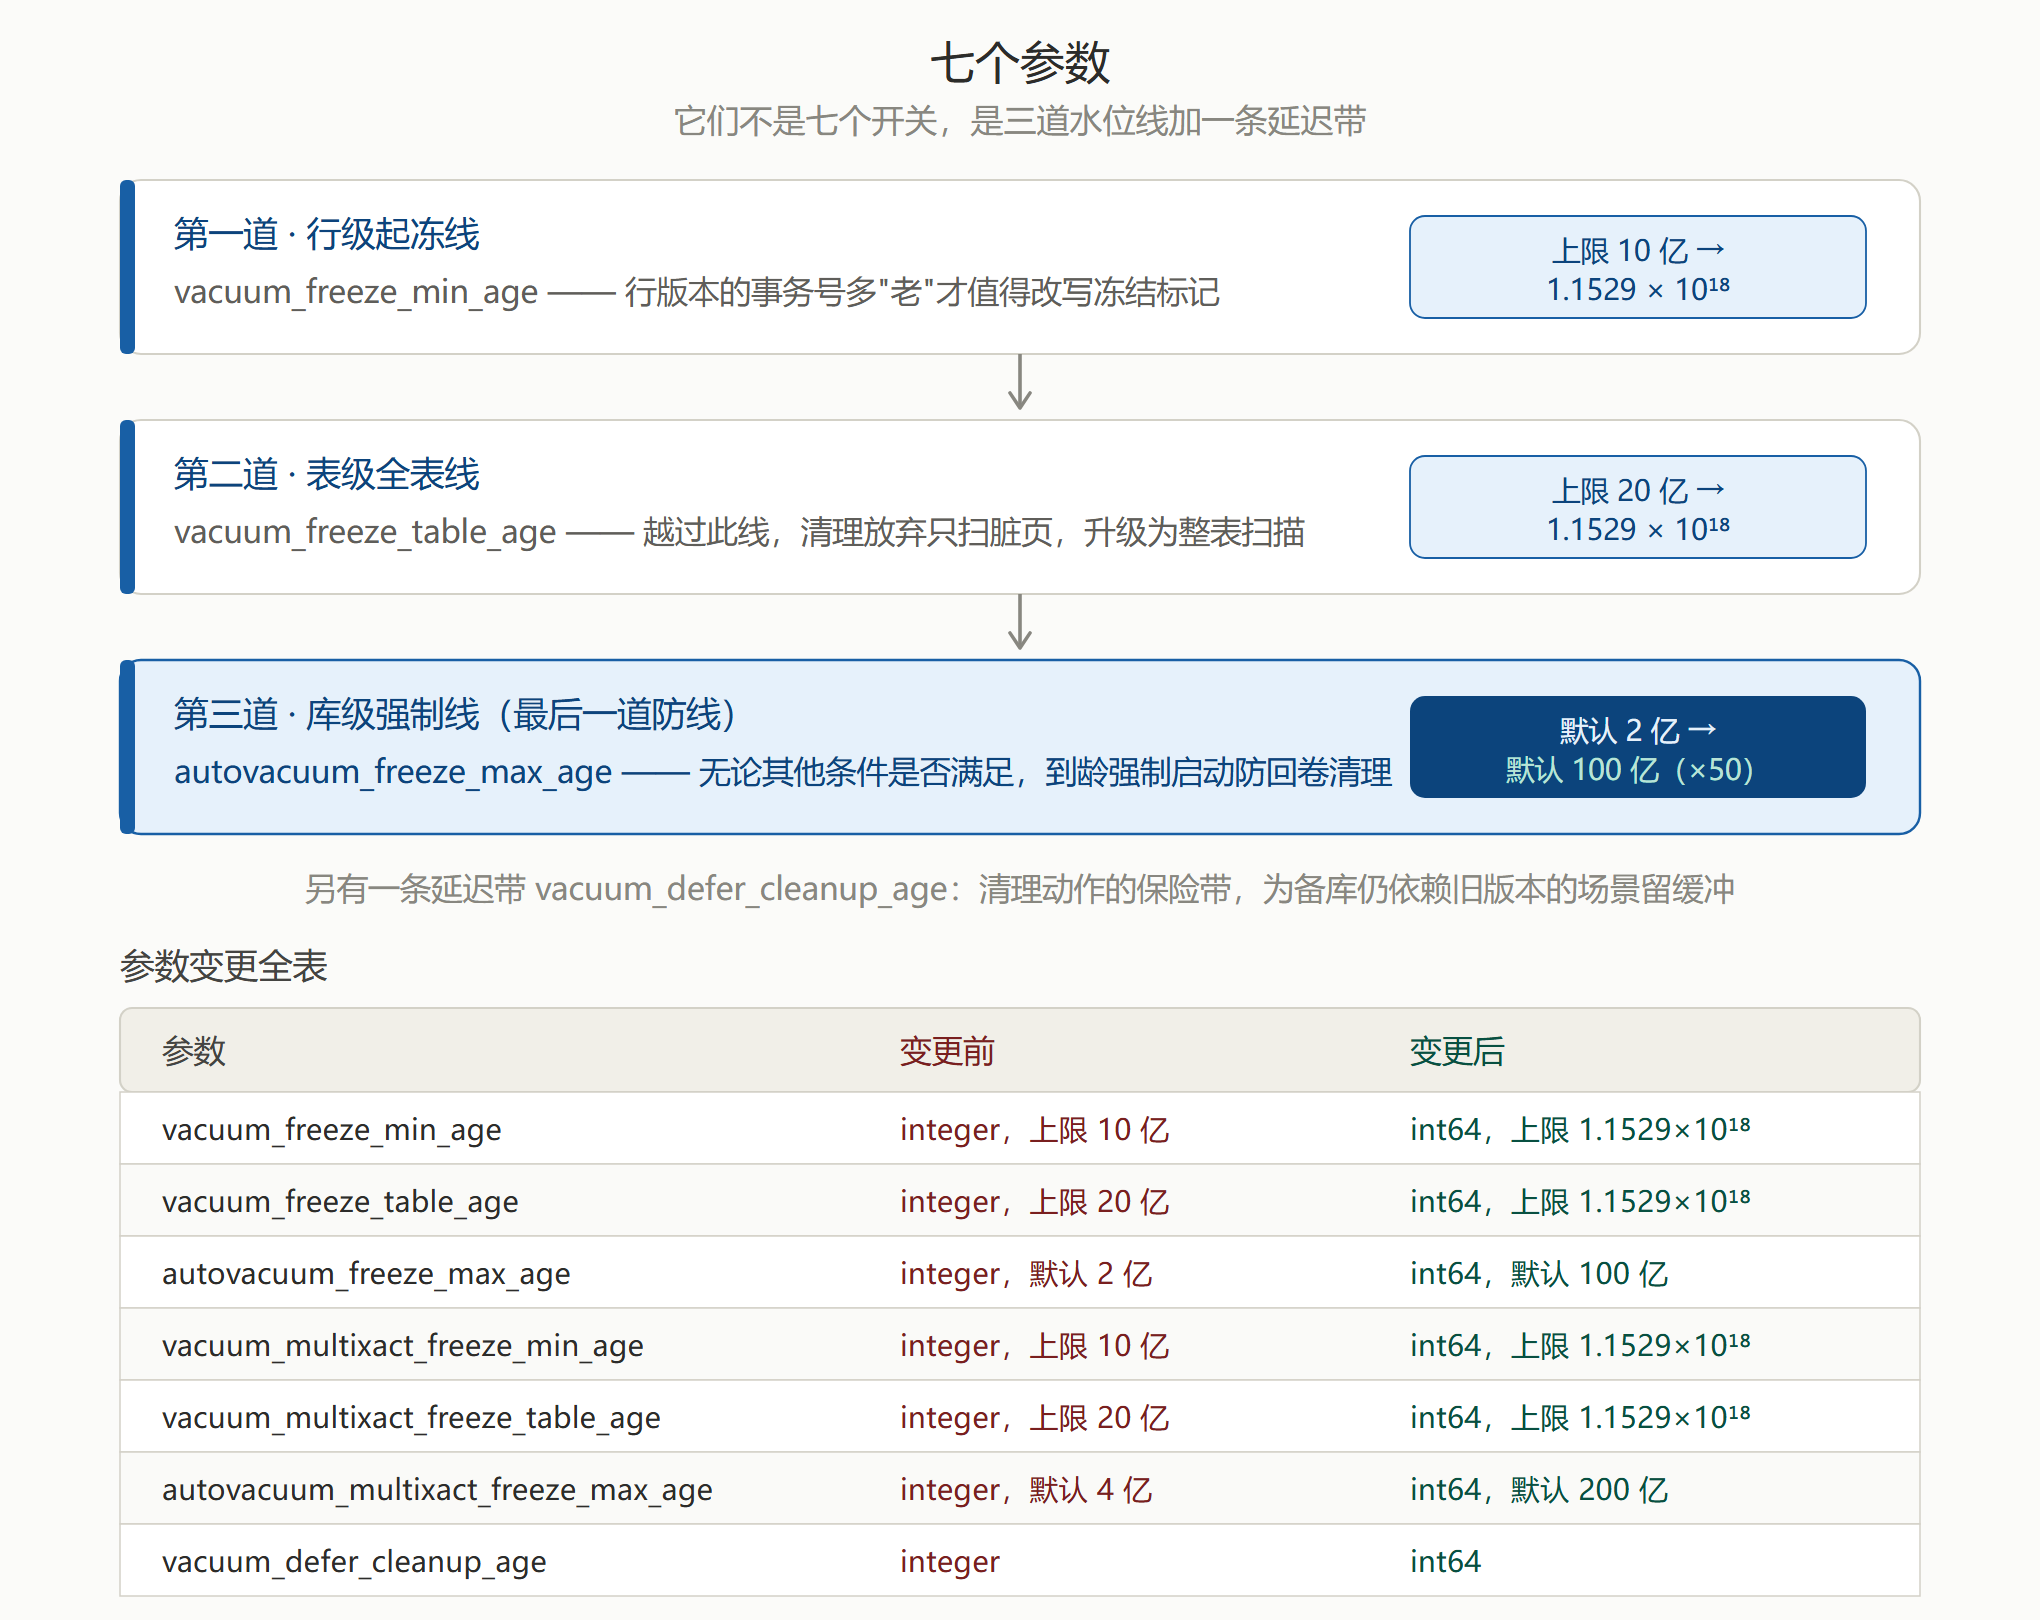
在这些参数中最值得说的是库级强制线 autovacuum_freeze_max_age:默认从 2 亿提到 100 亿,足足翻了 50 倍。
这儿有个老体系下的死结,值得掰开讲: 32 位时代你其实不敢把这个默认值往上调。 21 亿的硬顶就杵在那儿,默认值设得越高,留给系统的缓冲越薄,这就是纯属拆东墙补西墙。所以默认的 2 亿只占硬顶的 9%,防回卷清理也就成了每个库的例行公事。
64 位之后这个约束没了:100 亿只占新上限的约 1.15 亿分之一,放宽水位一分钱代价都不用付。
再来个有体感的数字:一个 50 TPS 的小系统,默认 2 亿意味着大约 46 天就得来一次防回卷清理;换成 100 亿,间隔拉到约 6.3 年。 而且这不是你调参调出来的,是编号空间撑开之后自己掉下来的。
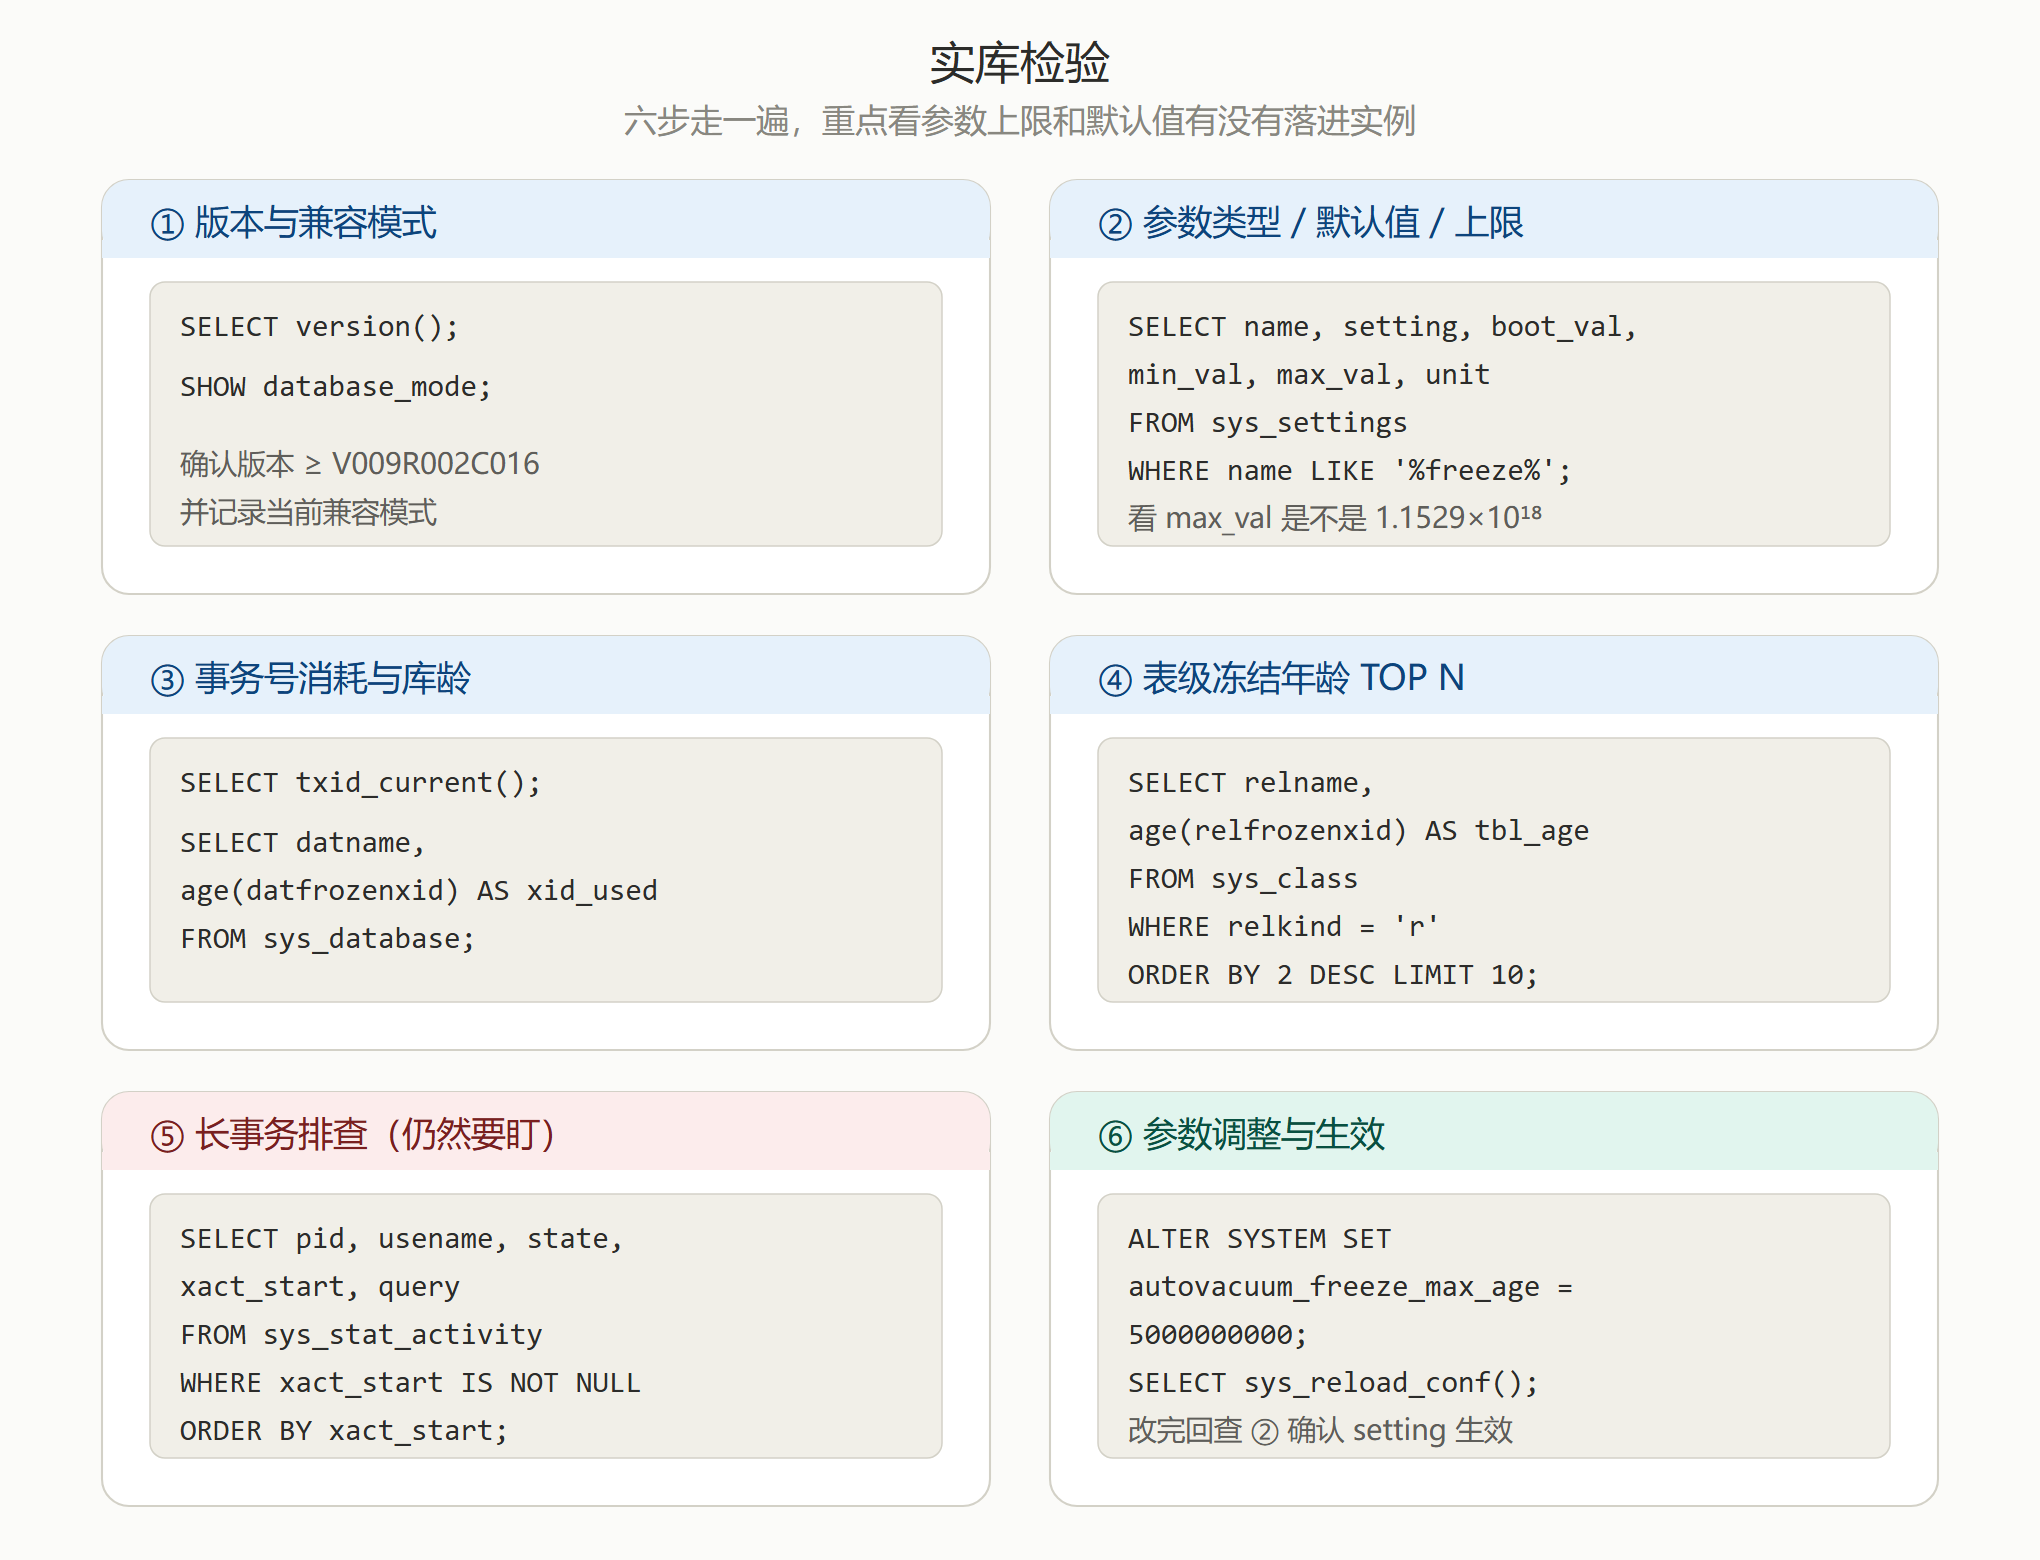
六、实库检验
本期跟随总监,先把要用的 SQL 摆出来——后面我会装一套对应版本真跑一遍,到时候再补实测回显。你着急的话,直接拿去用也行。
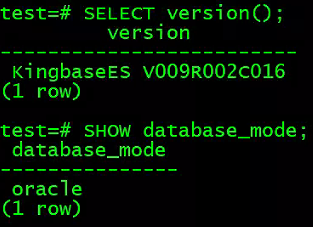
1. 版本与兼容模式
SELECT version();
SHOW database_mode;
2. 参数类型 / 默认值 / 上限
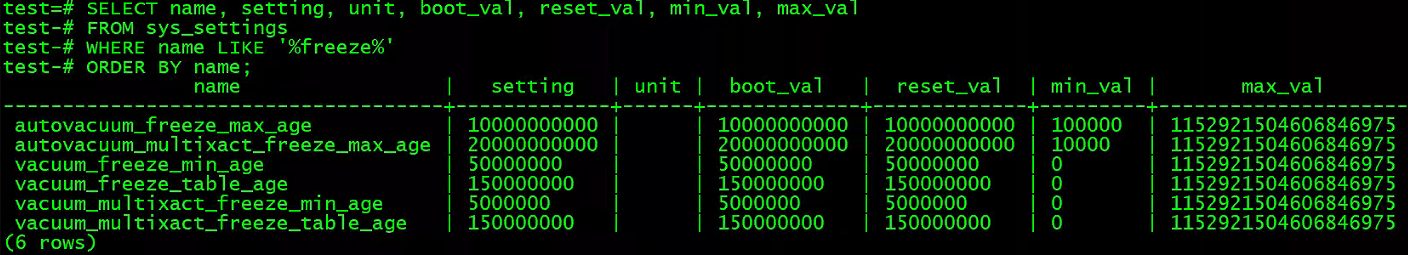
重点看 max_val 是不是 1,152,921,504,606,846,975,以及 autovacuum_freeze_max_age 的默认值是不是 10,000,000,000:
SELECT name, setting, unit, boot_val, reset_val, min_val, max_val
FROM sys_settings
WHERE name LIKE '%freeze%'
ORDER BY name;
3. 当前事务号消耗
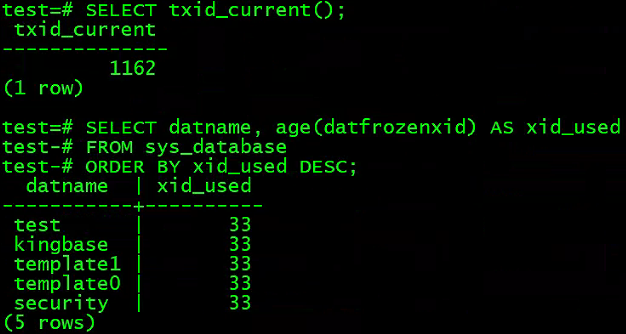
SELECT txid_current();
SELECT datname, age(datfrozenxid) AS xid_used
FROM sys_database
ORDER BY xid_used DESC;
4. 表级冻结年龄 TOP N
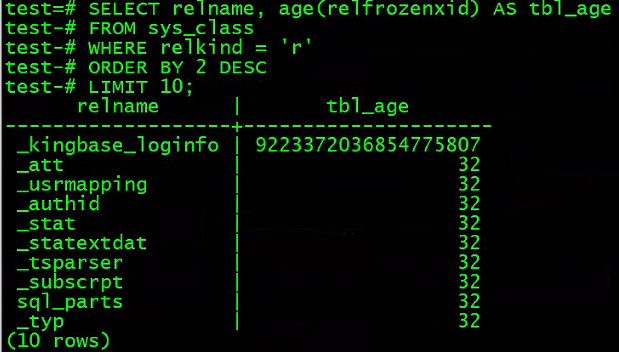
SELECT relname, age(relfrozenxid) AS tbl_age
FROM sys_class
WHERE relkind = 'r'
ORDER BY 2 DESC
LIMIT 10;
5. 长事务排查(这个仍然要盯)
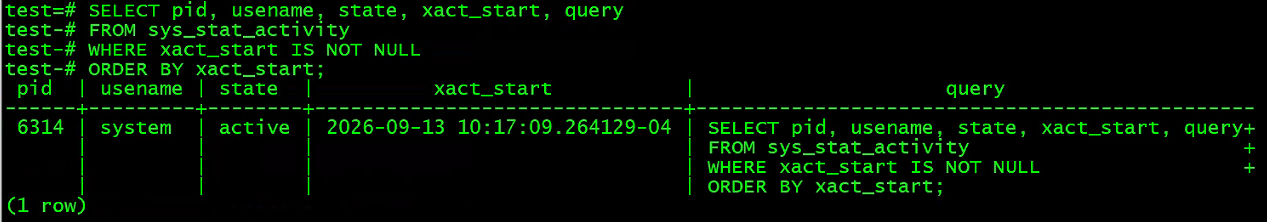
SELECT pid, usename, state, xact_start, query
FROM sys_stat_activity
WHERE xact_start IS NOT NULL
ORDER BY xact_start;
6. 参数调整与生效
ALTER SYSTEM SET autovacuum_freeze_max_age = 5000000000;
SELECT sys_reload_conf();

总结
评估一个数据库特性,我习惯先分它属于哪一类:是"性能涨了百分之多少",还是"把某一类故障从运维清单里划掉了"。64 位事务 ID 是后者。
涨百分之多少,可以折成 QPS、折成钱。可"防回卷清理不用再排期、长事务不再有回卷倒计时"这种事,价值在于 把一类平时没感觉、一出事就要命的故障归了零,而且是那种得凌晨爬起来进单用户模式救火的要命。
所以我的建议:
- 新建系统:直接用,别犹豫,这属于装上就赚到的改动;
- 老系统升级:无论是原地升级或者迁移都行,升完重点检查并按需调整对应 7 个参数的类型和默认值, 32 位时代那套 freeze 调参经验别原样搬,那是在"21 亿"这个紧箍咒下逼出来的,现在环境变了;
- 监控项:长事务、死元组、表膨胀三样照旧,事务号剩余空间这条告警可以降级,但别就不做了!
回到开头那个 3.25GB。当年真正把事儿解决了的,不是哪个更聪明的补丁,而是有人拍板把地址位宽加宽,补丁们随之集体退休。
这次是同一个故事: 编号空间撑开之后,"回卷管理"这项背了几十年的固定成本,就有可能退场。
老规矩,知道写了些啥。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31466763/viewspace-3182269/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 胖头鱼的技术专栏-479 如何高效地将喂给 AI 的数据搬过去(20261015)
- 胖头鱼的技术专栏-478 Agent 成了新用户,数据库要接住它的下一步(20261014)
- 胖头鱼的技术专栏-477 26ai新特性实战:表达式分区(20261013)
- 胖头鱼的技术专栏-476 26ai新特性实战:聚合过滤(20261012)
- 胖头鱼的技术专栏-475 蹭到最后,就没人摆摊了(20261010)
- 胖头鱼的技术专栏-474 从能跑到能上线:PG SplitJSON 0.2.0 和 0.1.0 差在哪
- 胖头鱼的技术专栏-473 26ai新特性实战:日历函数(20261004)
- 胖头鱼的技术专栏-473 改JSON的一个字段不再重写整篇:我给PostgreSQL 18写了个扩展
- 胖头鱼的技术专栏-472 26ai新特性实战:无 FROM 子句的 SELECT 语句(20261003)
- 胖头鱼的技术专栏-471 数据库优化的三层楼——为什么多数人总在第二层打转
