1、Table Access Operations
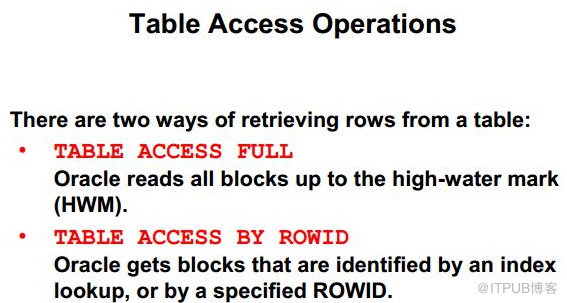
在Oracle数据库中SQL访问表的数据有2种方式:
- TABLE ACCESS FULL、
-
TABLE ACCESS BY ROWID
- Full Table Scans
全表扫描使用多块读,通过参数db_file_multiblock_read_count设置单次IO可以读取的数据块数。
当Oracle服务器使用串行全表扫描读取块时,他们使用least
recently used(LRU)的缓冲区缓存LRU列表。对于parallel(并行)扫描,当查询数据块不在缓冲区时,数据块的读写采用direct I/O方式直接读入子查询进程的PGA中。
如果查询行数较多(超过10%)或使用并行查询时使用全表扫描会比较高效。否则,索引扫描会比较高效。
高水位是表中最后一个使用的数据块。如果删除表中的数据,该表的所有数据块或部分数据块可能为空,但全表扫描仍然会读该块。即全表扫描从高水位以下读取,优化方法,降低高水位。
- Table Access by ROWID
先访问索引获取ROWID,然后使用ROWID获取需要的业务数据。
2、Index Access Operations
-
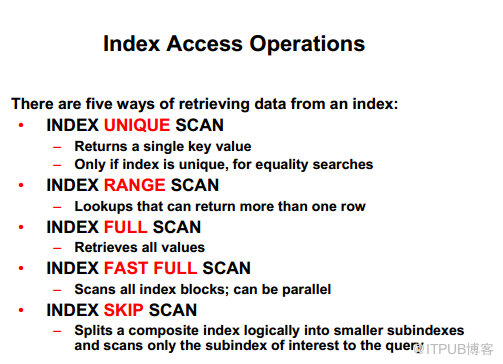
Index Unique Scan
该索引查询是基于constraints or unique indexes,查询结果为唯一值,或无查询结果。
- Index Range Scan
该索引查询是基于所有nonunique index,可能有多个结果返回,使用的谓词查询条件为(for example: BETWEEN, < or >)。
- Index Full Scan
索引全扫描返回排序后的数据,通过CBO判定索引全扫描的访问方法比全表扫描后再排序更
高效,但索引全扫描不能使用多块读。
- Index Fast Full Scan
使用基于CBO时,才会出现Index fast full scan。
只有当至少一个列的索引不为空时,Oracle服务器使用index full scan (否则无法保证所有列会被查询出来)
- Index fast full scan
可以使用多块读和并行操作,但不一定会按照顺序返回数据。当索引包含所有需要查询的列时,会使用Index fast full scan。Index fast full scans不返回ROWID,进行回表查询,因为该操作不需要没有意义。
- Index skip scan
当查询条件没有指定前导列,并且指定非前导列时出现。Index skip scan在逻辑上将复合索引划分为更小的子索引。逻辑索引分区的数量取决于前导列distinct values数量
。前导列distinct values越小性能越好,否则性能越差。例如,假设您有以下(性别、
EMPLOYEE_ID)索引数据:
(' F ',98)
(' F ',100)
(' F ',102)
(' F ',104)
(' M ',101)
(' M ',103)
(' M ',105)
该索引在逻辑上分为以下两个字索引:
——第一个子索引F键值。
——第二个子索引M键值。
性别列是跳过以下查询:
SQL > select *
2 from employees
3 where employee_id = 101;
不执行完整的索引扫描。相当于以下执行,
首先执行: select * from employees where employee_id = 101 and GENDER='F' ;
然后执行:select * from employees where employee_id = 101 and GENDER='M' ;
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31442014/viewspace-2678261/ ,如需转载,请注明出处,否则将追究法律责任。
上一篇:
微课sql优化(9)、如何获取执行计划

请登录后发表评论
登录
全部评论
