一、小说数据的获取
获取的数据为起点中文网的小说推荐周榜的所有小说信息。
源代码对所有想要获取的数据都有注释。
http://dxb.myzx.cn/grandmal/
# -*- coding: utf-8 -*-"""
Created on Mon Jan  4 22:59:11 2021
"""import requestsfrom bs4 import BeautifulSoupimport os.pathimport csvimport timeimport pymysqlimport randomclass DrawBookMessage():
    def __init__(self):

        """
        定义构造函数,初始化最初网址,方便后面调用,不必重复写
        """
        self.baseUrl='https://www.qidian.com/rank/recom';
        #定义baseurl目标网址

    def User_Agent(self):
        """
        定义5个代理IP隐藏身份,用5个IP随机选取,以防止被检测到链接对象而终止访问
        """
        user_agent1 = 'Mozilla/5.0 (Windows NT 6.2; WOW64; rv:21.0) Gecko/20100101 Firefox/21.0'
        user_agent2 = 'Mozilla/5.0 (Linux; Android 4.1.1; Nexus 7 Build/JRO03D) AppleWebKit/535.19 (KHTML, like Gecko) Chrome/18.0.1025.166 Safari/535.19'
        user_agent3 ='Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/51.0.2704.103 Safari/537.36'
        #user_agent4 ='Mozilla/5.0 (Android; Mobile; rv:14.0) Gecko/14.0 Firefox/14.0'
        #这个代理在我的开发环境中会发生访问错误,作者注释在这里,便于提醒自己
        user_agent5 ='Mozilla/5.0 (iPad; CPU OS 5_0 like Mac OS X) AppleWebKit/534.46 (KHTML, like Gecko) Version/5.1 Mobile/9A334 Safari/7534.48.3'
        lst = [user_agent1,user_agent2,user_agent3,user_agent5]
        return random.choice(lst)#返回随机IP
    def getHtml(self,url):
        """
        通过随机IP访问网页获取网页的内容
        """
        user_agent = self.User_Agent()#获取随机IP
        headers = {"User-Agent":user_agent}
        request = requests.get(url,headers=headers).text#通过IP访问网页,并且获取网页内容请求
        return request #返回

    def commonsdk(self,url):
        """
        把文本类型转换为<class 'bs4.BeautifulSoup'>类型,
        之后还会用BeautifulSoup库来提取数据,如果这不是一个BeautifulSoup对象,
        我们是没法调用相关的属性和方法的,所以,这是非常重要。
        """
        html = self.getHtml(url)
        doc=BeautifulSoup(html,'lxml')#转换为BeautifulSoup对象
        return doc
    def get_page_size(self,url):
        '''获取页面总数'''
        doc = self.commonsdk(url)
        self.pageNum = doc.find("div",class_="pagination fr")['data-pagemax']
        return int(self.pageNum)

    def draw_base_list(self,url):
        '''初级网页内容'''
        doc = self.commonsdk(url)
        listt=doc.find('div',class_ = "book-img-text").find_all('div',class_ = 'book-mid-info')
        for x in listt:
            self.bookName = x.find('h4').text.strip()#书名
            self.bookUrl ='https:'+x.find('h4').find('a')['href']#书的二级网址
            self.bookAuthor = x.find('p').find(class_='name').text.strip()#
            self.bookType = x.find('p').find('a',class_='').text.strip()#小说的类型
            self.bookStatus = x.find('p').find('span').text.strip()#小说更新的状态
            self.draw_Second_list()#调用获取二级网页内容
            self.dict_data()#调用生成字典的函数


    def draw_Second_list(self):
        '''获取二级网页内容'''
        doc = self.commonsdk(self.bookUrl)
        listt1 = doc.find('div',class_="book-info")
        self.bookIntrodaction = listt1.find(class_="intro").text.strip()#获取小说简介
        listt2 = doc.find(class_="fans-interact cf")
        if listt2.find(class_ ='ticket rec-ticket')==None:#ticket rec-ticket为空,ticket rec-ticket hidde不为空,有月票的标签
            self. monthTickets = listt2.find(class_ ='ticket month-ticket').find(class_ = 'num').text#小说月票
            self. weekTickets =  listt2.find(class_ ='ticket rec-ticket hidden').find(class_ = 'num').text#小说周票
        if listt2.find(class_ ='ticket rec-ticket hidden')==None:#ticket rec-ticket不为空,ticket rec-ticket hidde为空,没有有月票的标签
            self. monthTickets=0#没有月票标签时,月票为0
            self. weekTickets =  listt2.find(class_ ='ticket rec-ticket').find(class_ = 'num').text #小说周票
        self.weekWardNum = listt2.find(class_= 'rewardNum').text#小说本周打赏人数


    def dict_data(self):
        """
        定义一个人方法生成需要存入数据的字典
        """
        ctime = time.strftime('%Y-%m-%d %H:%M:%S',time.localtime());#当前爬取时间
        data={
                '书名':self.bookName,
                '作者':self.bookAuthor,
                '类型':self.bookType,
                '状态':self.bookStatus,
                '月票':int(self. monthTickets),
                '周票':int(self.weekTickets),
                '本周打赏人数':int(self.weekWardNum),
                '本书简介':self.bookIntrodaction,
                '爬取时间':ctime
                }
        print(data)
        print("="*50)
        self.write_to_MySQL(data,"spiders","bookMessage")#写入数据库
        self.write_to_scv(data,'bookMessage.csv')#写入.CVS文件
        pass

    def write_to_scv(self,dic,filename):
        """写入csv文件"""
        file_exists = os.path.isfile(filename)#判断是否为文件
        with open(filename, 'a',encoding='gb18030',newline='') as f: #a表示追加模式不覆盖原文件中的内容,newline = "" 表示读取的换行符保持不变,原来是啥,读出来还是啥
            headers=dic.keys()
            w =csv.DictWriter(f,delimiter=',',lineterminator='\n',fieldnames=headers)#创建一个对象
            if not file_exists :
                 w.writeheader()
            w.writerow(dic)#单行写入
        print('当前行写入csv成功!')
        pass

    def write_to_MySQL(self,dic,database,table_name):
        """ 写入数据库"""
        keys = ', '.join(dic.keys())
        values = ', '.join(['% s'] * len(dic))#动态的构造占位符
        db = pymysql.connect(host='localhost', user='root', password=(自己的数据库密码), port=3306, db=database)#连接数据库
        cursor = db.cursor()#数据库连接对象
        sql = 'INSERT INTO {table}({keys}) VALUES ({values})'.format(table=table_name, keys=keys, values=values)#插入语句
        try:
            if cursor.execute(sql, tuple(dic.values())):
                 print('Successful')
                 db.commit()#commit是把查询语句提交到数据库内
        except:
            print('Failed')
            db.rollback()
        cursor.close()#关闭对象
        db.close()#关闭数据库释放资源

  if __name__ == '__main__':
    """主函数"""
    drawBook = DrawBookMessage()
    page = drawBook.get_page_size(drawBook.baseUrl)
    for x in range(1,page+1):
        drawBook.draw_base_list(drawBook.baseUrl+'?page='+str(x))
    123456789101112131415161718192021222324252627282930313233343536373839404142434445464748495051525354555657585960616263646566676869707172737475767778798081828384858687888990919293949596979899100101102103104105106107108109110111112113114115116117118119120121122123124125126127128129130131132133134135136137138139140141142143144145
看到这里不知道是否对你有所帮助?看不懂的可以评论区留言,顺便点个赞。嘻嘻嘻嘻嘻嘻!

二、数据的分析与可视化
http://ask.baikezh.com/
相信大家对pandas都有了解吧,我就直入主题——数据分析。
2.1、Python读取数据表时,有时候会发生一个很顽固的错误

在这里一般性如果表中有中文的话,读表的时候就会报这个错误,这里把默认编码改为gbk一般就能解决这个问题。即encoding=‘gbk’。
2.2、查看表的统计信息
(1)describe()查看表的相关信息信息
data.describe()
   # count:数量统计,此列共有多少有效值
   #std:标准差
   #min:最小值
   #25%:四分之一分位数
   #50%:二分之一分位数
   #75%:四分之三分位数
   #max:最大值
   #mean:均值123456789
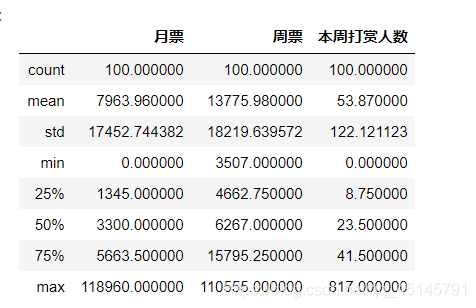
通过这个结果可以得出各票数的情况和打赏的人数。
(2)根据周票数对小说排序
我们通过排序可以筛选出周票数前5的小说
data.sort_values(by = '周票',ascending = False).head(5)1
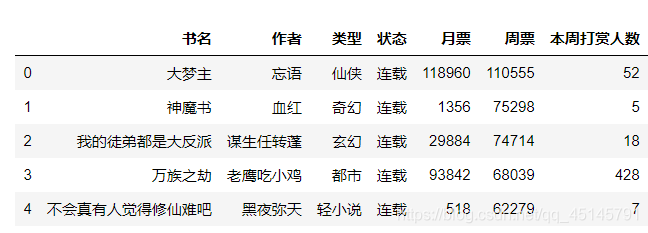
可以知道当前这5本小说人气很高。很多人还喜欢看完结的小说,毕竟一次性看完的感觉特别爽。我们也把几本完结的小说获取出来
data.loc[data['状态']=='完本'].sort_values(by = '周票',ascending = False)1

可以得出最近100流行小说中只有2本是完结的。
2.3可视化图分析
http://ask.baikezh.com/anhui/
(1)折线图
对于读者,都有不同的喜好都市、有的喜好玄幻、有的喜欢轻小说……让我们看一下最近这些小说各票数综合情况。通过下面打代码可以得出折线图情况。
import matplotlib.pyplot as pltimport pandas as pdimport numpy as np
plt.rcParams['font.sans-serif'] = ['SimHei'] #解决横坐标不能显示中文的况plt.rcParams['axes.unicode_minus'] = False#解决横坐标不能显示中文的情况#三条纵坐标的值y1 = data.groupby('类型').sum()['本周打赏人数']#求和y2 = data.groupby('类型').mean()['周票']#求平均值y3 = data.groupby('类型').mean()['月票']#求平均值x=list(dict(y1).keys())#横坐标值fig = plt.figure(figsize=(8,6), dpi=100)#指定画布大小plt.plot(x,y1,c='red',label='打赏票和')指定折线的颜色和标签
plt.plot(x,y2,c='green',label='周票均值')plt.plot(x,y3,c='blue',label='月票均值')plt.legend(loc='upper left')#标签靠左plt.ylabel('周票平局值、月票平局值、打赏票和',fontsize=15)改变定横坐标名称以及字体大小。
plt.title("小说票数折线图")#图名plt.xlabel('小说类型',fontsize=15)plt.show()12345678910111213141516171819
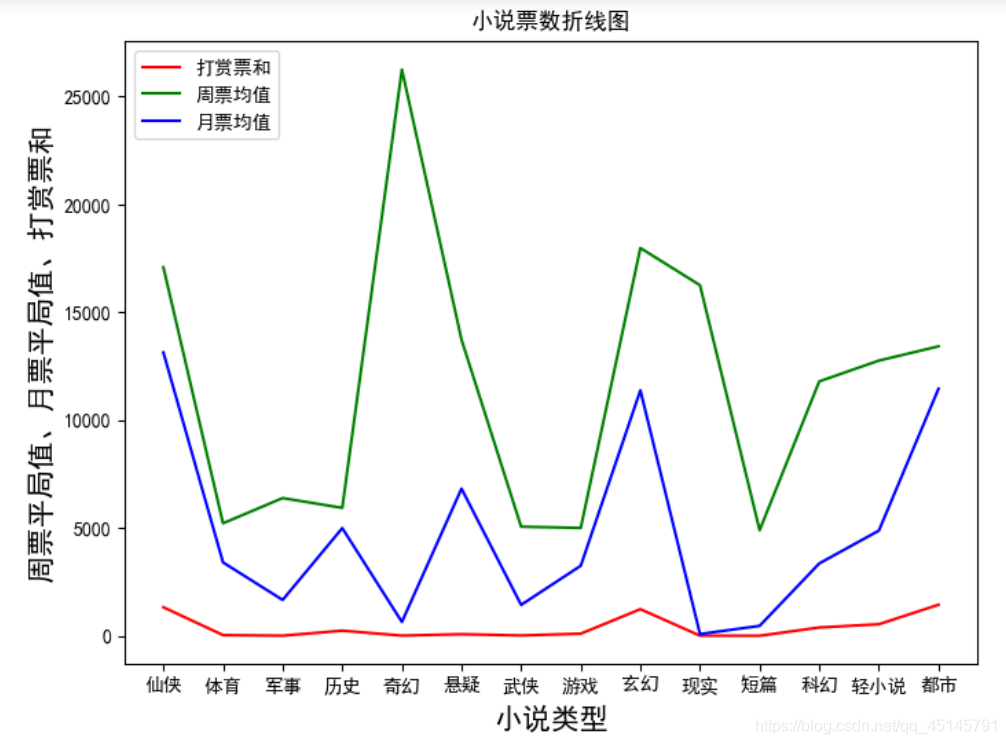
通过折线图可以直观的看书流行的趋势,可以分析到奇幻小说最受欢迎,读者最多。
(2)柱状图
http://ask.baikezh.com/changchun
在这里插入代码片plt.rcParams['figure.figsize']=(8,3)#图形大小data.groupby(['类型']).mean().plot(kind = 'bar')plt.xticks(rotation=0)#横坐标的角度plt.ylabel('number of people',fontsize = 15)#纵坐标名plt.xlabel('Date',fontsize = 15)#横坐标名12345
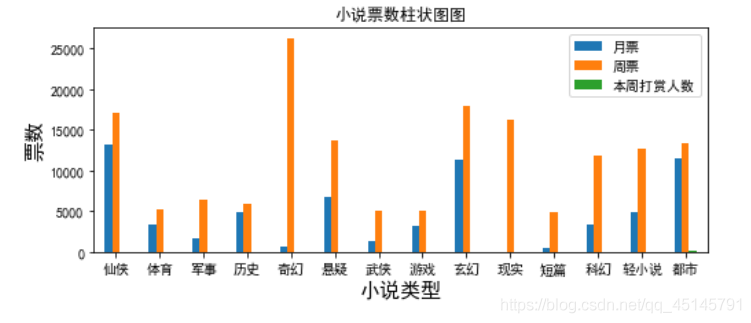
柱状图可以出月票、周票、以及打赏人数没有很直接的关系。比如奇幻周票高,但是其他两项的票数却非常低。
(3)饼状图
sizes = []for booktype in x:#x是上文折线图中横坐标,即小说所有的类型。
    bookTypeNum=len(data[data['类型']==booktype])#获取各种小说的数量
    sizes.append(bookTypeNum)plt.figure(figsize=(10,15)) #调节图形大小plt.rcParams['font.sans-serif'] = ['SimHei'] plt.rcParams['axes.unicode_minus'] = Falseplt.pie(
    sizes,
    labels=x,#指定显示的标签
    autopct='%1.1f%%'#数据保留固定小数位)#plt.axis('equal')# x,y轴刻度设置一致#本文中可以不用plt.title('小说类型受欢迎的分布图比')plt.legend(loc='upper left')# 左上角显示plt.show()12345678910111213141516
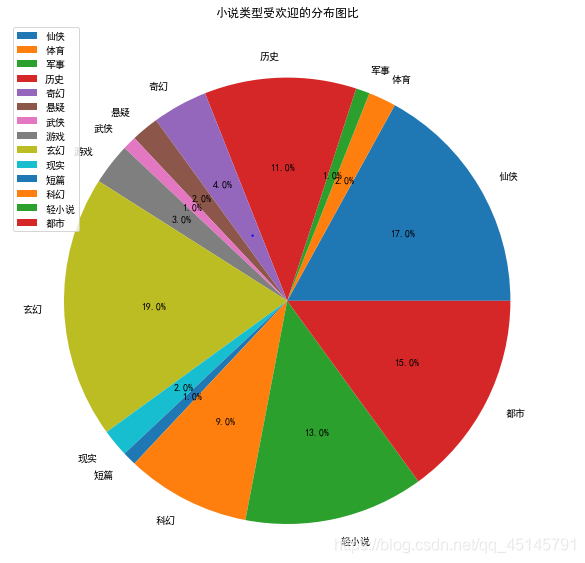
通过饼状图可以得出奇幻、都市、仙侠、轻小说几类小说很受大家追捧。
(4)词云图
import jiebaimport wordcloud
string = ''for i in range(len(x)):
    string = str + (x[i])*int(sizes[i])print(string)string=' '.join(string)w = wordcloud.WordCloud(background_color='white',font_path='simfang.ttf')#这里指明font_path时的字体一定要是自己电脑C:\windows\Fonts下包含有的字体,不然会报错,或者出现乱码。w.generate(string)w.to_file(r"bookMessage.png")12345678910
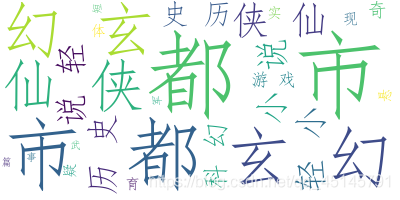
根据词云的字的大小可以看出当下最受大家追捧的小说的类型。
(5)散点图
import matplotlib.pyplot as pltimport numpy as np
plt.rcParams['figure.figsize']=(12,8)np.random.seed(0) #执行多次每次获取的随机数都是一样的colors = np.random.rand(100)size = np.random.rand(20)*1000#随机大小plt.scatter(a,b,c=colors,s=size,alpha=0.7,marker='*')plt.xlabel('月票数',fontsize = 15)#横坐标名plt.ylabel('周票数',fontsize = 15)#纵坐标名plt.title("月票和周票散点图")plt.show()1234567891011
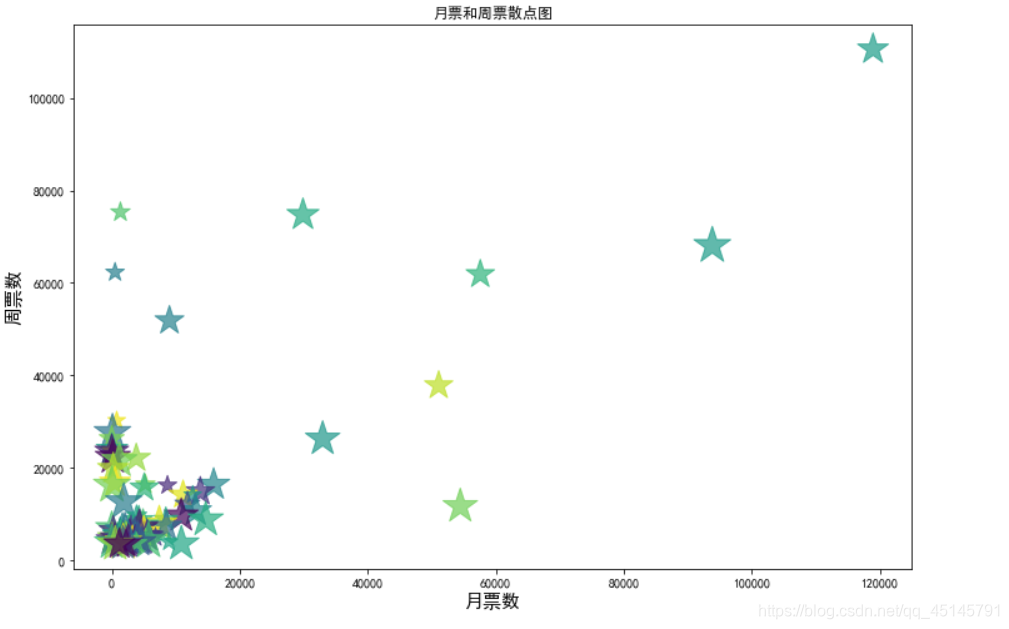
通过散点图可以得出大部分小说的月票和周票的数目很少,只有少数的小说月票和周票数目多。往往这些小说就是当下最火的小说。
http://dxb.myzx.cn/ningxia/
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/30239065/viewspace-2748646/
,如需转载,请注明出处,否则将追究法律责任。

