概率模型与条件随机场
https://blog.csdn.net/shijing_0214/article/details/51169048
1、概率模型
机器学习中的很多模型可以根据概率分布形式分为生成模型和判别模型,其中生成模型
以输入输出的联合分布P(X,Y)为基础建模
,如朴素贝叶斯、隐马尔可夫模型;判别模型
以条件概率分布P(Y|X)为基础建模
,如最大熵模型、条件随机场等。这几个模型之间有一定的关系,它们的关系如下:
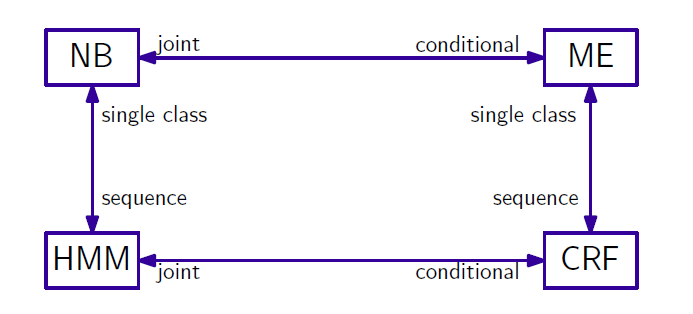
其中,NB表示朴素贝叶斯,ME表示最大熵,HMM表示隐马尔科夫,CRF表示条件随机场。joint联合分布,conditional条件分布。single class输出单一类别,sequence输出序列。例如,朴素贝叶斯将输出y扩展成序列
(
y
1
,
y
2
,
.
.
.
,
y
n
)
(y1,y2,...,yn)
,就可以以此为基础构造HMM;在满足输入条件下的HMM可以扩展成CRF。
这里面,朴素贝叶斯假设最强 ,因为它要求所有输入特征之间条件独立,如
P
(
y
|
x
1
,
x
2
,
.
.
.
,
x
n
)
=
∏
i
=
1
n
P
(
y
|
x
i
)
P(y|x1,x2,...,xn)=∏i=1nP(y|xi)
;这是一种为计算方便而做的近似假设,然而现实中基本不会有模型符合输入特征间的独立,因此以朴素贝叶斯建模一般会有精度损失。
隐马尔科夫模型进了一步,它考虑一定的变量相关性,如马尔科夫假设状态序列中,当前状态只与其前一个状态有关,如:
但是HMM只考虑了状态之间的邻接关系,没有考虑观测序列间的关系,条件随机场刚好弥补了这个缺陷。所以条件随机场是一个相对比较完善的模型,但代价是计算复杂性的提高。
2、概率图模型
上面讲到的概率模型可以用图的形式表示出来,称为概率图模型。概率图模型用图中结点表示随机变量,结点之间的边表示变量间的概率相关关系。
在概率图中,两结点没有边相连,说明两节点是条件独立的,比如 P ( a , b | c ) = P ( a | c ) ⋅ P ( b | c ) P(a,b|c)=P(a|c)⋅P(b|c) 。在概率图中,结点间全连接是不包含任何概率分布信息的,所以我们更关注的是哪些边是缺失的,这些缺失的边表示边连接的结点条件独立。
下图中的两个图是概率图的两种表示形式,一个是独立图,一个是因子图。通过条件独立的条件,可以将一个复杂的概率分布分解成简单的概率分布乘积,如下图中(a),联合概率分布
P
(
x
1
,
x
2
,
y
)
=
P
(
x
1
)
⋅
P
(
x
2
)
⋅
P
(
y
|
x
1
,
x
2
)
P(x1,x2,y)=P(x1)⋅P(x2)⋅P(y|x1,x2)
。
若定义因子,也称势函数
Ψ
s
Ψs
为概率分布的分解因子,对任意概率图G=(V,E),有:
p ( V ) = ∏ s Ψ s ( V s ) p(V)=∏sΨs(Vs)
其中,s表示随机变量构成的集合,
V
s
Vs
表示该集合中包含的变量。
则可以将
P
(
x
1
,
x
2
,
y
)
P(x1,x2,y)
写成
P
(
x
1
,
x
2
,
y
)
=
Ψ
1
⋅
Ψ
2
⋅
Ψ
3
P(x1,x2,y)=Ψ1⋅Ψ2⋅Ψ3
,这里的
Ψ
i
Ψi
分别与独立图中的概率对应。

概率图模型可大致分为两类:一类是有向图模型,表示变量间的依赖关系,也称为贝叶斯网;一类是无向图模型,表示变量间的相关关系,也称为马尔科夫网或马尔科夫随机场。
2.1 有向图模型
在有向图中,边表示了变量之间的一种依赖关系。联合分布概率可以写作是所有变量在在父节点条件下的概率乘积:
P ( V ) = ∏ i = 1 K P ( v k | v n k ) P(V)=∏i=1KP(vk|vkn)
如下图所示的隐马尔可夫有向图,联合概率可以写作:
P ( x 1 , x 2 , x 3 , y 1 , y 2 , y 3 ) = Ψ 1 ( y 1 ) ⋅ Ψ 2 ( x 1 , y 1 ) ⋅ Ψ 3 ( x 2 , y 2 ) ⋅ Ψ 4 ( x 3 , y 3 ) ⋅ Ψ 5 ( y 1 , y 2 ) ⋅ Ψ 6 ( y 2 , y 3 ) P(x1,x2,x3,y1,y2,y3)=Ψ1(y1)⋅Ψ2(x1,y1)⋅Ψ3(x2,y2)⋅Ψ4(x3,y3)⋅Ψ5(y1,y2)⋅Ψ6(y2,y3)

2.2 无向图模型
在无向图模型中,有个团和最大团的概念,表示了变量之间的关系。团的意思是一些随机变量结点构成的子集中,两两结点都有边相连,如下图中(1,2)、(1,2,5)等;最大团表示结点构成的团中再添加任何一个新结点后都不会构成团,如(1,4,5)。在一些线性链结构的无向图,如线性链条件随机场中,最大团只考虑(
y
j
−
1
,
y
j
,
x
yj−1,yj,x
)。
像有向图的分解一样,无向图也可以分解,无向图是基于最大团进行分解,如下:
P ( V ) = 1 Z ∏ C ∈ C Ψ C ( V C ) P(V)=1Z∏C∈CΨC(VC)
其中每个最大团对应一个势函数
Ψ
C
ΨC
。是不是跟最大熵模型的形式很相似?因为最大熵模型也是一个无向图模型。像在最大熵模型中一样,Z是一个归一化因子,如下:
Z = ∑ V ∏ C ∈ C Ψ C ( V C ) Z=∑V∏C∈CΨC(VC)
一般,势函数要求严格非负,所以在使用中会选择指数函数作为势函数。如下图的一个最大熵模型,可以写作:
P ( y | x ) = 1 Z λ ( x ) e λ 1 f 1 ⋅ e λ 2 f 2 ⋅ e λ 3 f 3 P(y|x)=1Zλ(x)eλ1f1⋅eλ2f2⋅eλ3f3

有向图与无向图的一个主要区别在于概率分布的分解不同,在概率有向图中,分解因子是条件概率分布;在无向图中,分解因子可以是任意函数,无向图不需要说明变量间是如何关联的,而是将在一个团中的变量作为一个整体来看。
**3、条件随机场**
在前面,我们说可以把隐马尔科夫模型看作是对贝叶斯模型的序列化;类似地,我们可以把条件随机场看作是对最大熵模型的序列化。条件随机场并不要求线性序列,即它可以是任意结构的,通常我们使用较多的是线性链随机场,它可以看作是有条件的HMM(即加入了观测序列x的条件)。
条件随机场属于判别模型,即它要求出在观测序列x的条件下得到可能输出序列y的概率
P
(
y
|
x
)
P(y|x)
。
由上面的无向图分解公式
P ( V ) = 1 Z ∏ C ∈ C Ψ C ( V C ) P(V)=1Z∏C∈CΨC(VC)
条件概率
P
(
y
|
x
)
P(y|x)
可以写作:
p ( y | x ) = p ( x , y ) p ( x ) p(y|x)=p(x,y)p(x)
= p ( x , y ) ∑ y ′ p ( y ′ , x ) =p(x,y)∑y′p(y′,x)
= 1 Z ∏ C ∈ C Ψ C ( x C , y C ) 1 Z ∑ y ′ ∏ C ∈ C Ψ C ( x C , y C ) =1Z∏C∈CΨC(xC,yC)1Z∑y′∏C∈CΨC(xC,yC)
= 1 Z ( x ) ∏ C ∈ C Ψ C ( x C , y C ) =1Z(x)∏C∈CΨC(xC,yC)
其中,
Z ( x ) = ∑ y ′ ∏ C ∈ C Ψ C ( x C , y C ) Z(x)=∑y′∏C∈CΨC(xC,yC)
下面介绍一下常用的线性链条件随机场,
线性链CRFs是条件随机场中的一种特殊结构,与隐马尔科夫一样,输出形成一个线性序列,如下图:

根据上面的公式,其条件概率可以写作,
p ( y | x ) = 1 Z ( x ) ∏ j = 1 n Ψ j ( x , y ) p(y|x)=1Z(x)∏j=1nΨj(x,y)
其中,n+1表示输出状态序列长度,n为势函数个数。
由图可知,状态
y
j
yj
与输入
x
x
和
y
j
−
1
yj−1
有关,特征函数可以写作:
势函数:
进而,线性链CRFs的条件概率分布可以写作,
p λ ( y | x ) = 1 Z λ ( x ) e x p ( ∑ n j = 1 ∑ i = 1 m λ i f i ( y j − 1 , y j , x , j ) ) pλ(y|x)=1Zλ(x)exp(∑j=1n∑i=1mλifi(yj−1,yj,x,j))
其中,
Z
λ
(
x
)
Zλ(x)
是归一化因子,
Z λ ( x ) = ∑ y ∈ Y e x p ( ∑ n j = 1 ∑ i = 1 m λ i f i ( y j − 1 , y j , x , j ) )
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/29829936/viewspace-2200284/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 那些适用于跨境电商的 ERP 系统
- On the decline of SAP consulting industry
- Matters Needing Attention as A SAP Freelancer
- The development prospect of SAP consultants in China in the next decade
- SAP WM中阶下架策略A(Partial Pallet Quantity)
- SAP WM高阶之上架策略C(Open Storage)
- SAP WM高阶之上架策略B (Bulk Storage)
- SAP WM高阶之上架策略P(Storage Unit Type)
- SAP WM高阶之2-Step Picking
- SAP QM 高阶之Physical Sample Management
