UNION操作符用于将两个查询结果合并成一个结果集,返回出现在第一个查询或者出现在第二个查询中的数据;INTERSECT操作符用于返回两个查询结果中的共同部分,即同时出现在第一个查询结果和第二个查询结果中的数据;EXCEPT操作符用于返回出现在第一个查询结果中,但不在第二个查询结果中的数据。
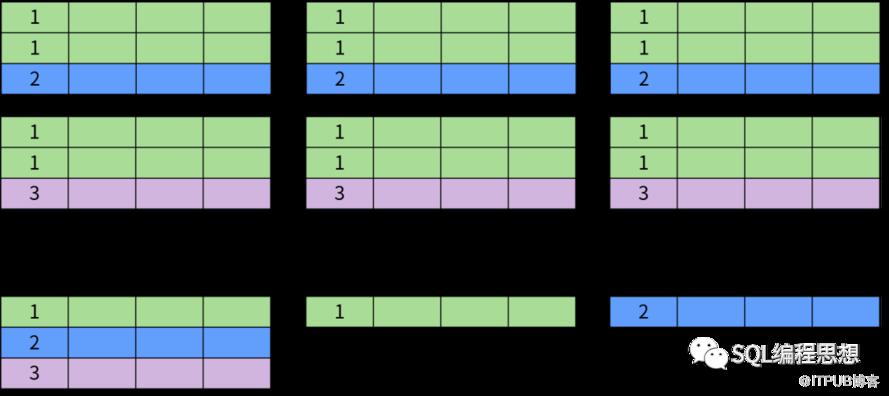
UNION
SELECT column1, column2
FROM table1
UNION [DISTINCT | ALL]
SELECT col1, col2
FROM table2;
select * from (values(1),(2)) t1(n)
union
select * from (values(1),(3)) t2(n);
n|
-|
1|
2|
3|

select * from (values(1),(2)) t1(n)
union all
select * from (values(1),(3)) t2(n);
n|
-|
1|
2|
1|
3|
INTERSECT
SELECT column1, column2
FROM table1
INTERSECT [DISTINCT | ALL]
SELECT col1, col2
FROM table2;
select * from (values(1),(2)) t1(n)
intersect
select * from (values(1),(3)) t2(n);
n|
-|
1|

select * from (values(1),(1),(2)) t1(n)
intersect all
select * from (values(1),(3)) t2(n);
n|
-|
1|

select * from (values(1),(1),(2)) t1(n)
intersect all
select * from (values(1),(1),(3)) t2(n);
n|
-|
1|
1|
EXCEPT
SELECT column1, column2
FROM table1
EXCEPT [DISTINCT | ALL]
SELECT col1, col2
FROM table2;
select * from (values(1),(1),(2)) t1(n)
except
select * from (values(1),(3)) t2(n);
n|
-|
2|

select * from (values(1),(1),(2)) t1(n)
except all
select * from (values(1),(3)) t2(n);
n|
-|
1|
2|
分组与排序
select n, count(*) from (
select * from (values(1),(2)) t1(n)
union all
select * from (values(1),(3)) t2(n)) t
group by n;
n|count|
-|-----|
1|    2|
2|    1|
3|    1|
select * from (values(1),(2)) t1(n)
order by n
union all
select * from (values(1),(3)) t2(n);
SQL Error [42601]: ERROR: syntax error at or near "union"
  Position: 50

select * from (values(1),(2)) t1(n)
union all
select * from (values(1),(3)) t2(n)
order by n;
n|
-|
1|
1|
2|
3|
集合操作优先级
SELECT column1, column2
FROM table1
UNION [DISTINCT | ALL]
SELECT col1, col2
FROM table2
INTERSECT [DISTINCT | ALL]
SELECT c1, c2
FROM table3;
相同的集合操作符按照从左至右的顺序执行;
INTERSECT的优先级高于UNION和EXCEPT;使用括号可以修改集合操作的执行顺序。
select * from (values(1)) t1(n)
union all
select * from (values(1)) t2(n)
union
select * from (values(1)) t3(n);
n|
-|
1|
select * from (values(1)) t1(n)
union all
select * from (values(1)) t2(n)
intersect
select * from (values(1)) t3(n);
n|
-|
1|
1|
(
select * from (values(1)) t1(n)
union all
select * from (values(1)) t2(n)
)
intersect
select * from (values(1)) t3(n);
n|
-|
1|
原文作者:SQL编程思想;如有侵权,请联系管理员删除。

请登录后发表评论
登录
全部评论
