22.1 窗口函数概述
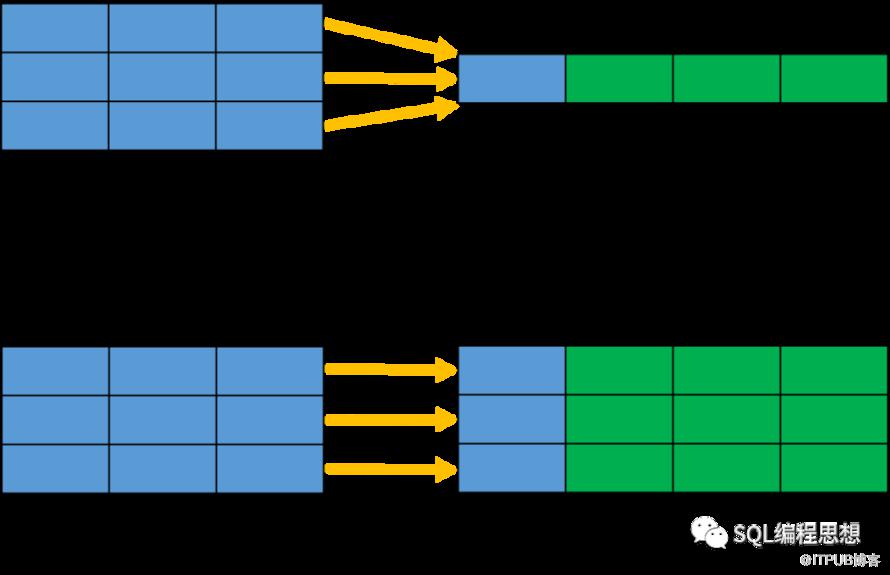
SELECT count(*)
FROM employee;
count(*)|
--------|
25|

SELECT emp_id, emp_name, count(*) OVER ()
FROM employee;
emp_id|emp_name |count(*) OVER ()|
------|---------|----------------|
13|关兴      |              25|
11|关平      |              25|
2|关羽      |              25|
1|刘备      |              25|
16|周仓      |              25|
8|孙丫鬟    |              25|
...
22.2 窗口函数的定义
window_function ( expr ) OVER (
PARTITION BY ...
ORDER BY ...
    frame_clause
)
22.2.1 分区选项(PARTITION BY)
SELECT emp_name "姓名", salary "月薪", dept_id "部门编号",
sum(salary) OVER (PARTITION BY dept_id) AS "部门月薪合计"
FROM employee;

22.2.2 排序选项(ORDER BY)
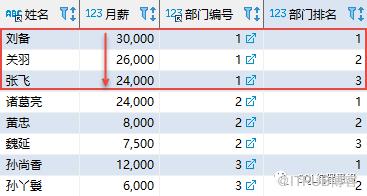
SELECT emp_name "姓名", salary "月薪", dept_id "部门编号",
       rank() OVER (
PARTITION BY dept_id
ORDER BY salary DESC
) AS "部门排名"
FROM employee;
22.2.3 窗口选项(frame_clause)
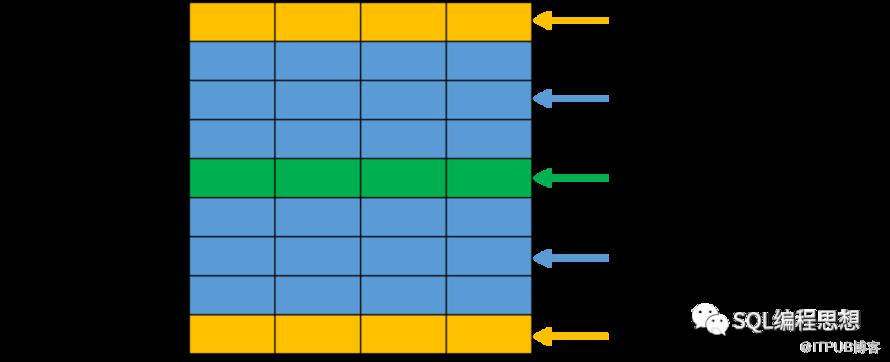
定义一个从分区开始到当前数据行结束的窗口,可以计算截止到每一行的累计总值。
定义一个从当前行之前 N 行数据到当前行之后 N 行数据的窗口,可以计算移动平均值。
{ ROWS | RANGE } frame_start
{ ROWS | RANGE } BETWEEN frame_start AND frame_end
CURRENT ROW
UNBOUNDED PRECEDING
UNBOUNDED FOLLOWING
expr PRECEDING
expr FOLLOWING
CURRENT ROW:对于 ROWS 方式,代表了当前行;对于 RANGE,代表了当前行的所有对等行。
UNBOUNDED PRECEDING:代表了分区中的第一行。
UNBOUNDED FOLLOWING:代表了分区中的最后一行。
expr PRECEDING:对于 ROWS 方式,代表了当前行之前的第 expr 行;对于 RANGE,代表了等于当前行的值减去 expr 的所有行;如果当前行的值为 NULL,代表了当前行的所有对等行。
expr FOLLOWING:对于 ROWS 方式,代表了当前行之后的第 expr 行;对于 RANGE,代表了等于当前行的值加上 expr 的所有行;如果当前行的值为 NULL,代表了当前行的所有对等行。
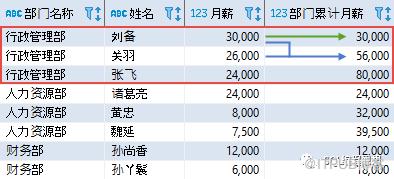
SELECT d.dept_name "部门名称", e.emp_name "姓名", e.salary "月薪",
sum(salary) OVER (
PARTITION BY e.dept_id
ORDER BY e.emp_id
ROWS UNBOUNDED PRECEDING
) AS "部门累计月薪"
FROM employee e
JOIN department d ON (e.dept_id = d.dept_id);
22.2.4 命名窗口
window_function(expr) OVER window_name

WINDOW window_name AS (PARTITION BY ... ORDER BY ... frame_clause)
WINDOW window_name AS (other_window_name)
SELECT d.dept_name "部门名称", e.emp_name "姓名", e.salary "月薪",
sum(salary) OVER w AS "部门累计月薪",
count(*) OVER w AS "部门累计人数"
FROM employee e
JOIN department d ON (e.dept_id = d.dept_id)
WINDOW w AS (
PARTITION BY e.dept_id
ORDER BY e.emp_id
ROWS UNBOUNDED PRECEDING
);
22.3 常用窗口函数
22.3.1 聚合窗口函数
SELECT d.dept_name "部门名称", e.emp_name "姓名", e.salary "月薪",
avg(salary) OVER (
PARTITION BY e.dept_id
ORDER BY e.salary
ROWS BETWEEN 1 PRECEDING AND 1 FOLLOWING
) AS "移动平均月薪"
FROM employee e
JOIN department d ON (e.dept_id = d.dept_id);
部门名称  |姓名  |月薪     |移动平均月薪  |
--------|------|--------|------------|
行政管理部|张飞  |24000.00|25000.000000|
行政管理部|关羽  |26000.00|26666.666667|
行政管理部|刘备  |30000.00|28000.000000|
人力资源部|魏延  | 8000.00| 8250.000000|
人力资源部|黄忠  | 8500.00|13833.333333|
人力资源部|诸葛亮|25000.00|16750.000000|
...
avg(temperature) OVER (ORDER BY ts RANGE BETWEEN interval '5 minute' PRECEDING AND CURRENT ROW)
22.3.2 排名窗口函数
ROW_NUMBER,为分区中的每行数据分配一个序列号,序列号从 1 开始分配。
RANK,计算每行数据在其分区中的名次;如果存在名次相同的数据,后续的排名将会产生跳跃。
DENSE_RANK,计算每行数据在其分区中的名次;即使存在名次相同的数据,后续的排名也是连续的值。
PERCENT_RANK,以百分比的形式显示每行数据在其分区中的名次;如果存在名次相同的数据,后续的排名将会产生跳跃。
CUME_DIST,计算每行数据在其分区内的累积分布,也就是该行数据及其之前的数据的比率;取值范围大于 0 并且小于等于 1。
NTILE,将分区内的数据分为 N 等份,为每行数据计算其所在的位置。
SELECT d.dept_name "部门名称", e.emp_name "姓名", e.salary "月薪",
       ROW_NUMBER() OVER (PARTITION BY e.dept_id ORDER BY e.salary DESC) AS "row_number",
       RANK() OVER (PARTITION BY e.dept_id ORDER BY e.salary DESC) AS "rank",
       DENSE_RANK() OVER (PARTITION BY e.dept_id ORDER BY e.salary DESC) AS "dense_rank",
       PERCENT_RANK() OVER (PARTITION BY e.dept_id ORDER BY e.salary DESC) AS "percent_rank"
FROM employee e
JOIN department d ON (e.dept_id = d.dept_id);
部门名称  |姓名 |月薪     |row_number|rank|dense_rank|percent_rank       |
--------|-----|--------|----------|----|----------|-------------------|
行政管理部|刘备 |30000.00|         1|   1|         1|                0.0|
行政管理部|关羽 |26000.00|         2|   2|         2|                0.5|
行政管理部|张飞 |24000.00|         3|   3|         3|                1.0|
...
研发部   |赵云 |15000.00|         1|   1|         1|                0.0|
研发部   |周仓 | 8000.00|         2|   2|         2|              0.125|
研发部   |关兴 | 7000.00|         3|   3|         3|               0.25|
研发部   |关平 | 6800.00|         4|   4|         4|              0.375|
研发部   |赵氏 | 6600.00|         5|   5|         5|                0.5|
研发部   |廖化 | 6500.00|         6|   6|         6|              0.625|
研发部   |张苞 | 6500.00|         7|   6|         6|              0.625|
研发部   |赵统 | 6000.00|         8|   8|         7|              0.875|
研发部   |马岱 | 5800.00|         9|   9|         8|                1.0|
...
ROW_NUMBER 函数为每个员工分配了一个连续的数字编号,可以看作是一种排名。其中“廖化”和“张苞”的月薪相同,但是编号不同;
RANK 函数为每个员工指定了一个名次,其中“廖化”和“张苞”的名次都是 6。在他们之后的“赵统”的名次为 8,产生了跳跃;
DENSE_RANK 函数为每个员工指定了一个名次,其中“廖化”和“张苞”的名次都是 6。在他们之后的“赵统”的名次为 7,名次是连续值;
PERCENT_RANK 函数按照百分比指定名次,取值位于 0 到 1 之间。其中“赵统”的百分比排名为 0.875,也产生了跳跃。
SELECT emp_name AS "姓名", salary AS "月薪",
       CUME_DIST() OVER (ORDER BY salary DESC) AS "累积占比",
       NTILE(5) OVER (ORDER BY salary DESC) AS "相对位置"
FROM employee;
姓名  |月薪    |累积占比|相对位置|
-----|--------|------|----|
刘备  |30000.00|  0.04|   1|
关羽  |26000.00|  0.08|   1|
诸葛亮|25000.00|  0.12|   1|
张飞  |24000.00|  0.16|   1|
赵云  |15000.00|   0.2|   1|
孙尚香|12000.00|  0.24|   2|
...
糜竺  | 4300.00|  0.84|   5|
黄权  | 4200.00|  0.88|   5|
庞统  | 4100.00|  0.92|   5|
蒋琬  | 4000.00|   1.0|   5|
邓芝  | 4000.00|   1.0|   5|
22.3.3 取值窗口函数
FIRST_VALUE,返回窗口内第一行的数据。
LAST_VALUE,返回窗口内最后一行的数据。
NTH_VALUE,返回窗口内第 N 行的数据。
LAG,返回分区中当前行之前的第 N 行的数据。
LEAD,返回分区中当前行之后第 N 行的数据。
SELECT d.dept_name "部门名称", e.emp_name "姓名", e.salary "月薪",
       first_value(salary) OVER w "最高月薪",
       last_value(salary) OVER w "最低月薪",
       nth_value(salary, 2) OVER w "第二高月薪"
FROM employee e
JOIN department d ON (e.dept_id = d.dept_id)
WINDOW w AS (
PARTITION BY e.dept_id
ORDER BY salary DESC
ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING)
ORDER BY e.dept_id, salary DESC;
部门名称 |姓名  |月薪     |最高月薪 |最低月薪 |第二高月薪|
--------|-----|--------|--------|--------|--------|
行政管理部|刘备 |30000.00|30000.00|24000.00|26000.00|
行政管理部|关羽 |26000.00|30000.00|24000.00|26000.00|
行政管理部|张飞 |24000.00|30000.00|24000.00|26000.00|
人力资源部|诸葛亮|25000.00|25000.00| 8000.00| 8500.00|
人力资源部|黄忠 | 8500.00|25000.00| 8000.00| 8500.00|
人力资源部|魏延 | 8000.00|25000.00| 8000.00| 8500.00|
...
SELECT product AS "产品", ym "年月", amount "销量",
(amount - LAG(amount, 1) OVER (PARTITION BY product ORDER BY ym))/
       LAG(amount, 1) OVER (PARTITION BY product ORDER BY ym) * 100 AS "环比增长率(%)"
FROM sales_monthly
ORDER BY product, ym;
产品|年月   |销量    |环比增长率(%)|
---|------|--------|---------|
桔子|201801|10154.00|         |
桔子|201802|10183.00| 0.285602|
桔子|201803|10245.00| 0.608858|
桔子|201804|10325.00| 0.780869|
桔子|201805|10465.00| 1.355932|
桔子|201806|10505.00| 0.382226|
桔子|201807|10578.00| 0.694907|
桔子|201808|10680.00| 0.964265|
桔子|201809|10788.00| 1.011236|
桔子|201810|10838.00| 0.463478|
桔子|201811|10942.00| 0.959587|
桔子|201812|10988.00| 0.420398|
桔子|201901|11099.00| 1.010193|
桔子|201902|11181.00| 0.738805|
桔子|201903|11302.00| 1.082193|
桔子|201904|11327.00| 0.221200|
桔子|201905|11423.00| 0.847532|
桔子|201906|11524.00| 0.884181|
...
原文作者:SQL编程思想;如有侵权,请联系管理员删除。

