ITPub博客

首页 > 数据库 > 数据库开发技术 > 数据处理进化史之小明历险记②:分布式数据库破局

数据处理进化史之小明历险记②:分布式数据库破局

原创 数据库开发技术 作者:梁敬彬 时间:2025-05-28 05:59:01 0 删除 编辑

数据处理进化史之小明历险记(原文链接)

往期回顾:

数据处理进化史之小明历险记①:从Excel困局到集中式数据库的飞跃


 二 分布式数据库破局【5-9】


5. 备份失效引发的系统重构决策

①大祸临头

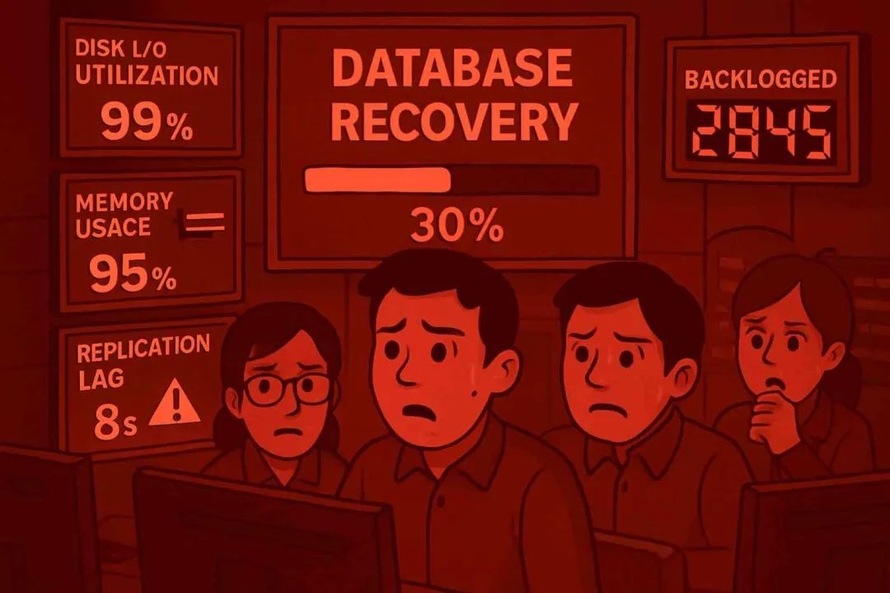
"恢复进度才30%?订单已积压2万笔!"老板的怒吼在会议室炸开。

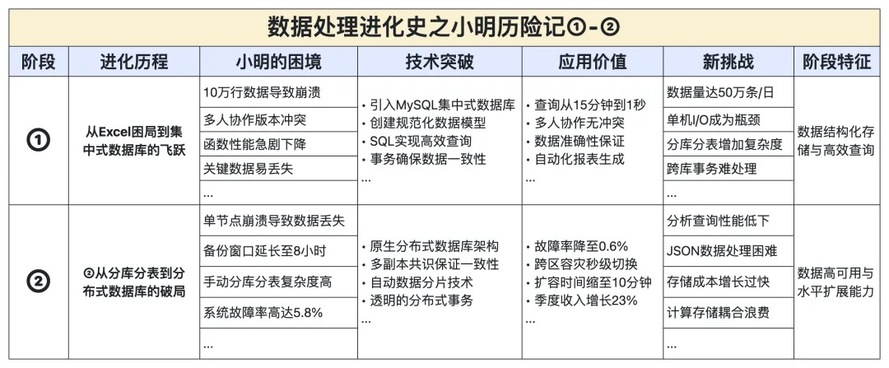
小明盯着屏幕上停滞的恢复进度条,回想起上月那次灾难性故障——因硬盘阵列损坏, 单节点 数据库崩溃,而 增量日志错误 导致6小时交易数据 永 久丢失 。

②痛下决心

这次事故敲响了警钟。随着业务扩展到供应链金融领域,日均数据写入量破千万条,单节点备份窗口已从2小时延长至8小时。运维团队监控大屏上,磁盘I/O利用率常年飙红,内存溢出告警此起彼伏。

"我们必须重构数据库架构。"CTO在技术会议上直言,“分库分表解决了单机容量问题,却 把复杂度转嫁到了应用层 。我们需要一种原生支持分布式的解决方案。”


6. 分布式数据库:从选型到落地
①选型突破

经过两个月调研,团队选择了某领先的分布式数据库解决方案。

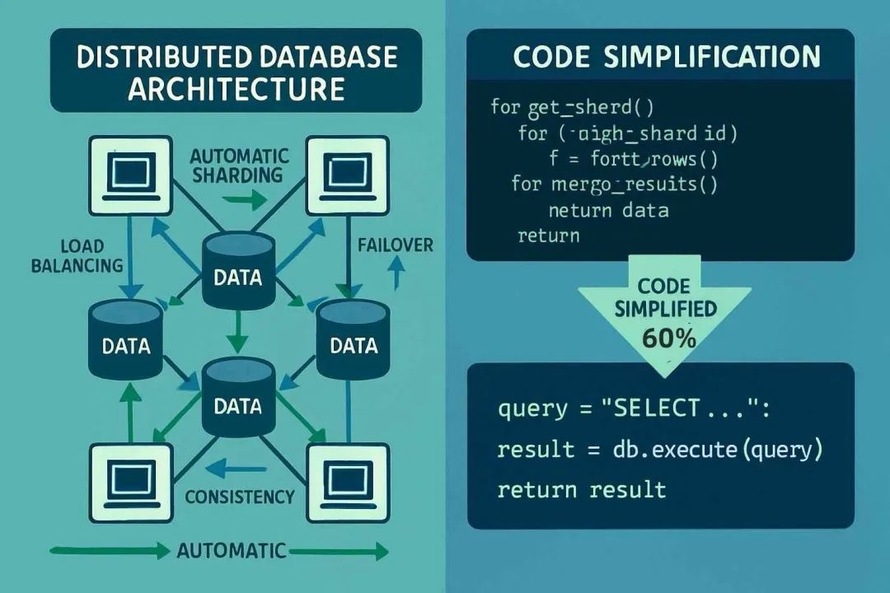
"这套系统采用’ 一份数据多副本 ’的 共识协议 保证数据一致性,底层自动完成数据分片,对应用层 完全透明 。"数据架构师在白板上画出系统架构。

②大道至简

迁移策略采用"双写+数据校验+灰度切换",确保 业务连续性 。最令开发人员振奋的是, 代码复杂度 大幅降低:

// 迁移前:手动拼接多个分片结果
List<Order> getOrders(Long userId) {
    List<Order> result = new ArrayList<>();
    // 查询多个区域订单库并合并结果
    result.addAll(beijingOrderMapper.findByUserId(userId));
    result.addAll(shanghaiOrderMapper.findByUserId(userId));
    // ...更多区域库查询...
    return result;
}
// 迁移后:简单直接的单库查询
List<Order> getOrders(Long userId) {
    return orderMapper.findByUserId(userId);
}

"代码量减少了60%!"开发负责人阿开说,“更重要的是, 不再需要处理跨库事务 的复杂逻辑,系统稳定性直接提升一个量级。”


7. 分布式架构带来的革命性变革临

①弹性扩缩

迁移完成后,系统运行稳定, 弹性扩展能力 令运维团队印象深刻。

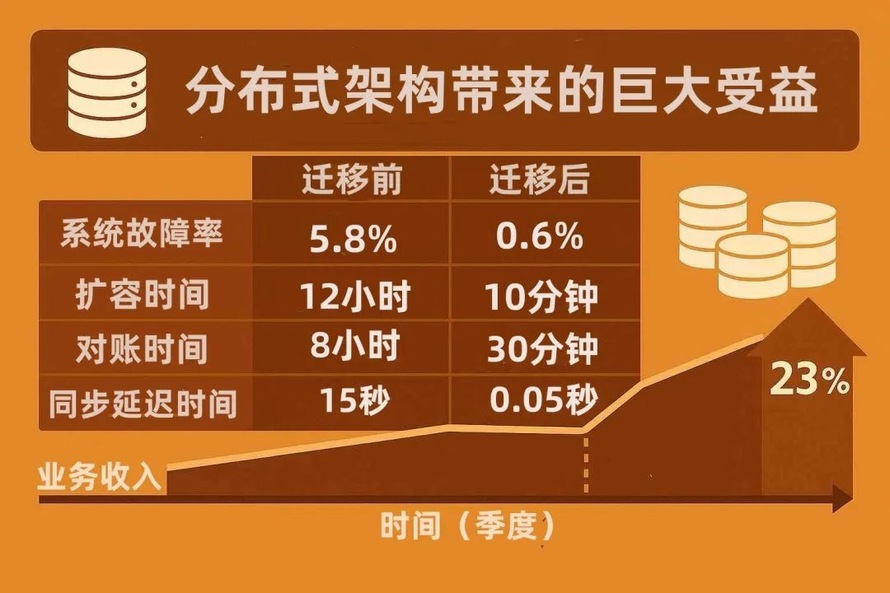
"上周销售部临时要做闪购活动,预计流量是平时的5倍。"运维小牛说,“在旧架构下,这意味着12小时的扩容准备。而现在,我只需点击几下,系统容量10分钟内翻倍。”

②完美一致

数据一致性 问题也得到根本解决,以往耗时一天的月度对账,现在30分钟完成,准确率100%。财务总监终于可以睡安稳觉了。

③容灾飞跃

容灾能力也大幅提升。一次灾备演练中,团队切断主数据中心网络,系统40秒内完成跨区域切换,业务毫无感知。印度数据中心突发电力故障时,分布式架构通过多副本机制完全屏蔽了影响, 客户无感知故障发生 。

④创新加速

业务创新速度加快。过去因技术限制无法实现的功能,如跨地区订单合并、全球库存实时查询等,在新架构下变得简单可行。公司推出全球一体化电商平台后,季度收入增长23%。


8. 分布式数据库的新挑战

①七年之痒

又过了七年,随着公司收购社交电商平台,新挑战接踵而至。为此,大家在会议室展开了讨论。

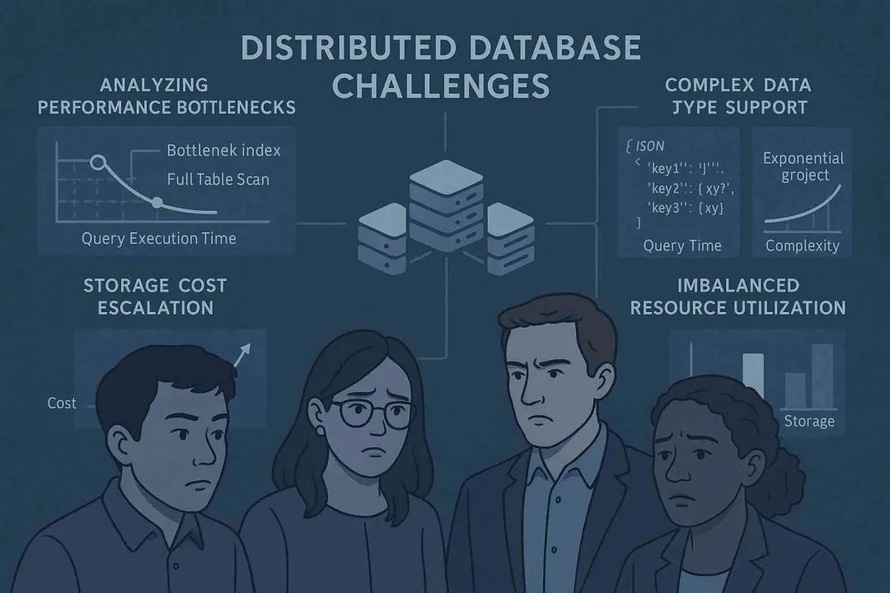
数据分析负责人丰哥抱怨:“我们需要 实时分析 用户浏览行为与购买转化率关系,但这个查询执行了整整10分钟。”

SELECT 
    u.age_group,
    p.category,
    COUNT(DISTINCT b.session_id) as browse_sessions,
    COUNT(DISTINCT o.id) as order_count,
    COUNT(DISTINCT o.id) / COUNT(DISTINCT b.session_id) as conversion_rate
FROM users u
JOIN browsing_history b ON u.id = b.user_id
LEFT JOIN orders o ON u.id = o.user_id AND o.product_id = b.product_id
JOIN products p ON b.product_id = p.id
WHERE b.browse_time > DATE_SUB(NOW(), INTERVAL 30 DAY)
GROUP BY u.age_group, p.category
ORDER BY conversion_rate DESC;

②局限暴露

"我们数据库的 行式存储结构 应对 事务处理 很在行,但面对 分析查询 ,还是有些 力不从心 的。"小明解释道。

"明哥啊,咱们平台商品属性是 JSON 格式存储的,每个品类都不同,数据库在处理复杂JSON查询时 性能太差了 !"产品经理也开始抱怨。

“是的。不仅如此,咱们存储的成本也很成问题。”小明直言,“按目前数据增长速度,半年后数据库存储投入将增加300%。”

“明哥,我觉得这和 计算与存储未解耦 有关。比如大促活动期间,计算需求暴增10倍,但存储需求几乎不变, 却不得不 同时扩展两者 。"小牛说道。


9. 深夜来临的紧急警报

①突发危机

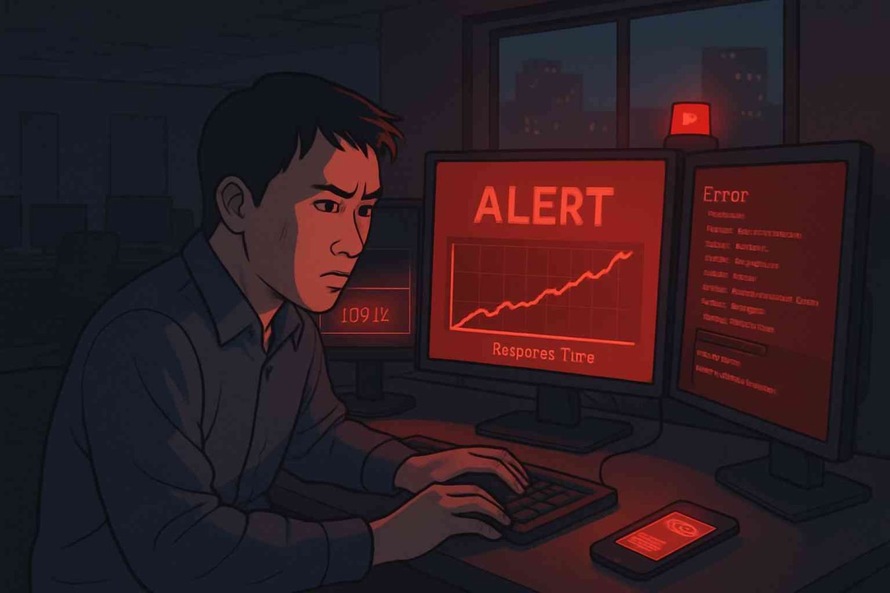
下班后,同事们都陆续离开,今晚轮小明值班。忽然,监控系统发出刺耳的警报声。

"怎么回事?"小明立即检查监控面板。屏幕上电商平台的响应时间曲线呈直线上升,已超过警戒线。

几分钟后,市场总监电话打来: "系统严重延迟!商品搜索响应 超过10秒 ,大量海外用户投诉无法完成购买!"

小明迅速展开排查,发现问题出在JSON查询上——简单的多条件商品筛选,让 CPU使用率瞬间飙升至100% 。

更糟的是,这次性能下降发生在大促销活动首日,预计影响交易额将达数千万元。老板在公司群里质问:"我们提前做了那么多准备,为何系统还是跟不上业务需求?"
②寻求突破

小明揉着太阳穴,这已经是本月第三次类似问题。

无奈之下,小明向曾经的导师老纪紧急求助。老纪听完问题描述后表示:"我近期正好聚焦在数据库新技术架构研究上,很有心得,明天咱们见面交流。当下可先采取一些 应急方案 ,如..." 小明松了口气,同时暗下决心:公司需要一场数据技术革命,越快越好。


未完待续...


公众号:收获不止数据库

微信:ljbyxl1213

系列回顾


来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/9091385/viewspace-3085947/ ,如需转载,请注明出处,否则将追究法律责任。

请登录后发表评论 登录
全部评论
历任中电福富研究院副理事长、中盾安信研究院副院长、宁德时代技术顾问等职务,受聘电信集团专家和国家十四五课题负责人,著有《收获,不止Oracle》《收获,不止SQL优化》等多本畅销数据库技术书籍。

注册时间:2024-02-06

  • 博文量
    162
  • 访问量
    198570