引言
上回说到,无名从2050年穿越而来,向众人揭示了AI时代的未来就业情况,大家唏嘘不已 (详见: 小朋友都能懂的人工智能⑬AI时代,未来就业走势 ) 。数天后,到了与无名约定再见的日子,他却并未现身,只留下一张纸条。
原来,无名发现由于自己的低级错误,可能无法再回到自己的时代。懊悔之余,他决定边过隐匿生活,边寻找解决之道。
很快,无名的传说在江湖中流传开来,无数人争相寻找这位大师以求指点,但都无功而返。
数月后...
老牛: L兄 ,咱们真的能见到无名大师吗?
L: 是的,见无名大师不易,大家一定要好好珍惜这次机会。
数小时后...
无名: 欢迎各位光临!L兄,好久不见,别来无恙。
1
数据之痛,从业者们口中的悲催故事
无名: 嗯,大家都抛出了自己的问题,L兄,你有什么需要探讨的吗?
L: 无名兄,我非常关注中国数据库产业的发展。虽然我们的数据库技术已经在某些方面超越Oracle了 ( 详见 : 数据库二十年目睹之怪现状⓹真实的谎言 ) ,但由于起步较晚, 用户案例积累远不如Oracle。而 优化器又极其依赖大量案例的经验打磨,因此在这一领域难免存在差距。对此,您有什么建议吗?
|
| |||
|
人员 |
困境 |
已采取手段 | |
|
|
|
数百套数据库, 多种技术栈, 学习成本高 |
3. 扩大人员 4. 加班加点 |
|
|
| ||
|
|
|
2. 低效SQL频上线, 影响生产 3. 疲于生产SQL的诊断及优化 |
2. 举行培训 3. 审核工具 |
|
|
|
2. 语义逻辑错误频发难定位 3. 应用时才暴露, 应对仓促 |
3. 人肉修复 |
|
|
|
3. 故障诊断和变更操作吃力 |
2. 参加培训 3. 依靠团队 |
|
|
|
|
2. 加大投入 |
2
人工智能,无名大师的数据诊疗方案
无名: 其实,各位的数据库“心病”无需太过担忧,我可以开出一剂名为“人工智能“(AI)的药方,它的核心成分是基于生成式AI的大语言模型,简称“ 大模型 ”。
小羊: 无名大师,我也在用大模型,主要是用来协助自己写文章、绘图 ( 详见 : 小朋友都能懂的人工智能⑪一滴墨汁成就一代画师 )、做视频 ( 详见 : 小朋友都能懂的人工智能⑫从画师到视频大师 )等,这玩意儿真能解决我们的数据库问题吗?
无名: 你用大模型协助你写文章、绘图、做视频,本质是通过交互让它帮你完成任务。其实 ,假设它真的掌握了SQL,用它处理SQL的编 写、审核、优化 ( 详见 : SQL优化思想 )和解释,与用它写文章、绘图 并无本质区别。你的主要问题在于需求过多、SQL工作量大以及审核和优化的繁琐,包括小侯需要的SQL解释。只要你们能够清晰的表达需求,大模型就可以帮你分担这些任务,并且它会变得 越来越强。
老马: 无名大师,您认为大模型可以参与生产中的数据库运维工作?但变更、升级、故障处理等操作都需要极高的准确性,一旦出错,后果不堪设想。如果大模型的建议有误,而我们又误采纳了,岂不是会对生产环境造成严重危害?我不敢用啊。
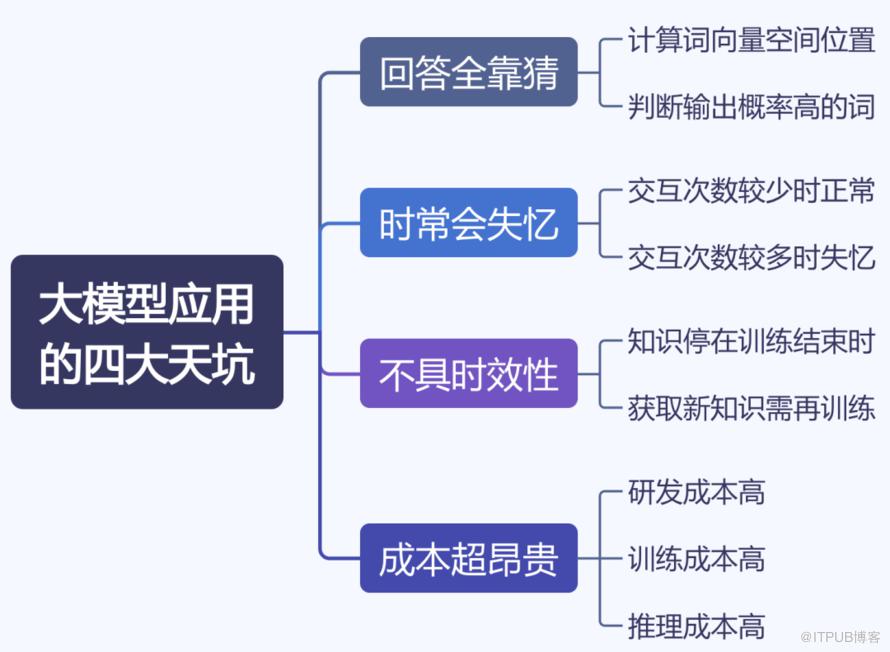
无名 :你的顾虑很有道理。大模型和数据库的结合确实存在许多挑战,尤其是它的 四大天坑 。
老牛: 天坑?
3
四大天坑,大模型真能治愈数据之痛?
无名: 我们先来看 天坑1—— “回答全靠猜” 。大模型的回复是基于概率统计,而非记录查询。它通过计算词向量 ( 详见: 小朋友都能懂的人工智能⓹-不可思议的大模型 ) ,结合注意力机制 ( 详见: 小朋友都能懂的人工智能⓺- 逆天,句中高能!!) 依次生成得分最高的词,连成句子或代码。简单来说, 它不知道你在问什么?也不知道自己在回答什么 。因此,它偶尔会产生 胡言乱语 ,也被称为“大模型的 幻觉 ”。
老马: 啊,都不知道自己在回答什么,还有幻觉,听起来确实很坑。
无名: 接着说天坑2—— “时常会失忆” ,大模型在 长时间交互中,可能忘记之前交代的信息 。 ( 详见: 小朋友都能懂的人工智能⓼--无名的故事与GPT-4运行(推理)流程 ) 。 比如,你要求它遵循Oracle数据库的SQL语法,但随着对话 深入, 它可能会把这要求抛在脑后 ,于是, 回复就偏离了你的预期 ( 详见: 小朋友都能懂的人工智能⓽ Hi AI, Database is all you need ) 。
老牛: 这也太不靠谱了吧!
无名: 再说天坑3—— “不具时效性” 。比如某个大模型是2024年6月1日训练出来的,那它只掌握了6月1日以前的知识,之后的信息它一概不知。 就算给它提供最新 的知识让它学习 ,它 也只能 进行推理回答,而不能把这些新知识融入到神经网络参数里,也就是说, 大模型不能实时学习 ,要重新训练才能掌握新内容 。
小侯: 我们人类都可以随时学习新知识,大模型怎么就不行呢?
无名: 最后说天坑4—— “成本超昂贵” 。OpenAI公司在大模型研发上投入 已超百亿美金 ,仅仅一次大模型训练成本就常常 超过千万美金 ( 详见: 小朋友都能懂的人工智能⓻--无名的故事与GPT-4训练流程 ) ,而推理成本更是高的惊人 ( 详见: 小朋友都能懂的人工智能⓼--无名的故事与GPT-4运行(推理)流程) 。所以能参与大模型研发的公司和机构很少,在国内也就阿里、百度、字节跳动、清华大学等少数几家有能力参与。
老马: 这么贵!还会胡言乱语、失忆,知识又不实时,这大模型根本无法用啊。
L: 老马,别着急下结论,无名兄来自2050年,咱们问问他未来大模型与数据库的结合情况如何?
无名: 未 来,大模型与数据的结合非常成功。两者达成了一种 “共生” 的美妙境界,不仅大模型赋能数据,数据也能反过来提升大模型能力。这一过程经历了多个发展阶段,可以类比L1到L5的无人驾驶层级。
老马: 真的吗?可您提到的“四大天坑”让我完全不敢接受啊。
无名: 大模型与数据的结合不是一蹴而就,而是 分阶段逐步实现 的。 天坑远不止这四 个 ,但是都有解决之道。接下来,我会详细讲解 大模型的运行机制 ,以及 与数据结合的关键思路 ,并带大家回顾这一“共生之路”的各个阶段。
众人: 太好了,非常期待!
欲知后事如何,请听下回分解...
公众号:收获不止数据库
微信:ljbyxl1213
原文作者:收获不止数据库;如有侵权,请联系管理员删除。

最新文章
- 2030年,两个智能体的深夜回忆:幸亏那年,人类重构了数据库
- 万物一理:从人体进化到IT架构的取舍之道——写在2026中国系统架构师大会之前
- 达梦9发布会归来:AI 时代,我们需要一款什么样的数据库?
- 当AI强到连“造物主”都感到恐惧,我们该怎么办?
- 当AI反噬宏观经济:一场关于个体自救与中国制度托底的万字推演
- 原来“先吃菜”和“后建索引”是同一个逻辑?揭秘那些万物相通的“执行顺序”
- 应用程序大模型化之路——从12306畅想看预设模式颠覆与数据觉醒(下)
- 应用程序大模型化之路——从12306畅想看预设模式颠覆与数据觉醒(中)
- 应用程序大模型化之路——从12306畅想看预设模式颠覆与数据觉醒(上)
- 技术人生——第13集:溯本清源,手起刀落
