数据架构是成功数据工程的关键。它为整个组织如何收集、存储、处理和利用数据奠定了基础。借助精心设计的数据架构,企业可以实现无缝数据集成、高性能、可扩展性和有效的数据治理。
下面我们探讨良好数据架构的核心原则,讨论关键的架构概念,并深入研究各种数据架构模式,以帮助您设计健壮且可扩展的数据系统。
一 什么是数据架构
数据架构是指概述组织内数据收集、存储、管理和使用方式的结构化框架。它定义了数据流、数据模型和用于处理数据的技术。可靠的数据架构可确保数据可访问、可靠且与各种业务需求相关,从而促进有效决策和运营效率。
数据架构是企业架构的一个子集,涵盖了组织的整个 IT 基础架构和流程。企业架构包括业务、应用程序、技术和数据架构等各种组件。了解企业架构的更广泛背景有助于确定数据架构在组织整体战略中的作用和重要性。

二 数据架构的演变
过去几十年来,数据架构经历了重大变革,推动力在于对高效数据分析的需求日益增长,以及利用数据实现业务效益的数据战略现代化。这一演变有几个关键阶段,每个阶段都具有独特的架构实践和技术。
1.2000 年之前:企业数据仓库 (EDW) 时代
在此期间,重点是企业数据仓库 (EDW) 的成功和实施。组织旨在创建集中式存储库,以便存储、管理和分析来自各种来源的数据。主要目标是通过结构化和一致的数据存储来支持商业智能和报告需求。
特征:
集中式数据存储
具有明确架构的结构化数据
专注于商业智能和报告
限制:
实施和维护成本高
数据量不断增长的可扩展性问题
难以整合各种数据源
2.2000 年至 2010 年:后 EDW 时代
这一时期,企业开始转向解决传统数据仓库的局限性。企业面临着数据碎片化和数据孤岛的挑战,导致分析不一致和碎片化。数据集市变得流行,因为它们允许各部门管理自己的数据,但这导致了进一步的碎片化。
特征:
依赖数据仓库和数据集市
碎片化数据分析
数据孤岛的出现
限制:
部门间数据分析不一致
难以整合数据以获取整个企业的见解
维护多个数据系统的成本持续居高不下
3.2010 年至 2020 年:逻辑数据仓库 (LDW) 时代
逻辑数据仓库 (LDW) 是解决数据分散问题的一种方法。它引入了一个通用语义层,统一了跨各种存储系统(包括数据仓库、数据集市和数据湖)的数据访问。这种方法实现了更统一的数据分析并提高了数据可访问性。
特征:
通过通用语义层进行统一数据访问
数据仓库、数据集市和数据湖的集成
增强的数据分析能力
好处:
提高数据一致性和集成度
增强的可扩展性和灵活性
更好地支持大数据和高级分析
限制:
继续依赖多个数据存储系统
管理语义层的复杂性
需要专业技能来实施和维护 LDW
4.2020 年起:增强数据分析和主动元数据的时代
数据架构的当前和未来阶段以增强数据分析的兴起为标志,这种趋势由人工智能、机器学习和数据编排等先进技术推动。这个时代的重点是实现数据访问的民主化,并实现由主动元数据支持的自助分析。
特征:
利用人工智能和机器学习增强数据分析
支持元数据的数据自助服务
高级数据编排和推荐引擎
自适应实践和主动元数据分析
好处:
增强数据可访问性和自助服务能力
通过高级分析改善决策
更灵活地适应不断变化的业务需求
主动元数据:元数据在当今时代发挥着至关重要的作用,它描述了数据的不同方面并实现了智能数据管理。元数据有四种类型:
技术元数据:有关数据存储、结构和处理的信息。
操作元数据:有关数据工作流、流程和使用情况的数据。
业务元数据:有关数据的业务含义和用途的上下文信息。
社交元数据:从数据交互和使用模式中获得的见解。
主动元数据不仅描述数据,还能识别跨系统的操作,促进数据操作更加动态、智能。
用例:
主数据管理
企业对企业数据交换
应用数据集成
合作伙伴数据交换
向主动元数据和增强分析的演变扩展了数据架构的功能,超越了传统实践,实现了跨不同用例的更复杂的数据管理和分析。
三 关键架构原则和概念
理解核心架构原则和概念对于设计有效的数据架构至关重要。这些原则构成了构建强大、可扩展且灵活的数据系统的基础。
领先企业的原则
各大企业都遵循自己的架构原则,以确保系统的有效性和效率。例如:
1.AWS 完善架构框架包含六大支柱:
卓越运营
安全
可靠性
性能效率
成本优化
可持续发展
2.Google Cloud 的云原生架构五大原则是:
为自动化而设计。
明智地对待国家。
支持托管服务。
实行纵深防御。
永远致力于架构。
四 关键数据架构模式
在过去的几十年中,数据架构中出现了几种关键模式,它们对于有效管理和利用数据至关重要。每种模式都有其优点、缺点和理想用例。在这里,我将简要探讨这些模式,以说明它们在各种情况下如何应用以及在何处应用。
1.数据仓库
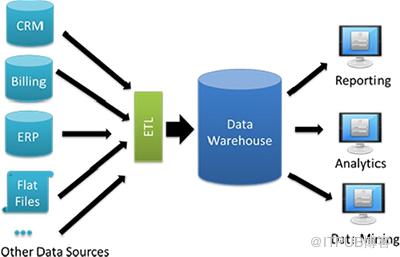
数据仓库是用于存储结构化数据以供报告和分析的集中式存储库。它们针对查询性能和数据聚合进行了优化,使其成为商业智能应用程序的理想选择。
特征:
集中存储:将来自多个来源的数据存储在一个位置。
结构化数据:数据高度组织化并且通常遵循某种模式。
针对分析进行了优化:专为快速查询和数据检索而设计。
好处:
高性能:针对复杂查询和数据分析进行了优化。
数据集成:整合来自各种来源的数据,提供统一的视图。
一致性:通过模式执行来保证数据质量和一致性。
用例:
商业智能和报告
历史数据分析
多个系统的数据整合
示例:零售公司使用基于云的数据仓库(如 Amazon Redshift)来分析不同地区的销售数据并生成详细的报告以供业务决策。
2.数据湖
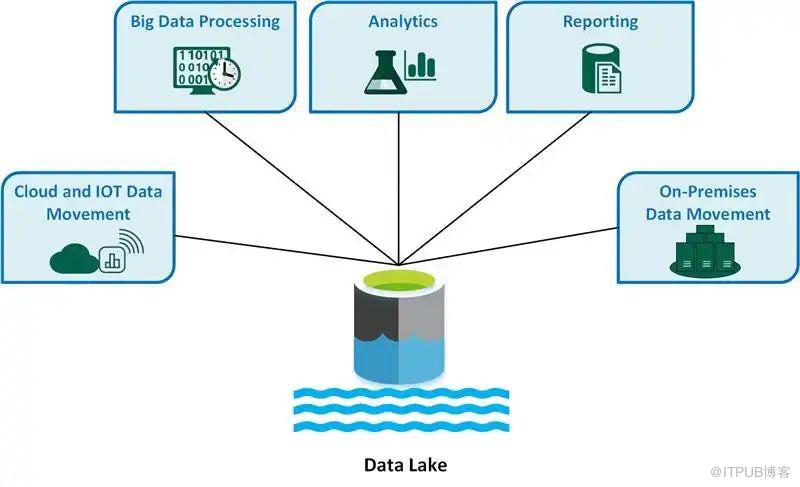
数据湖存储大量原始、非结构化和半结构化数据。与数据仓库不同,数据湖不会对数据施加严格的架构,从而允许在数据提取和存储方面具有更大的灵活性。
特征:
原始数据存储:以原始格式存储数据。
可扩展性:可以处理大量数据。
读取时模式:在读取数据时应用模式,而不是在存储数据时应用模式。
好处:
灵活性:可以存储多种数据类型,包括结构化、非结构化和半结构化数据。
可扩展性:适合处理大数据工作负载。
经济高效:与数据仓库相比,存储大量数据通常更便宜。
挑战:
数据管理:如果没有适当的管理,数据湖就会变成数据沼泽。
性能:与数据仓库相比,查询性能可能较慢。
用例:
大数据分析
机器学习和数据科学
存储日志和事件数据
示例:医疗保健提供商使用数据湖来存储患者记录、医学图像和传感器数据,从而实现全面的分析和研究。
3. 现代数据堆栈
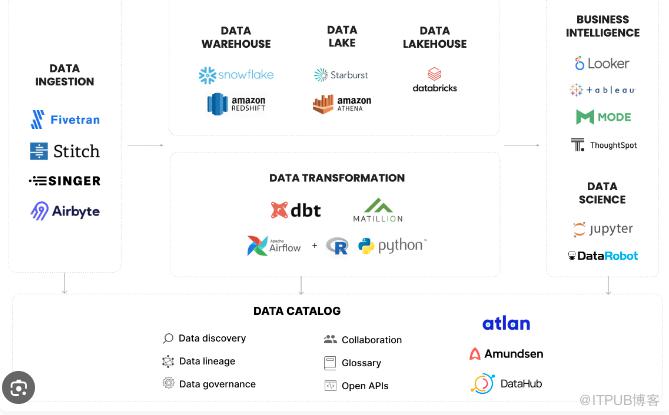
现代数据堆栈是指一组模块化的、基于云的工具,用于促进数据集成、转换、存储和分析。这种方法强调灵活性、可扩展性和易用性。
成分:
数据提取:Fivetran 或 Stitch 等工具用于提取和加载数据。
数据转换:类似 dbt(数据构建工具)的工具用于转换仓库内的数据。
数据存储:像 Snowflake 或 Google BigQuery 这样的云数据仓库。
数据可视化:Looker、Tableau 或 Mode 等工具用于数据探索和可视化。
好处:
模块化:灵活的组件,可以轻松交换或升级。
可扩展性:基于云的解决方案可随着数据量和使用情况而扩展。
易于使用:用户友好的界面和自动化减少了对大量技术专业知识的需求。
用例:
快速部署数据分析解决方案
敏捷数据管理和转换
自助分析和报告
示例:科技初创公司使用现代数据堆栈快速建立数据基础设施,集成来自各种 SaaS 应用程序的数据,使用 dbt 进行转换,并使用 Looker 可视化洞察。
4.统一的批处理和流式架构
统一的批处理和流式架构旨在在单一框架中处理实时数据和批处理数据。这种方法简化了数据处理流程,并降低了管理批处理和流式数据的独立系统的复杂性。

关键架构:
Lambda 架构:通过将数据流分成单独的路径来结合批处理和流处理。
Kappa 架构:通过将所有数据视为流来简化 Lambda 架构。
Lambda 架构:
批处理层:处理大量历史数据。
速度层:处理实时数据以获得即时洞察。
服务层:合并批处理层和速度层的输出以获得统一的结果。
好处:
全面的数据处理:处理历史数据和实时数据。
容错:通过批量重新处理确保数据的准确性。
挑战:
复杂性:管理单独的批处理和流式传输系统可能具有挑战性。
Kappa 架构:
统一流处理:将所有数据视为流,简化架构。
重新处理:允许重新处理数据流以进行历史分析。
好处:
简单性:通过使用单一数据处理模型来降低复杂性。
灵活性:更易于管理和扩展。
示例:金融服务公司使用 Apache Kafka 进行实时数据流传输,并使用 Apache Flink 进行统一批处理和流处理,从而使他们能够在同一数据平台上实时处理交易并执行历史分析。
5.数据湖
数据湖屋结合了数据湖和数据仓库的特点,既具有数据湖的灵活性,又具有数据仓库的性能和管理能力。
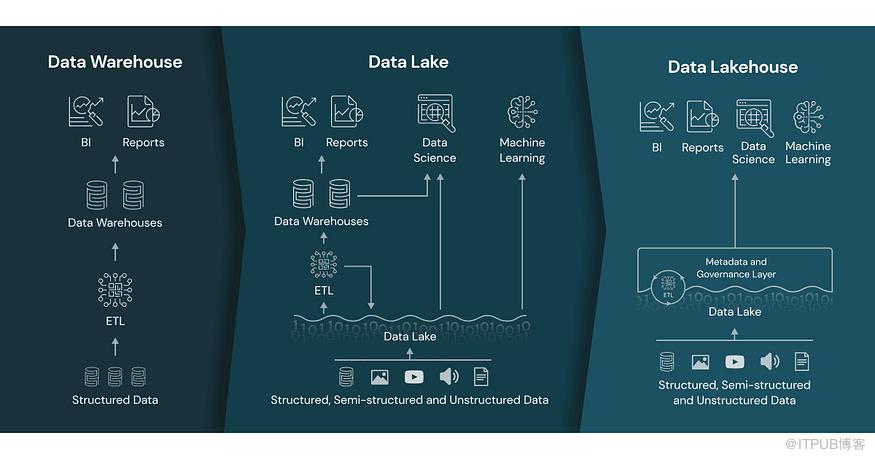
特征:
统一存储:存储结构化和非结构化数据。
ACID事务:支持数据操作的原子性、一致性、隔离性和持久性。
模式执行:允许读取时模式和写入时模式。
好处:
灵活性:可以处理各种数据类型和工作负载。
性能:针对高性能查询和数据管理进行了优化。
数据管理:提供强大的数据管理和治理功能。
用例:
统一数据分析和报告
机器学习和人工智能工作负载
实时和批量数据处理
示例:媒体公司使用数据湖来存储和分析流数据、客户互动和内容元数据,从而实现个性化的推荐和见解。
6.数据网格
数据网格是一种去中心化的数据架构方法,它将领域驱动设计的原则应用于数据管理。它从集中式数据湖或数据仓库转变为更分布式的模型,其中数据所有权和责任与特定业务领域保持一致。

特征:
面向领域:数据由最了解它的领域进行管理。
数据即产品:每个领域都将其数据视为产品,确保质量和可用性。
自助数据基础设施:提供必要的工具和平台,使域能够独立管理其数据。
联邦治理:以去中心化的方式实施集中式政策和标准。
好处:
可扩展性:允许组织随着业务的增长扩展其数据架构。
敏捷性:实现更快、更灵活的数据管理和分析。
所有权:促进领域内的数据所有权和责任。
用例:
具有多样化数据需求的大型组织
寻求改善数据治理和质量的公司
希望扩展数据基础设施的组织
示例:跨国公司实施数据网格来管理营销、销售和财务等各个部门的数据,允许每个部门处理其数据,同时遵守整体治理政策。
7.数据编织
数据编织是一种架构方法,通过连接本地和云环境中的不同数据源和应用程序来创建统一的数据环境。它旨在提供无缝访问和数据集成,确保一致的数据管理和治理。
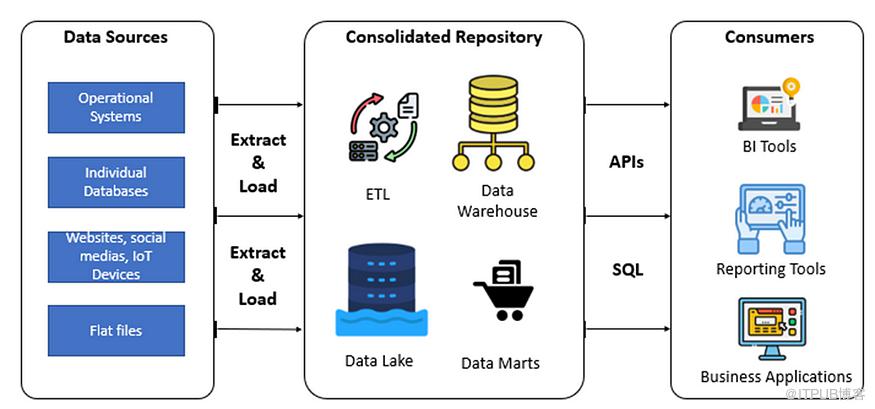
特征:
统一访问:提供所有数据源的单一访问点。
集成:连接不同的数据环境,实现数据移动和集成。
自动化:利用人工智能和机器学习来自动化数据管理任务。
治理:确保整个数据环境中的数据质量、安全性和合规性。
好处:
一致性:确保整个组织的数据一致。
效率:减少数据孤岛并简化数据访问。
敏捷性:促进快速的数据集成和移动。
用例:
具有混合数据环境的组织
寻求改善数据集成和管理的公司
需要确保数据治理和合规性的企业
示例:金融机构使用数据结构集成来自其内部部署数据库和云应用程序的数据,为监管报告和业务分析提供统一的视图。
往期推荐
谈谈汽车数据价值变现及收益分配
谈谈利用主数据改进数据分析的重要性
数据仓库中的7种建模方法及示例
谈谈在数据驱动中数据建模的重要性及建模方法
谈谈数据团队具有产品思维的重要性
元数据管理的架构视图
谈谈如何利用数据资产为企业带来更多价值
数据资产、数据产品和数据服务
原文作者:数据驱动智能;如有侵权,请联系管理员删除。

