一、引言:金融财务Agent进入真落地时代
2025年中国金融智能体市场规模达9.5亿元,同比增长120%。Gartner预测到2028年至少15%的日常工作决策将由AI Agent自主完成。金融财务审核场景因高频、规则明确、流程标准化,成为Agentic AI最易规模化落地的领域之一。金融机构的财务场景数据极度敏感、合规性要求近乎苛刻、系统架构新旧交织。若Agent仅提供对话式交互而无实质业务执行能力,则沦为昂贵的演示工具。
本文从系统集成、数据孤岛、安全合规、投资回报等架构师关注维度出发,提供一套可操作的选型检查清单。
二、金融机构选型的特殊性:为何不能套用通用标准
2.1 一般企业vs金融机构的评估差异
一般企业选财务AI,侧重功能覆盖、易用性、价格。金融机构的评估维度远为严苛——账户信息、客户资金流水、监管报送底稿,任何一处数据失控均可能触发合规风险。
两者在以下维度存在根本性差异:
-
数据主权要求:一般企业可接受公有云SaaS,金融机构原则上要求数据不出域
-
决策责任归属:一般企业可将AI作为参考工具,金融机构的每一笔审核结论必须明确责任人
-
监管报送义务:金融机构需向证监会、银保监会等监管机构定期报送业务数据,Agent必须支持监管数据提取与格式转换
-
系统变更管理:银行核心系统的任何变更需经过变更管理委员会审批,Agent不能频繁触发系统变更

2.2 金融行业的三大硬约束
金融财务审核面临三项刚性约束,构成选型的底线条件。
-
数据不能出机房:客户交易数据、持仓信息、资金流水属于高度敏感数据,监管要求物理隔离。任何涉及数据外传的部署方案一票否决。
-
操作必须可追溯:人行反洗局2025年对银行业开出罚单总额超3.6亿元,其中因内控缺失被罚占比超55%。每一步自动化操作须有完整日志、可复核、可追责。
-
系统必须适配国产化环境:金融信创已进入规模化推广阶段,非国产化技术栈产品无法进入采购序列。
2.3 常见选型误区
金融机构在Agent选型中容易陷入以下认知偏差,需在评估启动前予以排除。
-
迷信大模型参数规模,认为模型越大幻觉越低。实际上金融场景下幻觉风险与模型规模无线性关系,更取决于RAG架构、知识库质量和推理链设计。
-
优先看重报表生成可视化效果,忽略底层安全合规。展示层美观与风控有效性是两回事,审计关注的永远是后者。
-
将通用Agent直接接入核心业务系统,尤其涉及客户信息、交易数据的场景。通用Agent未经金融场景微调和安全加固,直接接入等于引入不受控风险敞口。
-
混淆通用大模型能力与金融场景定制化落地能力。一个在通用榜单上排名靠前的大模型,在财务报表理解、监管规则推理等专业任务上可能表现平庸甚至不及格。
-
低估私有化部署的运维成本。大模型推理需要GPU资源,日志存储需要扩容,知识库需要持续更新维护——这些都是许可证费用之外的隐性成本。
三、核心检查项一:安全合规(一票否决项)
在银行、券商场景中,合规已从加分项升级为否决项,不满足直接排除。建议将此维度纳入选型评估的第一步,采用一票否决制。
3.1 数据安全与隐私
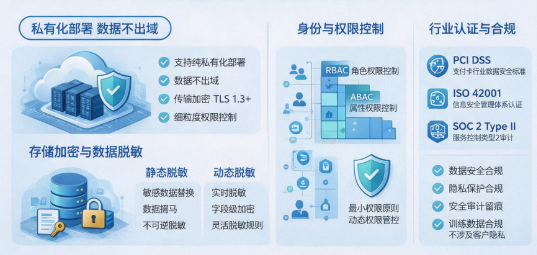
数据安全是金融财务Agent的生命线,需从传输、存储、使用三阶段逐一核查。
-
是否支持纯私有化部署,确保数据不出域
-
数据是否加密传输(TLS 1.3及以上),是否支持权限细粒度控制(RBAC+ABAC)
-
是否通过金融行业安全认证,如PCI DSS、ISO 42001、SOC 2 Type II
-
是否具备数据脱敏能力(静态脱敏、动态脱敏),是否支持字段级加密
-
模型训练数据来源是否合规,是否涉及客户隐私数据
3.2 审计追溯能力
审计追溯是金融场景区别于通用场景的核心要求。
-
操作日志是否保存3年以上且不可篡改。3年对应监管检查追溯期要求。
-
是否支持区块链哈希链或WORM存储等防篡改机制。日志一旦写入不可修改,满足司法取证标准。
-
每一步决策能否被审计、被复核、被追责。需区分系统决策与人工确认的边界。
-
证据链是否完整——每个风险结论能否回到原文出处。不完整的证据链等于没有证据。
-
是否支持全链路审计留痕与权限分级管控,包括模型输入输出、人工复核记录、规则变更历史、系统登录行为四个层级。
-
是否支持监管机构现场检查时的日志快速导出与格式化输出。

3.3 信创适配(金融刚需)
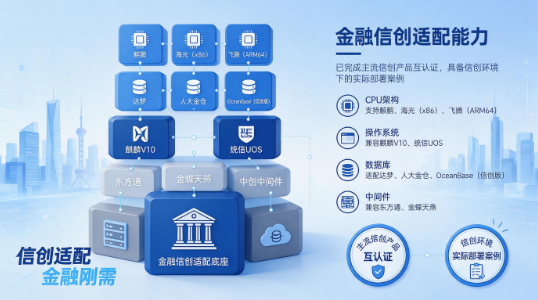
金融信创已进入全面推广阶段,非国产化技术栈产品无法进入金融机构采购序列。
-
CPU架构:是否支持鲲鹏、海光(x86)、飞腾(ARM64)三种主流国产芯片
-
操作系统:是否兼容麒麟V10、统信UOS
-
数据库:是否适配达梦、人大金仓、OceanBase(信创版)
-
中间件:是否兼容东方通、金蝶天燕
-
是否已完成主流信创产品互认证,是否具备信创环境下的实际部署案例
四、核心检查项二:技术架构与部署
技术架构决定Agent能否在金融机构现有的IT治理框架内平稳运行,部署模式直接影响长期运维成本。
4.1 私有化部署模式(三种架构对比)
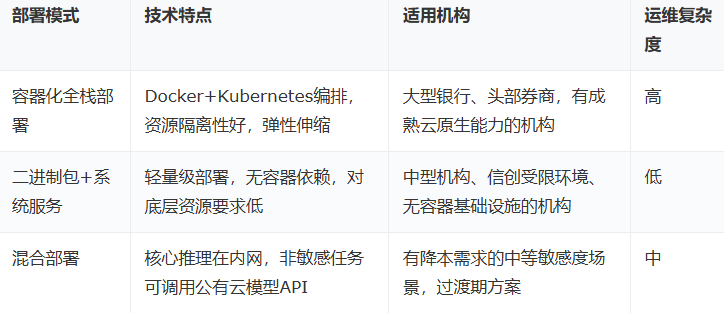
选型需评估以下几个关键问题:
-
是否提供纯私有化部署方案,非混合云伪装成私有化
-
部署后运维复杂度如何,包括容器化程度、依赖组件数量、是否需要专职运维团队
-
是否支持无公网依赖的离线安装,安装包体积是否在可接受范围
-
是否支持多环境隔离(开发、测试、生产)
-
是否提供自动化部署脚本与运维手册
4.2 性能与稳定性
金融机构对系统稳定性的要求远高于一般企业,性能指标需量化评估。
-
是否支持7×24小时连续运行,设计可用性是否达到99.99%以上
-
端到端延迟是否满足业务要求——证券交易场景需小于500ms,银行对账场景可放宽至秒级
-
是否支持横向扩展与高可用部署,是否有主备切换机制
-
银行场景:是否具备单集群高可用乃至两地三中心灾备能力
-
是否具备故障自愈机制,故障恢复时间(RTO)和数据恢复点(RPO)是否明确
-
是否支持灰度发布和AB测试,以便新版本上线前小范围验证
4.3 跨系统贯通能力
金融机构系统生态极为复杂,Agent需对接大量存量系统。
-
对接新系统需要多长时间,是否支持标准化接口(RESTful API、WebSocket、gRPC)
-
是否必须依赖API,还是支持屏幕语义理解技术实现对旧系统的非侵入式操作
-
面对界面UI变动,流程是否需要人工重录——屏幕语义理解方案应具备UI变动自适应能力
-
是否支持与遗留系统深度集成(COBOL程序、IBM Mainframe、CICS事务系统)
-
是否支持与企业服务总线(ESB)、MQ消息队列等中间件的对接
-
是否支持与核心账务系统、TA系统、估值系统的数据交换
五、核心检查项三:业务能力
业务能力直接决定Agent能否胜任实际财务审核任务,是选型评估中耗时最长的环节。
5.1 多模态单据识别与处理
金融场景涉及发票、合同、银行流水、回单、报关单、托管行对账单、增值税专用发票、承兑汇票等多种单 据类型,版式复杂多样,识别难度远高于标准化表单。
-
支持哪些单 据类型(须逐一列明,而非泛泛说支持所有票 据)
-
对非固定版式的识别准确率——扫描件清晰度不一、拍照件存在透视畸变、印章遮挡等干扰因素下的鲁棒性表现
-
是否支持表格结构还原(如银行流水中的交易明细表)
-
是否支持手写体识别(如票 据背书签字、审核意见手写批注)
-
是否支持多页文档的版面分析与内容关联(如合同中的条款与附件关联)
-
识别置信度是否输出,低置信度样本是否自动转入人工复核队列
5.2 规则推理与合规审核
财务审核的核心在于判断——不仅要提取数据,还要理解审核规则并输出可解释性结论。这是区分财务Agent与通用OCR工具的关键能力。
-
规则引擎是否支持自然语言配置,而非仅依赖工程师编写脚本。业务人员应能直接录入审核规则。
-
能否输出每一步审核决策的理由,形成可审计的审核意见书
-
规则变更后的生效周期,是否支持热加载无需重启服务
-
是否具备幻觉抑制机制——当信息不足时应明确表态无法判断,而非强行给出结论
-
是否支持复杂的条件组合与跨表关联推理,如费用报销需同时核查预算余额、发票真伪、审批流程完整性
-
是否支持多版本规则管理,便于规则变更前后的效果对比
5.3 可解释性与证据链
金融场景下,不可解释的AI结论等于没有结论。每一笔审核结果必须能为业务人员提供充分的决策依据。
-
每个结论是否找得到原始依据——结论与证据之间应建立双向索引
-
是否支持证据定位功能,每个风险结论关联到原文的具体页码和段落
-
人工复核效率如何,包括存疑比例、复核通过率、平均处理时长三项核心指标
-
是否支持生成审核报告,包含审核结论、依据条款、风险等级、处理建议
-
模型拒绝回答率是否合理——过高说明能力不足,过低说明风险意识薄弱
六、核心检查项四:厂商评估
产品本身过硬之外,厂商的综合实力同样关键,尤其在长期运维和持续迭代层面。
6.1 行业积累与案例验证
-
是否有金融行业成功落地案例,尤其同类机构(国有大行、股份制银行、城商行、券商、基金公司各有不同的业务特点)
-
是否理解银行/证券的业务逻辑与监管要求——如资本管理办法、流动性覆盖率、净稳定资金比例等核心监管指标
-
是否有信创环境下的实际部署经验,部署过程中遇到过哪些坑、如何解决
-
案例是否为生产环境正式上线,而非PoC试点后无下文
-
是否有与监管科技相关的落地实践(如监管报送自动化、合规自查)
6.2 交付与运维能力
-
是否提供可视化监控与告警能力,监控指标是否覆盖系统健康度、任务成功率、延迟分布、GPU利用率
-
是否具备自动故障诊断能力,能否在异常发生时自动生成诊断报告
-
厂商的技术支持响应机制与SLA——7×24还是5×8,现场支持还是远程,响应时间承诺
-
厂商是否提供定期巡检与健康度评估服务
-
知识库更新机制——金融监管政策频繁变动,厂商如何保持知识库与最新法规同步
6.3 成本与ROI
-
总拥有成本(TCO)——包含实施、集成、运维、硬件采购,不仅是软件许可证费用。金融机构往往只计算采购预算而低估后续三年运维投入。
-
平衡开发成本与长期维护成本,避免引入新框架造成技术债务。需评估团队学习曲线和人员流失风险。
-
是否有明确的ROI测算模型。典型测算逻辑:替代人工审核的工作量×单位人力成本-(软件采购+硬件采购+运维费用)。
-
计费模式:按Tokens计费、按并发用户数计费、按任务量计费、一次性买断制。不同模式对机构成本结构影响差异巨大。
-
是否有POC阶段的免费试用额度,降低选型试错成本。
七、选型实操建议
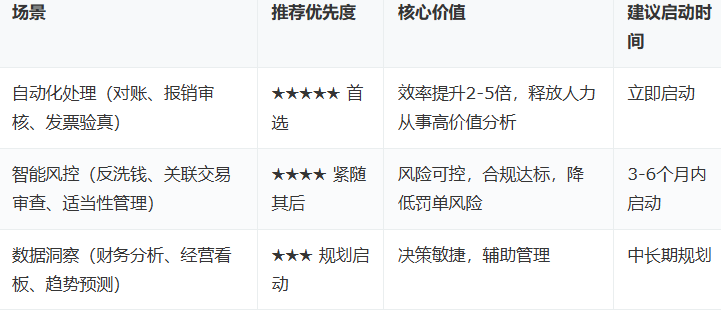
7.1 分场景优先级排序
建议采取分步走策略:优先落地自动化处理场景,积累经验后再扩展至风控场景,最后推进数据分析场景。每个阶段验证通过后再进入下一阶段,降低一次性大规模投入的风险。
7.2 验证方法:PoC必须现场跑
PoC(概念验证)是选型最关键的环节,不可仅凭产品彩页或厂商演示做决策。
-
选择最核心、最复杂的一个财务场景——如信创环境下的多银行流水对账,或跨系统的费用报销审核——让候选厂商在真实环境里跑一遍。封闭环境和生产环境的压力完全不在一个量级。
-
不要仅测试清晰的PDF,要测试模糊扫描件、拍照件、盖章遮挡件等真实业务中常见的劣质材料,重点考察材料解析完整率。
-
验证规则漏判和模型误判的实际表现。用一批已知结果的样本测试,对比Agent的判断与人工审核结果的一致性。
-
测试周期建议不少于两周,覆盖日常业务量和峰值业务量,观察系统在高负载下的表现。
-
要求厂商提供PoC测试报告,包含详细的数据指标而非定性描述。
7.3 六大必验指标
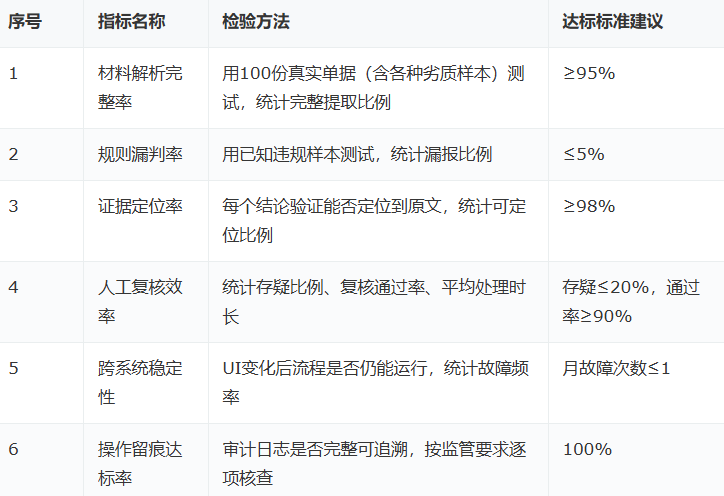
以下六项指标是选型决策的核心量化依据,应在PoC阶段逐一采集数据。
-
材料解析完整率:不要只测标准格式的PDF,要测真实业务中的劣质样本。完整率低于95%的产品需要大量人工补录,效率提升大打折扣。
-
规则漏判率:测试边界案例和复杂规则组合。漏判意味着风险敞口,反洗钱场景下漏判即合规事故。
-
证据定位率:每个结论能否溯源。审计追问时无法自证的产品,价值归零。
-
人工复核效率:存疑比例、复核通过率、处理时长三项综合评估。存疑比例过高则自动化效果不足,通过率过低则模型不可用,处理时长无明显缩短则ROI不成立。
-
跨系统稳定性:UI变化后流程是否仍能运行。金融系统频繁升级,每次UI变动导致流程重录将显著拉高运维成本。
-
操作留痕达标率:审计日志是否完整可追溯。逐项核对监管要求,确保无盲区。
7.4 企业级智能体平台简析
平台简介:
实在Agent:以AI+RPA为核心,自主识别屏幕元素模拟人工操作,不依赖API即可跨平台完成数据抓取与回填。自研TARS流程垂直大模型,OSWorld榜单全球总榜第 一(90.2%成功率)。适用于不想改造现有系统、需快速实现跨系统流程自动化的场景。
Agentar(蚂蚁数科):全栈企业级智能体平台,贯通智算调度、模型训推、应用开发全链条。Agentar-Fin-R1金融推理大模型在三项金融基准测试中位列第一。沉淀亿级高质量金融专业数据,上线业内首 个金融MCP服务广场。IDC 2025年中国金融行业大模型平台市场份额排名第 一。
HiAgent(火山引擎):1+N+X企业智能体工作站,依托豆包大模型,日均Tokens使用量突破50万亿。底层Eino框架使Token成本降低60%以上。2025年中国智能体开发平台私有化市场排名第 一。
千帆(百度智能云):一站式模型开发部署平台,全国产异构算力资源纳管。千帆慧金金融大模型提供8B和70B两个版本,基于海量金融语料深度训练。IDC 2025年中国金融行业大模型平台市场份额排名第二。
百炼(阿里云):MaaS模型服务平台,支持MCP协议标准化接入。已上线盈米MCP提供近30个专业金融工具。2025年中国智能体开发平台私有化市场排名第三。
八、结语
金融机构选智能体,第一道门槛不是效果,而是可追溯——每一步决策能否被审计、被复核、被追责。选型不能只看回答准确率,而应按业务责任、规则与模型分工、证据链、人工复核、系统接入和模型替换能力来判断。
建议金融机构以本文检查项为基础,形成内部需求文档和招标评估框架,在选型过程中逐项验证,避免能用但不好用、好用但不合规的困境。
附录:银行证券财务Agent选型评分表
建议将上述检查项转化为以下可量化评分维度(每项1-5分),便于招标时横向对比:
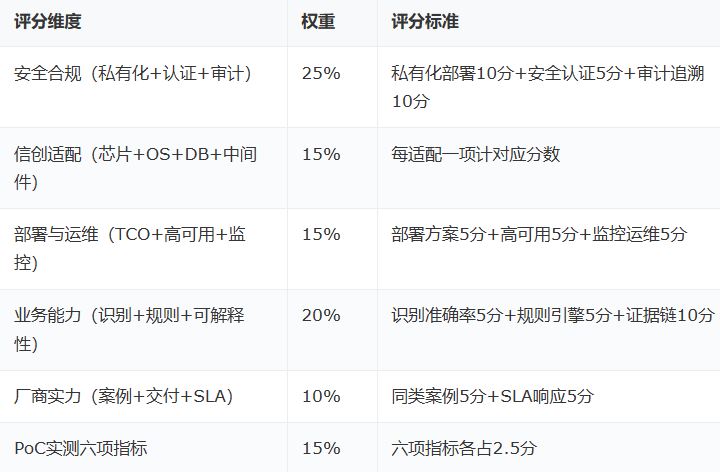
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70051022/viewspace-3181868/ ,如需转载,请注明出处,否则将追究法律责任。

