摘要: 企业数据中80%至90%为非结构化数据,涵盖PDF文档、扫描件、电子邮件、聊天记录、图片及音视频等多种形态 。这些数据承载着企业运营的核心业务上下文,是AI智能体进行推理、决策与行动的关键依据 。然而,调研显示94%的企业在非结构化数据管理上面临严重困难,57%的AI项目未能达成预期目标 。本文系统阐述非结构化数据处理Agent的端到端闭环架构——从文档解析(Parse)、语义检索(Retrieve)、推理决策(Reason)到业务行动(Act)的四阶段模型,分析金融、保险、法律等行业的落地案例,梳理企业落地过程中的六个核心问题,并客观盘点五款企业级智能体工具,为企业构建从数据提取到业务自动化的完整闭环提供参考框架。
关键词 :非结构化数据;智能体(Agent);智能文档处理(IDP);Agentic Document Workflow;端到端自动化;RAG;多智能体系统
一、背景与挑战:非结构化数据——智能体时代的核心瓶颈
非结构化数据指不具备预定义数据模型或未按行列表格组织的信息形态,包括PDF文档、扫描图像、电子邮件、即时通讯记录、办公文档、音视频文件等 。结构化数据(如财务记录、交易数据)虽能提供关键数值信息,但非结构化数据承载的是业务运行的完整上下文 。一份保险理赔文档中的病历描述、一份贷款合同中的特殊条款、一封客户投诉邮件中的情绪表达——这些信息无法被数据库中的字段所覆盖,却恰恰决定了业务决策的质量。
企业非结构化数据的规模与利用之间存在巨大鸿沟:
-
占比高、利用率低 :非结构化数据占企业数据总量的80%至90%,但70%的企业表示其非结构化数据的可发现和可用比例不足一半 。
-
投资失衡 :非结构化数据占企业数据的80%-90%,却仅获得40%的技术投资 。
-
项目失败率高 :Gartner 2026年报告显示60%的AI试点项目因数据就绪度不足而失败 。
传统非结构化数据处理手段的局限性日益凸显:
-
人工处理 :速度慢、成本高、难以规模化。
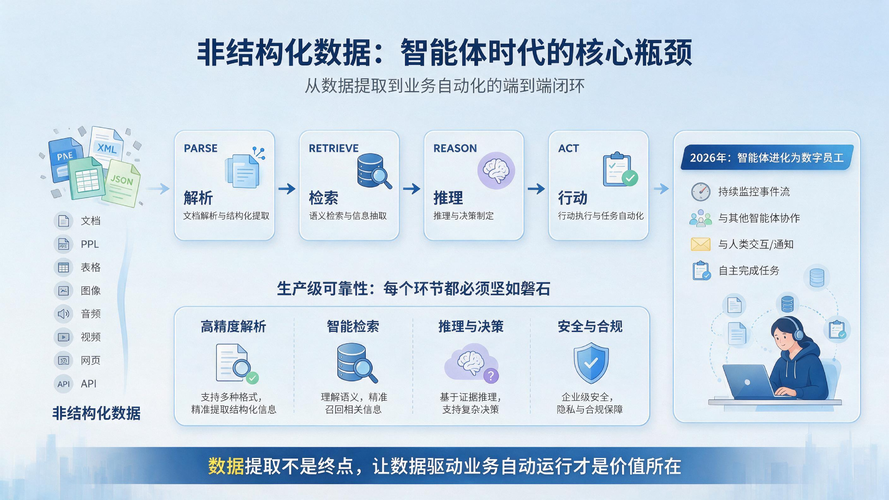
传统智能文档处理(IDP)将非结构化文档转化为结构化数据只是起点,真正的运营卓越需要从数据捕获走向对完整文档流程的智能体编排 。数据提取本身不是终点,端到端的业务自动化才是价值兑现的场所。
二、核心理念:Agentic Document Workflow的四阶段闭环
Agentic Document Workflow(智能体文档工作流)代表了非结构化数据处理从被动工具向主动智能体的范式跃迁。其核心架构可分解为四个相互衔接的阶段 :
(一)Parse:解析与提取
解析阶段的目标是将原始非结构化文档转化为可供下游系统消费的结构化对象。这一阶段面临的核心挑战包括:文档格式的多样性(PDF、Word、PPT、Excel、扫描件、图片)、复杂版面结构(多列表格、嵌套表格、图表、手写内容)以及文档层级关系的保留 。
现代Agentic解析方案的核心特征:
-
多模态理解 :同时处理文本、图像、表格、公式,而非仅依赖纯文本OCR 。
-
语义重构 :将解析结果输出为类型化对象(如Pydantic模型),包括文本块、表格、图片及元数据,而非原始OCR文本 。
IDP Accelerator框架展示了解析阶段的典型技术组合:DocSplit组件利用BIO标注对复杂文档包进行多模态分类分割,可配置的提取模块依托多模态大语言模型将非结构化内容转化为结构化数据 。在医疗行业的实际部署中,该框架实现了98%的分类准确率、80%的处理延迟降低和77%的运营成本缩减 。
(二)Retrieve:检索与上下文召回
检索阶段的目标是从已解析的文档库中精准召回与当前任务最相关的上下文片段。检索质量直接决定后续推理的可靠性——劣质解析导致垃圾输入,检索不准导致推理失焦。
核心技术方案包括:
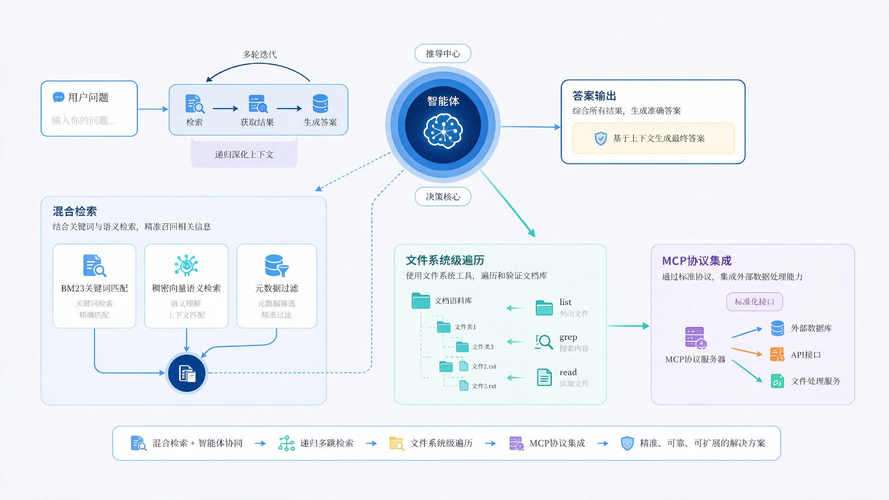
-
混合检索 :结合BM25关键词匹配与稠密向量语义检索,配合元数据过滤实现精准召回。
-
递归多跳检索 :通过多轮检索逐步深化上下文,而非一次性检索后即止 。
-
文件系统级遍历 :LlamaParse的Retrieval Harness为智能体提供list、grep、read等文件系统级工具,使智能体能遍历和验证整个文档语料库,而非寄希望于单次语义检索恰好命中正确的数据块 。
-
MCP协议集成 :通过Model Context Protocol(模型上下文协议)使智能体以标准化方式调用外部数据处理能力 。
(三)Reason:推理与决策
推理阶段是Agentic系统区别于传统自动化工具的核心分水岭。传统RPA遵循固定的if-then规则,遇到未编程场景即告失败;Agentic系统则通过大语言模型驱动的推理核心,理解文档上下文并动态做出决策 。
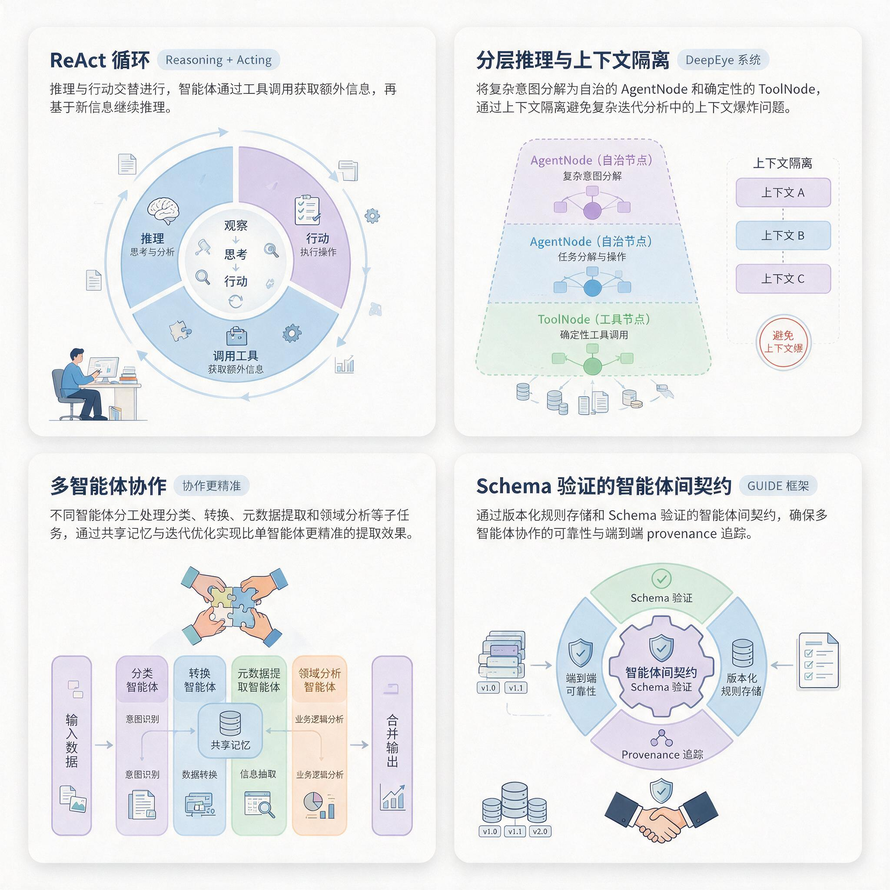
推理阶段的关键机制:
-
ReAct循环 :推理(Reasoning)与行动(Acting)交替进行,智能体在推理过程中可调用工具获取额外信息,再基于新信息继续推理 。
-
分层推理与上下文隔离 :DeepEye系统将复杂意图分解为自治的AgentNode和确定性的ToolNode,通过上下文隔离避免复杂迭代分析中的上下文爆炸问题 。
-
多智能体协作 :不同智能体分工处理分类、转换、元数据提取和领域分析等子任务,通过共享记忆与迭代优化实现比单智能体更精准的提取效果 。
-
Schema验证的智能体间契约 :GUIDE框架通过版本化规则存储和Schema验证的智能体间契约,确保多智能体协作的可靠性与端到端 provenance 追踪 。
(四)Act:行动与业务自动化
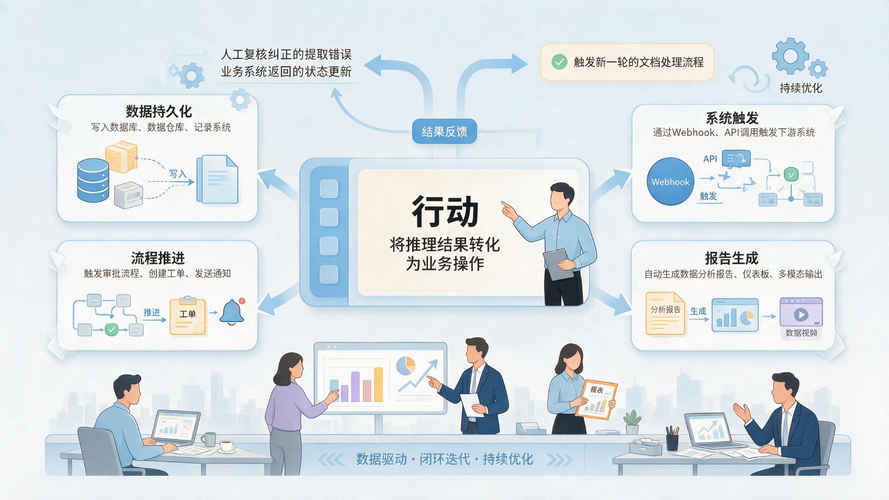
行动阶段是将推理结果转化为实际业务操作,实现从数据到价值的最后一公里。行动的类型包括:
-
系统触发 :通过Webhook、API调用触发下游系统动作。
端到端闭环的真正价值在于:行动阶段产生的业务结果可反馈至解析和检索阶段,形成持续优化的闭环——例如,人工复核纠正的提取错误可作为训练信号优化解析模型,业务系统返回的状态更新可触发新一轮的文档处理流程。
三、行业应用案例
(一)保险行业
保险业是文档密集型行业,理赔流程涉及病历、医疗发票、诊断证明、出入院记录等多种非结构化文档。平安产险采用多模态文档智能解析技术,基于PingAnGPT大模型与OCR融合,精准识别和提取复杂文档中的关键信息(险种类型、赔付金额等),截至2026年8月,个人非车险准入自动流程案件占比已超95% 。
韩国Shinhan Life保险公司基于生成式文档处理方案ETL with LLM,在内网环境中结合自研模型、大语言模型和Agentic Workflow,对业务方法书等复杂保险文档进行信息提取并自动写入系统,项目于2025年12月正式上线运行 。UiPath在保险业聚焦于利用代理式AI规范非结构化数据的初次损失通知(First Notice of Loss),AI代理能主动标记投保文件中缺失的信息,提高直通式处理率 。
日本あいおいニッセイ同和損害保険引入AI智能体分析客户声音(VoC)和员工反馈等非结构化数据,从传统依靠主观感知的定性判断转向数据驱动的洞察提取,用于新施策的研讨和既有施策的效果测定 。
(二)金融行业
银行贷款审核流程中,单笔贷款申请可能涉及数百页文档,需在多阶段进行人工验证 。Agentic IDP系统将文档视为待探索的环境:若遇到复杂条款,智能体会重读上下文段落以确保完整捕获法律义务;若收入以非本币列示,智能体可调用实时汇率API验证借款人资质 。
在投资研究领域,Agent从财报、政策文件等非结构化文本中提取Alpha因子,自动生成研究报告。在合同与贷款审核场景中,Agent自动提取申请人信息和收入数据,完成合规性检查与风险评级 。
(三)法律与合规
法律文档审查涉及海量非结构化文件的分类、信息提取与合规验证。IDP Accelerator的规则验证模块以大语言模型驱动的逻辑替代传统确定性引擎,处理复杂的合规检查 。LlamaIndex的Agentic Workflows已被芝加哥一家律所用于大规模筛选证据开示文档 。
(四)企业通用场景
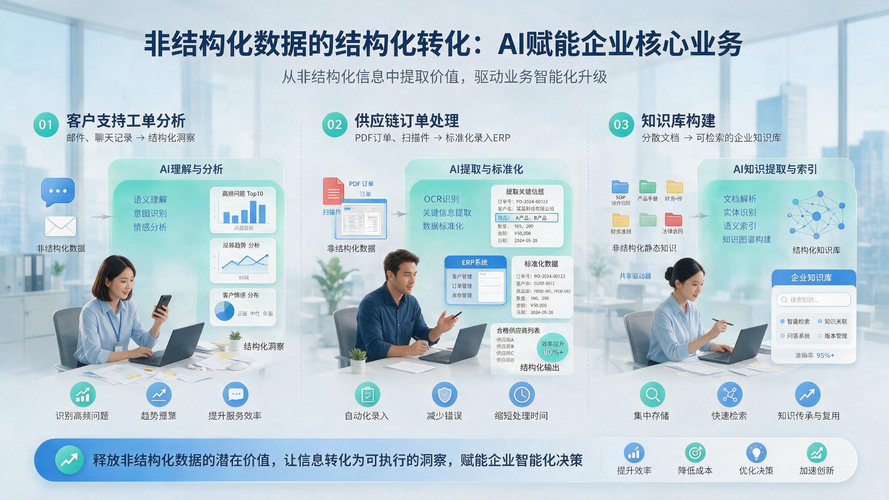
-
客户支持工单分析 :将非结构化工单(邮件、聊天记录)转化为结构化洞察,识别高频问题和投诉趋势。
-
供应链订单处理 :从非结构化订单文件(PDF订单、扫描件)中提取关键信息,标准化后录入ERP系统。
-
知识库构建 :将分散在共享驱动器中的SOP操作规程、产品手册、财务准则、法律合同等非结构化静态知识转化为可检索的企业知识库 。
四、Agent处理非结构化数据:六个必须搞清的核心问题
企业在规划和部署非结构化数据处理Agent时,以下六个问题必须优先厘清:
问题一:解析质量是否足以支撑下游任务?
解析是整个闭环的基石。传统OCR输出的是扁平文本流,丢失了文档的表格结构、标题层级和视觉布局信息。如果解析阶段输出的仅是原始文本,后续的检索和推理将建立在信息残缺的基础之上 。评估解析质量时需关注:表格结构的保留精度、多列文本的读取顺序正确性、图表和公式的处理能力、手写内容的识别准确率。
问题二:检索系统能否精准召回所需上下文?
检索质量取决于解析输出的质量和索引策略的合理性。混合检索(BM25+向量)通常优于单一检索方式 。需评估:检索结果的top-k准确率、是否支持元数据过滤、是否具备多跳检索能力、是否支持跨文档的关联检索。
问题三:Agent的推理是黑盒还是可审计的?
在金融、保险、法律等强监管行业,Agent的决策必须可解释、可审计 。需关注:Agent是否提供决策链路的可追溯性(provenance tracking) 、是否支持Human-in-the-Loop的关键节点干预 、是否具备置信度评分和来源引用机制 。
问题四:端到端的闭环是否真正打通,还是停留在单点自动化?
许多企业已部署文档提取工具,但提取后的数据仍需人工搬运至下游系统,形成自动化岛屿 。真正的端到端闭环要求:解析输出可直接被检索系统消费、检索结果可直接输入推理引擎、推理决策可直接触发下游业务系统的行动 。需审视各阶段之间是否存在人工接力的断点。
问题五:数据治理与合规性如何保障?
非结构化数据往往长期处于治理盲区——企业的数据治理框架主要围绕结构化的行列表数据构建,非结构化数据被遗留了二十年 。近90%的技术决策者表示,在数据经过正式治理验证之前无法完全信任AI驱动的洞察 。需评估:文档处理是否符合行业合规要求(HIPAA、GDPR、SOC 2) 、数据访问是否受身份感知控制 、处理过程是否可审计。
问题六:如何从试点走向规模化?
97%的企业已试点AI智能体,但仅18%实现了规模化部署 。规模化面临的障碍包括:数据安全问题(43%)、集成障碍(36%)、对数据缺乏信任(33%) 。从试点到规模化的路径应遵循:从小范围、高价值场景切入(如单一文档类型)→ 建立形式化的数据契约确保阶段间可靠交接 → 逐步扩展文档类型和业务场景 → 建立可观测性体系支撑规模化运营 。
五、企业级智能体工具盘点
以下从解析能力、检索与推理能力、行动集成能力、部署方式与生态四个维度,客观盘点五款企业级非结构化数据处理智能体工具。
| 维度 | LlamaIndex | Microsoft | AWS | 实在Agent | |
|---|---|---|---|---|---|
| 解析能力 | LlamaParse多模态解析,90+格式支持 | Azure Document Intelligence + Foundry Tools | Document AI,行业专用处理器 | IDP Accelerator + Bedrock | TARS大模型多模态理解 + OCR/IDP |
| 检索与推理 | Agentic Workflows + 混合检索 | Microsoft IQ四源统一 | Vertex AI Agent Builder | Bedrock Agents + AgentCore | 多模型统一调度 + 知识库管理 |
| 行动集成 | LlamaAgents编排 + MCP | Fabric + Teams + 365生态 | GCP生态 | Step Functions + S3 + SageMaker | RPA深度融合 + 跨系统拾取 |
| 部署方式 | 开源框架 + 云服务 | 云原生 + 企业级合规 | 云原生 + GCP集成 | 云原生 + 开源框架 | 企业级私有化部署 |
| 典型场景 | RAG、文档密集型垂直行业 | 微软生态内文档自动化 | GCP生态文档处理 | AWS生态 + 医疗等行业 | 跨系统业务流程自动化 |
六、结语
非结构化数据构成了企业数据的主体,也构成了智能体时代的核心瓶颈。从数据提取到业务自动化的端到端闭环,要求企业超越传统的单点文档处理工具,构建Parse-Retrieve-Reason-Act四阶段贯通的Agentic架构。
2026年被业界预测为长周期智能体的元年——智能体将从执行工作流进化为数字员工,能够持续监控广泛的事件流、与其他智能体和人类协作、在必要时通知和询问人类,其余时间自主完成工作 。这一演进的实现,依赖于非结构化数据处理能力的根本性突破:从解析到检索、从推理到行动,每个环节的可靠性都必须达到生产级标准。
对企业而言,当务之急不是等待更强大的模型,而是建立能够将非结构化数据转化为可操作智能的数据基础设施。数据提取不是终点,让数据驱动业务自动运行才是价值所在
。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70051022/viewspace-3181482/ ,如需转载,请注明出处,否则将追究法律责任。

