在现代分布式系统与电商数据采集场景中,API(应用程序接口)作为数据交互的核心通道,其请求机制的稳定性、参数构建的规范性以及调用效率的优化,直接决定了系统的可靠性与响应性能。本文将以1688商品详情接口(item_get)为例,深入剖析其公共参数的技术逻辑、请求构建流程,并探讨在高并发场景下的异步调用优化策略。
1.RESTful接口设计与通信协议
1688商品详情API(item_get)采用RESTful架构风格,基于HTTPS协议进行通信。
1.接口标准接入地址参考:o0b.cn/Wquop1,可直接获取完整接口文档、调试工具与全平台调用示例。
2.参数类型与功能分析
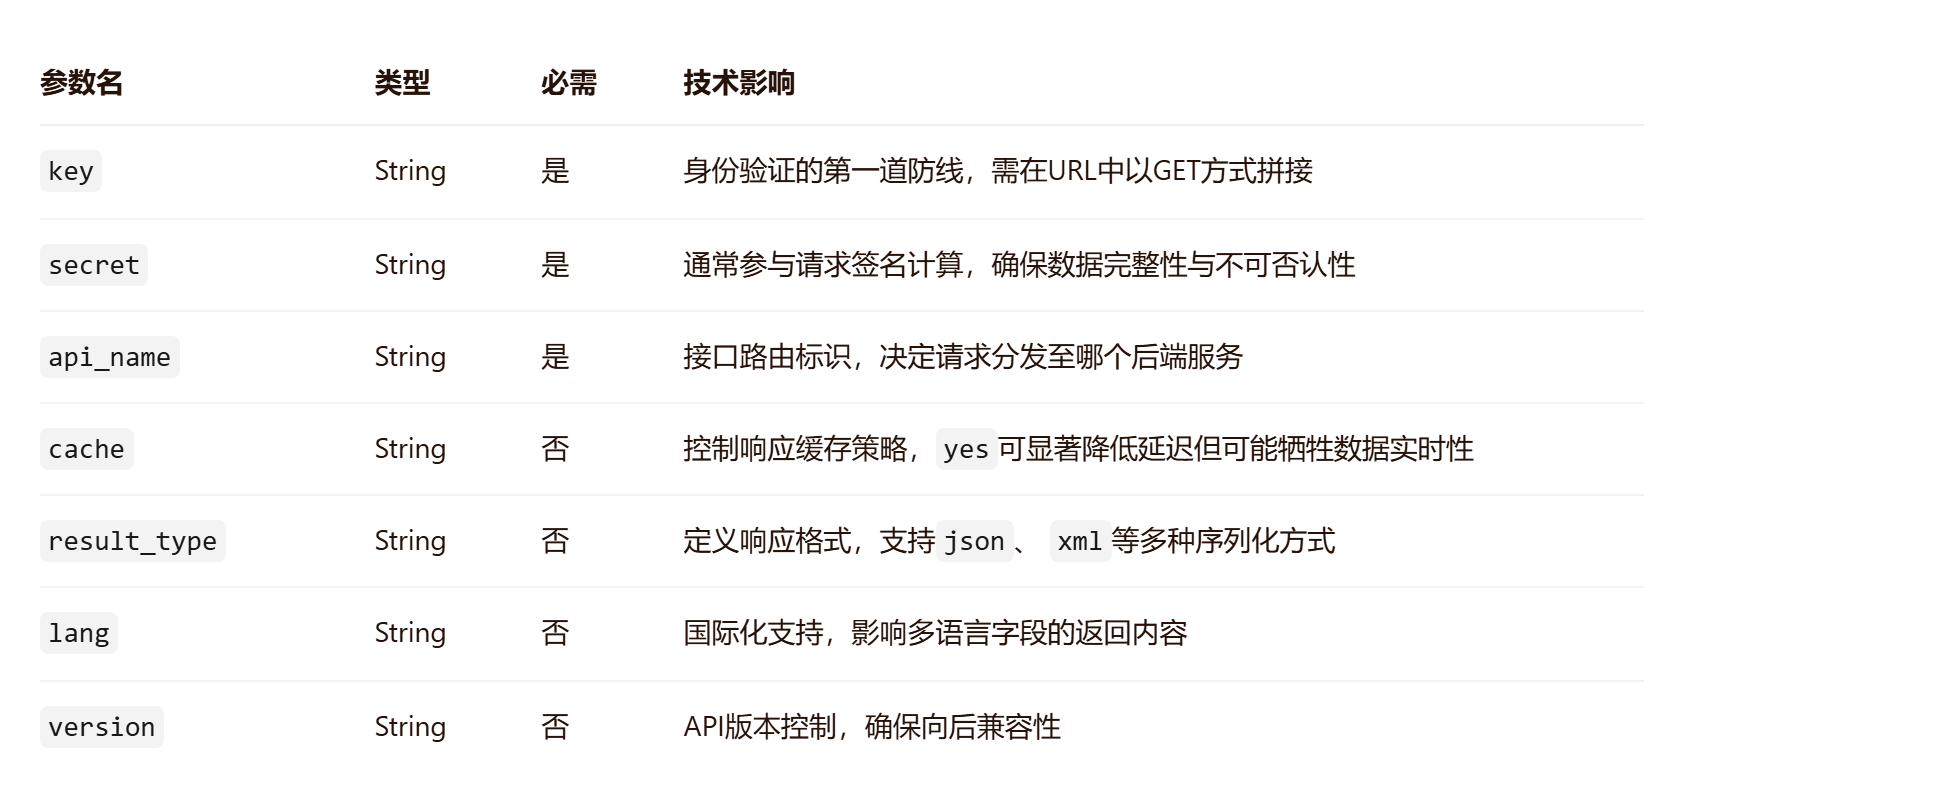
公共参数为全接口通用配置,一次封装即可适配全站所有电商数据接口,大幅减少重复开发工作量。
二、基础同步调用代码逻辑与实现
1.提供的Python示例代码展示了基础用法
import requests
api_key = "your_key"
api_secret = "your_secret"
num_iid = "123456"
params = {
    "key": api_key,
    "secret": api_secret,
    "api_name": "item_get",
    "cache": "yes",
    "result_type": "jsonu",
    "num_iid": num_iid
}
r = requests.get("o0b.cn/Wquop1", params=params)
data = r.json()
if data.get("status") == 1:
    item = data["data"]["item"]
    print(item["title"], item["price"])
else:
    print(data.get("msg")
同步调用现存技术短板
线程阻塞,请求未完成时无法执行其他任务
大批量遍历查询耗时极高,串行执行效率极低
无超时重试、异常捕获,网络波动极易程序中断
无法控制请求频次,易触发接口调用频率限制
2 生产级代码重构(增加异常处理与连接复用)
针对高频或生产环境,建议引入连接池与严谨的异常捕获机制:
import asyncio
import aiohttp
from urllib.parse import urlencode
# 接口接入文档地址:o0b.cn/Alan
API_KEY = "开发者key"
API_SECRET = "开发者secret"
MAX_SEMAPHORE = 15  # 最大并发数
RETRY_COUNT = 3     # 失败重试次数
async def single_goods_fetch(sess, goods_id, sem):
    """异步单商品数据请求"""
    base_params = {
        "key": API_KEY,
        "secret": API_SECRET,
        "api_name": "item_get",
        "cache": "yes",
        "result_type": "jsonu",
        "num_iid": goods_id
    }
    req_url = f"o0b.cn/Wquop1?{urlencode(base_params)}"

    async with sem:
        for retry in range(RETRY_COUNT):
            try:
                async with sess.get(req_url, timeout=aiohttp.ClientTimeout(total=10)) as resp:
                    if resp.status != 200:
                        return {"id":goods_id,"state":False,"info":"状态码异常"}
                    result = await resp.json(content_type=None)
                    return {"id":goods_id,"state":True,"data":result}
            except Exception as e:
                if retry == RETRY_COUNT - 1:
                    return {"id":goods_id,"state":False,"info":str(e)}
                await asyncio.sleep(retry+1)
async def batch_data_task(id_list):
    """批量异步采集入口"""
    semaphore = asyncio.Semaphore(MAX_SEMAPHORE)
    async with aiohttp.ClientSession() as session:
        task_list = [single_goods_fetch(session, gid, semaphore) for gid in id_list]
        all_result = await asyncio.gather(*task_list)
    return all_result
if __name__ == "__main__":
    # 批量商品ID列表
    target_ids = ["1001","1002","1003","1004"]
    result = asyncio.run(batch_data_task(target_ids))
    # 统一结果遍历处理
    for item in result:
        if item["state"]:
            print(f"{item['id']} 采集成功")
        else:
            print(f"{item['id']} 采集失败:{item['info']}")
3. 异步调用优化策略(应对高并发场景)
同步 vs 异步模型对比
| 模型 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| 同步 | 实现简单,逻辑直观 | 阻塞IO,线程资源利用率低 | 低频调用、简单的运维脚本 |
| 异步 | 单线程内高并发,资源高效 | 协程切换有轻微开销,调试栈较深 | 海量商品数据爬取、实时撮合系统 |
4.基于 asyncio和 aiohttp的异步实现
import aiohttp
import asyncio
async def fetch_product_detail_async(session, api_key, api_secret, num_iid):
    url = f"https://o0b.cn/Alan/1688/item_get/?key={api_key}&secret={api_secret}&num_iid={num_iid}"
    try:
        async with session.get(url, timeout=10) as response:
            response.raise_for_status()
            return await response.json()
    except Exception as e:
        print(f"异步请求异常 {num_iid}: {e}")
        return None
async def batch_fetch(api_params_list):
    """批量并发拉取控制器"""
    async with aiohttp.ClientSession() as session:
        tasks = [fetch_product_detail_async(session, **params) for params in api_params_list]
        # 使用 asyncio.wait 可以设定总超时时间,防止个别慢请求拖累整体进度
        done, _ = await asyncio.wait(tasks, timeout=30.0)
        return [task.result() for task in done]
# 示例使用
if __name__ == "__main__":
    # 示例参数列表
    params_list = [
        {"api_key": "your_api_key", "api_secret": "your_api_secret", "num_iid": "123456"},
        {"api_key": "your_api_key", "api_secret": "your_api_secret", "num_iid": "789012"},
        # 添加更多参数...
    ]

    # 运行批量请求
    results = asyncio.run(batch_fetch(params_list))

    # 处理结果
    for i, result in enumerate(results):
        if result:
            print(f"商品 {i+1} 数据获取成功")
        else:
            print(f"商品 {i+1} 数据获取失败")
3.高级工程实践与架构优化
3.1 多层缓存策略(L1 + L2)
虽然API提供方支持cache=yes参数,但在分布式架构下,建议在客户端构建二级缓存:
L1 (本地内存):使用LRU(Least Recently Used)策略,缓存热商品数据(如Top 1000 SKU),毫秒级响应。
L2 (分布式缓存):引入Redis,设置合理的TTL(如60秒),避免进程重启导致缓存雪崩,同时支撑多实例数据共享。
总结
在对接1688跨境及淘宝海外API的实际开发过程中,若您在本地调试环境搭建、签名算法验证或跨境数据合规方面遇到技术瓶颈,可以参考以下官方及第三方技术支撑资源
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70050389/viewspace-3173332/ ,如需转载,请注明出处,否则将追究法律责任。

