
最近一年,搜推中的精排模型迭代逐渐走向大模型方向,通过参数scaling law、序列和特征交叉建模等方式,不断释放算力对搜推模型效果的提升。从统一视角看,这些方法有很多相似性。它们的底层围绕特征和序列token化展开,上层通过多层的Transformer或MLP以及一些从LLM迁移的优化手段提升模型复杂度,验证推荐系统中的scaling law。今天这篇文章,就给大家汇总一下2025年字节在精排模型结构优化的代表工作,以及这些工作之间背后的关联。
字节提出的Rankmixer重点进行特征交叉层面的优化。其前身是谷歌DeepMind提出的Hiformer。Hiformer的核心思路是使用Transformer的结构进行特征交叉的计算,同时区别于NLP中每个token语义空间相同的应用场景,对每个特征使用独立的QKV映射矩阵进行映射,作为后续attention的输入表征。
Rankmixer在这个思路的基础上,借鉴了MLP-Mixer的建模思路,将Transformer结构替换成MLP结构。其核心思路是将attention这种两两相似度计算的方式,升级为MLP-Mixer这种非参数化的计算方式。
具体计算逻辑为,对于底层输入特征,将其分成多组,每组特征使用MLP映射成多个token表征,每组特征使用单独的MLP进行映射。接下来,借鉴MLP-Mixer的建模思路,通过token矩阵的转置操作,直接将部分各个token表征进行混合。
这种方式相当于强行让不同token之间不同维度表征进行互换,也起到了token间信息交互的目的。在MLP-Mixer原文中,也验证了其和Transformer效果差异不大,但是计算效率有明显提升。此外,文中也引入了Sparse-MoE等结构进一步对参数量进行scaling up。

长序列建模一直是推荐领域的核心话题,如何在计算复杂度提升量可控的前提下,建模更长周期的用户行为序列,是长序列建模研究的关键问题。在之前,业内通常采用两阶段进行训练,如MARM的全序列预训练大模型+表征引入精排模型的方式,或者阿里的ESU、GSU两阶段方法,以及快手的TWIN方式。这些方法虽然引入了更长的序列,但两阶段并不是最优解。
字节的Longer给出了一种端到端长序列建模方案。模型的输入包括global tokne和用户序列token两部分。Global token是用户属性信息、候选item信息、交叉特征等组成的多个token,其实就是模型中的其他基础特征。序列部分文中将长序列分成多组,每组多个行为,组内的行为子序列使用内部的一个transformer进行融合。通过这种方式,大幅缩短了输入序列的长度,组内由于子序列较短,attention计算的复杂度也不高。
在此基础上,后续采用cross attention和self attention相结合的方式进行建模。首先使用一层cross attention,采用global token,以及行为序列中最近的k个token作为query,检索序列和特征中的相关信息。接下来,使用多层self-attention中,则在上一层输出的token内部计算,进一步提取高阶的交叉信息。通过这种方式,以较小的代价首先将完整的长序列信息通过cross-attention吸收到较少的token中,再通过这些token的self-attention进一步提取高阶信息。
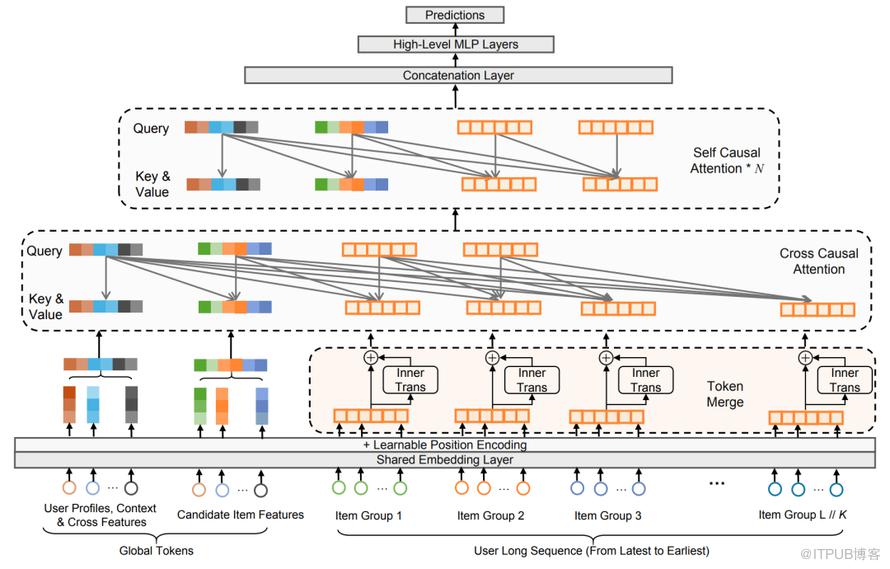
字节的OneTrans可以看成是字节前序的rankmixer、longer的融合版本,将特征交叉和序列建模放在一起进行优化。从OneTrans的结构中,可以看到很多rankmixer和longer的建模方法。
首先,OneTrans将序列和基础特征放到一起建模,对于非序列特征使用类似rankmixer的方法进行分组(人工分组或自动分组)得到多个token;对于序列特征将各种类型行为拼在一起,并用[SEP]特殊token进行不同类型行为的区分。接下来是多层的Transfomrer模块,这里对于序列特征使用共享参数进行QKV和FFN的映射,对于非序列特征,每个token使用单独的参数进行映射,类似rankmixer和hiformer中的操作。
最后,类似Longer的思路,每一层只选择最近的几个序列token进入下一层,减少计算量,同时也让模型将最关键的信息逐层汇集到少量的token上。

从字节的这三篇代表工作可以看出,基础特征建模和序列建模正在走向统一融合的过程,借鉴NLP、CV领域达模型的经验,将底层特征统一token化,再使用Transformer建模,配合序列压缩的方法,实现高效的精排模型Scaling Up,是未来精排进一步迭代的发展方向。

END


来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70050176/viewspace-3173379/ ,如需转载,请注明出处,否则将追究法律责任。

