
无论是语言模型还是推荐大模型,用强化学习进行偏好对齐已经成为不可缺少的一步。今天这篇文章给大家梳理强化学习在大模型中的应用,首先介绍强化学习的核心思路和算法,接下来结合语言模型、推荐大模型中的具体工作介绍强化学习在大模型中的应用方法。
强化学习核心要解决的问题为:给一个智能体训练一个神经网络,它以当前状态作为输入,预测下一步的动作,使得整体的期望reward最大。例如智能体是alphago,将当前棋牌状态以图像或网格数据等形式输入到神经网络,预测结果为下一步下在哪个位置,能赢得棋局。智能体为语言模型,则是将当前的问题或上下文作为输入,预测大模型应该给出什么样的答案,能够符合人类偏好。

为什么上述优化问题无法用普通的有监督学习进行优化?主要是2方面原因。其一是样本收集问题,在游戏等序列决策问题中,智能体的每次行为会影响后续状态进而影响后续行为和reward,生成样本本身就需要有一个初始智能体和环境互动,智能体也依赖这些样本更新,样本的收集和模型的更新是同步进行的,不像有件监督学习中数据集不会受到模型的影响。其他是reward优化问题,reward的设计一般比较复杂,例如每次行为有reward、整体有reward,这些reward可能是基于规则、模型计算得出的,本身不可导,因此不能像有监督学习那样直接简单引入模型中。
下面简单介绍强化学习最基础的算法Policy Gradient(PG)和Proximal Policy Optimization (PPO)。它们其实就是损失函数如何设计,能让神经网络更新产出能让reward最大化的智能体。模型的输入为当前状态,输出为当前状态下应该采用什么action(如一个简单的分类)。
PG算法的核心逻辑为:模型能够生成当前环境s下进行动作a的条件概率,如果这个动作的reward比较大,就提升它的概率,否则就降低它的概率。这和普通的有监督学习类似,主要差异是使用reward进行样本加权。
Reward的设计是核心,包括一些细节。比如当前动作对后续的影响是随时间降低的,因此对于当次行为后续带来的reward使用衰减系数进行降权;使用一个value function来拟合当前状态下未来最终得到的价值期望作为reward权重的baseline,如果当前action的reward比这个baseline高,才能证明是有收益的。
PG的训练过程很慢,需要先初始化一个智能体参数,进行多次序列行动收集样本,对参数进行一轮训练,然后再用新的参数进行样本收集,再进行训练,以此类推,效率很低。PPO主要为了解决该问题,引入重要性采样的方法,让模型能够使用新智能体参数去学老智能体收集到的样本,大幅提升训练效率。
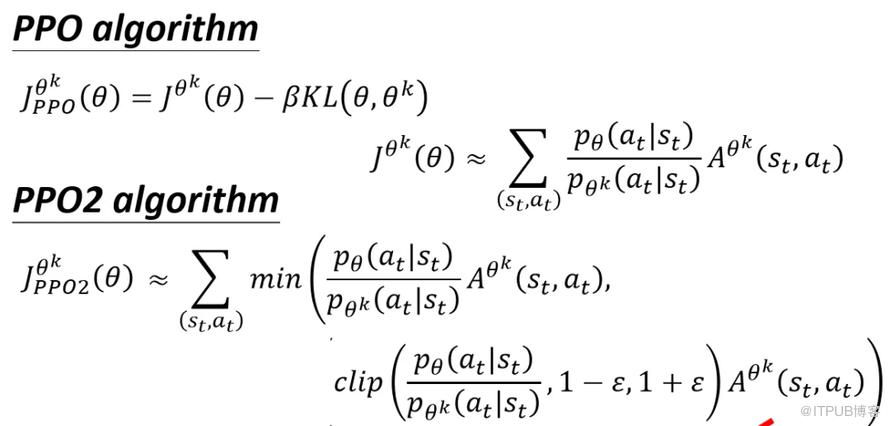
其核心思路是利用重要性采样,根据新老参数的分布差异对老参数智能体收集的样本进行加权使得该样本在新参数上也能训练。同时考虑到两个分布差异太大会导致重要性采样误差较大,使用KL散度约束新老参数产出的行为分布不能相差太多,也可以使用clip的方法对两个分布的差异进行clip。
在介绍了强化学习最基础的算法逻辑后,下面我们对大模型中强化学习的应用进行梳理。首先在大模型中应用强化学习的工作是Training language models to follow instructions with human feedback(2022),文中利用强化学习的PPO算法进行大模型的偏好对齐,构建了InstructGPT。在InstrucGPT中,智能体就是大模型本身,环境就是给大模型输入的prompt(如问题等,需要大模型给出回答),动作就是大模型每个时间步产出的文本,每个时间步产出的文本对应序列决策中每一步的action。
Reward文中使用了一个单独的模型产出,对于一个prompt让多个模型产出多种结果,让标注员评判这些结果的好坏,用这种带排序的标注结果训练一个奖励模型。对于一个prompt+回答,奖励模型能给出它的好坏程度,作为后续强化学习中的reward。通过这种方式,直接将人工评判的风格偏好引入到大模型中,这种不可导的奖励信号不借助强化学习是无法引入模型的。Value function使用了一个和大模型相同的结构,用来产出每个token生成预期的最终reward。

整体的损失函数表示如下,其中第一项是PPO损失,文中将PPO的KL散度约束改成了per-token的,即预训练模型和偏好对齐后的模型每个token的分布不能差异太大。同时也引入了前序非强化学习的预训练loss进行混合训练。
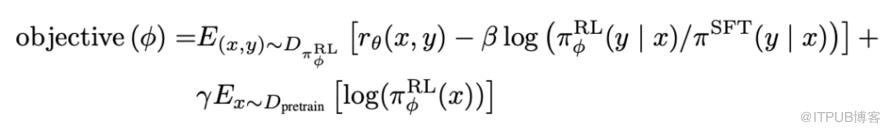
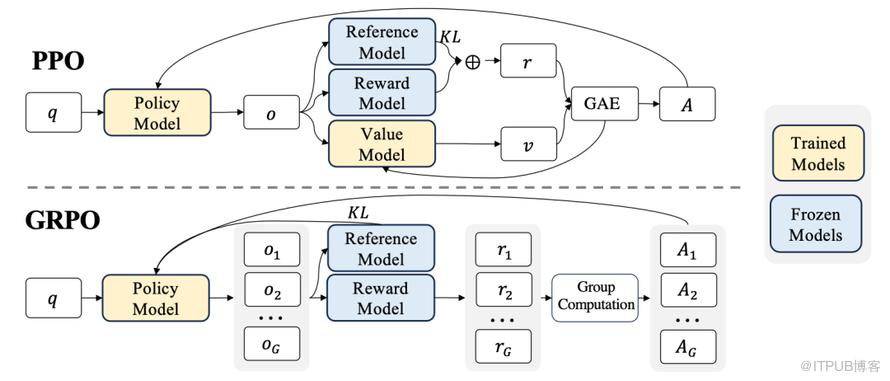
DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models(2024)提出了一种更高效的GRPO算法代替PPO。在PPO中,需要一个value function评估当前生成这个token未来的期望价值作为baseline,value function一般来说和policy(也就是大模型本身)是同相同的网络,参数量也很大,导致计算复杂度很高。为了解决这个问题,GRPO的核心优化是去掉了value function,改成使用对于同一个问题的多条采样输出结果的reward对当前reward进行归一化(计算采样均值、方差等),替代value function的baseline作用。和PPO的本质区别在于后者用模型预测reward期望作为baselin,前者用采样结果+reward模型打分统计平均reward作为baseline。
DAPO: An Open-Source LLM Reinforcement Learning System at Scale(2025)针对PPO、GRPO在大模型上应用存在的问题进行了多个细节优化。首先是将PPO中重要性采样引入的约束项的clip上限放开,Clip的作用和KL相似,都是为了让新参数和老参数产出的行为分布差异不要太大。但这种方式限制了低预估概率探索token的生成,同时高预估概率的探索token很难被限制住。其次是在GRPO的采样上,随着训练的进行有很多采样结果可能reward都是准确的且相同的,这些采样结果让模型在后期训练变慢,因此文中将采样次数提升,同时去掉其中完全准确的采样结果。对于序列长度的差异,之前采用sample维度求token loss平均计算loss,对于长句子来说每个token生成的好与坏被平滑掉了,因此文中将sample级别的loss改成token级别的loss。对于过长句子被截断的影响,文中发现这部分样本会影响训练稳定性(也是由于改成了token维度loss带来的负面效果),因此针对这些句子根据其超出最大长度限制比例进行降权,超出长度越多loss权重越低。
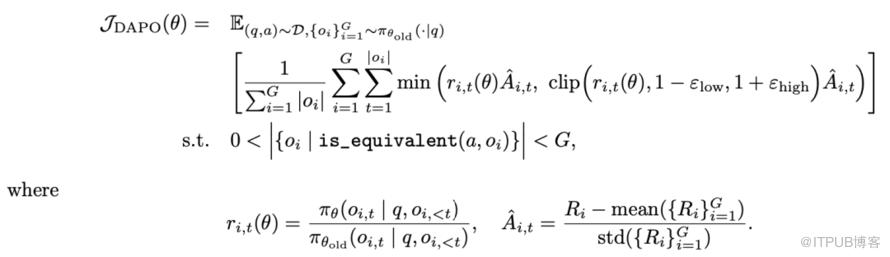
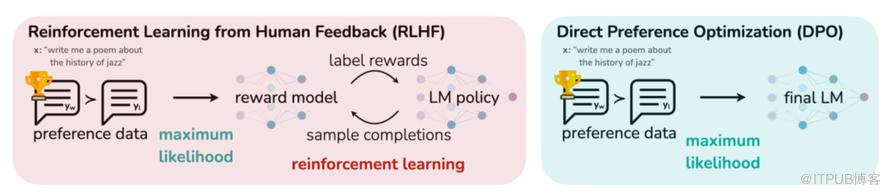
除了上述标准强化学习方法外,有的模型也利用其他方法模拟强化学习的偏好对齐能力。例如Direct Preference Optimization: Your Language Model is Secretly a Reward Model(2024)论文中提出的DPO方法,基于人工标注的最好的样本和最差的样本构建pair-wise样本,让模型预测好样本概率大于差样本,绕过了强化学习,Qwen模型中也使用该方法进行偏好对齐。
在推荐大模型中,基本沿用了语言大模型常用的强化学习方法,核心差异在于在推荐大模型中如何定义reward,在推荐系统中,一般根据用户日志来判断用户对推荐结果是否感兴趣,如播放时长、点击率等。
在第一版Onerec中,reward model采用了类似精排模型的方式训练各个关注的目标(如有效播放、点击率等)作为reward。对于一个用户的一次session请求,通过beam search的方式生成多组session推荐结果,使用精排模型打分得到每个session的总reward值,选择reward最大和最小的构建pair样本,使用DPO损失函数进行优化。

在Onerec V2中,也开始采用强化学习进行推荐大模型的偏好对齐。在reward的设计上,Onerec V2的做法更为简单,直接人工定义reward值。将用户看过的视频根据市场分组,当对一个视频的观看时长属于该分组下这个用户历史观看时长前25%的,reward就为1;当对一个视频有显示负反馈行为,reward就为0。这个过程将PPO中的value function和baseline作对比的作用直接放在了人工reward构造的过程中。

在强化学习算法上,分别提出了ECPO和GBPO方法,两者都是在PPO中的clip上做优化。ECPO中,对负向value的梯度的最大值也进行了约束,防止出现梯度爆炸问题,提升训练稳定性。在GBPO中,对于负样本提出了动态clip的方法,其核心逻辑为,一个负样本如果预测概率比较低,其进一步优化的空间就很小了,因此梯度应该比较小才合理,但是GRPO中并没有这种根据预测概率动态调节梯度的方法。在基础的BCE中,梯度中的1-p可以起到这个平滑作用,因此GBPO引入类似的方式,直接用1-行为概率预测结果作为负样本的动态clip边界。

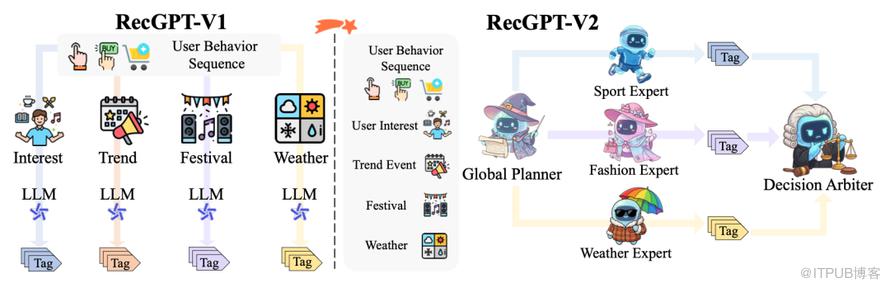
在RecGPTV2中,也采用了强化学习的方法对RecGPTV1进行偏好对齐。RecGPTV2采用GRPO进行优化,主要差异是在reward的设计上。在每个Expert的训练上,reward综合考虑了item tag预测的准确率、基于用户偏好对训练的奖励模型的打分、生成结果的多样性(每个tag映射成表征计算两两cosine距离的均值)等。可以看到在推荐大模型领域,reward的设计会更加复杂,需要综合考虑用户偏好、多样性、负反馈等各种信息。

END


来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70050176/viewspace-3172888/ ,如需转载,请注明出处,否则将追究法律责任。

