Agent 开始同时使用多个模型后,我们需要解决这样一个问题: 这一轮到底该用哪个模型?
当然,最省事的做法,是所有任务都交给能力最强的模型。但省事,不省钱。反过来,如果所有任务都交给更便宜的模型,看似省钱,却未必真的省。简单任务通常可以顺利完成,但一旦进入复杂分析、任务规划或者失败后的重新处理,模型可能会反复尝试。最后虽然单次调用更便宜,却增加了更多 Token 消耗、工具调用和失败重试。
所以,多模型 Agent 真正要解决的问题,是判断 当前这一步需要多强的模型,以及怎样在保证任务完成质量的前提下,把整体成本控制下来。
本文将结合 LangChain、NVIDIA、AWS、OpenRouter、Portkey 等技术团队已有的实践,讨论模型路由(下文用 Router 代替)中的几种工程设计思路。
模型池与能力分档
在判断任务难度之前,我们还要先确定 Router 到底可以从哪些模型里选?
LangChain 在为 Open SWE(LangChain 开源的 Coding Agent)设计 Router 时,并没有把所有可用模型直接交给分类器,而是 先根据能力和成本筛出候选模型,再划分为 Fast、Balanced、Performance 三个档位。
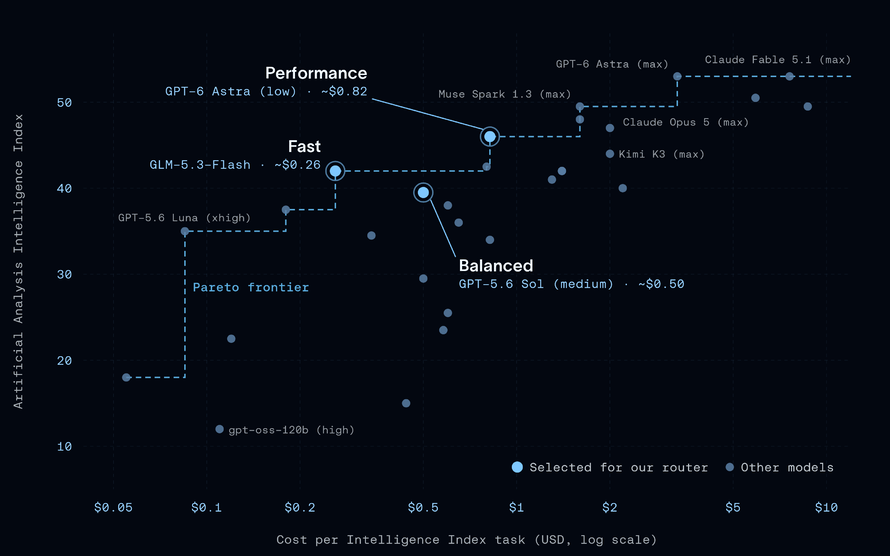
图注:Fast / Balanced / Performance 三档模型的成本分布图,图源 @LangChain
这里需要注意的设计是不一定要分成三档,而是不同档位之间要有足够明显的差异。如果两个模型价格接近,完成任务的效果也差不多,那么增加一次路由判断的收益就很有限;反过来,如果候选模型太多,而且能力高度重叠,Router 需要区分的边界也会越来越模糊。
所以 LangChain 实际上做了两件事:先在能力和成本之间选出几个有代表性的模型,再让 Router 判断,当前任务最低需要哪个能力档位 。
这样做有一个 好处,就是 Router 判断的是能力档位,而不是某个固定模型。今天 Balanced 档使用模型 A,之后模型 B 的能力提升或者价格下降,就可以直接替换进去,前面的任务判断逻辑不需要跟着重做。
但能力和价格还不是筛选模型的全部条件。进入 Router 之前,还要先确认模型能不能完成当前这类请求。
AWS Bedrock 的 Intelligent Prompt Routing 会限定可参与路由的候选模型,再在这些模型之间做选择。对于 Agent 来说,这一步尤其重要,因为不同模型在上下文窗口、输入模态、工具调用、结构化输出等能力上可能并不一致。一个模型即使价格更低,如果无法处理当前的工具调用或输出格式,也没有必要进入这一轮的候选范围。
因此,实际的模型选择可以拆成两个阶段:
全部模型
   ↓
过滤不满足当前任务要求的模型
   ↓
当前可用模型
   ↓
按能力和成本分档
   ↓
Router 选择
Router 真正需要比较的,是那些已经满足当前任务基本要求的模型。在这个范围内,再判断任务需要多高的能力,以及哪个档位更合适。
入口任务判断
确定候选模型以后,接下来才轮到 Router 判断:当前这个任务到底该交给哪一档模型。
如果只看任务开始时的第一次模型选择,一种常见做法是 先用一个轻量模型当**分类器**。Router 读取用户请求,根据任务内容判断它需要 Fast、Balanced 还是 Performance 档位,再把请求交给对应模型。
LangChain 的 Open SWE 就采用了这种方式。不过,他们并没有直接凭经验规定哪些任务算简单、哪些任务算复杂,而是先从 LangSmith(LangSmith 是 LangChain 做的一套 LLM / Agent 开发与观测平台)中分析真实 Thread,统计不同请求类型的调用轮数、单 Thread 成本和最终结果,再根据这些数据来设计分类标准。AWS 的 LLM-assisted Routing 也采用了相似思路,让分类模型先识别 Prompt 的任务类型、领域或复杂程度,再映射到对应模型。
这类方案的 优势是理解能力强,**分类器* *可以直接结合 Prompt 里的目标、约束和上下文做判断。相应的, 代价是每次路由都会多出一次模型调用。
所以,它适合在任务开始时做一次判断,再让后续多轮执行沿用这个结果。这样,一次分类的成本可以分摊到整个任务中。如果每一轮模型调用前都要重新判断,额外的延迟和成本就会不断累积。
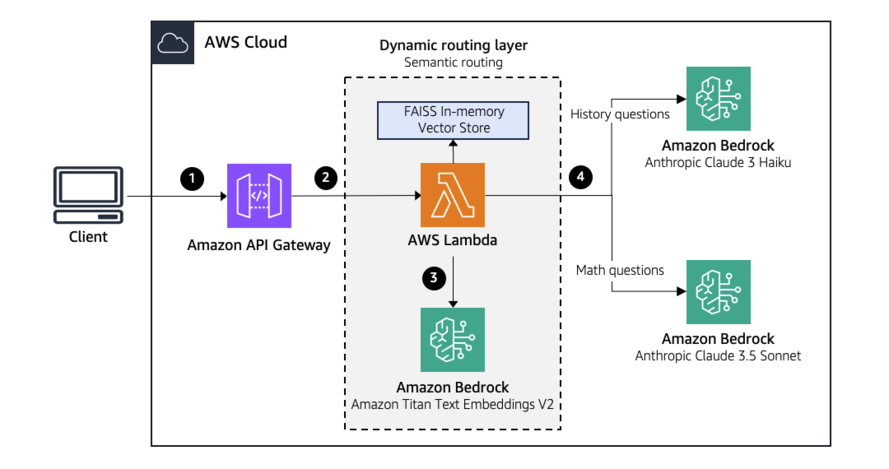
图注:Semantic Routing 架构图,图源 @AWS
如果任务类型比较固定,还可以进一步把这次的模型调用省掉。AWS 给出的另一种实现是 Semantic Routing: 先为不同任务准备一组代表性 Prompt,并计算对应的 Embedding;新请求进来后,通过向量相似度找到最接近的任务类型,再选择对应模型。
这种方式没有额外的生成过程,判断速度更快,也更适合任务类别比较清晰的应用。但它比较擅长判断“这个请求属于哪一类”,对任务实际需要多少推理能力,判断就没那么直接。
比如,“修复 CSS 错位”和“修复跨服务事务错误”都可能被归到 Bug Fix,但两者的复杂度和推理要求明显不同。因此,Semantic Routing 适合用来做任务或领域识别。如果还要继续判断模型能力需求,通常需要再结合其他信号。
Portkey 的 Task-Based Routing 则更偏 规则映射:根据任务标签、metadata 或分类结果,把不同请求分配给预先设定的模型。这种设计实现简单、可控性强,比较适合任务边界清楚、类型相对稳定的场景。
还有一类方案会继续往前走一步,不再先判断“这个任务属于哪一档”,而是直接估计不同候选模型完成当前请求的效果。AWS Intelligent Prompt Routing 更接近这种思路:Router 根据当前 Prompt 预测候选模型的响应质量,再结合成本做选择。这样一来,Router 关注的问题就从:
这个任务属于简单、中等还是复杂?,变成:
Model A 完成这个请求的效果如何?
Model B 完成这个请求的效果如何?
Model C 完成这个请求的效果如何?
然后从能够达到目标质量的候选模型中,选择成本更合适的一个。
这种思路接近模型路由真正要解决的问题。因为“任务难度”本身只是辅助判断的一个中间指标,最终还是要回答: 哪个模型能把当前任务做到要求的质量,同时成本更合适。
历史数据校准
如果 Router 长期依赖人工维护的“任务 → 模型”规则,很快还会遇到另一个问题: 模型本身一直在变。
OpenRouter 的 Auto Router 采用了一种数据驱动的做法。它先用一个轻量分类器,把 Prompt 分成大约 30 个更细的任务类别,例如
code:debugging、
agent:multi_step_planning、
math、
research_report 和
customer_support。
完成分类后,Router 会查看最近 7 天同类任务中各模型的实际使用支出占比,再结合用户设置的成本档位,对候选模型进行排序。这样一来,OpenRouter 就不需要长期维护一张固定的:
code → Model A
research → Model B
模型排序会随着近期的真实使用情况不断变化。如果大量开发者开始把某类任务转向新的模型,Router 也会相应调整候选顺序,不需要重新训练分类器,也不用人工修改规则。
这套设计主要是为了适应模型能力、价格和使用偏好的持续变化。 一套当前有效的固定映射,随着模型更新和使用习惯变化,可能很快就会失效。
当然,实际使用支出占比也不能直接等同于模型质量。开发者选择模型时,还会受到价格、品牌偏好、可用性、默认配置等因素影响。因此,Router 的模型映射应该能够根据真实运行数据持续调整。
实际系统里,用来调整路由结果的数据也不一定非得是实际使用支出占比,还可以是同类任务的成功率、平均成本、人工反馈,或者线上 A/B 测试结果。
OpenRouter 在多轮会话里还加入了一层稳定机制。即使每次请求都会重新计算候选模型,只要当前模型仍然处在合适的候选范围内,Router 就会优先继续使用它,避免因为排名的小幅变化频繁切换模型。
这样一来,模型选择既能随着真实数据变化,又不会在多轮任务里来回切换。

图注:不同任务类别、不同成本档如何对应不同模型,图源 @OpenRouter
执行状态改判
前面的几种设计都有一个共同点:模型选择主要发生在任务开始时。但 Agent 真正执行之后,会不断产生新的信息。例如:
读取项目
↓
定位目标函数
↓
修改
↓
测试失败
↓
再次修改
↓
测试再次失败
↓
重新搜索其他模块
刚开始时,这可能只是一个普通的 Bug Fix。但是随着任务继续执行,实际复杂度可能已经超出了最初的判断。对此,一些 Agent Router 会继续观察执行过程,再根据新的状态调整模型选择。
NVIDIA 的 Stage Router 就采用了这种设计。它不会每一轮都重新分析完整 Prompt,而是重点读取最近的 Tool Result,根据 Agent 当前的执行情况判断是否需要更强的模型。
它主要关注两类信号。一类是任务可能已经卡住的信号,例如:
-
severity:近期错误有多严重; -
spinning:反复执行相似操作,但一直没有明显进展; -
exploring:长时间停留在搜索、读取和分析阶段,还没有真正推进任务。
这类信号越集中出现,Router 越可能判断当前模型已经难以继续推进任务,需要切换到能力更强的模型。
另一类是任务仍在顺利推进的信号,例如持续修改文件、已经进入比较明确的执行阶段,或者测试开始通过。出现这些情况时,Router 更倾向于继续使用低成本模型。
这些信号不会单独决定最终结果,而是会放在一起判断。一次测试失败,并不能说明当前模型能力不足;一次搜索没有结果,也很常见。但如果连续出现:
测试失败
+
修改后再次失败
+
重复尝试相似操作
+
连续几轮没有新的进展
当这些信号连续出现时,系统会判断当前模型已经很难继续推进任务。对于一些更明确的异常情况,则可以直接触发升级,不需要再等待其他信号继续累积。因此,这类运行时 Router 通常可以分成三层判断:
明确的异常信号
→ 直接升级
一般执行信号
→ 累计判断
信号仍然不明确
→ 使用默认策略或交给 Judge
但一旦允许 Agent 在任务中途切换模型,Router 还要解决模型来回切换的问题。例如:
小模型
↓
失败
↓
大模型
↓
状态改善
↓
小模型
↓
再次失败
↓
大模型
这种频繁切换会带来 Prompt Cache 丢失、重新读取上下文以及工具调用行为变化等额外开销。NVIDIA 的 Stage Router 为此加入了
capable hold。
当任务升级到高能力模型后,Router 会让它继续执行若干轮,再判断是否有必要降回低成本模型,给强模型留出一个完整的恢复窗口。
另一种更简单的做法,是只允许单向升级。NVIDIA 的 Escalation Router 会先让低成本模型执行,再由 Judge 持续判断任务是否遇到困难。在 LangChain 的一项测试中,只有连续两次得到负面判断后,任务才会升级到高性能模型;一旦升级,本次 Session 后续都继续使用强模型。
这种方式会少一些进一步降本的空间,但状态管理更简单,也能减少反复切换。
所以,运行时路由真正需要设计的,不只有“什么时候升级”,还包括升级后保持多久、是否允许重新降级,以及什么情况下才算任务已经恢复稳定。
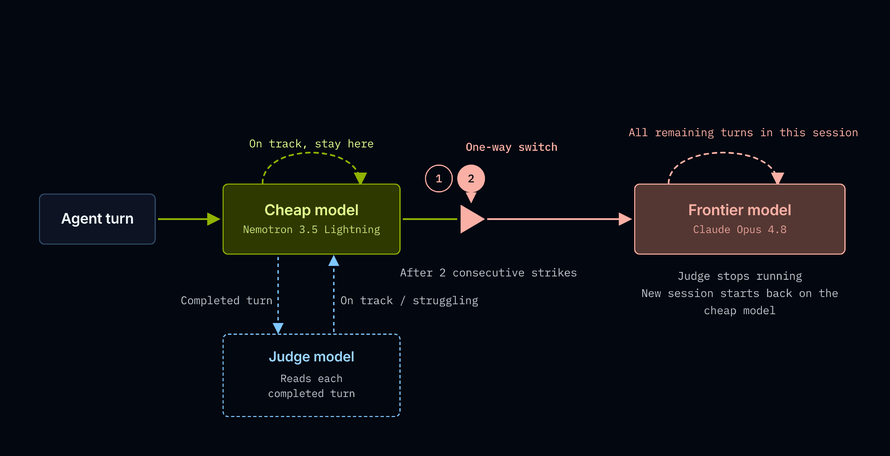
图注:“连续两次负面判断 → 升级到高性能模型并保持到 Session 结束”的流程,图源@LangChain
路由成本控制
动态路由还有一个容易被忽略的问题:Router 自己也要花钱。如果每一轮都调用 Judge,先判断“当前是否需要更强模型”,那么 Agent 每次调用之前都会多出一次额外的模型请求。任务越长,这部分成本和延迟就越明显。
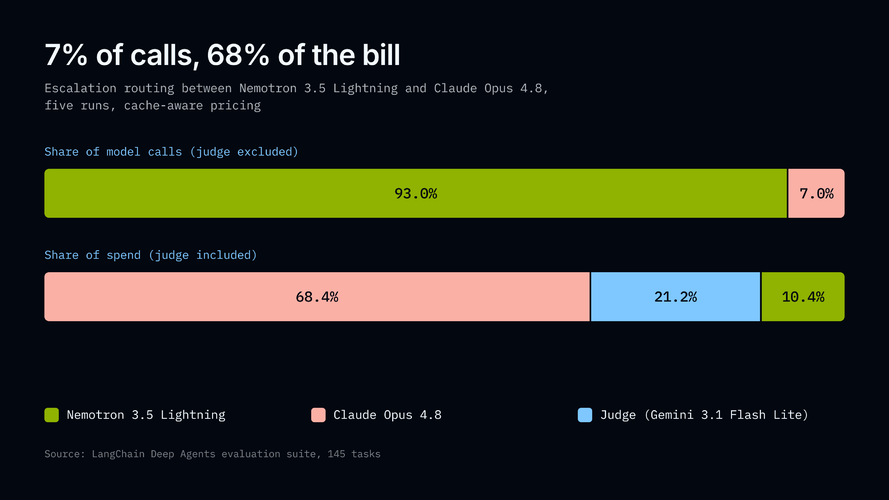
图注:模型调用费用,93% 的调用落到便宜模型,并不代表 93% 的费用也被省下来。图源 @LangChain
LangChain 在 Escalation Router 的公开测试里就观察到了这个问题。虽然 93% 的执行调用都由低成本模型完成,高性能模型只占约 7%,但最终费用结构是:
- 高性能模型:68.4%
- Judge:21.2%
- 低成本模型:10.4%
也就是说,负责判断“要不要升级”的 Judge,本身就消耗了超过五分之一的总成本。
所以,Router 自己也需要做成本分层,尽量避免所有请求都经过同样昂贵的判断过程。
例如:
判断比较明确
→ 直接选择模型
执行状态明显异常
→ 直接升级
信号比较模糊
→ 调用 Judge
Judge 仍无法确定
→ 回到默认档位
NVIDIA 的 Stage Router 就采用了类似思路。大部分请求先利用已有的执行信号完成判断,只有这些信号不足以做出明确选择时,才进一步调用 LLM Judge。
LangChain 在测试 Escalation Router 时还提出了一个更直接的成本判断方法:把 Judge 的调用成本与高低模型之间的价格差进行比较,可以估算需要把多少流量转移到低成本模型,才能抵消 Judge 本身的费用。
如果这个比例已经接近甚至超过 100%,说明仅靠模型切换很难覆盖 Router 的额外成本,这套路由在经济上就没有太大意义。
所以,判断任务难度本身也需要遵守同一个原则: 简单情况尽量用便宜的方法判断,把昂贵的判断留给少数边界情况。
路由效果评估
最后还需要回答一个问题:怎么判断这套路由到底有没有价值?
只看“大模型调用减少了多少”并不够。对于 Agent 来说,更有意义的是:在任务质量达到要求的前提下,完成一次完整任务需要多少成本。
LangChain 在 Open SWE 上做过一组线上 A/B 测试。973 个真实 Thread 中,Router 组的单 Thread 成本中位数为 0.94 美元,全高性能模型组为 2.61 美元,成本下降约 64%。同时,两组 PR Merge Rate 分别为 29.2% 和 27.3%,差异没有达到统计显著水平。
这组结果说明,在 Open SWE 的这批任务里,入口路由能够明显降低成本,同时没有观察到明显的任务质量下降。
但动态 Escalation 的结果就没有这么理想。
在 145 个多步骤 Agent Task 中:
| 策略 | 准确率 | 运行成本 |
| 全高性能模型 | 86.00% | $11.45 |
| 动态 Escalation | 80.00% | $3.00 |
| 全低成本模型 | 77.70% | $0.72 |
相比全高性能模型,动态路由的成本降低了约 74%,但准确率下降了 6 个百分点;相比全低成本模型,它只提高了 2.3 个百分点的准确率,成本却增加到约 4.2 倍。
这说明,模型路由有没有价值,很大程度上取决于任务分布和候选模型本身。 对于任务类型清晰、复杂度差异明显的场景,入口分流可能已经足够;对于长任务 Agent,运行时升级更有意义。如果低成本模型本身已经能稳定完成大多数请求,再增加 Judge 和复杂路由,收益可能就比较有限。
因此,模型路由最终要评估的,是完整任务的成功率、总成本和执行时间有没有真正改善。 同时,模型能力、价格和任务分布都会变化,现有的分档和路由规则也需要根据真实运行结果持续调整。
最终,Router 要回答的仍然是:当前任务该交给哪个模型,才能在达到目标质量的前提下,把完整任务的成本控制得更低。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70050060/viewspace-3185688/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 如何兼顾个人 Agent 的数据安全与个性化能力?
- Personal Agent 真能越用越懂你吗?AdaptArena 揭示个性化 Web Agent 的失效链路
- 周 1 上线 | Deno 团队加入 Cloudflare,黄老板 “盯上” Reflection AI
- 从 Bun 到 Deno,AI 时代的开发工具正在经历什么?
- Coding Agent 长任务中的 Context 压缩时机
- 模型变强之后,Skill 和 Prompt 该做减法了
- Agent 小知识|MCP 里的 Tools、Resources、Prompts 有什么区别
- 从上下文到权限:如何把 Agent 接进真实业务流程
- 从自我改进到递归进化:RSI 的五级路线
- 攒了上百个 Skill,Agent 知道怎么用吗?拆解多 Skill 场景下的分层加载机制
