PACE:代码通过率从 42% 到 97%, 让长程 Agent 在有限 KV Cache 下用好历史 Token
长程 Agent 经常需要在多个步骤后,重新使用前面的代码定义或业务规则。随着会话增长,KV Cache 无法无限扩张,推理系统需要选择性地保留历史信息。可问题是即便保留了后续任务所需的 Token,模型就一定能正确使用吗?
Amazon 研究团队在「[PACE: Keeping the Right Tokens in the KV Cache Is Not Enough for Long-Horizon LLM Agents]」中深入探索了这一问题:在有限 KV Cache 的合成编码实验中,所需 Token 仍留在缓存中的比例(缓存驻留率)接近 100%,代码检查通过率却仍随着这些历史 Token 与当前查询之间的 RoPE (旋转位置编码)位置距离增大而下降。
为此,作者提出 PACE(Planner-Aware Context Engine,规划感知上下文引擎),根据 Agent 后续步骤对历史信息的引用关系保留 Token,并通过重新编号驻留 Token、同步调整缓存中 Key 的 RoPE 旋转结果,控制历史 Token 与当前查询之间的位置距离,从而改善模型在长程编码任务中对历史信息的使用效果。
所需 Token 保留不保证代码检查通过
为了区分历史信息被淘汰和保留后仍无法正确使用这两种情况,作者设计了一组多步骤 Python 合成编码任务。模型首先定义数据类、状态类型,以及收费计算和舍入规则;随后不断读取约 2,000 Token 的 Python 标准库源码,并回答其中第一个函数的名称。经过大量中间步骤后,模型需要重新使用早期定义,编写收费函数、结算函数及完整模块。作者通过隐藏单元测试检查代码是否正确,同时统计答案中是否包含早期定义的类名、字段、常量和计算规则,分别观察代码正确性与历史事实召回情况。
实验采用 Qwen3-8B 模型,完整保留 100K Token 的 KV Cache 需要约 14.7GB 显存,而将每层缓存预算限制为 2,048 Token,仅占会话长度的约 2%。在有限预算下,已有方法通常根据注意力得分选择保留哪些 Token,例如 H₂O 使用累计注意力得分,SnapKV 则依据当前提示末尾的注意力进行选择。但过去很少使用的信息,可能正是未来任务的重要依赖。为检验保留所需信息是否足够,作者根据已知的任务依赖关系优先保护相关 Token,并固定会话总长度为 100K Token,只改变早期定义与后续使用之间的间隔。
仅使用规划感知保留时,当早期定义与后续使用之间的间隔从 2K 增加到 90K Token,所需 Token 的缓存驻留率仍约为 99.6%,但隐藏单元测试检查项的通过率却从 93% 下降到 64%。与此同时,答案中的事实召回率仍保持在 98%~100%,部分失败答案已经包含正确的历史事实,却没有将其正确应用到代码中。
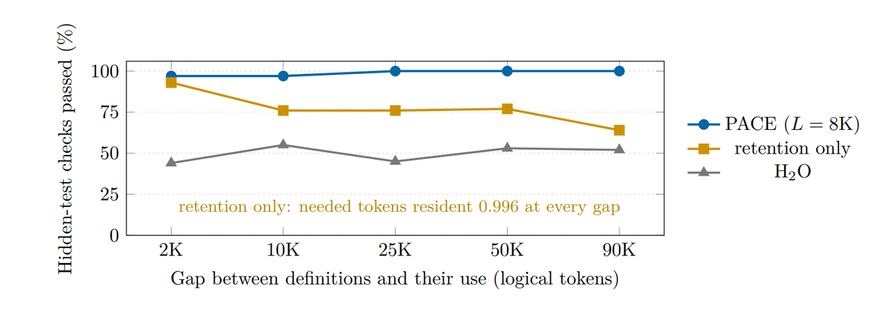
图 1:仅规划感知保留时,Token 驻留率稳定,代码检查通过率仍随逻辑间隔增大而下降。
这组实验揭示了两类缓存失效:后续所需信息被淘汰,以及信息仍然保留、模型却未能正确使用。前者涉及缓存保留策略,后者与保留信息和当前查询之间的 RoPE 位置距离有关。PACE 分别针对这两个问题设计了相应的处理机制。
任务依赖图决定未来需要保留哪些 Token
PACE 基于开源推理引擎 SparseEngine 实现,是对 H₂O 缓存管理器的扩展,无需重新训练模型。H₂O 根据历史注意力得分决定保留哪些 Token,却无法预知未来任务的需求。例如,一个早期定义的接口可能长期没有被使用,却是后续业务模块的重要依赖。PACE 因此将 Agent 的任务规划信息引入 KV Cache 管理,提前保护未来需要的内容。
从任务依赖到缓存保留决策
每个执行步骤开始前,Agent 通过额外请求字段向推理服务发送 Blueprint,说明哪些历史消息会被哪些未来步骤引用。例如,第七步需要使用第一步创建的数据结构,推理服务就根据聊天模板定位第一步消息对应的 Token 范围,再将 Blueprint 转换为包含 Token 起止位置和未来引用步骤的记录,供缓存管理器使用。
缓存管理器据此为相关 Token 增加“未来引用奖励”,并与 H₂O 原有的累计注意力得分相加,按照总分决定保留哪些 Token。奖励遵循三个规则:
-
未来仍会被引用的 Token 优先保留。实验设置的奖励下限为 50,000,高于测试中观察到的普通 Token 累计注意力得分;
-
当受保护内容超过缓存预算时,优先保留更早需要的 Token;
-
最后一次计划引用完成后,额外奖励归零。对应 Token 重新参与普通淘汰。
没有未来引用的 Token 仍按照累计注意力得分排序。
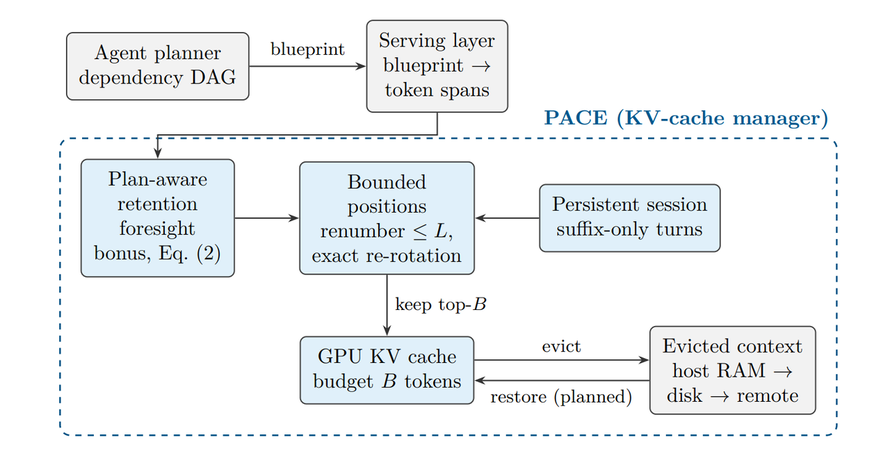
图 2:PACE 的 KV Cache 管理架构。
要让上述缓存保留决策在多轮 Agent 任务中持续生效,还需要延续此前的缓存状态。如果每一步都重新提交完整历史,推理引擎需要重复预填充,之前淘汰的 Token 也可能重新进入缓存,无法延续原有的淘汰结果。PACE 因此使用持久会话,将多轮任务映射为持续存在的推理序列,每轮只追加新消息,并通过前缀稳定的聊天模板保证 Token 序列的一致性。新步骤开始时,缓存管理器根据最新规划重新计算驻留 Token 的未来引用奖励,使已完成的依赖退出保护,后续需要的信息继续参与保留决策。
这一过程要求 Agent 能提供可定位的未来任务依赖,推理服务也必须支持 Blueprint 解析和持久缓存管理。不过,规划感知保留只能决定哪些 Token 留在缓存中,早期 Key 与当前查询之间的 RoPE 位置距离仍可能随着会话增长而扩大。
有界位置与 Key 重旋转控制 RoPE 距离
使用 RoPE 的模型,会根据 Token 的位置对 Query 和 Key 进行旋转,注意力计算结果受到二者相对位置差的影响。推理引擎通常缓存已经完成旋转的 Key,即使部分 Token 被淘汰,保留下来的 Key 仍携带原来的位置信息。例如,某个数据结构定义位于第 1,000 个 Token,当前查询已推进到第 100,000 个 Token,即使中间绝大多数 Token 被淘汰,二者的 RoPE 位置距离仍接近 99,000。缓存规模缩小,并不会自动缩短位置距离,PACE 因此引入了有界位置机制。
重新编号如何缩短 RoPE 距离?
PACE 区分两种位置:
-
逻辑位置记录 Token 在完整会话历史中的原始位置;
-
物理位置是模型实际用于 RoPE 计算的位置编号,并非 GPU 内存地址。
系统为驻留 Token 记录物理位置,同时维护逻辑位置与物理位置之间的偏移量。
重新编号并非每次缓存淘汰后都执行。PACE 在每次淘汰检查后判断,后续 Token 的物理位置是否即将接近设定上限 L。达到触发条件时,系统才按照原有顺序,将各层驻留 Token 重新编号到从零开始的连续位置,消除已淘汰 Token 留下的位置空隙,并更新位置偏移量,让新 Token 从重新排列后的末尾继续编号。
不过,修改位置编号还需要同步更新缓存中的 Key。因为 Key 已经按照旧位置完成 RoPE 旋转,如果原位置为 p,新位置为 p′,根据 RoPE 旋转的组合性质,只需对已旋转的 Key 再施加位置差 p′−p 对应的旋转,就能在数学上得到直接使用新位置编码时的结果。PACE 使用推理引擎已有的正弦、余弦表完成这一操作,并遵循模型的 RoPE 频率缩放方式,无需重新执行历史 Token 的模型前向计算。两次重新编号之间,系统仍按正常的位置关系计算注意力。
重新编号还需要为后续 Token 预留位置空间,因此位置上限 L 必须大于缓存整理前可能达到的最大驻留条目数与预填充块大小之和。论文采用 2,048 Token 缓存预算、4,096 Token 预填充块,在这一配置下,8,192 是满足约束的最小二次幂上限。
作者还测试了约 40K 的位置上限。虽然它同样能够限制位置增长,但重新编号后,早期定义与当前 Query 仍可能相距约 24K 个位置,代码检查效果不如 L=8K。采用 L=8K 后,即使历史定义来自数十万乃至上百万 Token 之前,实际 RoPE 位置距离也能保持在约 2K~7K。因此,L 需要结合缓存预算、淘汰检查间隔、预填充块大小及模型表现确定,8K 并非通用参数。
反复重旋转如何避免数值误差?
Key 重旋转在数学上可以精确变换位置,但实际计算会受到浮点数精度影响。如果每次重新编号都直接在 bf16 缓存 Key 上继续旋转,长期驻留的 Key 会不断积累舍入误差。在模拟百万 Token 会话重旋转压力的测试中,这种做法使代码检查通过率从 100% 降至 84%。
PACE 为此引入参考 Key 存储。某个 Key 需要重旋转时,系统保存其参考副本和对应位置;此后每次位置变化,都从参考 Key 出发,使用 fp32 重新计算旋转结果,避免在已经舍入的结果上累积误差。相同压力测试下,通过率恢复到 100%,代价是额外的参考 Key 存储,在 Qwen3-8B 的实验配置中最多约占 0.3GB。
有界位置还有一项设计取舍:重新编号保留了历史 Token 的先后顺序,却压缩了它们之间的原始位置距离。这有利于论文测试中远距离历史信息的使用,但对于依赖事件间隔的任务,位置变化可能影响模型判断。
消融与距离实验验证两项机制的作用
为了验证两项机制的效果,作者在 Qwen3-8B 上进行了预先登记的消融实验,使用十组新的随机合成会话,每组约 100K Token,包含三个代码检查步骤,KV Cache 预算统一为 2,048 Token。各组采用相同的推理引擎、持久会话机制和贪心解码配置,但位置编码有所区别:未启用有界位置的策略使用 YaRN ×4 扩展位置范围,启用有界位置的策略则采用 L=8K。
实验分别关闭规划感知保留和有界位置,对比两项机制单独使用及组合后的表现:
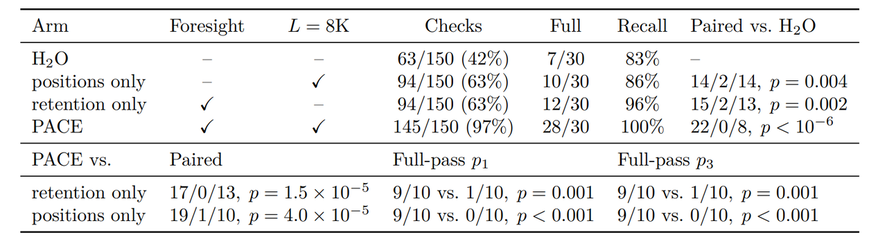
图 3:规划感知保留与有界位置的消融实验结果。
完整 PACE 通过了 145/150 个隐藏单元测试检查项,30 个代码检查步骤中有 28 个完整通过,显著优于单独使用任一机制的结果(p<10⁻⁴)。失败样本进一步揭示了两项机制的不同作用:仅使用有界位置时,H₂O 仍可能淘汰未来需要的收费精度、舍入模式等信息;仅使用规划感知保留时,所需 Token 全部驻留,事实召回率达到 96%,代码检查通过率却只有 63%。在该配置下,18 个未完整通过的检查步骤中,有 8 个已经包含全部所需事实,却仍然错误地使用了这些事实。
这些结果表明,规划感知保留能够减少所需信息被淘汰的情况,而有界位置能够改善模型对远距离保留信息的使用效果。两项机制配合后,取得了明显更好的代码检查结果。
为进一步检验位置距离的影响,作者将会话总长度固定为 100K Token,只改变早期定义与后续检查之间的逻辑间隔。仅使用规划感知保留时,代码检查通过率随间隔增大而下降;完整 PACE 则将实际 RoPE 位置距离控制在约 2K~7K,各组通过率保持在 97%~100%。
作者进一步汇总三种 PACE 相关配置下的 225 个代码检查步骤,按照模型实际看到的 RoPE 位置距离分组。在所需 Token 驻留率均约为 99.5%~99.6% 的情况下:
-
距离低于 8K:通过率为 96%~100%。
-
距离在 8K~16K:通过率为 87%。
-
距离超过 16K:通过率降至 69%~77%。
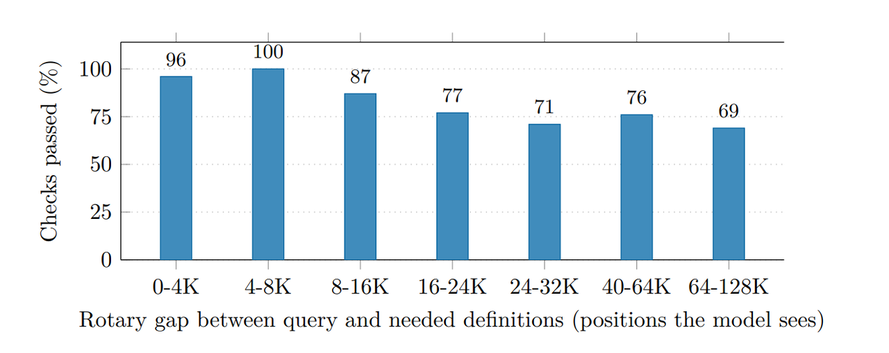
图 4:RoPE 位置距离与代码检查通过率的关系。
统计显示,即使所需 Token 基本保留在缓存中,代码检查通过率仍与 RoPE 位置距离存在明显关联。不过,最大的 RoPE 距离只出现在逻辑间隔最长的实验中,分组统计本身无法完全排除会话位置等因素的影响。固定总会话长度的距离扫描提供了更直接的对照:随着逻辑间隔增加,规划感知保留的效果下降,而控制 RoPE 距离的 PACE 仍保持较高通过率。
这些实验支持两项机制在当前条件下均具有重要作用,但作者并未证明推荐的 L=8K 配置具有统计显著的超加性效果。
百万 Token 会话中的缓存效果与工程代价
当会话历史增长到百万 Token,PACE 能否继续保持缓存管理效果?作者使用一张 NVIDIA L4 24GB GPU,将合成编码会话扩展到 300K、1M 和 2M Token,仍采用 Qwen3-8B 和 2,048 Token 的缓存预算。
在 300K Token 会话中,早期定义与后续检查相隔约 270K Token,PACE 通过全部 45 个隐藏检查项。到了 1M Token,定义与使用相隔约 89.4 万 Token,PACE 通过 74/75 个隐藏检查项,15 个代码检查步骤中有 14 个完整通过,125 项历史事实全部召回。2M Token 时,逻辑间隔增加到约 180 万 Token,PACE 通过全部 75 个检查项,15 个步骤全部通过,事实召回率仍为 100%。
作为对照,仅使用有界位置、没有规划感知保留的策略,在 1M 和 2M Token 时的检查通过率分别降至 33% 和 13%。
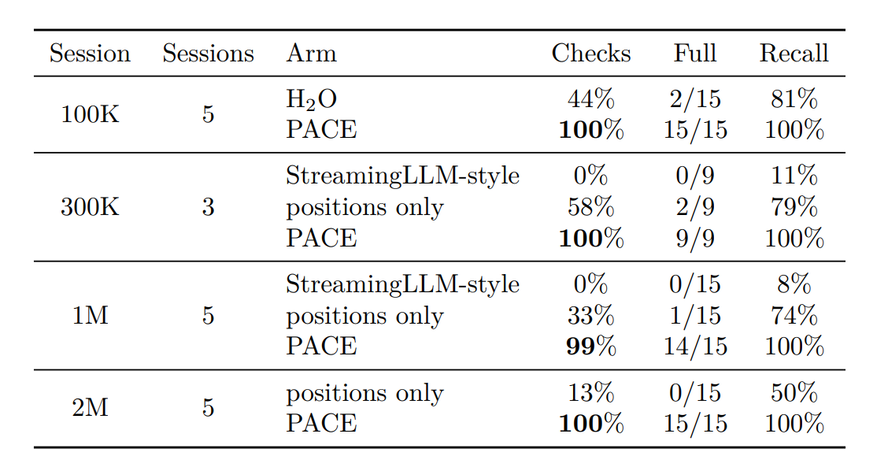
图 5:不同会话长度下 PACE 与对照策略的代码检查和事实召回结果。
在 2M Token 实验中,两种策略的平均 RoPE 位置距离均约为 6K,结果差异主要来自缓存保留能力:没有未来依赖保护的策略丢失了更多早期定义。
不过,百万 Token 指累计会话历史,模型每一步主要使用的仍是约 2K 个驻留 Token 的缓存工作集,并未对全部百万 Token 执行完整注意力计算。
在 Qwen3-8B 的配置下,2,048 Token 的常驻 KV Cache 约占 0.3GB,参考 Key 最多再占 0.3GB。如果完整保留历史 KV,1M 和 2M Token 分别需要约 147GB 和 295GB。
缓存管理也有运行成本。在十组 100K Token 会话中,PACE 相比 H₂O 增加了约 9% 的总运行时间。而持久会话可以减少重复预填充:在单独的 16K Token 测试中,相比每轮重新提交完整历史,预填充 Token 数量减少了 5.5 倍,总运行时间缩短了 4.3 倍。
虽然 KV Cache 工作集保持固定,完整会话的执行时间仍会增长。1M Token 会话耗时约 13.6 分钟,2M Token 增至约 31 分钟。后者的单轮填充任务耗时也从最初约 0.9 秒,增长到结束时的 1.7~3.2 秒。
如果规划器遗漏了未来依赖,或者需要保护的内容超过缓存预算,后续任务需要的 KV 条目仍可能被淘汰。PACE 因此提供了分层恢复机制:缓存整理时,将淘汰的 KV 条目卸载到主机内存,在存储压力下转移到本地存储,并异步复制到远程缓存。当后续规划发现这些信息重新成为必要依赖,系统可以从相应存储层恢复 KV 条目,将其重新接入缓存,并调整位置以保持顺序和位置边界。
在一组受控实验中,规划器直到需要使用某项定义时才将其标记为必要内容。没有恢复机制时,模型只召回 5 项事实中的 1 项;启用后,5 项全部召回。从主机内存恢复一次 KV 条目约需 2.3ms,远程缓存恢复约需 2.7 秒。
这项实验验证了恢复机制的作用,但样本规模较小,而且恢复依赖规划器识别所需信息。如果始终没有相应的依赖标记,系统不会自动恢复。此外,300K、1M 和 2M Token 的长会话实验排除了与待测任务主题相近的填充代码,以减少相似代码对模型生成结果的干扰;真实 Agent 会话中未必能够进行这种筛选。
实际应用还需要满足哪些条件?
PACE 的效果首先取决于规划器能否准确提供未来任务依赖。主要实验使用已知真实依赖关系的规划器,作者也尝试让 Qwen3-8B 生成依赖图,依赖边精确率达到 1.0,召回率为 0.9。在这项采用 L=40K 位置配置的实验中,PACE 的隐藏检查项通过率达到 92%,H₂O 为 41%。
固定的未来引用奖励也存在长度约束。PACE 设置了 50,000 的奖励下限,而普通 Token 的累计注意力得分会随会话增长。在 2M Token 实验中,未受保护 Token 的最高得分已达到约 25.1K。作者估算,到约 5M Token 时,部分普通 Token 的得分可能超过这一奖励下限,影响未来所需内容的保留优先级。
此外,缓存管理无法消除模型自身的代码生成错误。在 Mistral-7B-Instruct-v0.3 的较短会话无淘汰对照中,模型的代码检查通过率仅约为 40%,说明其代码生成能力本身构成了明显限制。PACE 在长会话中的表现接近这一水平。具体到 90K 间隔,PACE 与仅使用规划感知保留的 p₁+p₂ 检查通过率分别为 46% 和 36%,差异未达到统计显著(p=0.75)。需要注意,无淘汰对照来自不同的较短会话,因此这一能力上限比较属于描述性判断。
目前,PACE 的实验主要覆盖合成 Python 编码任务、两种 7B~8B 模型及单张 GPU。更大模型、真实软件工程任务和多会话并发吞吐仍未验证;100K Token 实验也没有同长度的完整 KV Cache 无淘汰对照,相关控制实验使用的是较短的 8K Token 会话。
从工程应用看,PACE 更适合具有明确步骤依赖、能够提前定位未来所需历史信息的 Agent 工作流,例如分阶段代码开发、数据处理和工具调用。如果任务需要随时访问漫长历史中的任意细节,或者执行计划频繁变化、未来依赖难以判断,仅靠规划感知保留就无法保证信息始终驻留,仍需要完整上下文服务或其他检索恢复机制。
PACE 的工程价值在于将 Agent 的任务规划信息用于推理层的缓存决策,同时控制保留信息与当前查询之间的位置距离。在有限缓存预算下,这为长程任务提供了一种可行的历史信息管理思路。实际应用时,还需要综合考虑规划准确性、缓存恢复能力及推理服务的运行成本。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70050060/viewspace-3189425/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- Agent 小知识|黑板架构:多个 Agent 如何协作解决复杂问题?
- 周一上线 | DSH 喜提原神进场动画,Anthropic 启动 IPO 路演
- Anthropic:Agent 不必一直运行,也能持续工作
- Agent 小知识|Agent 之间如何传递上下文?
- Coding Agent 并行写代码,源码控制系统怎么扩?
- 让 Go 走得更远:用 LLGo 打通 Go 与 C/C++/Python 生态
- 多 Agent 如何协作完成复杂任务?从 GCA 看任务编排与执行控制
- 周一上线 | ChatGPT Images 2.6 支持制作 GIF;Marvell 超千亿美元拟收购 Lumentum
- 代码库看不懂?给 Agent 装个能生成可交互架构图的 Skill
- Agent 支线知识:Personal Agent 如何跨应用完成任务?
