Agent 在做一项长任务时很少只用一个或几个 Skill,比如科研任务中,文献检索、数据库查询、专业软件分析、统计检验、可视化和研究报告,往往对应一组不同能力。Skill 只有几个时,直接告诉 Agent 该用哪个并不复杂;可当 Skill 库扩展到上百个,Agent 怎么知道当前任务需要哪些 Skill?这些 Skill 背后的操作说明和参考资料,又该怎样进入有限的上下文?
K-Dense 团队在论文
「Scientific Agent Skills: A Library of Procedural Knowledge for Research Agents」中分析了 Scientific Agent Skills。论文以 v2.65.0 为分析基准,共收录
163 个科研 Skill;而在作者整理的 46 个文档化科研工作流中,一个工作流中位会组合 10 个 Skill,最少 5 个,最多 16 个。
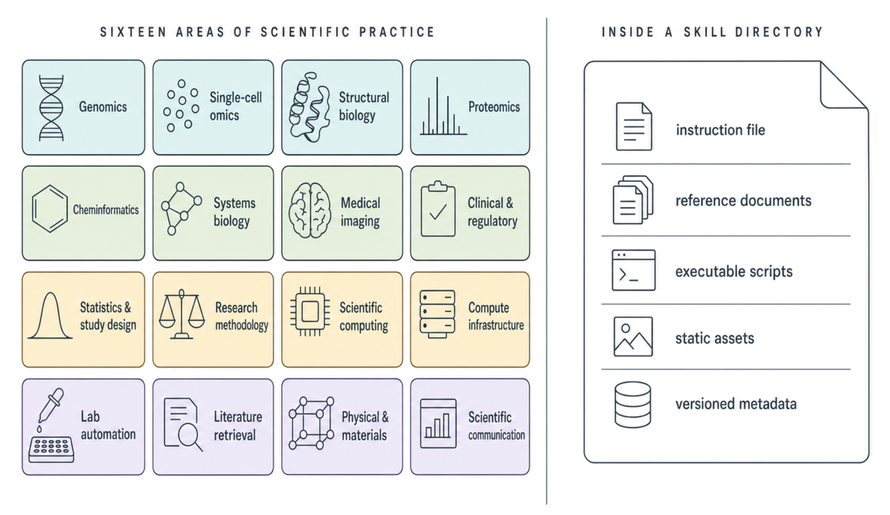
图 1:Scientific Agent Skills 覆盖的科研领域与 Skill 目录结构。
Scientific Agent Skills 是一套科研 Skill 库,但它暴露的问题并不只属于科研场景。当 Agent 同时拥有大量可选 Skill,而每个 Skill 又包含不同层级的操作说明和参考资料时,系统就需要决定:
哪些信息常驻上下文,哪些 Skill 在任务到来后再选择,哪些内容只有真正用到时才继续加载。 本文以 Scientific Agent Skills 为例,拆解多 Skill 场景下的这套分层加载机制。
Skill 记录可复用的科研程序
科研 Agent 常常遇到这个问题:代码能运行,并不代表分析方法成立。论文开头列了几个典型场景。三只小鼠各测量 100 个细胞,统计上的独立重复仍然只有 3 只小鼠;如果处理组和对照组分别在不同日期完成实验,批次因素可能已经和处理条件混在一起;处理 BED 格式的基因组区间时,如果误解了坐标计数方式,也可能让分析结果失效。比如把从 0 开始计数的起始坐标当成从 1 开始计数。多组比较如果没有进行多重检验校正,也可能得到看起来正常、实际并不成立的结果。
这些问题已经超出了“代码怎么写”。Agent 还需要知道应该选什么检验、什么才算独立重复、哪套标识体系是权威的、步骤按什么顺序执行,以及结果必须附带哪些限制条件。论文把这类知识概括为
程序性知识。它们分散在软件文档、报告规范、行业标准以及不同研究领域长期形成的实践中。
Scientific Agent Skills 用 Skill 来记录这些程序。一个 Skill 至少包含
SKILL.md,里面写明适用条件、执行步骤和需要检查的约束,也可以附带参考资料、脚本和静态资源。它提供的不是临时检索回来的一段知识,也不是一个必须调用的 API,更接近一份提前整理好的领域操作规程。论文中 analytical-method-validation 就是一个例子。它要求 Agent 在设计分析前先确定适用的治理框架,并在采集数据前明确验收标准。重点不在某个 API 怎么调用,而在
具体条件下应该按照什么程序完成这项工作。这类知识可以不断写进 Skill。但当 Skill 从几个增加到 163 个以后,新的问题随之出现:这些内容不可能全部长期留在上下文里。
163 个 Skill 通过分层加载控制上下文
在 v2.65.0 中,163 个完整
SKILL.md 共 482,506 Tokens,背后的 1,033 份参考文档又包含 2,480,674 Tokens,整个文档语料达到 2,963,180 Tokens。Scientific Agent Skills 因此采用渐进式披露,把不同粒度的信息分层加载。
图 2:Scientific Agent Skills 的三层加载路径
第一层是始终常驻的名称和描述。163 个 Skill 合计需要 14,246 Tokens,单个 Skill 的常驻信息长度中位数为 67 Tokens,约占论文采用的 20 万 Token 参考窗口的 7.1%。
第二层是完整的
SKILL.md。只有当 Agent 判断某个 Skill 与当前任务相关时,才读取对应操作说明,其中文件长度中位数为 2,857 Tokens。
第三层是参考资料。当操作说明指向具体 Reference,而且任务确实需要时,Agent 才继续读取。通过这种分层,整套文档中 83.7% 的内容默认保持未读取状态。
这里的 20 万 Token 只是论文统一采用的比较尺度,并不对应某个特定模型。图 2 展示的也是语料库测量下的一条假设加载路径,不是一次真实 Agent 的执行轨迹。作者用一句话概括了这套机制:
分层只是延后了成本,并没有让成本消失。
分层加载降低了常驻上下文成本,也把选择压力推到了短描述上:
完整操作说明还没有加载时,Agent 仅凭几十个 Token 的描述,怎么从上百个候选中找到当前需要的 Skill?
短描述开始承担 Skill 路由
这正是短描述需要承担的另一项任务。它不再只是告诉 Agent“这个 Skill 能做什么”,还要尽可能划清相邻能力之间的边界。例如 datamol 和 rdkit 都属于化学信息学工具,研究设计、量子计算和绘图领域也存在功能彼此接近的 Skill。作者因此对 163 个 Skill 的描述进行词汇建模,计算了全部 13,203 对 Skill 的余弦相似度。

图 3:163 个 Skill 描述的词汇可区分性。
一个 Skill 与最近邻描述的余弦相似度中位数为 0.15,90 分位为 0.26。整个 Skill 库中最接近的一对是 datamol 和 rdkit,相似度达到 0.40。这些高相似 Skill 往往本身就在处理相邻问题,因此词汇重合并不等于描述写错了。
对于部分相邻能力,作者会直接在描述中提示什么时候应该改用另一个 Skill。词汇最接近的 20 对 Skill 中,有 17 对至少存在一个这样的路由提示。人工提示仍然会有遗漏。例如 infographics 和 scientific-schematics 的相似度达到 0.36,是最接近的无提示 Skill 对。作者因此提出,这类相似度测量可以随版本持续运行,用来发现新的描述碰撞。
不过,上图测的是词汇可区分性,不是 Agent 的真实 Skill 选择准确率。两个描述使用相似词汇,不代表模型一定会混淆;用词差异较大,也不意味着它们不会竞争同一个任务。论文把余弦相似度定义为一个代理指标,并没有测任何宿主的实际 Skill 选择率。
所以这组实验能够回答的是:哪些 Skill 在常驻描述层可能存在选择压力。它还不能回答:Agent 到底能不能稳定选对 Skill。
多 Skill 工作流仍需继续筛选参考资料
但科研任务通常还不止需要一个 Skill。论文中的 46 个文档化工作流共包含
472 个 Skill 使用位置,覆盖 162 / 163 个 Skill;一个工作流中位会用到 10 个 Skill,最少 5 个,最多 16 个。这些都是作者自己整理的文档化示例,不是观察到的真实 Agent 会话。论文把它们作为会话模型,用来估算一组 Skill 同时参与任务时需要多少上下文。
先只看操作说明。在保留所有常驻描述的基础上,再加载一个工作流涉及的完整
SKILL.md,中位成本为 47,706 Tokens,约占 20 万 Token 参考窗口的 23.9%;最大的工作流为 62,476 Tokens。46 个文档化工作流在这一口径下都没有超过参考窗口。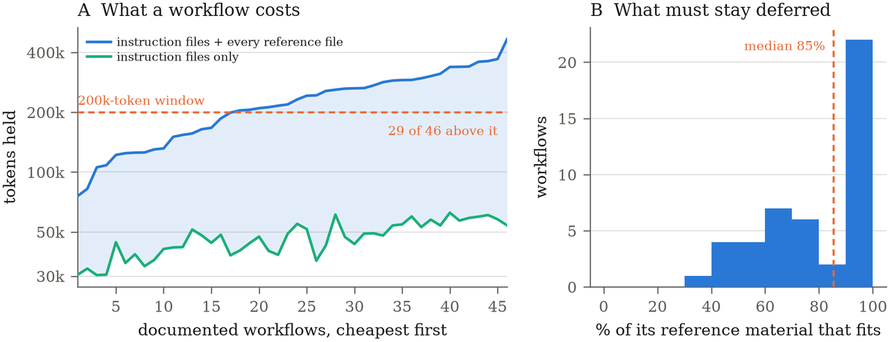
图 4:46 个文档化工作流的上下文成本。
加入参考资料后,上下文成本会明显增加。如果进一步把每个被选 Skill 的全部参考文件都加载,中位成本会增加到 225,498 Tokens,达到参考窗口的 112.7%;最大的工作流达到 466,131 Tokens。此时,46 个文档化工作流中有 29 个会超过这一参考窗口。
这不是说真实 Agent 已经发生了 29 次上下文溢出。作者刻意把每个相关 Skill 的全部 Reference 都加载进去,这条曲线本来就是人为构造的成本上界。它反映的是另一个问题:
激活 Skill 以后,参考资料仍然需要继续按需加载。
在常驻描述和相关
SKILL.md 已经进入上下文后,按工作流统计,剩余空间可容纳其自身参考资料的比例中位数为 85%;最吃紧的工作流只有 35%。46 个示例中,17 个可以容纳全部 Reference,其余都需要继续筛选,其中 5 个连一半都装不下。而且这些数字只统计文档文本,不包括脚本、静态资源、工具输出以及宿主额外增加的包装信息。因此,它们也不能直接当成一次真实会话的完整上下文成本。分层加载实际上贯穿了整个 Skill 使用过程:项目先限制安装范围,任务到来后再选择相关 Skill,激活后读取完整操作说明,需要时继续筛选参考资料。论文也因此建议,只安装项目真正需要的 Skill。每增加一个 Skill,都会增加一份常驻描述,也增加一个需要区分的候选项。但更小的安装集合能不能提高实际选择准确率,论文没有做实验验证。
上下文之外还有运行和验证边界
Skill 数量增加以后,管理问题并不只发生在上下文里。Scientific Agent Skills 中有 105 个 Skill 带有
scripts/ 下的代码,这些 Skill 也继承了科学计算软件本身的依赖和运行环境问题。
一个比较直接的例子是,105 个带脚本的 Skill 中有
40 个都包含自己的
scripts/_common.py。如果把多个这样的 Skill 放进同一个 Python 解释器,
_common 可能解析到先加载的模块,导致测试实际调用了错误文件。仓库的测试 Runner 因此会为每个 Skill 创建独立的临时环境,并启动单独进程。这里描述的是
仓库的测试方案。论文没有进一步验证生产环境中的科研 Agent 是否也需要采用相同粒度的进程隔离。但这个案例说明,当 Skill 开始携带真实的科学软件和辅助代码时,需要管理的已经不只有 Prompt 和上下文,解释器、依赖和模块命名空间同样可能相互影响。
验证覆盖也存在类似边界。仓库面向全部 163 个 Skill 运行基础规范和 Frontmatter 检查;另一组包含 10 项规则的深层结构检查,在论文锁定的版本中只覆盖带脚本的
105 个 Skill,其余
58 个纯文档 Skill不在这套检查范围内。
作者为了论文重新把相同的结构检查跑遍整个固定版本后,发现了
2 条失效的本地相对路径,恰好都位于这 58 个纯文档 Skill 中。这组结果更适合说明检查范围的边界,而不是评价这个仓库“是否可靠”。
自动化检查可以验证目录结构、路径、Python 解析以及部分工程行为,却无法判断一份科研程序在专业领域里是否正确。论文也明确指出,这些自动化门禁不会判断文档中的科研程序是否在科学上成立。
仓库级验证和科研有效性验证是两件事。前者可以通过更多规则和测试持续完善,后者仍然需要针对具体领域、任务和结果进行验证。
选对、执行对和科研结果对是三件事
到这里很容易继续推一步:既然程序性知识已经被写成 Skill,又有分层加载、路由提示和自动化检查,科研 Agent 的结果是不是已经更可靠了?
这一步其实超出了论文证据。作者没有进行任务级效果评测,也没有报告任何宿主的实际 Skill 选择率。论文测量的是这套 Skill 库的文档结构和部分工程属性,并没有证明安装这些 Skill 后,Agent 的科研能力提高了多少。
要判断这些 Skill 是否真的让科研 Agent 更可靠,至少有三道关需要分开看:
第一,Agent 有没有选对 Skill? 图 3 测的是描述文本的词汇可区分性,不是真实选择准确率。论文没有报告任何宿主的 Skill 选择率。
第二,选中以后有没有执行对? Agent 仍然可能遗漏步骤、改变顺序、跳过停止条件,或者只读取了部分必要参考资料。论文没有测步骤级遵循情况。
第三,完整执行以后,科研结果是否正确? 这还取决于研究本身是否满足程序的适用条件。任务或数据可能缺少实验设计、抽样、测量、预处理、研究对象等关键信息,而 Skill 无法利用宿主没有提供的条件。与此同时,标准、软件、API、数据库结构和参考数据都会变化,固定一个版本只能记录当时有哪些指令,不能保证这些内容一直正确和最新。
所以这篇论文目前最重要的事实边界仍然是:
选对 Skill ≠ 执行对 Skill ≠ 科研结果正确。论文对此也给出了一条很明确的边界:
Skill 能够帮助组织科研判断,但最终仍需要专家审查。
Scientific Agent Skills 已经量化了 Skill 规模扩大后的一部分工程问题:如何控制常驻上下文、如何区分相邻能力、如何继续筛选参考资料,以及代码和运行环境带来的额外管理成本。但它没有证明科研 Agent 因此变得更准确。
回到开头的问题:
攒了上百个 Skill,Agent 知道怎么用吗?从 Scientific Agent Skills 这个案例里,可以抽出几条更通用的多 Skill 设计思路:
第一,发现信息和执行信息分开。 不必让完整 Skill 长期常驻,只保留足够完成能力发现和初步路由的信息。
第二,知识深度和上下文成本分层。 Skill 被选中后再加载操作说明,更大的参考资料继续按需读取,而不是一次全部展开。
第三,Skill 越多,路由越需要单独设计。 描述不再只是介绍文案,还要划清相邻能力之间的边界;安装范围本身也会影响候选规模。
第四,选中 Skill 只是执行链的开始。 Skill 选择、指令执行和最终任务结果是三个不同层级,不能因为 Skill 被成功加载,就默认任务已经可靠完成。
这些更适合作为多 Skill 系统的设计原则,并不是所有 Agent 都必须照搬的固定架构。具体怎么组织 Skill、怎么路由和加载,仍然取决于系统本身的 Skill 结构、上下文预算和运行方式。
参考资料
Scientific Agent Skills: A Library of Procedural Knowledge for Research Agents. arXiv:2609.00065;
K-Dense-AI/scientific-agent-skills,GitHub。
#科研Agent #Agent #skill #ScientificAgentSkills #上下文工程 #Agent架构 #AI科研 #开发者
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70050060/viewspace-3183927/ ,如需转载,请注明出处,否则将追究法律责任。

请登录后发表评论
登录
全部评论
最新文章
- 周 1 上线 | Deno 团队加入 Cloudflare,黄老板 “盯上” Reflection AI
- 从 Bun 到 Deno,AI 时代的开发工具正在经历什么?
- Coding Agent 长任务中的 Context 压缩时机
- 模型变强之后,Skill 和 Prompt 该做减法了
- Agent 小知识|MCP 里的 Tools、Resources、Prompts 有什么区别
- 从上下文到权限:如何把 Agent 接进真实业务流程
- 从自我改进到递归进化:RSI 的五级路线
- 当 Coding Agent 开始内卷,软件工程的标准会变吗?
- 谷歌利用果蝇实现“AI 突围”?Cognition 再融 20 亿美元;AI 三巨头集体呼吁放慢脚步
- 一个 Skill 让 AI 掌握论文图的视觉语法:以 DeepSeek V4.1 Flash 论文图为例
