一、文献过载与检索失真:科研效率的双重瓶颈
截至当前,全球学术出版物的年增长速度持续攀升,以主流索引平台统计,公开可检索的论文总量已突破数亿篇量级。在此背景下,科研人员普遍面临两类突出困境。
信息过载困境:面对动辄成百上千篇的检索结果,研究者需要投入大量时间进行人工初筛,方能定位真正具有参考价值的文献,调研效率因此被严重稀释。
语义理解困境:传统检索工具依赖关键词匹配机制,难以理解带有模糊概念、跨学科背景或复杂逻辑的科研提问。当研究者只凭片段记忆或抽象描述和关键词尝试找回某篇论文时,传统工具往往无法给出有效响应。
与此同时,随着生成式AI技术被引入学术检索场景,一个新的风险随之浮现—— AI幻觉,即模型在缺乏真实文献支撑的情况下生成看似合理却并不存在的引用或结论。这一问题在强调证据链条完整性的学术场景中尤为致命,直接影响科研结论的可信度。上述矛盾共同催生了对一种兼具语义理解能力与事实核验机制的检索工具的迫切需求。
二、产品定位与关键突破
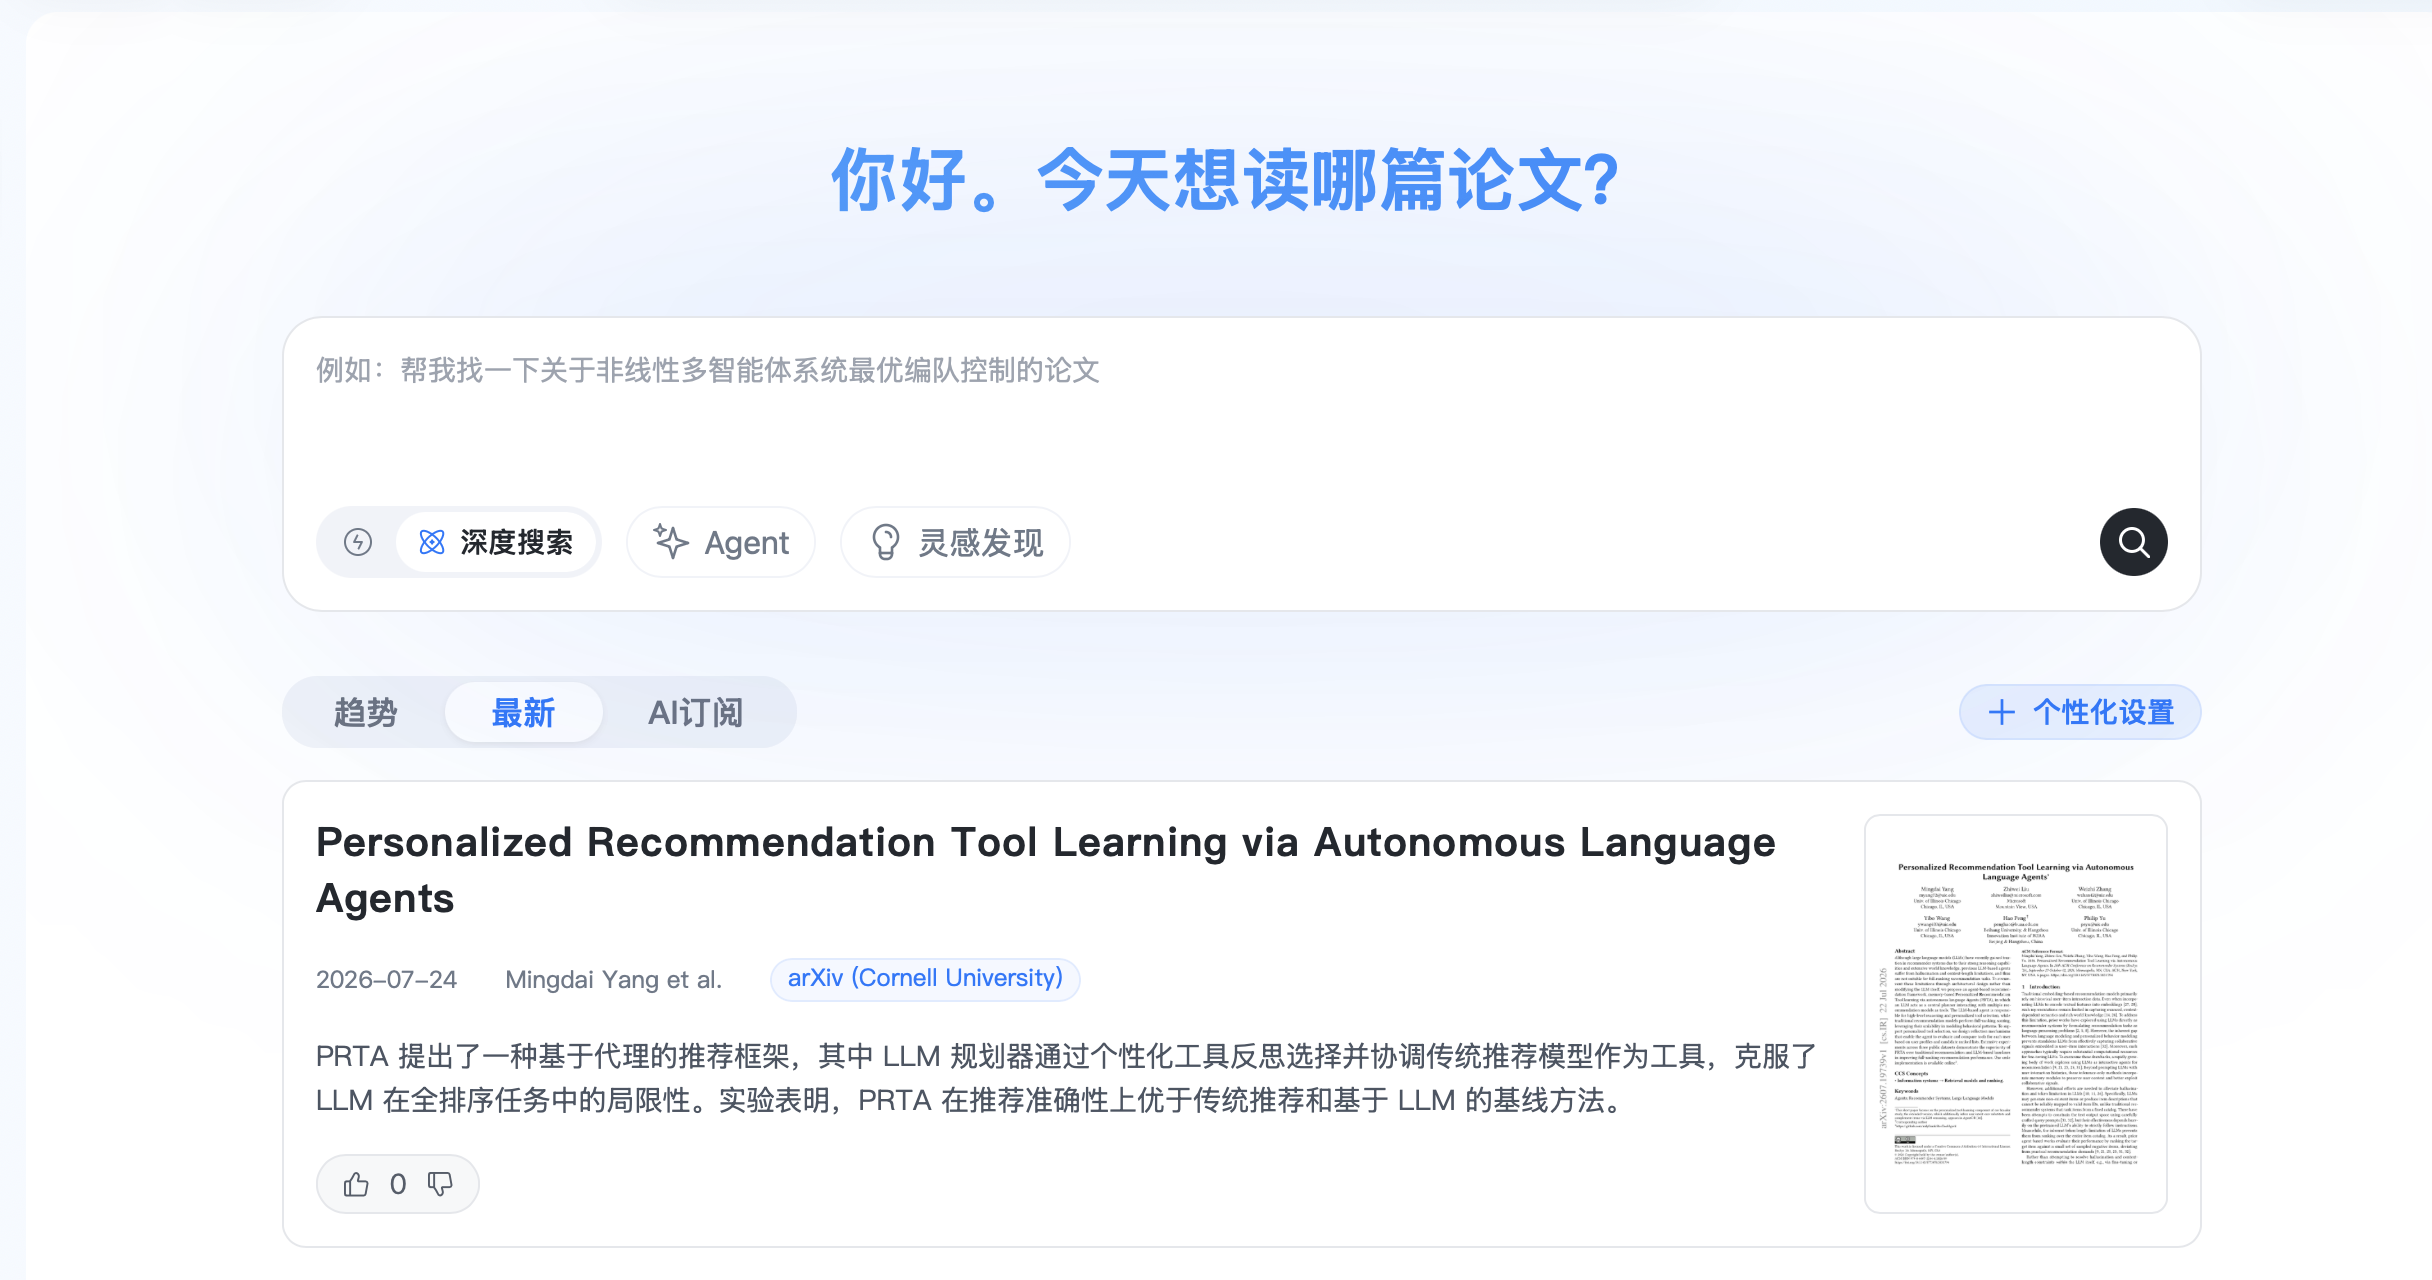
切问学术·深度搜索(Scholar Search)是一款支持自然语言提问的深度AI文献检索系统,定位为具备自主逻辑推理能力的科研助手体系中的入口模块。该产品依托规模达5亿篇论文的索引库,并集成1.2亿篇开放获取(OA)论文全文资源,构建起兼顾覆盖深度与检索准确性的技术底座。
其关键突破体现在两方面:一是将
幻觉率控制在趋于0的水平,确保每一条检索结果均可追溯至真实文献,从根本上区别于依赖生成式联想的传统AI Q&A形式;二是实现
检索准确率达到95%,使自然语言提问能够被稳定转化为高相关度的文献匹配结果。
三、系统架构解析
1. 自然语言意图解析模块
该模块负责将研究者输入的自然语言问题转化为结构化检索逻辑,替代传统的关键词拼接方式。
- 支持模糊概念、片段化描述的语义还原
- 具备科研意图深度解析能力,减少检索词构造成本
- 兼容跨学科表达方式,降低专业术语依赖
2. 全文检索引擎
基于5亿篇论文数据库构建的深度匹配引擎,是检索覆盖度与结果相关性的关键支撑。
- 覆盖1.2亿篇OA论文全文,支持全文级别的深度匹配
- 支持跨学科文献的关联检索,快速定位陌生领域的奠基性论文
- 具备大规模并行处理能力,支撑高并发检索请求
3. 证据溯源与引用校验模块
该模块是控制幻觉率的关键机制,确保输出结果始终锚定于真实文献来源。
- 每条检索结果均附带可验证的文献出处
- 通过多源交叉核验降低虚构引用出现的概率
- 支持结果回溯至原文段落,便于研究者二次核实
4. 极速筛选与过滤模块
面向文献过载场景设计的效率优化组件,负责在海量结果中完成快速浓缩。
- 支持在5分钟内对1000篇文献完成自动化过滤
- 输出浓缩至20篇左右的重点论文集合
- 结合检索历史进行动态排序优化,提升筛选结果贴合度
四、性能实证
在内部测试场景中,切问学术·学术搜索针对典型科研调研任务进行了量化评估,主要指标如下:
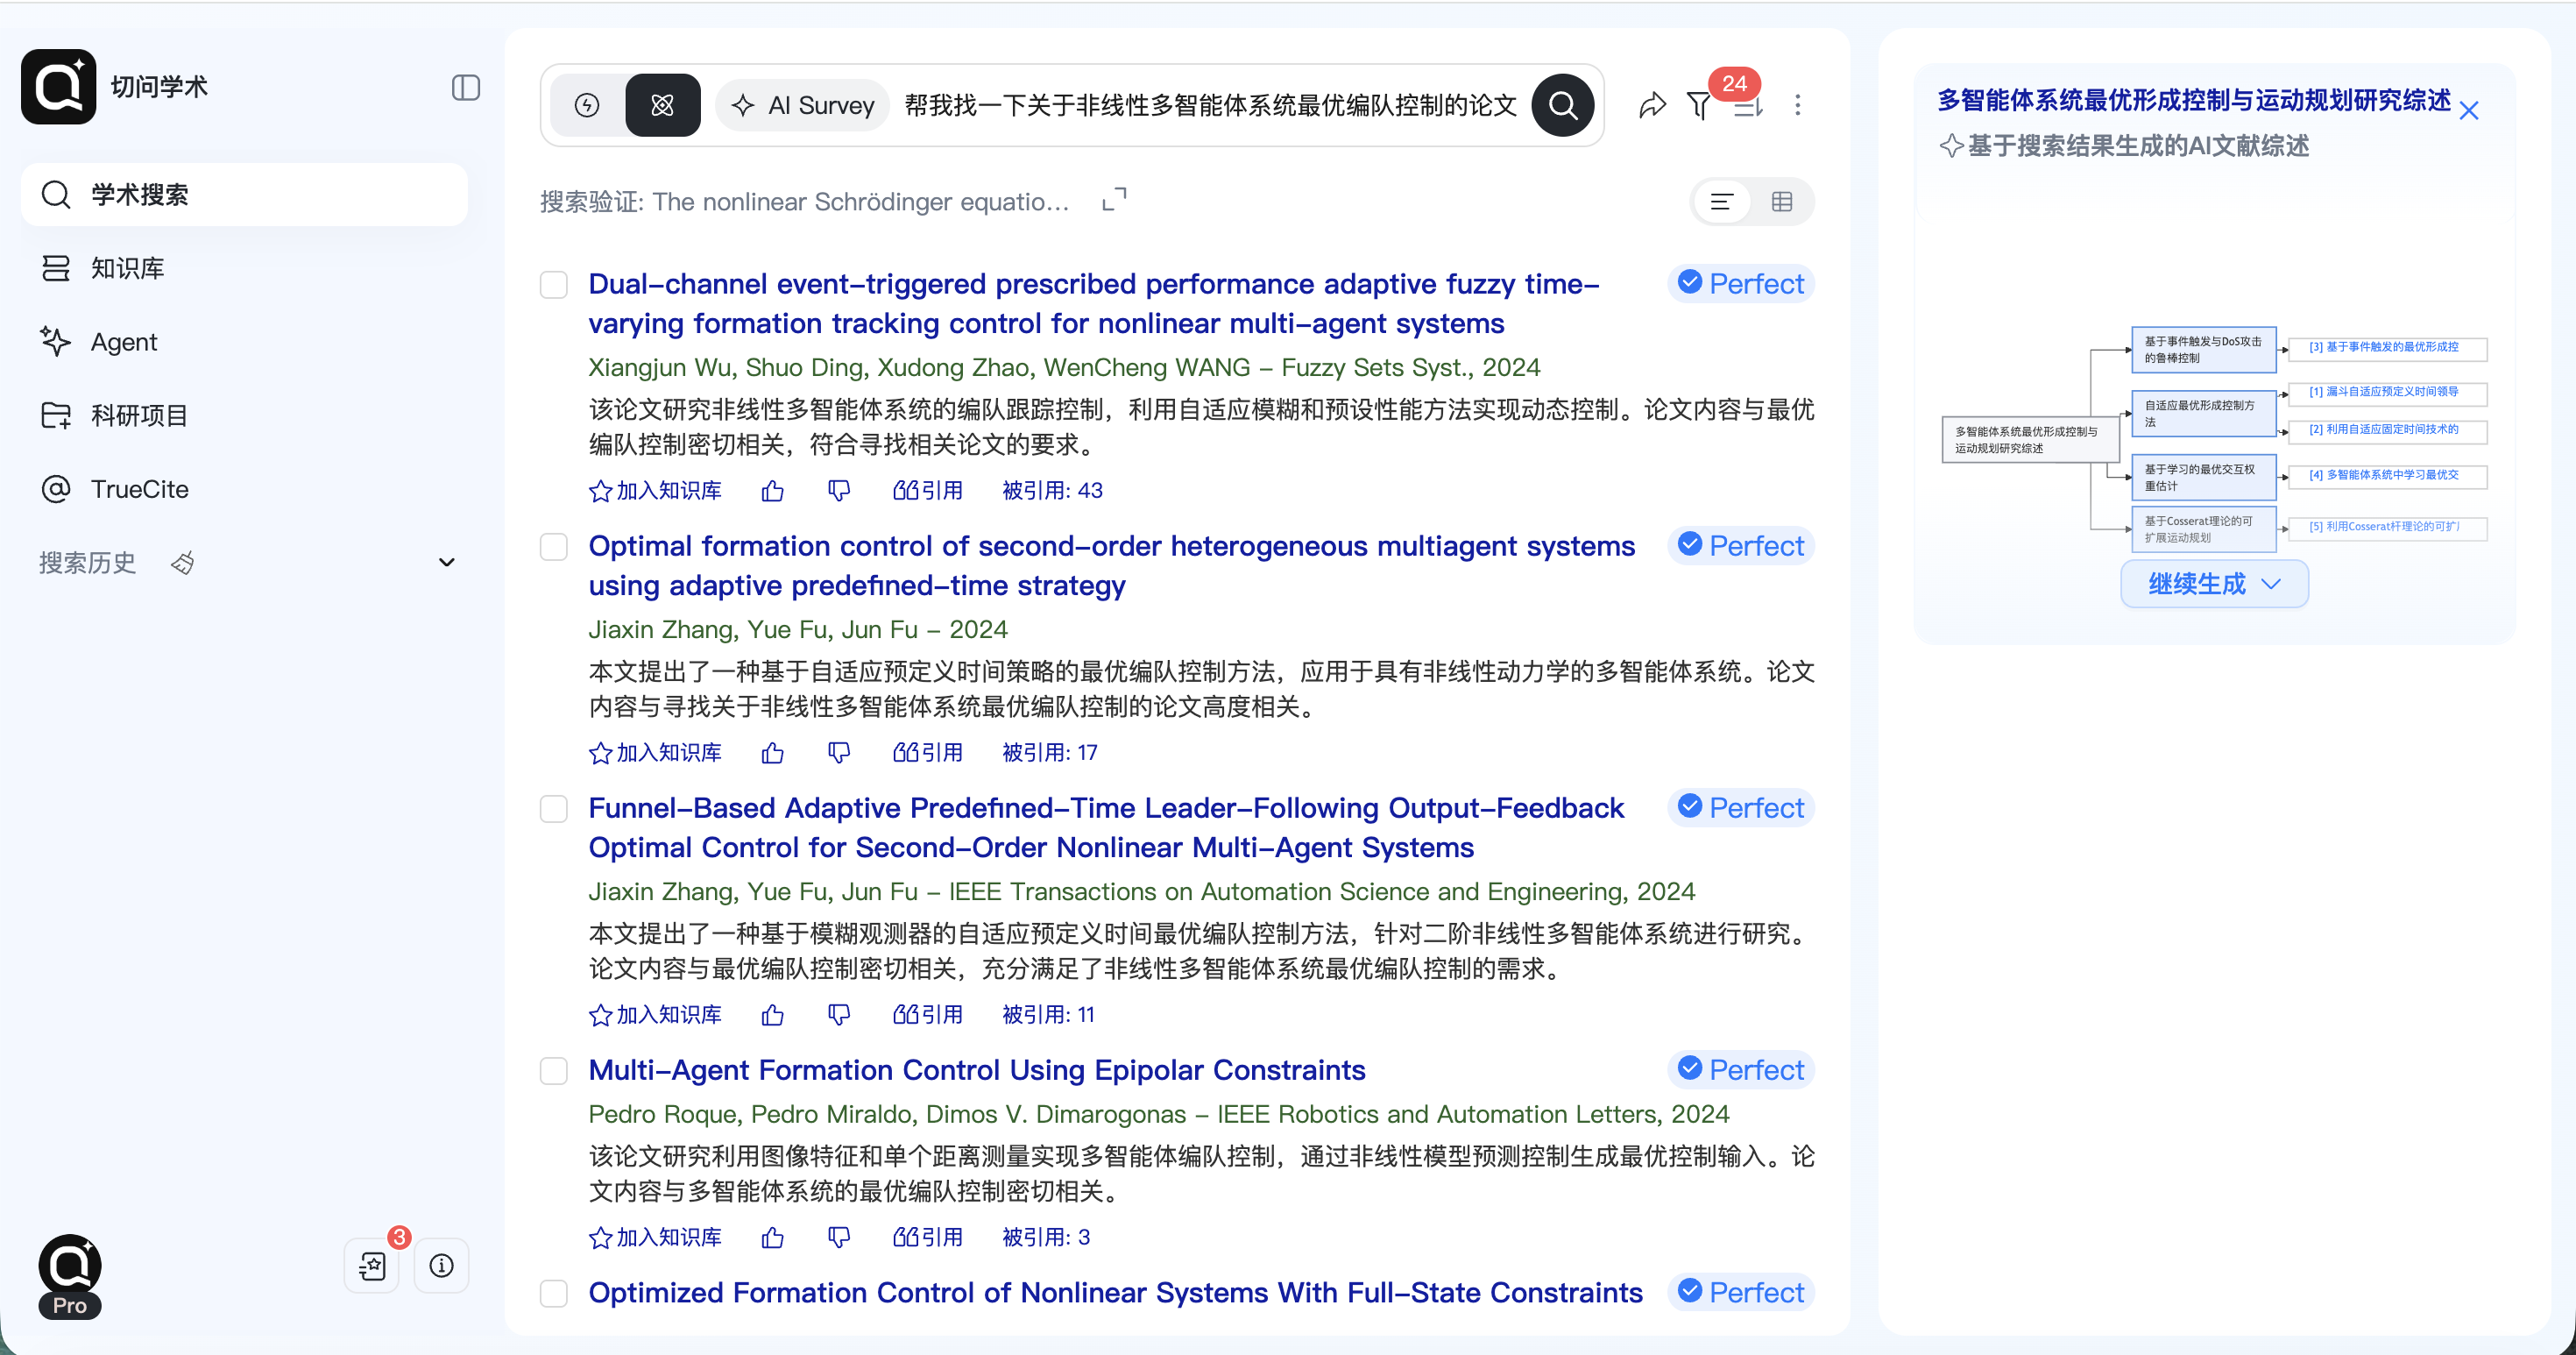
- 检索准确率:95%,即在给定自然语言提问的情况下,系统返回结果与研究者实际意图相符的比例达到该水平。
- 幻觉率:趋于0,表明系统在文献引用环节基本未出现脱离真实数据源的虚构内容。
- 筛选效率:在5分钟时间窗口内完成1000篇候选文献的自动化过滤,浓缩比例约为2%,明显压缩了人工初筛所需的时间成本
与依赖关键词匹配的传统检索方式相比,该系统在语义理解层面的处理方式使得模糊概念检索、跨学科文献定位等任务的成功率得到明显提升,具体效果因检索场景差异而有所不同,尚未形成统一的第三方对比基准,相关数据以企业内部测试结果为准。
五、多维度优势分析
| 对比维度 | 传统关键词检索工具 | 切问学术·学术搜索 |
|---|---|---|
| 检索方式 | 依赖精确关键词匹配 | 支持自然语言意图解析 |
| 结果可信度 | 无幻觉校验机制 | 幻觉率趋于0,附证据溯源 |
| 覆盖范围 | 通常局限于单一数据库 | 5亿篇索引库+1.2亿篇OA全文 |
| 跨学科适配 | 需研究者自行构造术语 | 支持模糊概念自动关联 |
| 筛选效率 | 人工逐篇甄别 | 5分钟内完成千篇级过滤 |
从上述对比可见,该产品在检索方式、结果可信度与筛选效率三个维度形成了较为明确的差异化路径,尤其在证据溯源机制的设计上,直接回应了学术场景对内容真实性的高要求。
六、应用价值与发展展望
在实际应用中,该系统适用于多类典型科研场景:课题开题阶段的文献初步调研、跨学科探索中的奠基性论文定位,以及基于模糊记忆片段找回特定文献等长尾需求。通过将人工初筛环节大幅前置压缩,研究者能够将更多时间投入到文献深度阅读与研究设计本身。
从发展路径看,学术搜索模块并非孤立存在,而是与AI综述、AI订阅源与趋势、知识库、智能对话引擎、科研智能体及AI辅助阅读等模块共同构成一套端到端的科研工作流闭环。未来,随着检索能力与综述生成、智能体自动化流程的进一步协同,该体系有望在选题、调研、写作、复现等科研全链路环节中持续释放效率价值。
七、客观局限性说明
需要客观指出的是,当前系统的检索能力仍受限于索引库自身的收录范围,对于未被纳入数据库的小众出版物、非公开预印本或特定小语种文献,检索覆盖存在一定盲区。此外,尽管幻觉率已控制在较低水平,但对于表述极度模糊、缺乏明确学科背景的提问,系统仍可能需要多轮交互才能收敛至理想结果,用户体验的稳定性有待在更多长尾场景中持续验证。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70049815/viewspace-3179228/ ,如需转载,请注明出处,否则将追究法律责任。

