学习笔记:什么是大模型微调
大模型微调(Fine-tuning)是一种在预训练模型(Pre-trained Language Models, PLMs)完成训练后,为了适应特定任务或用户需求而对其进行优化和调整的技术和方法。
本质上,微调是将一个已经具备通用知识和能力的模型,通过特定数据进行“再教育”,使其在某个垂直领域或特定任务上表现得更专业、更精准。
- 为什么要微调?
预训练大模型虽然知识渊博,但在特定应用场景下往往存在不足。微调的主要目的就是解决这些“不到位”的问题,可以归结为两大类:补数据和纠能力。
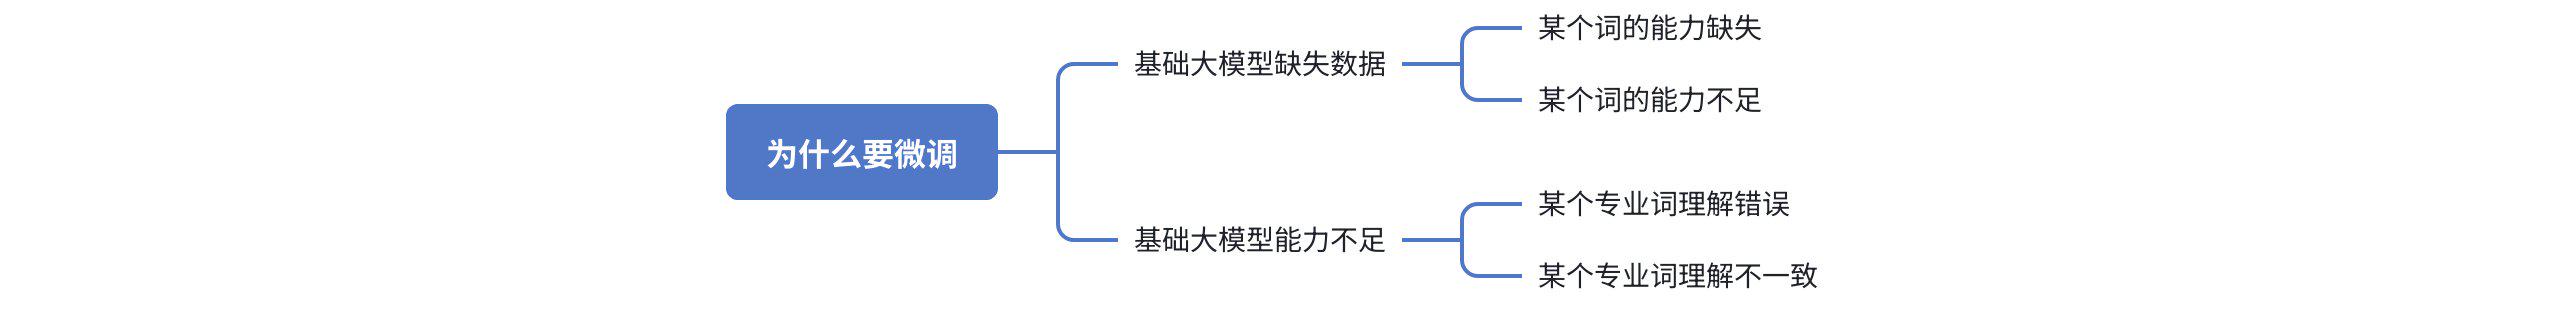
• 补数据(解决“不知道”的问题):
◦ 知识缺失:模型没有见过或见得太少的知识,例如某个领域的专业术语、2025年的最新法规等。原生大模型可能对“急性ST段抬高型心肌梗死(STEMI)”这类专业名词理解不透,导致后续的诊断编码、用药推荐等一系列专业工作出错。
◦ 样本稀疏:模型对某些罕见的任务格式或风格不熟悉,比如要求它按特定格式撰写罕见病历。
• 纠能力(解决“学歪了”的问题):
◦ 表示缺陷:模型虽然见过某些词,但在其内部的向量空间中,这些词的表示是混乱或错误的。例如,模型可能将LayerNorm和BatchNorm两个词的向量表示学得非常接近,导致在回答相关问题时将两者混淆,表面看是知识错误,根源却是词级理解缺陷。
◦ 行为偏差:模型的输出不符合特定要求,如输出的JSON格式总缺少字段,或回答内容触及安全合规的红线。微调可以帮助模型与人类的偏好和伦理价值观进行对齐(Alignment),确保其行为符合预期。
通过微调,我们可以提升模型在特定任务上的性能和准确性,使其更好地适应特定领域的知识体系和任务需求。
- 什么时候微调?
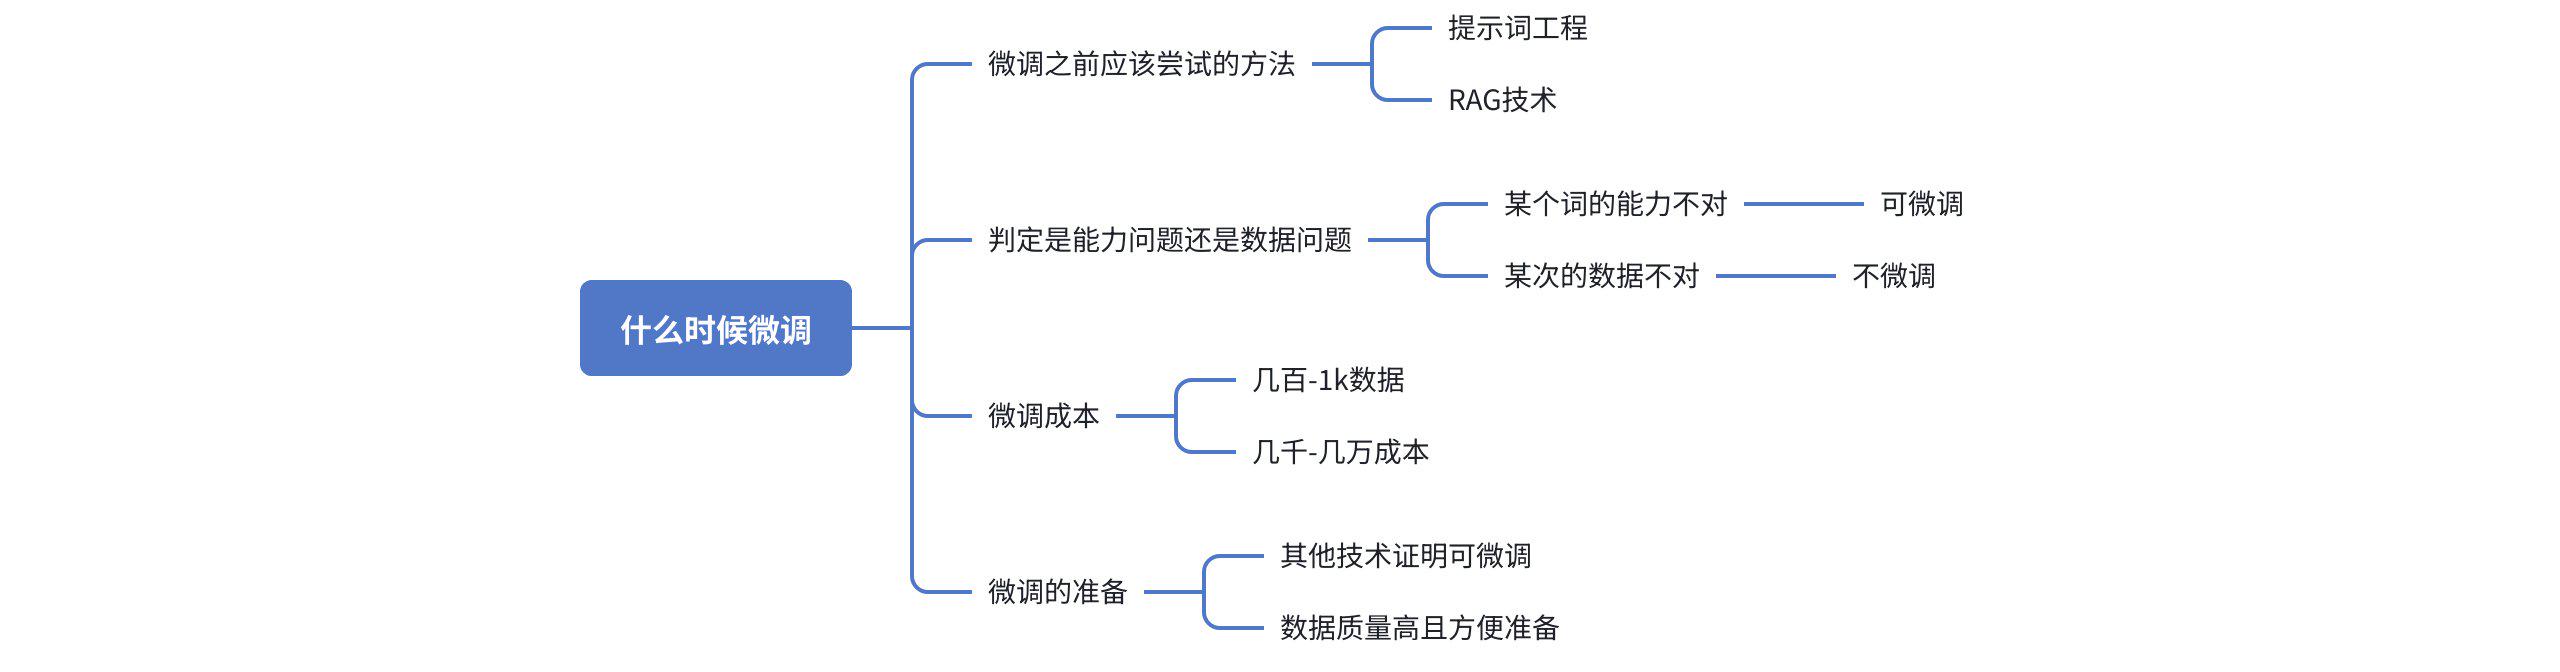
微调并非All way方案,而是在其他低成本方法失效后的选择。启动微调的最佳时机,可以用一个五点检查清单来概括:“提示词用尽、RAG到位、错误持续、数据够量、实验有效”。
具体来说,当以下条件同时满足时,就应该考虑微调了:
- 提示工程(Prompt Engineering)已达瓶颈:反复迭代优化提示词(Prompt),但模型性能提升已微乎其微(例如,连续两轮提升小于2%)。
- 检索增强生成(RAG)效果不佳:即便引入了外部知识库(如RAG),模型仍然频繁、稳定地犯事实错误、格式错误或边界错误。特别是在RAG给出正确段落后,模型依然答错,这可能暗示问题出在模型自身的能力而非知识缺失。
- 错误模式集中且代价高昂:线上监控发现,某类错误持续出现(例如,连续7天某个指标低于阈值),且这些错误对业务造成了较高代价。
- 拥有足够的高质量数据:有能力构造出至少几百上千条高质量的“正确范例”数据用于微调。如果错误样本少于200条,微调很容易过拟合,效果不佳。
- 小规模实验证明有效:通过小批量数据(如500-1000条)进行短时间的LoRA微调实验,如果性能相比基线(如5-shot Prompt)有显著提升(例如,提升≥8%),则证明微调的投资回报率(ROI)为正,值得全面铺开。
总结来说,微调的前提是“Prompt/RAG已无法经济地弥补模型的能力缺陷”。如果问题是知识更新频繁(如股价)、临时性需求(如活动文案)或数据量不足,那么RAG、动态模板或数据增强是更合适的选择。
换句话说,如果大模型的某个词对应的能力有问题则应该微调,如果仅仅是因为缺失运行时的数据则不用微调。
- 有哪些微调方法?成本如何?
大模型微调技术体现了在性能与效率之间的权衡,主要分为两大类:全参数微调和部分参数微调。
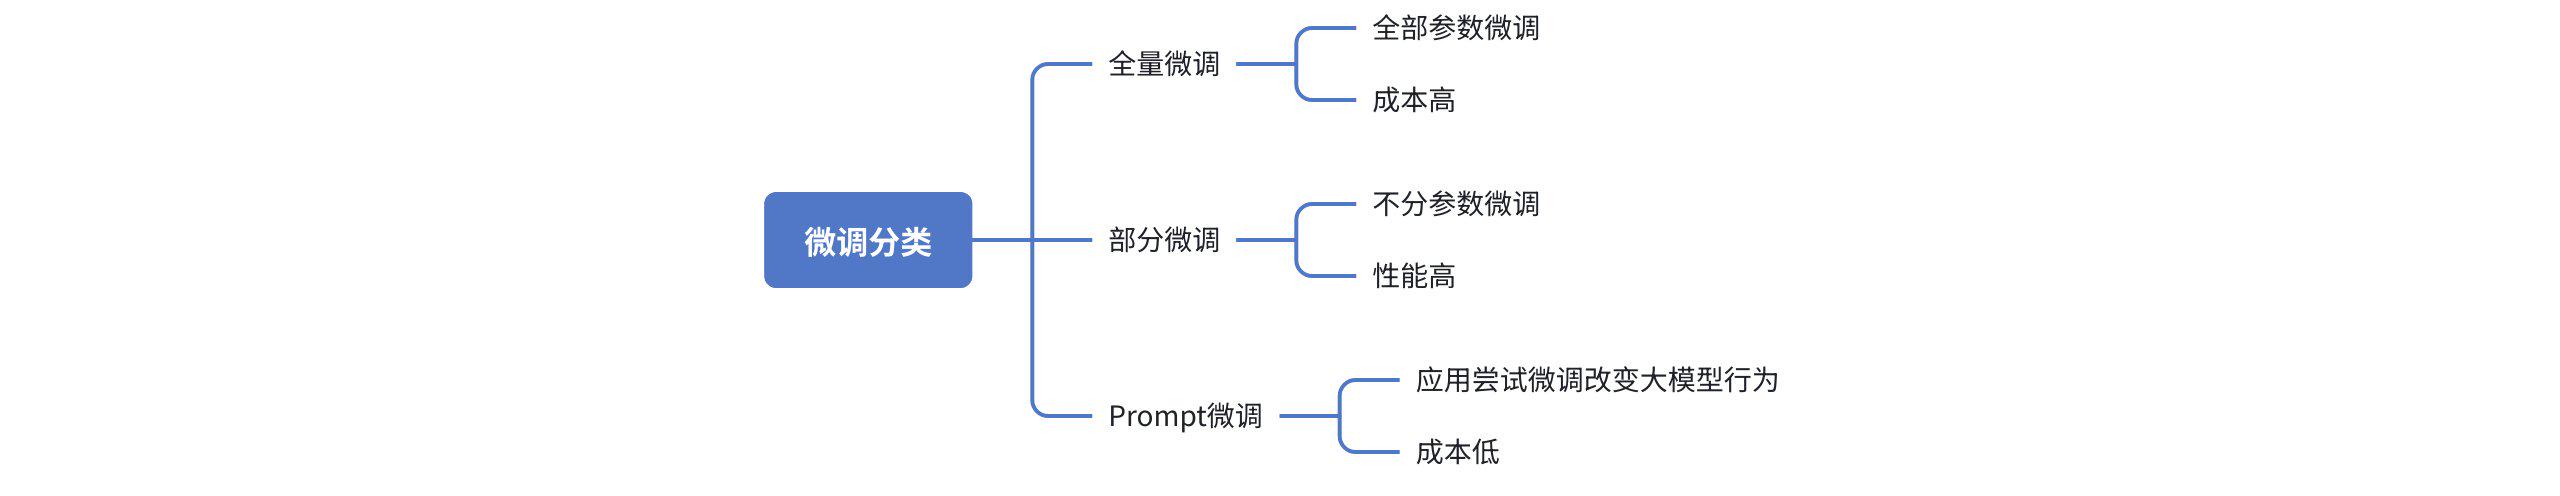
• 全参数微调 (Full Fine-Tuning)
◦ 方法:更新模型中所有层的全部参数(权重)。这是最直接的微调方式,灵活性强,能最大程度地适配新任务。
◦ 成本:非常高。需要大量的计算资源(如GPU显存)和时间,适用于数据量充足且对任务性能要求极高的场景。
• 部分参数微调 (Partial Fine-Tuning)
◦ 方法:只更新模型参数的一个子集,以减少计算开销,同时保留大部分预训练知识。
◦ 成本:较低。旨在实现高效适配,广泛应用于资源受限或需要快速部署的场景。
◦ 主要流派:
- 参数高效微调 (Parameter-Efficient Fine-Tuning, PEFT):这是当前最主流的部分参数微调方法,目标是在最小化参数调整量的同时最大化性能提升。其下又包含多种具体技术:
• LoRA (Low-Rank Adaptation) 及其变体 (如QLoRA, DoRA等):通过引入低秩适配器矩阵来模拟参数更新,只训练这些新增的少量参数,极大地降低了内存和计算需求。一次LoRA微调实验的成本可能非常低,例如,在A100 GPU上训练1-2小时,成本可能低于5元人民币。
• Adapter Tuning:在模型的不同层之间插入小型的“适配器”模块,训练时冻结原模型参数,只更新这些适配器模块的参数。
• 基于Prompt的微调 (Prompt-based Tuning):
• 方法:包括Prefix-Tuning、Prompt Tuning、P-Tuning等。这类方法不改变模型的核心参数,而是通过优化添加到输入端的、可学习的虚拟提示(Prompt)或前缀(Prefix)来引导模型生成期望的输出。
• 成本:通常也是非常低的,因为它需要更新的参数量极少。
不同的微调方法各有侧重,提供了灵活的选择以满足多样化的应用需求15。随着技术发展,未来可能会出现更高效的微调策略.
微调技术简介
现在大模型微调技术实现上非常简单,比如用「LLaMA-Factory」微调一个闺蜜大模型跟你聊天。
一行 Docker 直接把环境跑起来:
然后浏览器打开
localhost:7860,就像发朋友圈一样简单:
- 上传 50 条聊天 JSON;
- 选“LoRA”+“中文提示”;
- 点“Start”去倒咖啡;
- 20 分钟后,模型已学会“哈哈哈~”结尾,回消息比我闺蜜还像本人。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70049428/viewspace-3176128/ ,如需转载,请注明出处,否则将追究法律责任。

