常见的 SQL 语句
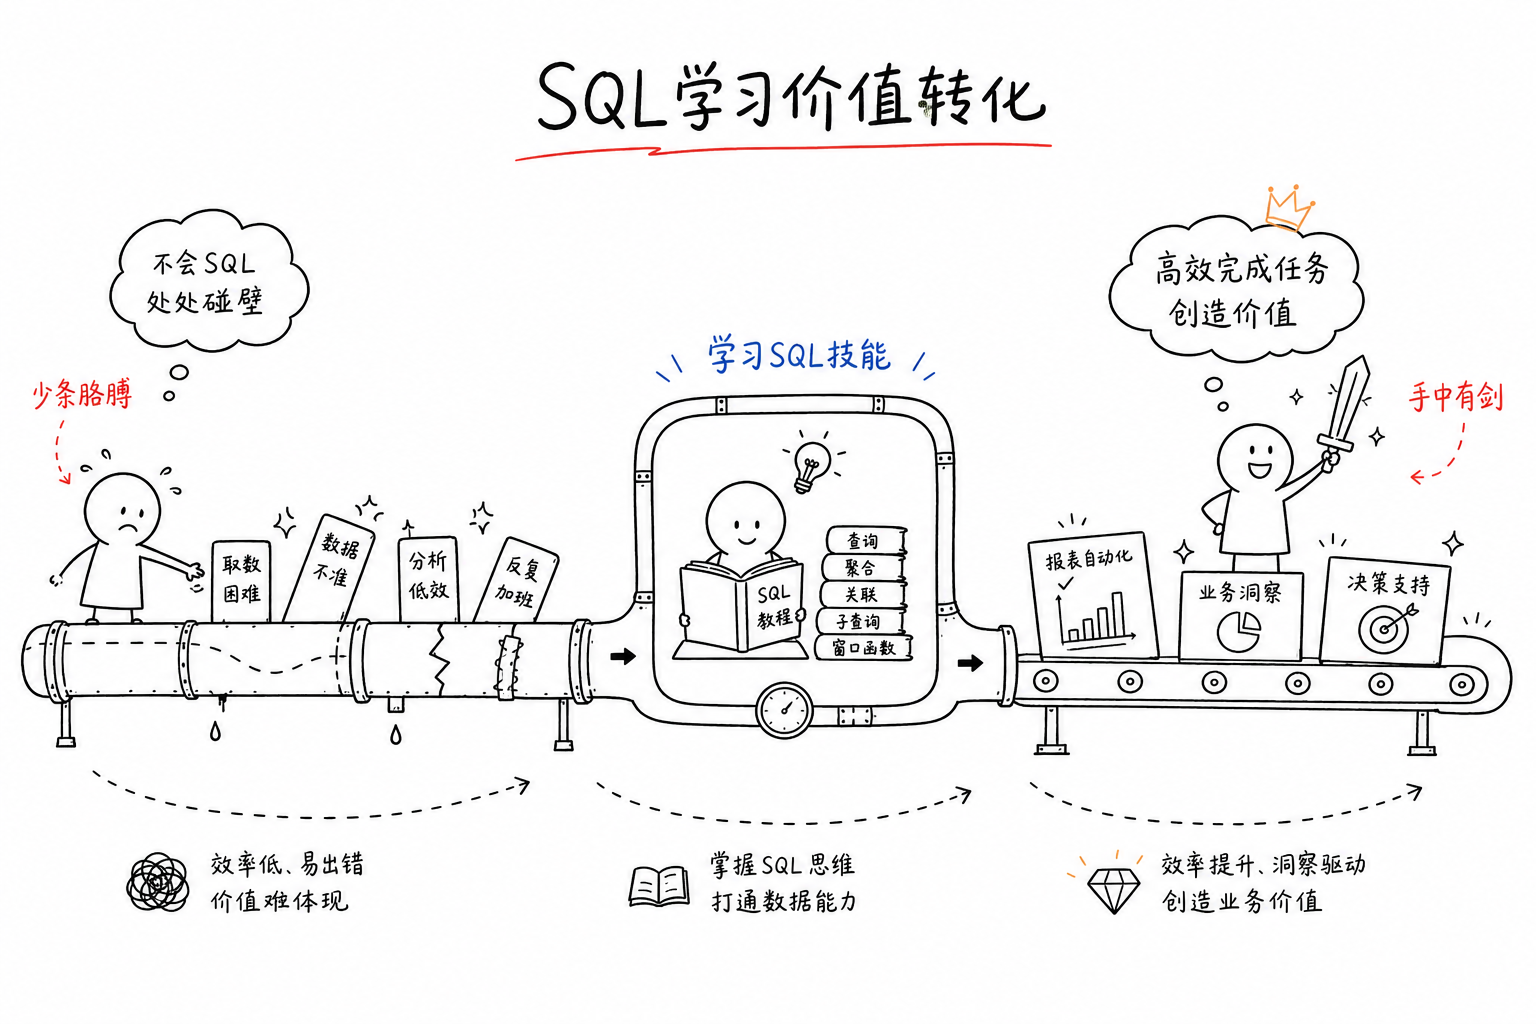
嘿,朋友!一起把SQL“肢解”了,再装回去,行不?
很多刚接触数据库的朋友,看到
SELECT、
WHERE、
JOIN 这些词,就像看到了天书。别急,咱们换个思路。
你想象一下,数据库就像一个超大型的Excel表格仓库,而SQL就是一把key,让你能从这个仓库里 精准地找到、修改、添加甚至删除你想要的数据。
今天,咱们不搞枯燥的背诵,而是从 工程视角,像拆解一台精密的机器一样,把SQL最常用、最核心的几个“零件”拆开看看。准备好了吗?花上20分钟,跟着我的思路,咱们一起把这几个“零件”玩明白!
1. 核心动作:查询(SELECT)—— 从仓库里“拿”东西
这是你最常用的操作,没有之一。就像你去图书馆,想找一本书。
1.1 基础查询:把整本书搬过来
最“暴力”的方式,就是把整个书架都搬过来。
SELECT * FROM Websites;
这里的
* 是通配符,代表“所有列”。而
FROM Websites 就是告诉SQL:“嘿,去那个叫
Websites 的书架上找!”
1.2 精准查询:只拿你需要的章节
如果你只想看书的目录和简介,就不会把整本书都搬过来。SQL也一样,我们可以指定只取某些列。
SELECT name, url FROM Websites;
这样,我们就只拿到了
name 和
url 这两列的数据,是不是清爽多了?
2. 过滤条件(WHERE)—— 戴上“显微镜”找东西
光知道从哪个书架拿还不够,我们还得知道具体是哪本书。
WHERE 子句就是你的“显微镜”,帮你精确锁定目标。
打个比方:你想找一本作者叫“张三”的书。
SELECT * FROM Books WHERE author = '张三';
2.1 常用的“显微镜”镜片
WHERE 后面可以接很多种条件,就像给显微镜换不同的镜片。
-
等于(=):精确匹配。比如
empno = 7900。 -
大于/小于(> / <):范围筛选。比如
sal > 2000。 - 组合条件(AND / OR / NOT):
-
AND:必须同时满足。比如
sal > 2000 AND sal < 3000(工资在2000到3000之间)。 -
OR:满足其一即可。比如
sal > 2000 OR comm > 500(工资高于2000或者奖金高于500)。 -
NOT:取反。比如
NOT sal > 1500(工资不高于1500)。 -
范围(BETWEEN):一个更优雅的范围写法。
sal BETWEEN 1500 AND 3000等价于sal >= 1500 AND sal <= 3000。 -
枚举(IN):匹配列表中的任意一个值。
sal IN (5000, 3000, 1500)等价于sal = 5000 OR sal = 3000 OR sal = 1500。 - 模糊匹配(LIKE):当你记不全名字时,这就是神器。
-
'M%':以M开头的所有内容。 -
'%M%':包含M的所有内容。 -
'%M_':倒数第二个字符是M的内容。(_代表一个任意字符)
小互动:假设你想找所有名字里带“o”的员工,SQL语句该怎么写?答案就是:
SELECT * FROM emp WHERE ename LIKE '%o%';
3. 排序(ORDER BY)—— 给结果排排队
查出来的数据可能乱糟糟的,就像一堆书散落在地上。
ORDER BY 就是你的“整理员”,可以按指定顺序排好。
语法很简单:
SELECT * FROM Websites ORDER BY alexa;
这会让结果按
alexa 列
从小到大(升序,ASC)排列。想
从大到小(降序)?加个
DESC 就行:
SELECT * FROM Websites ORDER BY alexa DESC;
还可以按 多列排序,比如先按国家排,再按排名排:
SELECT * FROM Websites ORDER BY country, alexa DESC;
这就像先把书按国家分类,在每个分类里,再按排名从高到低摆放。
4. 增删改(INSERT / UPDATE / DELETE)—— 动动仓库里的“货”
光会查还不行,我们还得会“进货”、“理货”和“下架”。
4.1 进货(INSERT INTO)
往表里加一条新数据。
-
简化版:必须提供所有列的值。
INSERT INTO table_name VALUES (value1, value2, ...); -
标准版:指定要插入哪些列,更安全、更清晰。
INSERT INTO table_name (column1, column2) VALUES (value1, value2);
注意:强烈推荐使用 标准版,因为它能避免因表结构变化导致的错误。
4.2 理货(UPDATE)
修改已有的数据。 这是最危险的操作之一,千万要小心!
UPDATE Websites SET alexa = 5000, country = 'USA' WHERE name = '菜鸟教程';
关键:
WHERE 子句!它指定了要修改哪一行。如果忘了写
WHERE,那整个表的所有行都会被修改!这就像你本想改一本书的价格,结果把整个书店的书价都改了。
4.3 下架(DELETE)
删除数据。 同样非常危险!
DELETE FROM Websites WHERE name = '百度' AND country = 'CN';
再次强调:
WHERE 子句是你的“安全绳”!忘了它,整个表的数据就清空了!虽然表结构还在,但数据就再也找不回来了。
如果想 清空整个表(但保留表结构),可以写:
DELETE FROM table_name;
或者在某些数据库里用
TRUNCATE TABLE table_name;,后者通常更快。
5. 限制与模式匹配(LIMIT, LIKE, 通配符)—— 高级筛选技巧
5.1 只取前N条(LIMIT)
当表里有上万条数据时,我们可能只想先看看前几条。
LIMIT 就是干这个的。
SELECT * FROM Websites LIMIT 2;
(这是MySQL的写法,SQL Server用
SELECT TOP 2 ...,Oracle用
ROWNUM <= 2)
5.2 模糊搜索(LIKE + 通配符)
我们之前聊了
LIKE,现在来系统看看它的好搭档——
通配符。
-
%:代表 零个或多个任意字符。 -
'https%':以“https”开头。 -
'%oo%':包含“oo”。 -
_:代表 一个任意字符。 -
'_oogle':第二个字符是“o”的6位字符串。 -
[charlist]:字符列表(某些数据库如SQL Server支持)。 -
'[GFs]%':以G、F或s开头。 -
'[A-H]%':以A到H之间的字母开头。
思考题:如何找到所有名字以“J”开头,且总长度为5个字符的员工?答案:
SELECT * FROM emp WHERE ename LIKE 'J____';(用了4个下划线)
6. 高级筛选(IN, BETWEEN)—— 让条件更简洁
-
IN:等价于多个OR条件的简写。
``
sql SELECT * FROM Websites WHERE name IN ('Google', '菜鸟教程'); ``
-
BETWEEN:选择介于两个值之间的数据, 包含边界值(具体取决于数据库)。
``
sql SELECT * FROM Websites WHERE alexa BETWEEN 1 AND 20; ``
也可以和
NOT 组合:
WHERE alexa NOT BETWEEN 1 AND 20;
7. 给表和列起“外号”(别名)—— 让代码更易读
当你的查询变得复杂时,给表和列起个简短易懂的“外号”(Alias),能极大提升可读性。
-- 给列起别名
SELECT name AS 网站名称, url AS 网址 FROM Websites;
-- 给表起别名
SELECT w.name, a.count FROM Websites AS w, access_log AS a WHERE w.id = a.site_id;
这样,后面再引用
w 和
a 时,就比写全称
Websites 和
access_log 简洁多了。
8. 连接(JOIN)—— 把多个“书架”关联起来
这是SQL最强大的功能之一。想象一下,你的客户信息存在一个表(
Customers),他们的订单存在另一个表(
Orders)。你想知道某个客户的所有订单,怎么办?用
JOIN!
JOIN 的核心就是
基于两个表之间的共同字段(比如
Customers.id 和
Orders.customer_id)来合并数据。
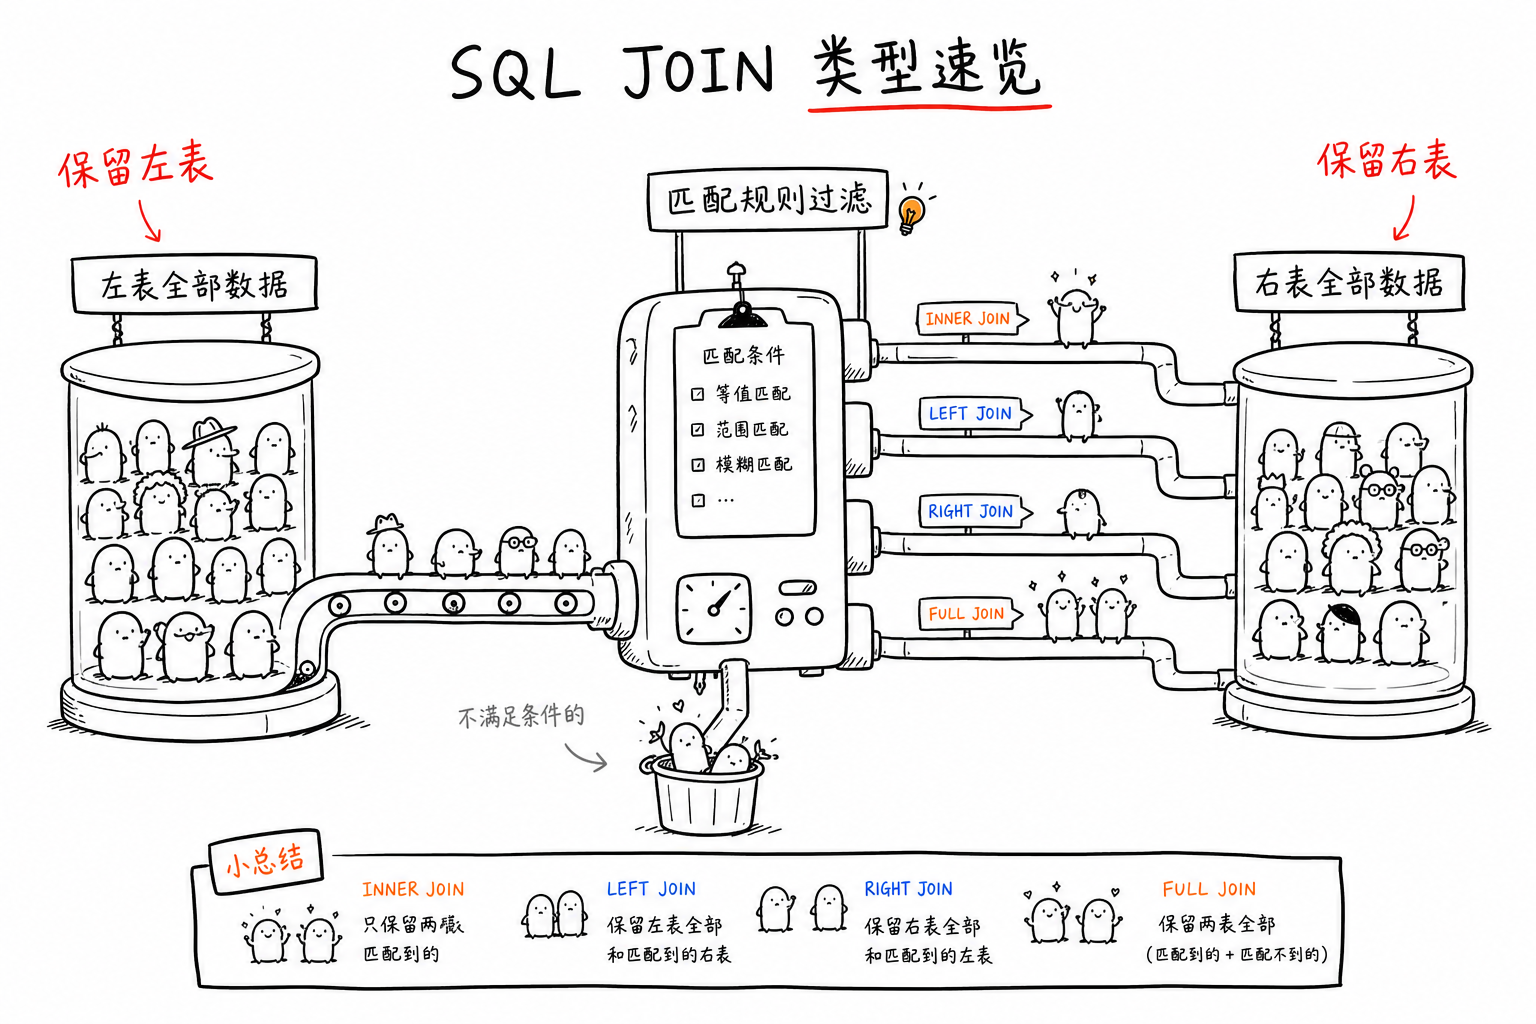
8.1 四种最常用的JOIN
我们用一个简单的图来理解(请脑补一下韦恩图):
- INNER JOIN:只返回两个表中 都有的、匹配的行。就像两个圆圈重叠的部分。
-
LEFT JOIN:返回
左表的所有行。如果右表没有匹配,就用
NULL填充。就像左圆圈的全部,加上重叠部分。 -
RIGHT JOIN:返回
右表的所有行。如果左表没有匹配,就用
NULL填充。就像右圆圈的全部,加上重叠部分。 -
FULL OUTER JOIN:返回
两个表中所有的行。只要一边有,就显示出来,另一边没有就用
NULL填充。就像两个圆圈的总和。
举个LEFT JOIN的例子:
SELECT Websites.name, access_log.count
FROM Websites
LEFT JOIN access_log ON Websites.id = access_log.site_id;
这个查询会返回
所有网站的名字,即使有些网站没有访问记录(
access_log 里没有对应数据),它们的
count 字段也会显示为
NULL。
9. 合并结果集(UNION)—— 把多个查询结果“叠”起来
UNION 操作符用于将两个或多个
SELECT 语句的结果合并成一个结果集。
重要规则:每个
SELECT 语句必须拥有
相同数量的列,且对应列的数据类型必须兼容。
-
UNION:自动去重,只保留不同的值。 -
UNION ALL:保留所有值,包括重复的。
-- 合并两个表中的所有国家(去重)
SELECT country FROM Websites
UNION
SELECT country FROM apps;
10. 常用函数(Functions)—— 给SQL加点“魔法”
SQL内置了很多函数,能帮你做计算、处理文本和日期。
10.1 聚合函数(Aggregate Functions)
它们对一组值进行计算,并返回 单一的值。就像统计员。
-
AVG():求平均值。 -
COUNT():统计行数。COUNT(*)统计所有行,COUNT(column)统计该列非NULL值的行数。 -
MAX()/MIN():求最大值/最小值。 -
SUM():求和。
10.2 标量函数(Scalar Functions)
它们基于 单一的输入值,返回 单一的值。就像加工员。
-
UCASE()/LCASE():转大写/小写。 -
LEN():返回字符串长度。 -
ROUND():四舍五入。 -
NOW():返回当前日期和时间。
10.3 实战:GROUP BY —— 分组统计
GROUP BY 通常和聚合函数一起使用,用于将数据按某个列分组,然后对每组进行统计。
-- 统计每个网站的访问总次数
SELECT site_id, SUM(count) AS total_visits
FROM access_log
GROUP BY site_id;
这个查询会先按
site_id 分组,然后对每一组内的
count 值求和。
好了,朋友!SQL这个看似庞大的“机器”,其实核心就是由这些“零件”组成的。从最基础的
SELECT 和
WHERE,到强大的
JOIN 和
GROUP BY,每一个都有它独特的作用。
学习SQL最关键的还是要练习
SQL全套学习,资料,练习和视频,推荐自学网站,SQL自学网, http://xuesql.cn 入门学习网站, https://www.w3schools.com/
现在,你心里是不是有了一张清晰的地图了?别怕犯错,多在数据库里“折腾”一下。记住, 手中有剑,心里不慌!下次见!
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70049428/viewspace-3175051/ ,如需转载,请注明出处,否则将追究法律责任。

