背景:本文以超兔 CRM「客户导入」功能的三代演进为蓝本回溯开发历程。所有表名、字段名、接口名均已脱敏改写,不影响技术脉络还原。文中数据现场全部来自工业与工贸客户——工厂、贸易商、上下游配套商。
先说结论
「客户导入」是所有 To B 系统里最不起眼、又最躲不开的功能:每个新客户上线必经,每个老客户换数据源必经。在工业与工贸客户的现场,它看起来只是"把 Excel 存进数据库",但真实世界交给你的,是 十几个工作表、几百个自造列名、七种日期写法、一客五名的重复客户、和老销售们手打了十几年的野台账。
这个功能在我们团队手里做了三代。三代之间不是简单的"加功能",而是三次开发范式的切换:
- 1.0 模板时代:系统预制模板,用户整理数据,校验交给服务器——一切确定性,成本在用户侧;
- 2.0 识别时代:系统识别任意文件,但字段映射、选项匹配靠用户在图形界面里逐个点选——半自动,成本在界面上;
- 3.0 智能时代:大模型做判决,代码做执行,人只做兜底确认——自动化的不确定性被工程化收编。
3.0 的最终架构可以一句话概括: 十四步显式流水线(run + gate + ledger)+ 五层匹配 + 两个判决小模型 + 唯一人工停点 + 幂等账本写入闭环。本文按三代顺序回溯各自的能力形态、技术架构与开发复杂度,最后给出跨代对比与工程心法。
先看战场:工贸数据的五种脏法
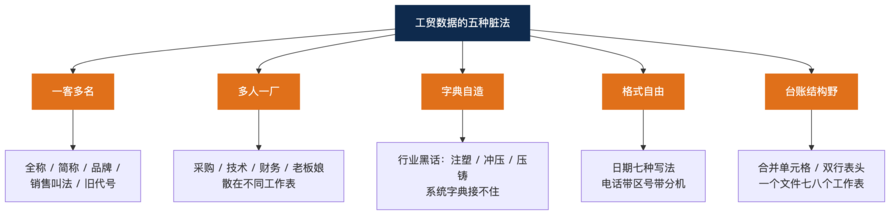
通用 CRM 的导入已经够难了,而工业与工贸客户把难度又抬了一档。他们的客户不是"个人消费者",而是 厂、贸易商、配套商——一个客户背后有车间、有采购链、有十几年的往来关系。他们的数据现场有五个鲜明特征:
- 一客多名:同一家厂,营业执照一个全称、门头一个简称、产品一个品牌名、销售嘴里一个叫法、旧系统里一个代号。客户自己填表都填不一致,何况十年间不同销售各自记的台账;
- 多人一厂:一个客户背后是一群联系人——采购管询价、技术管参数、财务管付款、老板娘管拍板,散落在不同工作表、不同行里;
- 字典自造:行业、工艺、客户等级这些字段,客户写的是行业黑话——"注塑/冲压/压铸","重点保护/随时可能跑"——系统预置字典根本接不住;
- 格式自由:日期七种写法,电话带区号带分机带 +86,金额写"1w2";
- 台账结构野:合并单元格、双行表头、一个文件七八个工作表(报价单、订单台账、联系人表各一摊)。
把这五种脏法放到三代系统面前,各自的下场是:
| 脏法 | 工贸现场实例 | 1.0 的下场 | 2.0 的下场 |
|---|---|---|---|
| 一客多名 | "华宇精密" / "河北华宇精密制造有限公司" / "HUAYU" | 全称必填,用户自己都不知道哪个是准的 | 字面匹配认不出同一家,重复建档 |
| 多人一厂 | 一个厂 5 个联系人,分布在 3 个工作表 | 多联系人靠行结构约定,用户一忘就错行 | 逐列点选,工作量随联系人数线性膨胀 |
| 字典自造 | "注塑/冲压/压铸" vs 字典里的"制造业" | 下拉里没有,校验直接拒 | 逐值创建/替换,点到手酸 |
| 格式自由 | "3月5号"、"23.3.5"、"+86-0311-8888 转 606" | 校验拒行,回 Excel 改 | 界面标红,用户点改 |
| 台账结构野 | 合并单元格 + 双行表头 + 多工作表 | 解析直接乱 | 解析乱,映射界面跟着乱 |
这张表同时也是 3.0 的需求清单——每一行都是 3.0 必须接住的招。
其中 查重是生死线。工贸客户的资产不是"联系人列表",而是"这家厂谁在跟、跟到哪一步、报过什么价"——一旦一客多名裂成多条记录,报价历史断成几瓣,两个销售各跟各的,互相压价撞单,老板看到的客户数还是虚的。三代系统对查重的态度,本身就是一条演进线索:1.0 把选择权交给用户(新建式还是覆盖式,自己掂量);2.0 在界面上做提示;3.0 才真正把它变成系统责任(详见 3.4 的查重与并入规则)。
全景:三代演进一张图

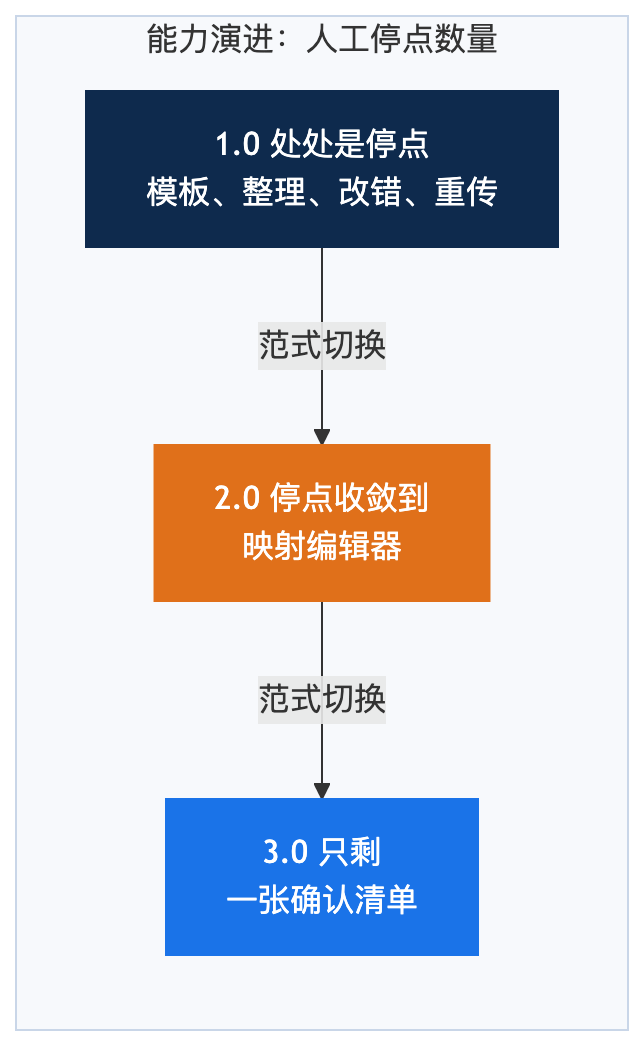
三代的本质差异可以用一句话概括: 数据整理的职责,从用户手里一步步移到了系统手里。下面逐代拆解。
一、1.0 模板时代:确定性世界的重预制
1.1 能力形态
1.0 的世界观是: 用户的数据必须长得像系统要求的样子。为此系统提供了"预制模板"这一核心机制:
- 模板不是静态文件,而是 按当前租户的数据字典动态生成的 Excel——字典里有哪些选项,模板下拉里就有哪些值;字典变了,旧模板作废,要重新下载(生成还要等一两分钟);
- 模板分企业客户/个人客户两大类,再细分简版、完整版、进阶版(进阶版支持上下级客户、分组隔离、指定所有者);
- 三个必填字段(客户简称、客户全称、客户种类)写死在说明页里;
- 多联系人靠约定:从第二个联系人开始,只填客户简称和联系人列,其余客户列留空;
- 单次上限 1000 行,且明确不支持 WPS——模板里的隐藏校验公式只在微软 Office 下可靠。
放到工贸现场,1.0 的几个设计都显得吃紧:
- 1000 行上限撞上老牌经销商十年积累的台账——几千行数据要分批导,批次之间的重复与覆盖风险全靠用户自己小心;
- 多联系人靠行结构约定,而工贸客户恰恰是"多人一厂"的重灾区:一个厂五六个联系人,用户在 Excel 里拆行拆到眼花,约定一忘就是错行错挂——张三的询价记到李四的厂里,比不导入还糟;
- 覆盖式导入的语义在这个场景下格外危险:老客户换数据源重新导一遍,"覆盖"还是"并入"选错,存量数据就出事——这个判断 1.0 全权交给用户。
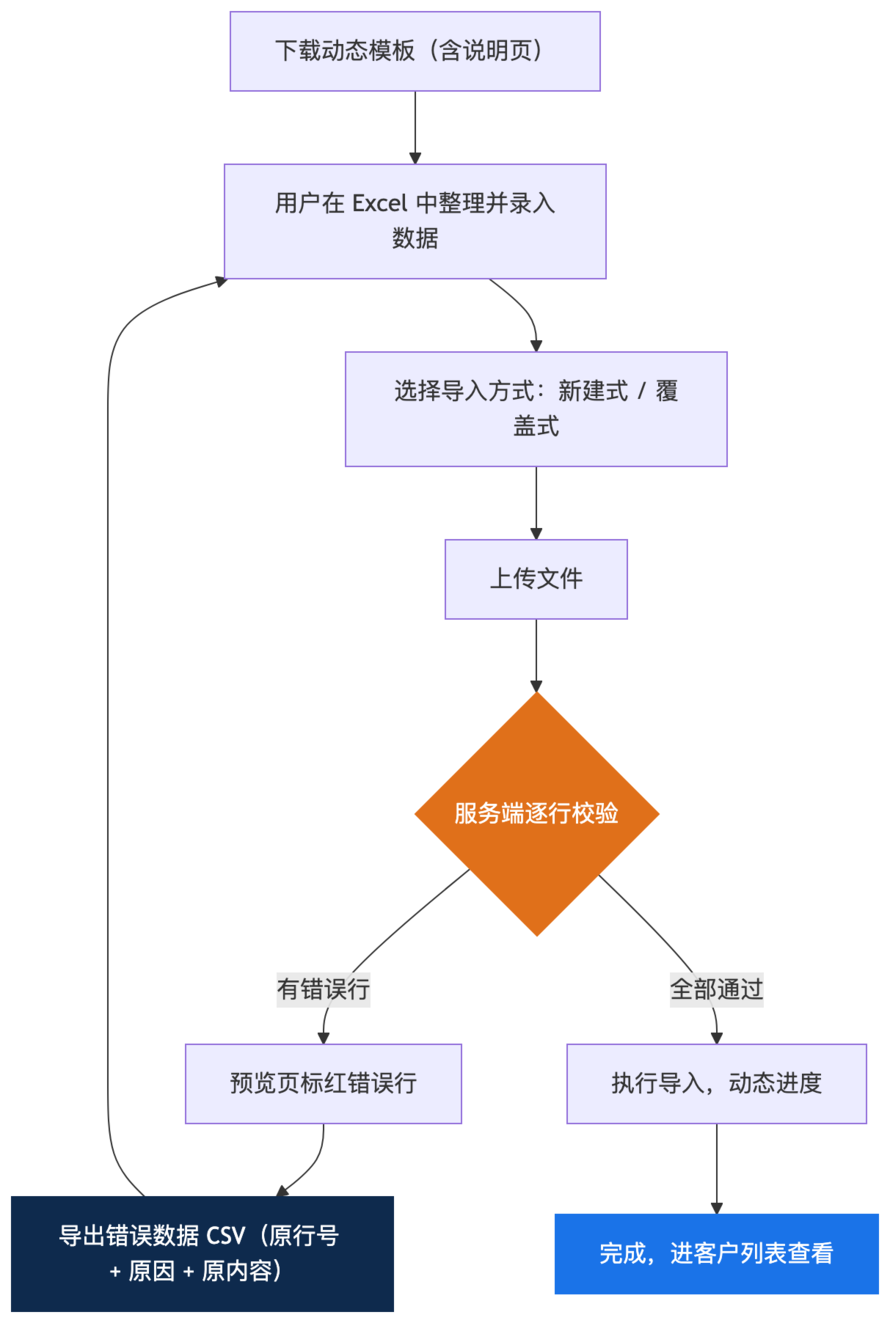
导入流程是一个标准的"校验-回改-重传"闭环:
1.2 技术架构
1.0 是经典的三层结构, 没有任何 AI 参与:
- 模板生成器:读取当前租户的字段定义与数据字典,渲染出带隐藏校验的 xls 文件;
- 服务端校验器:逐行验证必填、格式、字典值合法性、引用完整性(如上级客户简称必须已存在);
- 批量写入器:校验通过的行进批量入库。
每个环节都是纯确定性代码。错误处理也是确定性的:错误行标红、给出原因、导出 CSV 让用户回去改。
1.3 开发视角
从开发复杂度看,1.0 是三代里最低的:
- 状态空间小:一条流水线,没有分支交互,不需要前端状态机;
- 测试面窄:校验器是纯函数,单测好写;
- 难点集中在两处: 动态模板生成(字典联动、多模板变体、隐藏公式的 Office 兼容)和 校验规则的完备性(现实数据总能找到你没想到的脏法)。
但它的产品成本极高: 所有预制工作都在用户侧。工贸用户要读懂说明页、按格式整理数据、为多联系人设计行结构、出错后按行号回 Excel 改了再传。对一个只导入一两次的用户来说,学习成本远高于导入本身的收益。系统简单了,用户复杂了。
二、2.0 识别时代:把模板还给用户,增加图形化映射
2.1 能力形态
2.0 迈出的关键一步是: 用户不再需要下载模板,任意表格文件直接上传。系统识别文件内容,字段自动匹配:
- 上传后自动做表头匹配,与系统字段一致的自动对上;顶部实时统计"已匹配/未匹配字段数";
- 没对上的,由用户在 字段匹配区域逐行手工选择(左侧目标字段、右侧来源字段);
- 支持 导入时创建自定义字段——文件里多出来的列可以顺手建成系统字段;
- 选项类字段出现 单选值映射区域:文件里的值如果系统字典没有,标红,用户可以逐个点击"创建到系统(+)"或"替换系统现有选项(→)",也支持批量创建/批量替换。

2.2 技术架构
2.0 的重心从服务端挪到了 前端状态机:
- 文件解析在前端完成(表头提取、数据预览、行数统计);
- 自动匹配是启发式的:表头与系统字段名做精确/相似度比对,能对上的直接落位;
- 匹配界面是一个双列映射编辑器,配上选项级的二级映射面板——这是 2.0 开发量的主体;
- 服务端退化为"字段元数据接口 + 写入接口",模板生成器整个废弃。
匹配的核心逻辑不复杂,本质是一个名字对齐问题:
// 表头自动匹配(脱敏示意)function autoMatch(headers, sysFields) { return headers.map((h) => { const norm = h.trim().toLowerCase(); const hit = sysFields.find((f) => f.name === norm); // 精确命中 if (hit) return { header: h, target: hit, auto: true }; const fuzzy = sysFields.find((f) => f.name.includes(norm)); // 包含式兜底 return fuzzy ? { header: h, target: fuzzy, auto: true } : { header: h, target: null, auto: false }; // 留给用户 });}
到了工贸现场,"名字对齐"还有一层暗礁: 一客多名。2.0 中期我们补了一件武器——名称指纹,把字面上的变体先归一掉:
// 名称指纹(脱敏示意):工贸客户"一客多名"的字面归一function nameFingerprint(raw) { return String(raw) .replace(/(([^)]*)|\([^)]*\))/g, '') // 去括号备注:"华宇精密(原红星厂)" .replace(/(股份|责任)?(公司|集团|厂|部|中心|门市|经营部)$/g, '') // 去组织后缀 .replace(/[\s·、,,]+/g, '') // 去空白与分隔符 .toUpperCase(); // HUAYU / huayu 归一}
指纹能解决"华宇精密制造有限公司"和"华宇精密"这类字面变体,但解决不了语义等价——"老华那厂"和"HUAYU"在字面上毫无交集。 这条线走到头,就是 2.0 的天花板,也正是 3.0 的入口。
2.3 开发视角
2.0 的开发复杂度比 1.0 上了一个台阶,但复杂度的 性质变了:
- 1.0 的复杂度在服务端规则;2.0 的复杂度在 前端交互状态:映射关系、映射修改、选项映射、批量操作之间的联动,是典型的高维状态编辑器;
- "全部替换"这类批量操作引入了破坏性语义(把系统字典按文件顺序整个换掉、没替换到的直接删),开发上必须做二次确认与危险提示—— 半自动系统的每一步人工操作都要防误操作;
- 测试面从纯函数扩展到了 UI 交互流,回归成本明显上升。
工贸现场还会把 2.0 的交互成本再放大一档:通用客户的文件 30 列算多的,而一份报价单导出常常 60 列起步,一个文件里三五个工作表。映射界面的点选次数与列数、选项数是乘法关系—— 半自动系统的问题不在"能不能",在"点不完"。
产品侧的账也很清楚:系统识别了文件,但 两级映射(列→字段、值→选项)的认知负担原封不动地留给了用户。一个 30 列、10 个选项字段的文件,用户可能要在界面上点上百次。比 1.0 好得多,但离"顺手"还很远。
三、3.0 智能时代:大模型判决,人只兜底
3.1 设计原则
3.0 的目标定得非常直白: 尽可能降低手工操作,达成 0 门槛导入。落到开发上是三条铁律:
- 确定性优先:能靠代码算出来的绝不麻烦模型——逐字命中、别名库、格式归一这类确定性逻辑仍是主干;
- AI 只做判决,不做写入:大模型只回答"这一列去哪、这个值归并到哪",所有对系统的写操作由确定性代码执行;
- 人只做兜底:AI 拿不准的、涉及系统变更的,打包成一张确认清单,人只看这一张。
架构上选择了 工作流编排平台(Workflow API)直调,全程没有智能体(Agent)循环——判定任务是有限轮次的结构化判决,Agent 的自由度在这里只会带来不稳定。判决模型用国产主力大模型,temperature 0,输出严格 JSON。这里有一个实战结论:轻量档模型指令跟随能力不足,无法稳定完成"逐列覆盖"的结构化判决,换强档后探针测试 6/6 全对、零波动—— 模型档位是架构参数,不是成本参数。
3.2 十四步流水线
3.0 的执行骨架是一条
显式注册的十四步流水线:每步 =
run(执行)+
gate(门禁)+
ledger(落账)。gate 不过就显式失败停点,
禁止带病下传;所有值的去向进"丢值总账",任何值不允许无终态消失。

骨架本身就是三条铁律的代码化——每步显式注册
run +
gate,账本逐步合并,gate 不过当场停:
// 流水线骨架(脱敏示意):run + gate + ledgerconst steps = [ { id: 'parse', run: parseAndProfile, gate: (r) => r.columns.length > 0 }, // 有列可判 { id: 'match', run: fiveLayerMatch, gate: (r) => r.everyColumnHasFinalState() }, // 每列有终态 { id: 'plan', run: planChanges, gate: (r) => r.planConsistentWithMeta() }, // 纯计划不动系统 { id: 'confirm', run: humanConfirm, gate: (r) => r.userApproved }, // 唯一停点 { id: 'write', run: idempotentWrite, gate: (r) => r.ledgerClosed() }, // 账本闭合 { id: 'verify', run: readBackVerify, gate: (r) => r.allDiffExplained() }, // 差异全有解释];for (const s of steps) { const result = await s.run(ctx); if (!s.gate(result)) throw new PipelineStop(s.id, ctx.ledger); // 显式失败停点 ctx.ledger.merge(result.ledger); // 一切落账}
两个细节值得展开:
- T0+T1 双层元数据:T0 是随代码发布的基线字段快照(离线测试的夹具),T1 是运行时从元数据接口动态拉取的当前租户字段与字典。自定义字段、字典选项这些 租户级数据永远以 T1 为准、运行时获取,禁止硬编码——多租户 SaaS 里这是生命线;
- 确认是唯一停点:十四步里只有第 6 步等人。清单上每张卡对应一件事(列映射/建字段/字典变更),必选项缺失整卡红边框;没有待确认项时提示"无待确认项,请执行",理想情况下用户从贴表到导入完成只做一次点击。
3.3 五层匹配与两个小模型
列匹配是 3.0 的核心战场,采用 五层判定序贯 + 大模型全场复核的结构:
// 五层判定(脱敏示意),序贯短路:高层命中即定案/出候选L1 精确层 // 列名 === 字段名,逐字相等L2 别名层 // 人工维护的别名库(如"老板电话"→ 联系人手机),命中即定案L3 记忆层 // 历史人工定案的映射库直接复用(最强证据,含"@进备注""@丢弃")L4 词表层 // 同义词表,只出候选交给确认清单,不在代码层定案L5 重合层 // 列值与字典选项重合度 >= 0.8 视为强对齐信号(候选档)
关键设计是 代码层命中一律降级为"预判",随要素包送大模型全场复核:AI 判决优先级高于预判,漏答或调用失败时回落预判兜底。唯一例外是客户全称字段 硬锁,防止模型幻觉改判导致主键错乱。而当全部列逐字命中主表且无联系人子表字段在场时,走 零调用快路径——确定性足够时连模型都不调,成本为零。
字典归因是第二个小模型任务:字典内值直写;字典外的值由模型判"归并到哪个现有选项 / 新建选项 / 弃置进备注"。大字典做了裁剪策略:≤300 项全量送审,>300 项送前 40 项加与典外值字面互含的条目。
把判决阶段放进时间轴,一次典型的运行是这样的:
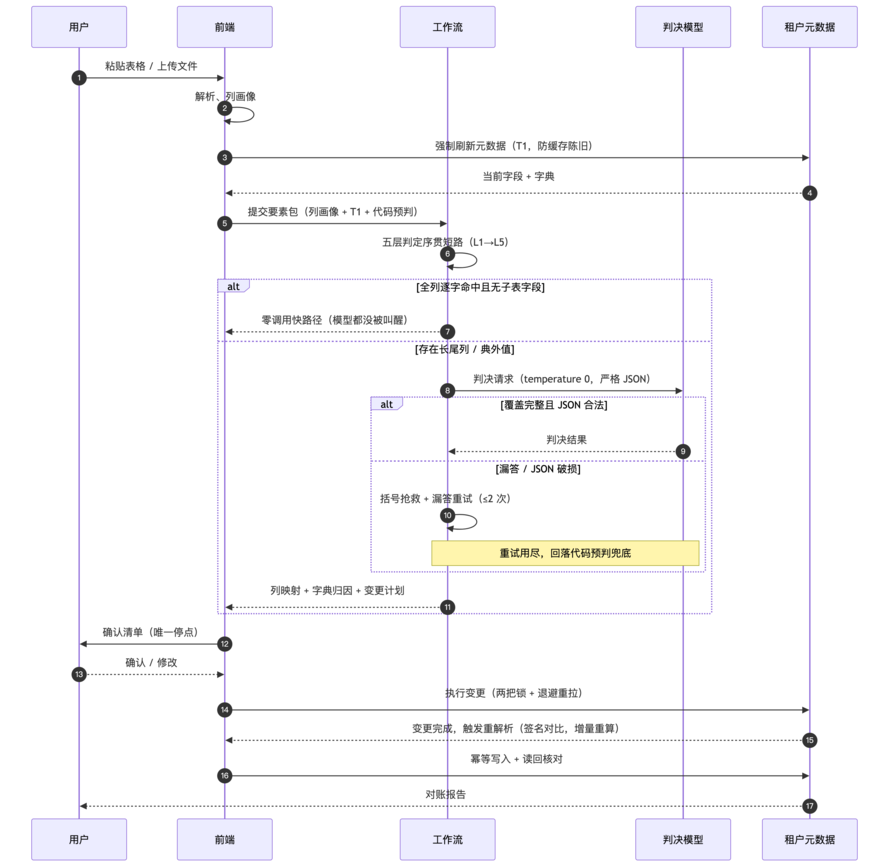
这张图里值得盯住的两处:
强制刷新元数据排在提交判决之前(缓存陈旧是误判之源);
回落预判是模型链路的兜底出口(模型挂了,导入不停摆,只是清单变长)。
不确定性的每一条退路,都要有确定性的终点。
3.4 写入闭环
写入阶段完全是确定性代码,但要把 LLM 世界的不确定性"关"在判决层之后:
- 两阶段写入:先客户主表批量,再联系人子表批量;逐条容错,单行失败不拖垮整批;
- 幂等与断点续传:每行以行号为键登记一条终态入账本,写入前对账、失败后只补未完成位,重跑零重复建档;
-
查重先行:写入前用精准
where-in查询比对存量客户——全称撞上且带联系人的并入存量客户(只挂联系人,客户本体不动),简称撞上自动升级全称重查,批内同全称先合并、联系人并入首行;查重接口失败则降级空集不阻断,由写入侧服务端拦截兜底; - 读回核对:写入后把数据读回来逐字段比对。 已知变换(字典归并、日期归一、空格规范化)吸收不报, 真差异如实呈现;并入存量客户的行如实标注"仅并入联系人,主表列未写入"——这一步是"AI 判决 + 代码执行"闭环的最后防线。
两阶段写入配上幂等账本,在时间轴上是这样的:

幂等账本的登记与终态语义(脱敏示意):
// 幂等账本(脱敏示意):每行以行号为键登记终态,重跑只补无键行done[rowIdx] = { kind: 'written', cid: newId }; // 正常建档done[rowIdx] = { kind: 'attach', cid: existingId }; // 全称撞存量:联系人并入,客户本体不动done[rowIdx] = { kind: 'full', cmsg: '已有同全称客户,跳过不重建' };// 终态枚举:written(已写)/ attach(并入存量)/ full(跳过)/ skipped(弃置)/ failed(待续传)// 写入前对账:已终态的跳过;断点续传只补无键行,绝不重复建档
格式归一是写入前的最后一道确定性关卡(脱敏示意):
// 格式归一(脱敏示意):日期与电话的"工贸七十二变"function normalizeDate(v) { const m = String(v ?? '').match(/(\d{4})[.\/年\-]\s*(\d{1,2})[.\/月\-]\s*(\d{1,2})/); if (m) return `${m[1]}-${m[2].padStart(2, '0')}-${m[3].padStart(2, '0')}`; const serial = Number(v); // Excel 序列日期(如 41839) if (Number.isFinite(serial) && serial > 20000 && serial < 60000) return serialToDate(serial); return null; // 归一不了的进确认清单,绝不瞎猜}function normalizePhone(v) { return String(v ?? '') .replace(/[^0-9+]/g, '') // 去空格/横线/括号/"转" .replace(/^\+?86/, ''); // 去 +86;区号分机原样保留进读回核对}
"归一不了的进确认清单,绝不瞎猜"——确定性逻辑的边界划在哪里,比它能处理多少格式更重要。
3.5 工程战斗清单
3.0 的大部分开发量不在主干,而在 驯服不确定性。挑几场有代表性的战斗:
- JSON 抢救:模型偶发在输出尾部多一个括号导致整体解析失败。标准解析失败后做字符串感知的括号配对扫描,截取第一个平衡的 JSON 对象抢救回来;
- 漏答检测:判决要求逐列覆盖,模型偶尔偷懒漏答几列。拿到判决后校验列覆盖完整性,缺列自动重试(上限 2 次),用尽才回落预判;
- 竞态门控:补完字典后的重解析与兜底写入存在时序冲突,旧构建可能抢先写入导致新字典值未生效。解法是版本号门控 + 元数据可见性护栏;
- 缓存陈旧:元数据缓存导致刚建的自定义字段不在候选列表里,引发误判。页面触发导入时强制刷新元数据;
- 服务端语义实测:字典保存接口实测是 追加语义而非覆盖(同全量提交两次,尾项重复)——文档不会告诉你这些,探针实验是唯一真相;
- 隐性必填:接口元数据不暴露全部必填约束,靠"写入失败 → 学习 → 沉淀到租户存储"的自愈链路补齐,下次导入直接复用;
- 进度签名抗碰撞:批次签名从哈希改为原始串直存,AI 缓存键加长度因子双校验,避免跨批次记账错位。
挑 JSON 抢救展开看一眼实现——它最能体现"驯服不确定性"的气质:先信标准解析,救不回来才动手术,手术要有证据(括号配对扫描),实在救不回来才认输:
// JSON 抢救(脱敏示意):模型尾部多一个括号时的自救function rescueJSON(raw) { try { return JSON.parse(raw); } catch (e) { /* 落入抢救路径 */ } let depth = 0, inStr = false, start = -1; for (let i = 0; i < raw.length; i++) { const c = raw[i]; if (c === '"' && raw[i - 1] !== '\\') inStr = !inStr; // 字符串感知 if (inStr) continue; if (c === '{') { if (depth === 0) start = i; depth++; } else if (c === '}') { depth--; if (depth === 0) { // 第一个平衡对象即判决本体 try { return JSON.parse(raw.slice(start, i + 1)); } catch (_) { /* 继续扫 */ } } } } throw new Error('JSON_UNRESCUABLE'); // 真救不回来才显式失败}
四、三代对比:能力、架构与复杂度
| 维度 | 1.0 模板时代 | 2.0 识别时代 | 3.0 智能时代 |
|---|---|---|---|
| 用户起点 | 下载系统模板 | 任意表格文件 | 粘贴/上传/多工作表 |
| 数据整理 | 用户按模板整理 | 用户整理(无模板约束) | 系统归一(日期/金额/手机号) |
| 字段映射 | 模板即映射 | 自动精确匹配 + 用户手工点选 | 五层匹配 + 大模型复核,人只看清单 |
| 选项处理 | 模板下拉预置 | 逐值手工创建/替换 | 模型归并判决,自动补字典 |
| 一客多名 | 全称必填,用户自己猜 | 名称指纹认字面,认不出语义 | 精准撞名并入存量:全称撞→挂接联系人不重建,简称撞→升级全称重查 |
| 多人一厂 | 行结构约定,易错行错挂 | 点选次数随联系人线性膨胀 | 子表批量挂接 + 幂等账本对账 |
| 错误处理 | 标红导出,用户回改 | 界面标红,用户点改 | 逐条容错 + 自愈,人只兜底 |
| AI 参与 | 无 | 无(纯启发式匹配) | 两个判决任务 + 全场复核 |
| 写入保障 | 服务端校验 | 界面确认 | 幂等账本 + 断点续传 + 读回核对 |
| 元数据来源 | 模板生成时固化 | 接口拉取 | T0 基线 + T1 运行时强刷 |
| 开发复杂度 | 低(规则密集) | 中(前端状态机) | 高(不确定性工程化) |
开发复杂度的跃迁值得单独说。1.0 的复杂度是"规则多"——校验规则、模板变体,堆人力就能覆盖;2.0 的复杂度是"状态多"——映射编辑器的联动状态,靠状态机纪律可以管住;3.0 的复杂度是**"不确定多"**——模型输出不可控、租户元数据不可预知、现实数据不可枚举,传统"想全了再写"的方法论失效,必须换成"显式失败 + 落账 + 兜底 + 自愈"的防御性架构。
三代的能力边界可以用同一张图上的"人工停点数量"来读:1.0 处处是停点(模板、整理、改错),2.0 停点收敛到映射界面,3.0 只剩唯一一张确认清单。
五、回望:三代开发心法
- 确定性优先,AI 只做判决。代码能算的不给模型,模型只回答"去哪/归哪",写操作永远由确定性代码执行。判决错了可以重判,写错了是事故。
- 显式失败,禁止带病下传。每步一个门禁,不过就停在原地把问题说清楚,绝不静默降级。静默是智能系统最大的敌人。
- 一切落账。列有列终态、值有值终态、行行列列都有账。"任何值不允许无终态消失"这条铁律,是排查疑难杂症时唯一的救生索。
- 读回核对闭环。写进去不算数,读回来看过才算数。已知变换吸收、真差异如实呈现,机器对账替代用户肉眼。
- 记忆让系统越用越准。人工定案沉淀为映射记忆与必填名单,第二次导入同一个租户时,确认清单比第一次更短。
- 模型档位是架构参数。轻量档省下的钱会在判决波动上加倍还回来;temperature 0 + 严格 JSON + 漏答重试,是把模型当确定性组件用的最低配置。
- 服务端语义要探针实测。追加还是覆盖、必填校验在哪层拦截,文档与代码都可能是错的,唯一可信的是线上探针实验。
结语
三代客户导入,表面上是"从 Excel 到智能导入"的功能升级,底层是同一条主线: 把不确定性从用户侧逐步收编到系统侧。1.0 用模板把不确定性挡在系统外,代价是用户重预制;2.0 把不确定性接进来,用图形界面让用户消化;3.0 把不确定交给大模型消化,把剩下的残渣收进一张确认清单。
在工贸客户的现场,一张手打了十几年的台账里,藏着这家厂一半的客户关系——把它安全地搬进系统,就是这三次范式切换全部的意义。
开发范式的切换同样清晰:从"写规则",到"管状态",再到"驯服概率"。下一代的课题已经清楚——确认清单如何更短、记忆如何跨租户复用、大字典与大文件如何进一步降本,以及一客多名剩下的那块硬骨头:跨名称的客户语义归一("老销售们嘴里的叫法"对上营业执照的全称)。但无论怎么演进,"人只做兜底"的架构原则不会变: 机器负责干活,人负责把关,系统负责让两者互相信任。
如果你们团队也在做导入、同步、映射这类"脏数据进系统"的功能,欢迎在评论区聊聊你们踩过的坑——尤其是被现实数据教育的那一刻。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70048408/viewspace-3185595/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 2026年国内6款高实用CRM系统:一体化、AI化与行业化或成为新趋势
- 2026必看CRM软件盘点:6大热门产品综合实力 对比
- 2026全球头部 vs 本土CRM大盘点:6大系统核心能力解析,适配不同预算企业选型需求
- 2026客户管理系统选型指南:5大CRM 品牌实测
- 企业数字化转型必看:5 款全链路CRM系统横向测评
- 全链路闭环CRM系统:5 款主流产品深度对比测评(2026版)
- CRM盘点:6 款打通获客 - 履约 - 复购产品深度测评(2026 版)
- 制造贸易复合业态企业,主流使用的9款CRM系统盘点
- 全链路协同 CRM 系统:6 款中小微专属产品深度测评(2026 版)
- 2026客户管理系统怎么选?七大热门产品全业务链路适配性深度解析
