OceanBase列存:HTAP混合负载的性能利器
总结说明
OceanBase 列存通过 Column Group 机制将基线数据按列独立存储,结合 增量行存 + 基线列存的 LSM-Tree 架构,在保证 DML 写入性能的同时大幅提升分析型查询(扫描、过滤、聚合)效率,支持纯列存、行列混存及列存索引等多种部署形态。
详细说明
概念定义
OceanBase 列存(Column Store)是一种将基线数据按列独立存储的存储格式。与传统的行存(Row Store)将一行所有列聚在一起存储不同,列存将每一列的数据单独组织为一个 SSTable,查询时只需读取涉及列,大幅减少 IO 开销。由于同一列的数据类型一致,列存还能获得更高的压缩效率。
Column Group —— 列存的基本单元
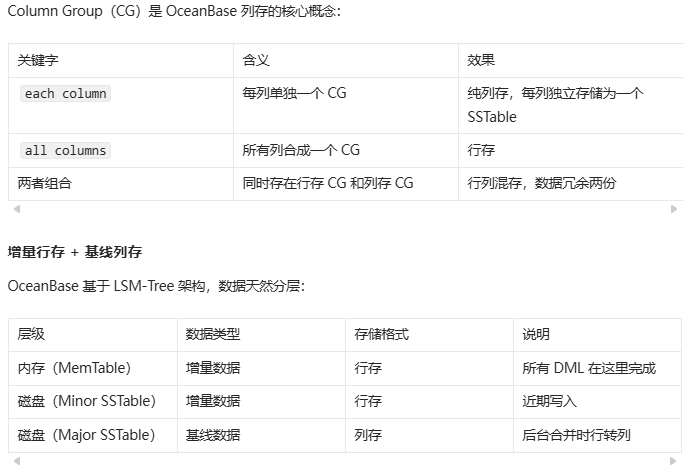
关键点:
-
增量数据始终行存 → DML 操作无影响 -
基线数据按列存储 → 分析查询高效 -
读取时自动融合增量行存和基线列存
使用场景
三种存储模式选型
| 存储模式 | 建表方式 | 适用场景 | 优缺点 |
|---|---|---|---|
| 纯行存 | 默认建表 | TP 为主 | 写性能最优,AP 分析慢 |
| 纯列存 | WITH COLUMN GROUP(each column) | AP 分析为主 | 压缩比高、分析快 |
| 行列混存 | WITH COLUMN GROUP(all columns, each column) | HTAP 混合负载 | TP/AP 均可,但存储空间翻倍 |
使用方法
-
创建列存表
-- 纯列存表

CREATE TABLE orders_col (

  order_id   BIGINT PRIMARY KEY,

  user_id    BIGINT,

  amount     DECIMAL(10,2),

  status     VARCHAR(20),

  created_at DATETIME

) WITH COLUMN GROUP(each column);


-- 行列混存表(TP/AP 都要兼顾)

CREATE TABLE orders_hybrid (

  order_id   BIGINT PRIMARY KEY,

  user_id    BIGINT,

  amount     DECIMAL(10,2),

  status     VARCHAR(20),

  created_at DATETIME

) WITH COLUMN GROUP(all columns, each column);
-
创建列存索引
-- 在行存表上创建列存索引

CREATE INDEX idx_col ON orders(user_id, amount, created_at)

  WITH COLUMN GROUP(each column);
-
已有表行存转列存
-- 行存表转列存

ALTER TABLE orders ADD COLUMN GROUP(each column) [DELAYED];
-- 行存表转行列混存
ALTER TABLE orders ADD COLUMN GROUP(all columns, each column) [DELAYED];

加上 DELAYED 选项后实际的行转列操作在下一次合并(Compaction)时完成,期间不阻塞业务。
-
设置默认存储格式
-- 租户级配置:后续新建的表默认列存

ALTER SYSTEM SET default_table_store_format =
'column';


-- 取值说明:

--
'row'       → 默认行存(系统默认值)

--
'column'    → 默认纯列存(自动加 each column)

--
'compound'  → 默认行列混存(自动加 all columns, each column)
注意:仅对新建主表生效,已有表不受影响。
-
Skip Index 列属性
每列数据按固定大小切成数据块,每个块预存统计信息(最小值、最大值、行数、SUM 等)。查询时根据统计信息直接跳过不可能命中的数据块,无需解码。
-- 建表时指定 Skip Index

CREATE TABLE t1 (

  c1 INT PRIMARY KEY,

  c2 INT SKIP INDEX(MIN_MAX, SUM),

  c3 VARCHAR(100) SKIP INDEX(MIN_MAX)

) WITH COLUMN GROUP(each column);
-- 对已有表 c2 列新增 Skip Index 属性
ALTER TABLE t1 MODIFY COLUMN c2 SKIP INDEX(MIN_MAX);

OceanBase 默认为列存表的每列自动创建 MIN_MAX 类型的 Skip Index。
-
Hint 手动指定引擎
-- 强制走列存

SELECT /*+ USE_COLUMN_TABLE(orders) */ * FROM orders WHERE ...;


-- 强制走行存

SELECT /*+ NO_USE_COLUMN_TABLE(orders) */ * FROM orders WHERE ...;
行列混存表中,优化器会自动选择最优引擎。需要手动调优时才用 Hint。
确认查询是否走了列存
EXPLAIN SELECT amount, status FROM orders_col WHERE user_id = 100;
关键标志:
| 算子名称 | 含义 |
|---|---|
| COLUMN TABLE FULL SCAN | 走了列存全表扫描 |
| TABLE FULL SCAN | 走的行存 |
列存加速原理
只读需要的列 —— 减少 IO:
查一张 100 列的表,SELECT c1, c2 WHERE c3 > 10:
-
行存:读全部 100 列的数据,浪费 97 列的 IO -
列存:只读 c1、c2、c3 三列,IO 减少 97%
Skip Index 数据跳过: WHERE age = 25
数据块1: min=30, max=50 → age=25 不可能在这里 → 直接跳过!
数据块2: min=18, max=28 → 可能有 → 读取并检查
数据块3: min=40, max=60 → 直接跳过!
不用解码就能跳过大量数据块,查询效率大幅提升。
谓词/聚合下推 —— 存储层直接算:
传统方式:存储层读数据 → 传给 SQL 层 → SQL 层计算。
列存引擎:存储层直接计算,结果才传给 SQL 层。
能下推的操作包括:
-
过滤下推:WHERE 条件在存储层直接过滤
-
聚合下推:MAX / MIN / SUM / COUNT / NDV 在存储层直接计算
-
GROUP BY 下推:分组聚合在存储层完成
适用版本
-
OBServer 4.x(V4.3.3 及以上版本引入列存,V4.3.5 LTS 为推荐版本)
-
OBServer 2.x / 3.x 不支持列存功能
如果在操作过程中遇到问题,欢迎在评论区留言交流,后续我们会持续分享更多实战运维干货,记得 关注不迷路 ,下次见~

来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70047467/viewspace-3180885/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- JDBC 报错 No more data to read from socket 排查手册
- OceanBase 物化视图实践:增量刷新、并行调优、MLOG 机制拆解
- OceanBase ODP 主备租户读写分离配置指南
- OMS 4.3.2 迁移坑:OBOracle 同名 PK/UK 引发全量迁移错误
- 使用OceanBase物化视图时,你可能会遇到需要考虑的场景决策
- 性能暴涨2000倍!OceanBase 4.4.2.1 解决分区DDL业务雪崩难题
- OceanBase 4.3 适配 gh-ost 在线无锁 DDL 指南
- 海量数据迁移神器: OceanBase 分区交换(Exchange Partition)
- OceanBase SSL 传输链路加密配置与排错全指南
- OceanBase 报‑5188/1499?分区数超限排查与优化指南
