在金融机构的风险管理与声誉保护工作中,基于传统关键词匹配的舆情监测模式正面临严峻挑战。自媒体账号的批量搬运容易引发告警风暴,而同名企业、模糊简称造成的误报,也常使风控与公关团队陷于无效核查。
随着大语言模型与智能体(Agent)技术的引入,舆情管理正从“被动接收信息”转向“主动研判预警”,但在实际工程落地中,一套可落地的券商舆情智能体,其核心价值不在于单纯用大模型生成摘要,而是前端能否精准完成信息去重、主体消歧与风险定性,后端能否将带有完整凭据的线索接入既有的权责流转体系。
今天我们从业务分流、去重机制、主体识别、结构化提取、系统治理与验收评估六个维度,探讨券商舆情智能体的工程架构设计。
一、 业务划界:区分自身声誉与外部关联主体风险
构建舆情智能体的首要工作,是在业务逻辑层划清监测对象与响应流程。
证券公司的舆情线索天然存在两条独立的业务主线:
- 券商自身声誉风险:涵盖服务争议、系统异常、员工违规等事项。依据中国证券业协会发布的《证券公司声誉风险管理指引》,这类事件直接关联机构自身的品牌形象与合规责任,需建立专班研判与分级响应机制。
- 外部关联主体风险:涵盖持仓上市公司、债券发行人、客户及交易对手方的司法纠纷或财务危机。金融机构需将这些关联主体的风险纳入信用风险与存续期管理体系,防范履约违约传导。
两类业务可以共用底层的数据采集能力,但智能体的预警规则与接收部门必须保持隔离。若智能体将外部发行人的履约负面新闻误判为券商自身的公关危机,不仅会打乱响应节奏,也会增加不必要的管理消耗
二、 数据清洗:基于事件聚类的同源去重
在流式数据接入阶段,最常见的干扰是一篇爆料经多个自媒体搬运后引发的重复告警。

在技术处理上,传统的精确哈希指纹(如 MD5)仅能识别完全相同的文本,而基于词频重叠的近似指纹(如 SimHash)能发现局部改写。但在实际场景中,自媒体常采用更换标题、引用截图、段落重排或二次转述等手段,仅靠文本相似度算法难以准确判断各篇报道是否指向同一事实。
智能体在数据清洗环节的核心,在于实现 事件级聚类:
1、 同源转载合并:识别不同账号是否引用了相同的原始出处或关键证据截图,将其合并至同一传播链条,仅统计扩散频次与传播烈度,避免重复推送告警。
2、 独立事件保留:若不同用户在不同时间反映了相似的业务异常,即使文本表述高度接近,系统也需保留为独立事件,防止遗漏真实的系统性风险线索。
三、 主体消歧:基于多维信息与时空背景的交叉验证
金融语境下的主体识别有着极高的精准度要求,以常见的企业名称为例,某一自媒体文章中提及的“金科”,既可能是上市公司“金科股份”,也可能是同在环保领域的“金科环境”,抑或是某家未上市的区域性小微企业。若仅凭字面名称进行正则匹配,极易产生大量无效预警。

对于上市公司与公开发行债券的主体,证券代码与统一社会信用代码是确定的映射依据;,而对于非上市交易对手或私募客户,智能体需要建立多维交叉验证机制:
- 多字段关联比对:提取文本中提及的地理位置、法定代表人、核心业务及关联上下游等要素,与机构内部的客户数据库及知识图谱进行综合比对。
- 时空动态映射:结合事件发生的时间节点,匹配当时的股权关系与商号变迁,避免使用当前的主体架构去套用历史事件。
- 候选列表与待确认机制:当上下文信息不足以给出高置信度结论时,智能体不强行推断,而是输出按可能性排序的候选名单,引导人工接入完成确认。
四、 事件抽取:从情感分类迈向结构化风险定性
早期的舆情系统多依赖通用情感分析接口,将“负面情绪得分高”简单等同于“高风险”。然而在金融场景中,语气激烈的自媒体帖子可能缺乏事实依据,而一则语言平实的官方公告或司法冻结告知书,却往往蕴含重大违约风险。
参考 DuEE-Fin 等金融领域事件抽取的工程实践,智能体应将核心能力集中于 结构化事件提取,将非结构化段落解析为标准化的业务字段:
- 风险主体:明确风险暴露的具体对象(如:某上市公司)。
- 事件类型与关键要素:识别具体事项与量化规模(如:股权冻结,涉及金额 2.3 亿元)。
- 证据等级与业务关联:标记信息来源的权威度及券商的业务关联(如:官方公告 / 资管计划持仓)。
- 风控响应规则:匹配内部风控触发条件(如:触发信用风险 A 类预警)。
通过将非结构化文本转化为这种高密度的结构化数据,智能体能够无缝对接风控系统的定量规则,实现基于风险实质的精准告警。
五、 预警交付:凭据追溯与流程治理嵌入
智能体生成的预警报告,是连接前端数据提取与后端业务处置的纽带。一份符合金融合规要求的报告,关键在于凭据的“可解释”与“可追溯”。
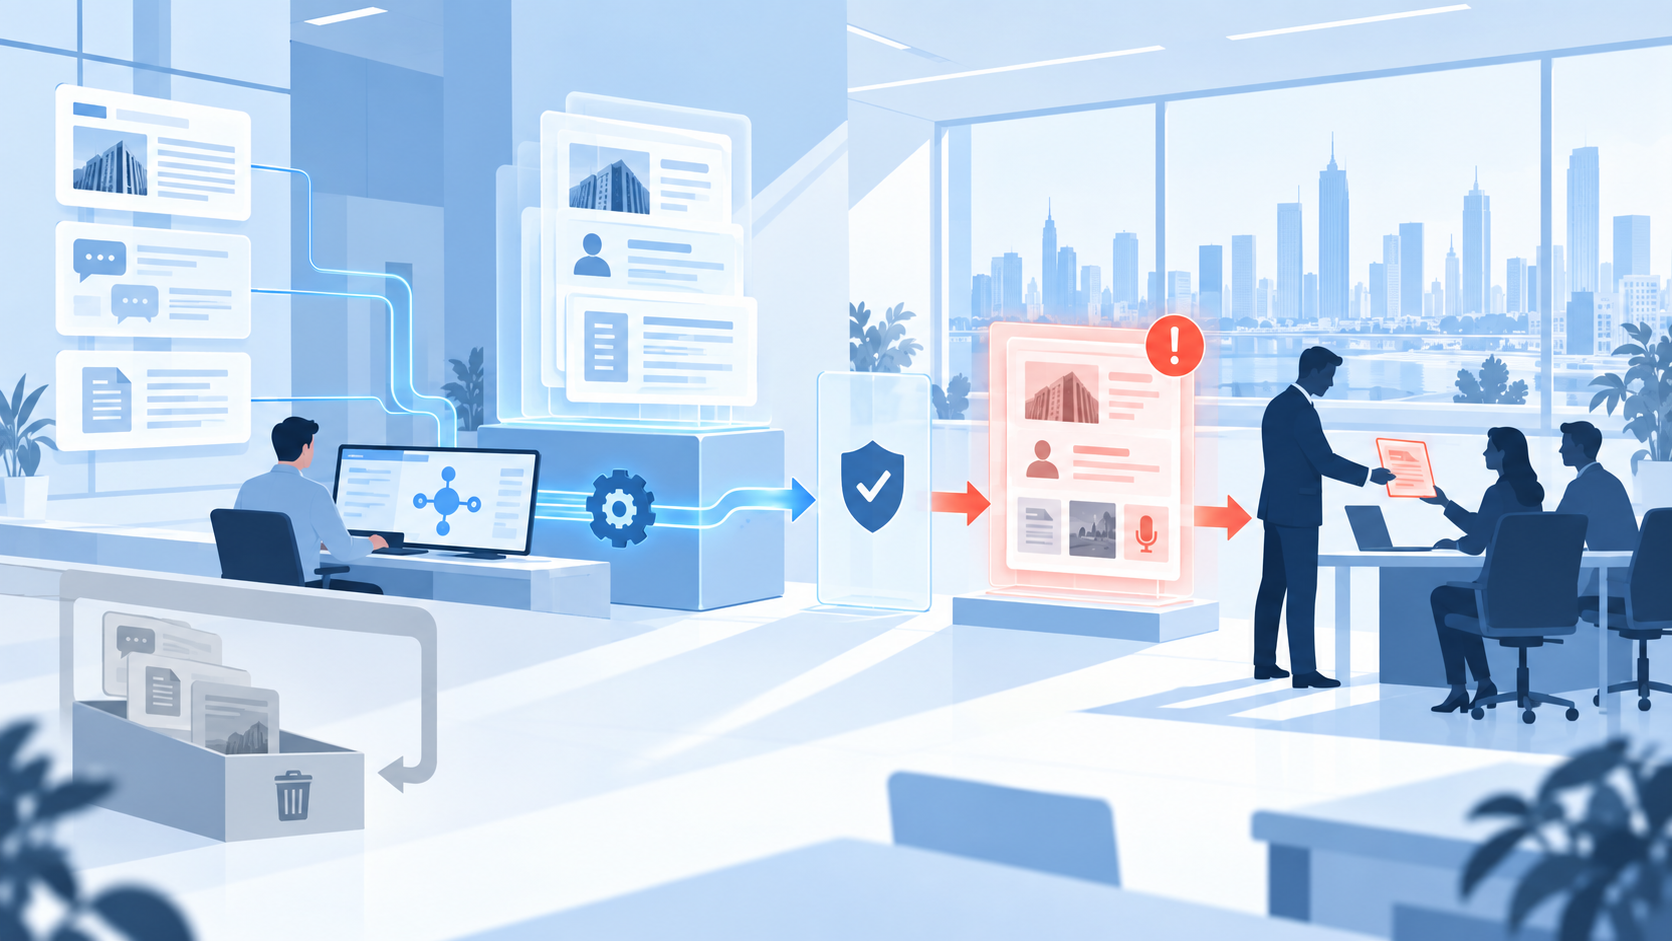
报告需要清晰呈现事实推导过程,区分“原始出处主张”、“官方公开披露”与“模型推断结论”。对于存在争议的信息源(如自媒体爆料与企业澄清),报告应保留分歧并予以标注,避免模型强行平滑矛盾。报告中的每一项关键结论,均应提供可跳转至原始网页或授权存档证据片段的锚点。
在系统流转方面,当前金融智能体的落地普遍采用“大模型负责理解提取、流程系统负责治理约束”的架构设计:
- 通用智能体平台路线:微软 Copilot Studio、IBM watsonx Orchestrate 等平台重点在于提供统一的智能体编排与安全管控边界。
- 流程自动化演进路线:以金智维为代表的企业级服务商,则倾向于将智能体深嵌于机构已有的流程自动化与审批体系中。智能体作为高效的“受监督流程助手”,负责完成多源数据的实时抓取、事件提取与报告草案生成;而后续的风控告警触发、权益调整或公关回应,仍需经由严格的岗位权限隔离、日志审计与人工复核流程,确保决策与执行过程的合规可控。
六、 评估验收:券商舆情智能体的评价指标体系
评估一套券商舆情智能体在生产环境中的应用价值,不能仅看数据采集总量或报告生成速度,而应建立涵盖准确性、工程化与响应时效的综合评估体系:
- 主体消歧准确率:评估系统在同名企业、模糊简称及集团关联关系上的识别准确度。
- 事件聚类准确率:测试系统对同源转载的合并能力,以及对不同时间、不同来源独立事件的拆分精准度。
- 风险事件召回率与误报率:在历史标注数据集上,检验高风险事件的漏报率及低价值噪声的拦截效果。
- 证据可追溯率:抽查预警报告中的主体、事件、金额和时间节点能否 100% 还原至原始数据源或授权证据片段。
- 全链路响应时效:统计从信息被抓取发现、智能体完成研判,到最终推送至责任人工作台并完成复核的总耗时。
建立并关注这五项评估指标,能够帮助金融机构摆脱“被动应对噪声”的困境,推动舆情管理真正成为主动风控与声誉治理的有效手段。
从“海量监测”到“精准风控”,券商舆情智能体的设计过程,本质上是一场将非结构化网络信息转化为确定性业务决策的工程重构。
大语言模型赋予了系统理解自然语言与复杂上下文的灵性,但金融场景对合规、审计与风控的极 致要求,决定了智能体不能孤立地作为文本生成工具存在。真正能够为机构创造价值的舆情智能体,必须建立在严密的主体消歧与事件抽取之上,并深度融入企业现有的流程治理与权限边界之中。
唯有将大模型的感知认知能力,与流程自动化的确定性治理规则有机结合,金融机构才能真正从“被动应对舆情噪声”走向“主动掌控风险全貌”,在保障合规安全的同时,让数字化智能化工具真正转化为生产力。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70047400/viewspace-3187464/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 企业AI Agent平台换模型需要重建流程吗?ERP集成、权限审计与迁移成本分析
- WorkBuddy如何结合RPA处理财务业务?对账成本、数据安全与企业级流程治理
- 财务共享中心如何部署AI智能体?票 据审核、银企对账与跨系统自动化选型
- 企业AI Agent项目如何评估ROI?现金收益、产能估值与长期运维成本
- 制造企业AI Agent如何落地?ERP/MES/WMS集成、厂商选型与投资回报评估
- 金融机构AI Agent如何通过生产准入评估?数据安全、权限治理与审计追溯
- 企业智能体Token成本如何优化?RPA流程复用、任务执行与运行成本治理
- WorkBuddy结合RPA如何对接ERP、CRM、OA?企业权限治理与执行审计要求
- 企业智能体运行成本如何评估?任务成功率、执行资源与单位成功任务成本
- 企业智能体如何避免ERP、CRM数据错配?主数据治理、业务口径与权限一致性
