销售查询某个客户还能赊销多少,系统往往需要同时拿到几类信息。授信制度可能在知识库,客户主体和集团关系在CRM,额度及占用情况在ERP或其他业务系统,临时调整还可能挂在审批流程里。
如果CRM使用客户简称,ERP按照法人主体建档,同一集团下面又有多家公司,客户匹配就可能先出错。即使主体对上了,接口刚刚返回的数据也可能来自昨晚更新的报表。制度、客户、额度、占用,每一项都可能是真实数据,组合起来仍然可能给出错误结果。
RAG负责取得制度、合同和业务知识,ERP、CRM提供当前业务记录,主数据负责对齐客户和组织,权限体系限制可访问范围。中国信通院在《数据要素发展报告(2025年)》中也把高质量数据供给、数据治理和AI应用放在同一条链路讨论,企业面向AI的供数已经覆盖结构化、半结构化和非结构化数据。到了具体业务里,规则版本、客户主体、字段口径、数据时间和当前权限都会影响最终答案。
一、知识检索要带上适用条件
制度、合同、产品资料进入知识库后,语义检索可以很快找到相关内容,实际业务里,同一份资料经常还附带部门、地区、客户类型、合同、时间等限制条件,物流计费和制度版本,就是两个比较典型的情况。

物流计费
同一套规则可能覆盖不同运输方式、货物类型、路线距离和退货状态。当前运单使用哪一条,需要把这些业务字段一起带入判断。长期从事流程自动化和数字员工的金智维,在其供应链场景中就采用过“知识库语义检索+提示词限定匹配”的方式,将运输方式、货物类型、路线距离、是否逆向退货等条件纳入运单计费规则匹配。知识检索先找到候选规则,再由业务条件继续缩小适用范围。
制度版本
今天上传到知识库里的文件,可能只是旧制度扫描件;一个月前发布的制度,只要尚未失效,今天仍然有效;处理历史交易时,还可能需要调取当时有效、目前已经废止的版本。文件形成时间、入库时间、生效时间和业务发生时间因此需要分开处理。
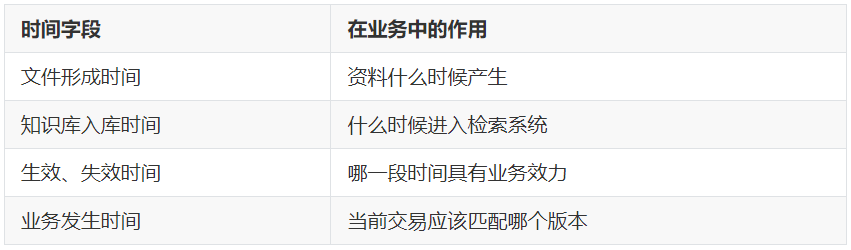
企业知识库做到业务层以后,机构、地区、制度类型、生效区间、合同类型等元数据都会参与检索范围控制。语义相似度负责找到候选内容,业务条件继续筛选。
二、数据时点与业务口径
库存、订单、应收余额这类信息通常来自ERP、CRM或其他业务系统。下午14:00查询库存,接口立即返回100件,如果底层读取的是每天凌晨更新的报表库,这100件反映的仍然是前一个数据周期。
一条业务数据通常会同时带着三种时间信息:
- 提问时间 用户什么时候需要这个结果。
- 查询时间 智能体什么时候访问系统。
- 数据更新时间 返回记录实际更新到什么时候。
订单、客户状态、应收和经营报表都可能经过缓存、异步副本或数据仓库加工,查询发生在现在,数据未必更新到了现在。知识库也有自己的更新过程,文件上传之后还要经过解析、处理和索引;制度被替换、撤销或删除以后,旧内容也需要从后续检索中退出。只增加新资料、不处理旧版本,已经失效的制度仍可能进入答案。
库存和授信还涉及字段口径,库存系统里常见的几个字段,就可能对应不同业务状态:
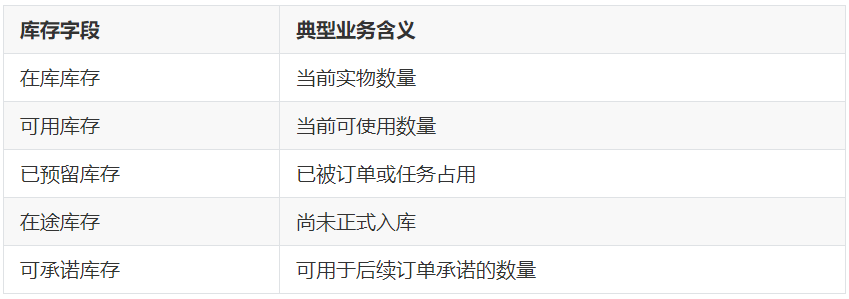
销售判断一笔订单能否承接时,通常要看可承诺库存,仓库盘点则更关心实物在库。授信额度同样需要沿用企业已经确定的业务规则,哪些金额计入占用、冻结怎么处理、临时额度是否已经生效,都不能临时由模型组合。
三、跨系统数据先对齐业务主体
CRM、ERP、合同和财务系统里的同一个业务对象,经常使用不同名称和编码,客户如此,物料也一样。
2025年,国家能源集团物资有限公司与中国信通院围绕物料主数据开展RAG与大模型融合治理,处理的就是存量重复数据识别、智能分类和特征参数校验等问题。放到客户数据里,对应的也是同一类基础工作:先把业务对象、编码和属性关系理顺,再让智能体继续调用后面的额度、应收、合同和订单数据。
集团下面存在多家公司时,名称越相似,自动拼接越容易出错。假设CRM返回A集团华南公司,ERP命中了A集团总部,应收系统又按照简称找到另一家子公司,几个字段都来自真实系统,最后仍可能拼成错误的客户状态。
企业过去建设主数据体系,本来就在处理这类关系,智能体接入以后,客户唯一ID、统一社会信用代码、法人主体、集团归属、ERP往来单位编码等信息会直接影响回答质量。
主体一旦匹配错误,后面的额度、应收、合同和订单都可能跟着错位。
四、权限变化要同步到查询结果
员工昨天能够查看某个客户,今天发生调岗,CRM里的权限已经收回,如果智能体仍然沿用此前缓存的结果、知识索引或历史会话,旧数据就可能继续出现在新的回答里。

企业内部的知识库、CRM、ERP和文件系统通常各有权限体系,智能体把这些系统接到同一个入口后,原来的授权关系仍然需要继续生效。
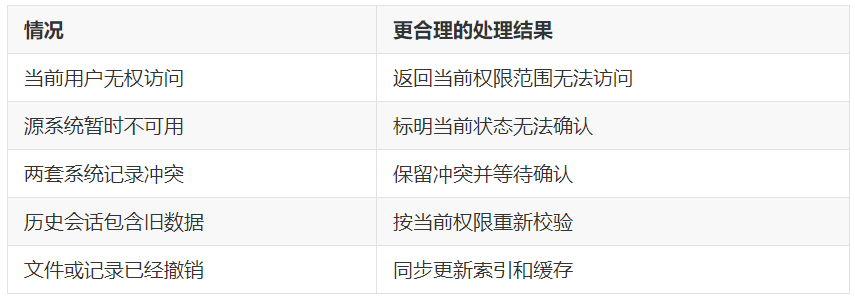
“查不到”和“不能看”对应的是两种不同状态,前者可能来自数据缺失或系统不可用,后者来自授权限制,后续处理路径也不同。
在企业级智能体平台里,这一层通常还会继续延伸到工具调用和执行权限。以长期服务金融、政企等强治理场景的金智维为例,其Ki-AgentS支持分级权限、执行隔离、日志审计、实时监控和人工暂停,用来约束智能体能够访问什么数据、调用什么工具,以及执行到哪一步需要人工接管。
五、知识库与业务系统协同运行
授信、物流、库存这几类问题放在一起看,企业智能体处理的本来就是多种数据源。
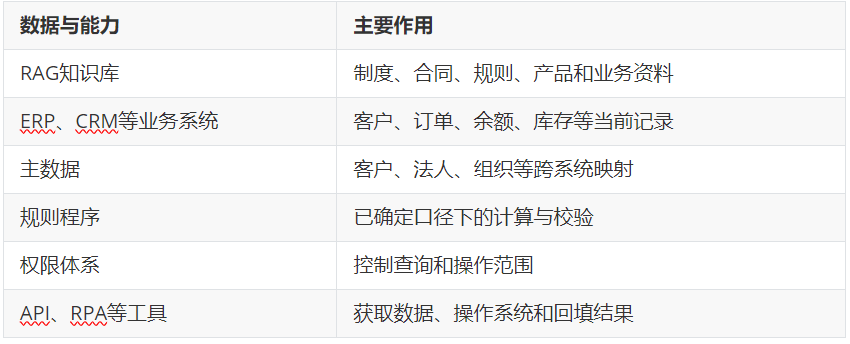
这种“知识+业务数据+工具”的组合,现在已经进入企业级智能体产品,中国信通院与华为联合发布的《智能体技术和应用研究报告(2025年)》中,华为Data Agent就把结构化、非结构化数据、知识库、元数据、数据权限和查询分析放在同一架构里,并通过SQL、Excel等工具处理企业数据。
另一类路线来自原本就做跨系统流程自动化的厂商,长期处理ERP、CRM、网页和桌面系统连接的金智维,进入企业级智能体阶段后继续复用已有API和RPA流程,Ki-AgentS可以调用企业知识库、API、RPA和已有流程,原有自动化资产仍然承担具体系统操作。
这里的分工仍然落在企业已有系统上,制度和合同保存业务依据,ERP、CRM提供当前记录,主数据维护对象关系,权限体系控制访问范围,智能体负责把这些信息组织进同一任务。
六、业务数据出错集中在五个环节
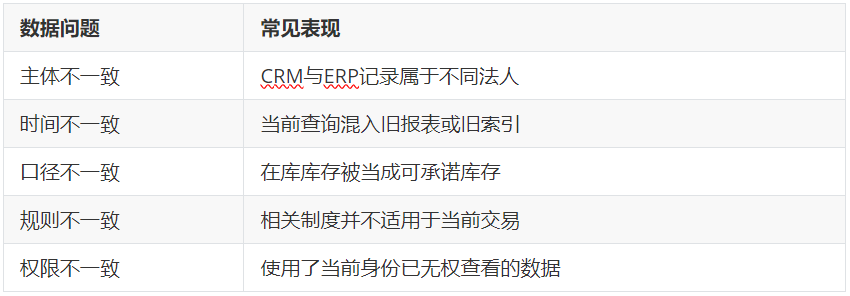
企业智能体进入业务系统以后,一条答案里可能同时出现制度、业务记录和计算结果,长期运行中,数据问题通常集中在这五个位置:
- 规则版本 当前交易使用的是哪一版制度、合同和业务规则。
- 数据时点 数值实际更新到什么时候,是否满足业务需要。
- 主体关系 CRM、ERP和合同系统是否对应同一个客户或法人主体。
- 指标口径 库存、余额、额度等字段使用的是哪套业务定义。
- 授权范围 当前用户具有哪些数据访问和操作权限。
测试时可以加入制度撤销、客户重名、源系统超时、旧缓存命中、员工刚刚调岗、记录已经删除等情况,这些状态更容易暴露企业智能体长期运行后的数据问题。
当规则版本、业务主体、数据时间和访问范围能够随着数据一起保留下来,知识库里的规则和ERP、CRM里的业务状态就不会在生成答案时被混成一团。企业智能体最终呈现的是一段自然语言,但这段话背后,仍然对应着不同系统、不同时间和不同业务边界。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70047400/viewspace-3185875/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 企业AI Agent平台换模型需要重建流程吗?ERP集成、权限审计与迁移成本分析
- WorkBuddy如何结合RPA处理财务业务?对账成本、数据安全与企业级流程治理
- 财务共享中心如何部署AI智能体?票 据审核、银企对账与跨系统自动化选型
- 企业AI Agent项目如何评估ROI?现金收益、产能估值与长期运维成本
- 制造企业AI Agent如何落地?ERP/MES/WMS集成、厂商选型与投资回报评估
- 证券公司如何建设智能舆情预警系统?数据清洗、主体识别与风控系统集成
- 金融机构AI Agent如何通过生产准入评估?数据安全、权限治理与审计追溯
- 企业智能体Token成本如何优化?RPA流程复用、任务执行与运行成本治理
- WorkBuddy结合RPA如何对接ERP、CRM、OA?企业权限治理与执行审计要求
- 企业智能体运行成本如何评估?任务成功率、执行资源与单位成功任务成本
