云轴科技ZStack AI翻译平台建设实践-聚焦中英
(一) 前言
面对全球化商业竞争,企业出海亟需高质量翻译支持,包括不限于产品 U I 、技术文档、营销资料等面向出海国语种的全线配备。当下 AI技术蓬勃发展,如何利用A I 深度赋能提升翻译质量?如何将翻译工作流形成标准化工具链?如何构建切合实际场景的质量评估体系?这些都是企业翻译业务面临的现实挑战。
本文主要聚焦中英场景,从 Z S tack文档实践出发,围绕本地模型部署与精调、一站式A I 翻译平台设计思路、实际建设难题与攻克等要点,向大家全面深入介绍 Z S tac k AI 翻译平台建设的成功实践。
(二) 本地模型部署与精调
当下 ,以ChatGPT为代表的大语言模型 ( LLM )在 通用翻译 领域 已展现出强大能力。借助零样本学习 ( Zero -shot)和提示词工程 ( Prom pt E ngin eerin g , PE ) ,LLM能够处理绝大多数日常语言的互译任务,其流畅度和上下文理解能力远超传统机器翻译系统。
然而,当场景切换至专业领域翻译 (如 云计算 软件 文档 ) ,通用 L LM立即暴露出明显 短板: 无法理解企业 特定 术语体系和表达规范 。
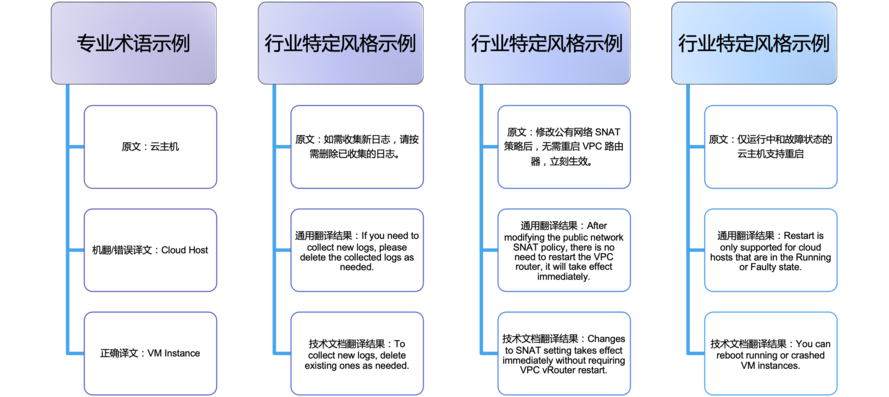
图 1 . 通用 L LM 的翻译短板
为应对上述挑战 ,ZStack 采取 “基础模型+领域精调”技术路线,通过 以下 五个关键环节构建专业翻译能力 。
1. 数据准备
模型 精调的 效果高度依赖训练语料的质量。ZStack构建 了 分层次、高标准的语料筛选体系,语料来源分布确保核心 技术 文档(如用户手册)占比50%、产品UI界面文字(如界面提示语)占比不低于40%、辅助 技术 文档(如实践教程)占比10%,并且所有双语语料均需通过术语准确性、风格一致性、技术深度、场景覆盖度等维度的严格审核。
2. 模型选择
选用Qwen2.5-7B-Instruct作为基础模型,该开源模型在保持7B参数规模适中性的同时,展现出良好的多语言处理能力和架构扩展性。
3. 模型精调
采用 LoRA(Low-Rank Adaptation)等参数高效精调技术,在单张NVIDIA 3090显卡上即可完成训练,大幅降低计算资源需求。
4. 模型评估
评估体系结合量化指标与人工质检, 采用 BLEU、ROUGE、COMET等自动评估工具,配合专业英文文档工程师审核,形成多维质量评估矩阵。
5. 模型迭代
为确保模型能力与业务需求同步进化,采用 “3+1”迭代模式 (即: 3个月语料筛选+1个月模型调优与质检 ), 结合数据更新与评估反馈进行持续优化。

图 2. 精调 L LM 的五个关键环节
(三) ZStack AI 翻译平台整体设计思路
如何将精调 L LM 与翻译工作流有机整合,是下一个需攻克的难点。
ZStack AI 翻译平台基于 ZStack AIOS智塔平台 构建, 整合了从 A I基础设施到应用接口的全栈能力 ,内接 Z S tack专业语料库+精调L LM ,提供一站式翻译管理服务。
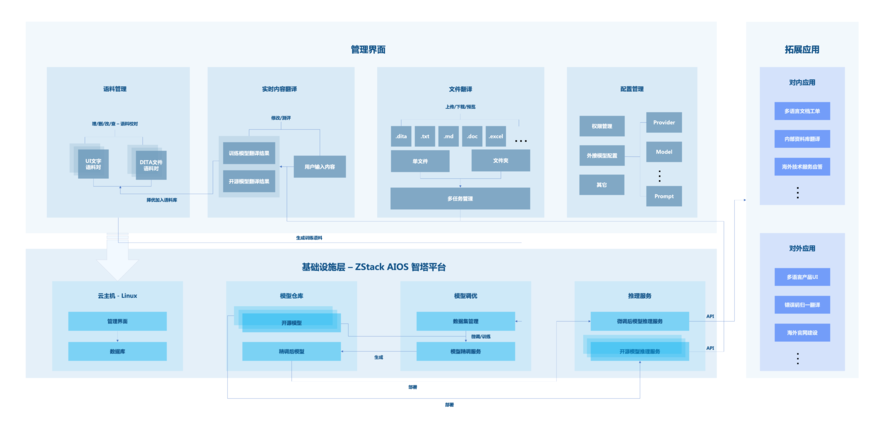
图3. 整体设计框架
1. 基础设施层
整合 了 模型仓库、模型调优、推理服务和数据管理组件。
-
模型仓库集中管理AI模型,提供预置模型和自定义模型。
-
模型调优工作台支持基于数据集的参数精调。
-
推理服务提供模型快速部署到生产环境的能力。
-
数据管理组件通过云主机对外提供翻译平台的管理界面和数据库服务。
2. 核心功能层
包含 了语料管理、实时内容翻译、文件翻译、配置管理 四大核心模块 。
-
语料管理持续收集优质双语资源。
-
实时内容翻译提供自训练模型和外接模型,支持翻译结果对比,优质翻译可一键加入语料库,形成数据闭环。
-
文件翻译支持.dita、.txt、.md、.doc、 . excel等格式文件的单个/批量翻译,提供翻译进程管理与翻译结果在线预览。
-
配置管理提供权限管理、外部模型接入设置等运维能力,确保系统灵活可控。
3. 应用接口层
通过标准化API对接 企业 内外部业务系统 ,提供翻译赋能。
-
对内支持 文档 工单 翻译 、内部知识库翻译、海外技术服务应答等。
-
对外 支持 产品UI 翻译 、错误码归一翻译、海外官网建设等。
(四) ZStack AI 翻译平台实际建设难题与攻克
1. DITA 文档的 分割与重组
考虑到 L LM在结构化文本理解和层次化内容处理 上的 固有能力, 在 构建DITA语料库 过程中采取 格式保持策略,完整保留DITA 文档 的原始内容结构与标记信息。
相较于传统纯文本翻译流程, 上述方法 显著减少标记对、属性值、内嵌代码块等格式化元素和引用信息的后处理工作量, 从而降 低整体翻译任务 的 复杂度。然而,受制于模型的Token长度约束,仍需对超长 文件 进行合理分割,以避免LLM输出截断等异常情况发生。
考虑到翻译场景中词汇和句子语义高度依赖上下文信息,在DITA 文档 分割过程中 采取段 落级分割策略,最大程度避免产生孤立词汇、独立句子或句子截断的情况。
鉴于此, Z S tack自研 一套自适应分割算法,将长篇DITA 文档 动态分解为满足上述语义完整性要求的多个子 文件 片段。这些分割后的DITA片段将依次输入到训练 后的 LLM中进行处理,最终将翻译结果进行结构化整合。
2. 多重机制保障结果准确性
考虑到 LLM基于概率生成的工作机制导致输出结果存在固有的不确定性,以及DITA 文档 必须严格遵循类XML格式规范, 平台 构建多层次质量保障体系 以 确保翻译结果的准确性和可靠性。
1) 训练 数据质量控制层面
考虑到训练 数据 质量直接影响模型质量, 采取人 工质检与AI质检相结合的双重质量控制机制。 一方面,训练语料需通过 专业英文文档工程师 审核,另一方面, 通过 提示词 工程结合指令微调 技术 ,确保模型输出专注于翻译结果本身,排除思维过程、总结性文本等非翻译内容的干扰。
2) 模型输出质量保障 层面
针对DITA结构完整性, 平台提供 多级重试机制。当翻译结果不符合XML结构规范时,系统 将 自动调整参数进行二次尝试;如果结果 仍不符合规范 , 将 对原 文件 进一步分割后重新翻译 。 在极端情况下,系统会调用更大规模的模型进行处理。 针对 DITA内容准确性, 平台下一步将 部署AI质检系统,对翻译内容进行二次验证。
3. 提示词 工程
文档翻译作为高度专业化应用场景,要求系统将所有输入文本严格视为翻译源材料,而非对话交互内容。在训练阶段,通过系统提示词 结合 指令微调技术,使模型深度理解翻译任务的执行指令,实现 “纯翻译、零对话”行为模式。值得注意的是,即使训练 阶段 仅使用中英翻译提示词,模型 在 推理 阶段 对英中翻译指令的理解同样保持高度准确性。
训练与推理是相互协同的过程。为优化训练 与 推理的时间效率,降低系统提示词的Token消耗至关重要。在训练 与 推理阶段, Z S tack 致力于构建精简而完备的 提示词描 述体系,涵盖翻译风格、输出格式、特定规则等关键要素,使 模型 在 训练 阶段逐步掌握翻译任务的偏好配置,并在推理阶段达到预期效果。鉴于 模型 已具备丰富的基础知识储备,部分 提示词 可采用通用性描述,无需过度细化,例如“保持XML结构输出 ” 即可实现预期效果。
(五) ZStack AI 翻译平台价值
1. 统一管理、直观便捷
ZStack AI翻译平台提供统一的可视化管理界面, 支持 一站式维护训练语料、实时翻译文本内容、创建文件翻译任务、跟进翻译进程及结果。对于翻译失败的任务,可直接查看任务日志,快速定位问题。
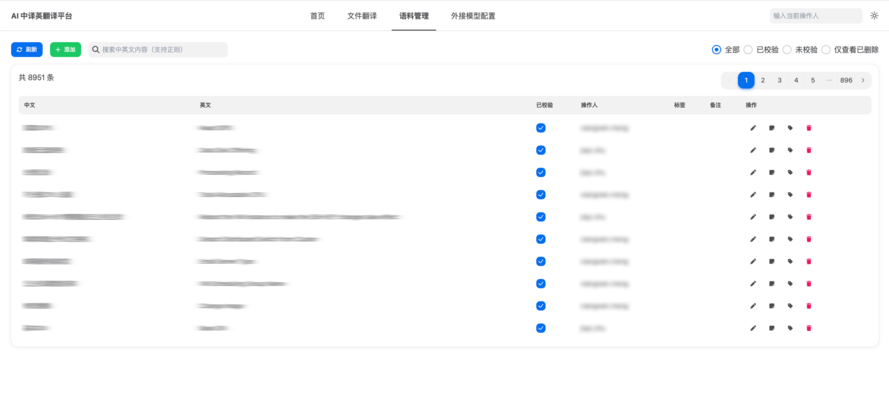
图4. 语料管理界面

图5. 文件翻译界面
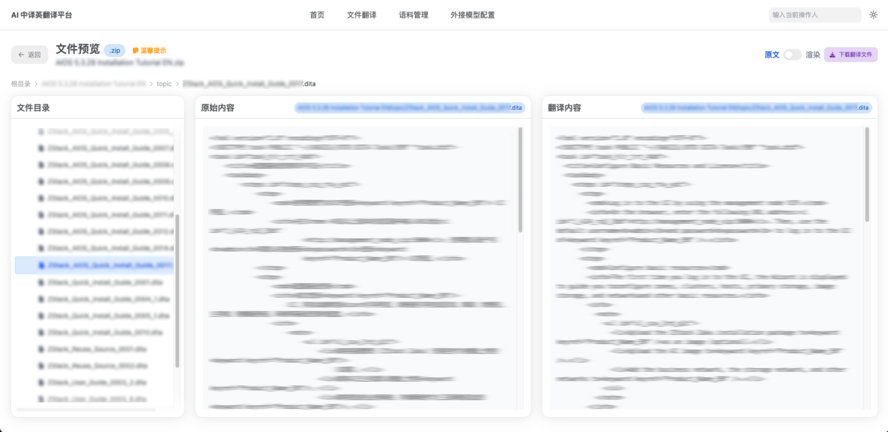
图6. 翻译结果预览

图7. 查看 任务 日志
2. 灵活拓展,赋能提效
ZStack AI翻译平台通过标准化API 接口,支持 对接 各种 业务系统 ,提供翻译赋能。例如,将平台对接 i18n系统,一键翻译 产品U I 界面文字,配合人工质检, 加速产品UI 翻译交付 效率。
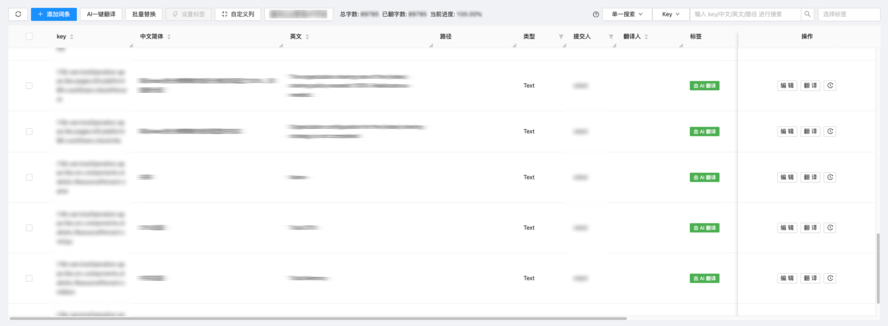
图8. 对接i18n系统
(六) 结束语
为应对全球化挑战, Z S tack文档一直致力于专业领域翻译技术的创新与实践。从L LM 领域精调到 Z S tack A I 翻译平台构建一站式翻译服务,不仅提升了翻译的准确性与专业性,而且深入实际业务场景,将翻译工作流形成标准化工具链。未来我们期待与更多同行者一起探索,进一步推进专业领域翻译技术向前发展。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70044221/viewspace-3092669/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- GPU 利用率提升 1.3 倍:ZStack AIOS 帮助企业高效盘活异构算力
- 老系统也能接 Agent:ZStack Zentrix 帮助企业盘活存量业务能力
- 推倒重建是死路:运营商云底座的 AI 化,只有平滑演进这一条路
- 开发者在用“打折Claude”,IT 部门知道吗?AI 网关把模型接入管起来
- AI 上场后,写文档的人开始造系统
- ZStack AIOS 完成昇腾 910C 全链路适配!国产高端算力生态再升级
- 医疗信创落地:VMware 替代中的业务连续性与 AI 发展的双重挑战
- 从传统业务到 AI 承载:国产化平台选型要注意的四个新标准
- 虚拟化观察 第 001 期:VMware Explore 2026 开幕,Proxmox VE 8 正式 EOL
- 内存/硬盘一年涨了 3 倍多,一体机“脱保”的账该重新算了
