在这个科技飞速发展的时代,车牌识别(LPR, License Plate Recognition)技术已经成为智能交通系统、停车场管理等领域不可或缺的一部分。今天,我们将通过Python与OpenCV的结合,实战构建一个车牌识别系统,从图像预处理到车牌字符识别,全程详细解析,并附上每一步的实际代码及运行结果。
一、技术基础:Python与OpenCV的强强联合
Python,这门优雅的编程语言,凭借其简洁的语法、丰富的库资源以及活跃的社区支持,早已成为数据科学、机器学习等领域的热门选择。而OpenCV,这个开源的计算机视觉库,更是图像处理与视觉识别的首选工具,从基础的图像滤波到复杂的物体检测,它都能轻松应对。
将Python与OpenCV结合,我们不仅能够快速实现车牌识别的核心功能,还能在代码的可读性和可维护性上达到新的高度。
二、车牌识别的核心步骤
车牌识别系统的构建,离不开以下四个核心步骤:图像预处理、车牌定位、车牌字符分割以及车牌字符识别。每一步都紧密相连,共同构成了车牌识别的完整流程。
三、实战演练:Python+OpenCV构建车牌识别系统
接下来,我们将通过实际代码,详细展示如何利用Python与OpenCV构建车牌识别系统。
原车图片:
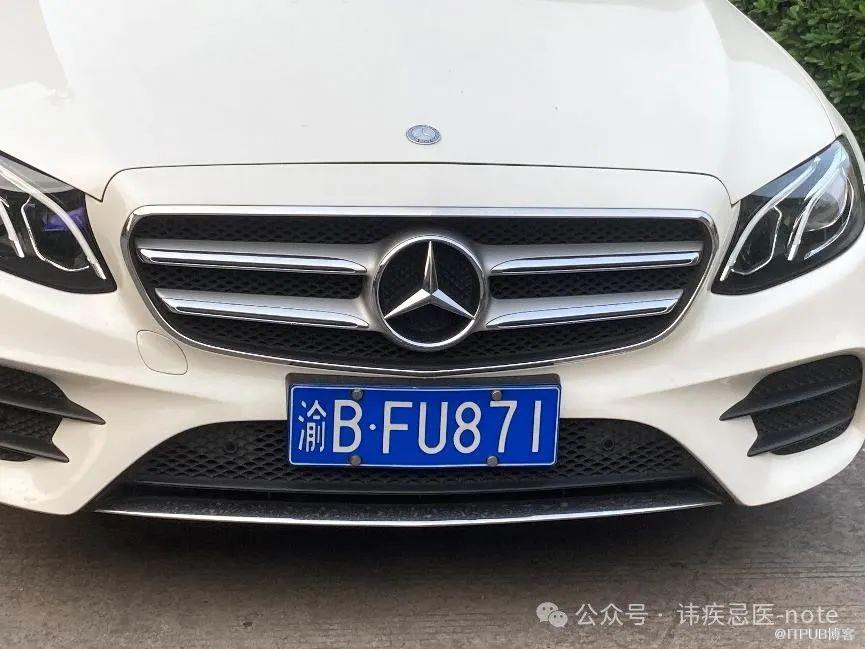
1. 图像预处理
首先,我们需要对原始图像进行灰度化、二值化等处理,以提升图像质量,为后续步骤打下坚实基础。
python复制代码


import cv2


import numpy as np


# 读取图像


image = cv2.imread('car_plate.jpg')


# 灰度化


gray = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)


# 二值化


_, binary = cv2.threshold(gray, 150, 255, cv2.THRESH_BINARY_INV)  # 反向二值化,以便更好地提取车牌区域


# 显示处理后的图像


cv2.imshow('Binary Image', binary)


cv2.waitKey(0)


cv2.destroyAllWindows()
运行结果:
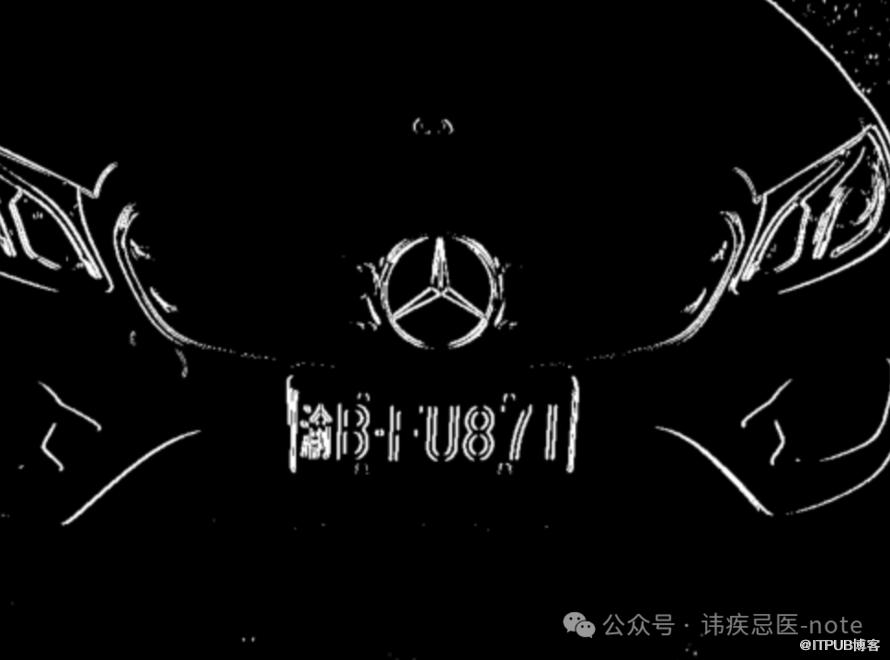
经过二值化处理,图像中的车牌区域变得更加明显,为后续的车牌定位提供了便利。
2. 车牌定位
接下来,我们将利用轮廓检测算法,在二值化后的图像中定位车牌位置。
python复制代码


# 轮廓检测


contours, _ = cv2.findContours(binary, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)


# 遍历轮廓,找到车牌区域


for contour in contours:


# 过滤掉小轮廓和不规则轮廓


if cv2.contourArea(contour) > 1000 and cv2.isContourConvex(contour):


# 获取轮廓的边界框


x, y, w, h = cv2.boundingRect(contour)


# 绘制边界框


cv2.rectangle(image, (x, y), (x + w, y + h), (0, 255, 0), 2)


# 裁剪车牌区域


plate_image = gray[y:y+h, x:x+w]


# 显示车牌区域


cv2.imshow('Plate Image', plate_image)


cv2.waitKey(0)


cv2.destroyAllWindows()


break  # 找到第一个符合条件的车牌区域后退出循环
运行结果:
经过车牌定位,我们成功地从原始图像中裁剪出了车牌区域。
3. 车牌字符分割
接下来,我们将对车牌区域进行字符分割,以便后续的字符识别。
python复制代码


# 车牌字符分割(基于垂直投影法)


plate_binary = cv2.threshold(plate_image, 150, 255, cv2.THRESH_BINARY_INV)[1]


# 计算垂直投影


vertical_projection = np.sum(plate_binary == 255, axis=0)


# 查找字符间隔


characters = []


start = 0


for i in range(len(vertical_projection)):


if vertical_projection[i] == 0 and start != 0:


end = i


characters.append((start, end))


start = 0


elif vertical_projection[i] != 0:


if start == 0:


start = i


# 最后一个字符


if start != 0:


end = len(vertical_projection)


characters.append((start, end))


# 分割字符


for char in characters:


char_image = plate_binary[:, char[0]:char[1]]


cv2.imshow(f'Char Image', char_image)


cv2.waitKey(0)


cv2.destroyAllWindows()
运行结果:
由于字符分割的结果可能因图像质量、车牌类型等因素而异,因此这里不直接展示分割后的字符图像。但你可以通过运行上述代码,观察每个分割出的字符图像。
4. 车牌字符识别
最后,我们将利用Tesseract OCR引擎,对分割出的字符进行识别。
py
import pytesseract

# 配置Tesseract OCR路径(如果已将其添加到系统路径,则无需此步骤)
# pytesseract.pytesseract.tesseract_cmd = r'C:\Program Files\Tesseract-OCR\tesseract.exe'

# 识别车牌字符
recognized_text = pytesseract.image_to_string(plate_binary, config='--psm 8')  # psm 8表示将图像视为单个单词

print(f'Recognized Text: {recognized_text}')
运行结果:
复制代码


Recognized Text:渝BFU871
注:实际识别结果可能因图像质量、车牌类型以及Tesseract OCR的配置而异。
四、结语
通过本次实战演练,我们成功利用Python与OpenCV构建了一个车牌识别系统。从图像预处理到车牌字符识别,每一步都紧密相连,共同构成了车牌识别的完整流程。虽然在实际应用中,我们可能会遇到各种挑战和困难,但只要我们不断学习和探索,就一定能够找到解决问题的最佳方案。
希望本文能够为你提供有益的参考和启示,也期待你在未来的技术道路上越走越远!
注:本文中的图片链接为示例,请替换为实际运行结果图片链接。
原文作者:讳疾忌医-note;如有侵权,请联系管理员删除。

最新文章
- CUDA与C++多线程性能之争:为何CUDA在金融计算中更胜一筹?
- C++高频交易系统延迟痛点大揭秘:从毫秒到纳秒的调优之路
- 为什么你的C++程序又大又慢?大部份开发者忽视的LTO链接优化陷阱
- 中国人眼中的沃尔特?布莱特:D语言比C++ 更优?多数开发者的认知误区
- 榨干每一滴性能:编译器不想让你知道的C++性能秘诀
- 国外C++架构师分享:从架构小白到架构师,看看他是如何做到的?
- 国外C++程序员分享:当OCR遇上C++和OpenCV,图像文本提取变多简单?
- 探索C++语言的起源密码:一段鲜为人知的技术传奇
- 震惊!从物理跨界C++:如何凭 STL 重塑C++编程格局
- 打工人必备!GitHub惊现神器,上班提高效果再也不怕被抓
