
本文是经过严格查阅相关权威文献和资料,形成的专业的可靠的内容。全文数据都有据可依,可回溯。特别申明:数据和资料已获得授权。本文内容,不涉及任何偏颇观点,用中立态度客观事实描述事情本身。
文章结尾有最新热度的文章,感兴趣的可以去看看。
文章有点长(3542字阅读时长:5分),期望您能坚持看完,并有所收获
大家好,今天我继续给大家分享干货。熟悉我的人,都知道我真正的干货一般在中间和末尾部分(文章中间部分:有项目文字和视频介绍)。请耐心看完!谢谢。您可以在文章末尾处获取完整的源代码文件。

在如今金融市场变化极快的大环境里,交易决策往往就在那一瞬间发生了。对于券商来讲,期权定价系统的及时性跟交易的成败以及利润的多少有着直接的关联。想象一下,在市场行情剧烈波动的时候,倘若系统不能够及时地将准确的合约风险值给出,这样就有这样一种可能,即会让投资者错过良好的机会,甚至还得要去面对很大的损失。接下来我们就以某券商的期权定价系统为例,深入探讨传统C++代码在处理这类问题时的困境,以及如何通过CUDA与C++协同实现加速计算。
一、问题痛点:为什么传统C++代码跑不动风险模型?
场景描述
某券商的期权定价系统,承担着实时地去计算10万多份合约的风险值(像Delta以及Gamma这样的)这一重要任务。Delta所衡量的是期权价格针对标的资产价格变动所展现出的敏感度,而Gamma反映出的是Delta对于标的资产价格变动的敏感度。在交易的时候,投资者得按照这些风险值,赶紧把投资策略给调整了。不过原系统是以C++单线程来实现的,每次计算风险值,竟然耗费了15秒之久。不过市场的要求却是必须在5秒之内得出结果。这其间巨大的时间差距,使得该系统根本无法满足实时交易那种迫切的需求。
性能瓶颈分析
为了找出问题所在,我们使用性能分析工具生成了火焰图(数据来源:借助Linux系统下的perf工具结合FlameGraph脚本生成火焰图,多次运行系统以获取典型结果)。从火焰图中可以清晰地看到,CPU利用率一直处于100%的满负荷状态,这个时候内存频繁交换,Swap使用率高达30%。这表明系统的内存存在着极为严重的短缺情况,CPU只得频繁地,在内存与磁盘之间进行数据的交换操作,这种情况极大地,对计算速度产生了影响。另外期权风险值的计算涉及到Black - Scholes公式的迭代求解,这是一个计算逻辑极为密集的任务。单线程的C++代码根本无法充分利用CPU的多核性能,导致计算效率极其低下。
优化方向选择
在考虑进行优化方案的时候,多线程以及CUDA这二者是可供选择的两个方向。多线程技术一般适用于IO密集型的任务,它借助线程的切换以提升CPU的利用效率。但我们面临的是计算密集型任务,需要大量的并行计算。GPU具有千级线程并发的强大能力,对比之下,CPU的百级线程并发能力就显得捉襟见肘。因此选择CUDA来加速计算无疑是更为明智的决策。

二、优化方案设计:CUDA+C++协同架构
整体架构图
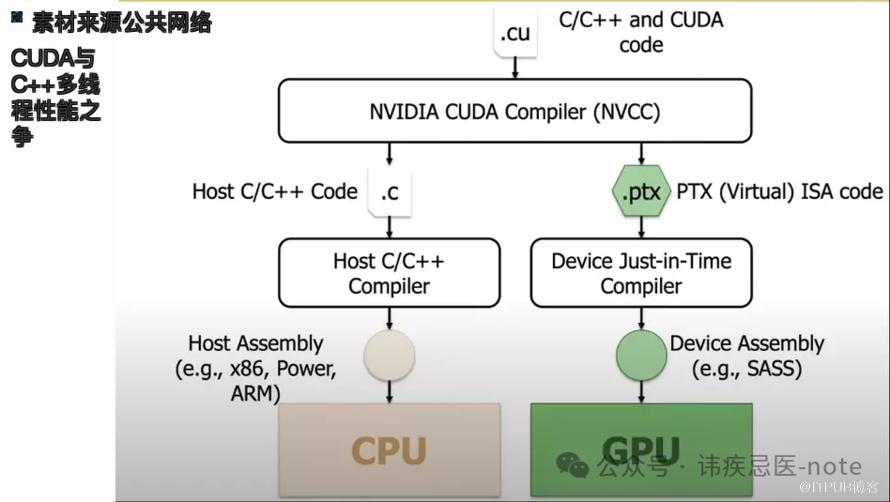
我们设计的CUDA与C++协同架构就像是一个分工明确的团队。CPU承担着逻辑控制的任务,主要针对合约数据展开预处理工作,像对数据进行读取操作,还有进行清洗以及格式化为特定形式等这些工作。GPU专门致力于并行计算,能够同时对10万以上的期权参数进行计算。为了减少数据在CPU和GPU之间的传输开销,我们采用了统一内存(Unified Memory)技术让数据的访问更加高效。
关键技术拆解
原文作者:讳疾忌医-note;如有侵权,请联系管理员删除。

最新文章
- C++高频交易系统延迟痛点大揭秘:从毫秒到纳秒的调优之路
- 为什么你的C++程序又大又慢?大部份开发者忽视的LTO链接优化陷阱
- 中国人眼中的沃尔特?布莱特:D语言比C++ 更优?多数开发者的认知误区
- 榨干每一滴性能:编译器不想让你知道的C++性能秘诀
- 国外C++架构师分享:从架构小白到架构师,看看他是如何做到的?
- 国外C++程序员分享:当OCR遇上C++和OpenCV,图像文本提取变多简单?
- 探索C++语言的起源密码:一段鲜为人知的技术传奇
- 震惊!从物理跨界C++:如何凭 STL 重塑C++编程格局
- 打工人必备!GitHub惊现神器,上班提高效果再也不怕被抓
- 国外C++程序员分享:告别复杂的元编程,抢先预览C++26的新特性
