
本文是经过严格查阅相关权威文献和资料,形成的专业的可靠的内容。全文数据都有据可依,可回溯。特别申明:数据和资料已获得授权。本文内容,不涉及任何偏颇观点,用中立态度客观事实描述事情本身。
文章结尾有最新热度的文章,感兴趣的可以去看看。
文章有点长(2679字阅读时长:5分),期望您能坚持看完,并有所收获
大家好,今天我继续给大家分享干货。熟悉我的人,都知道我真正的干货一般在中间和末尾部分(文章后部分有代码优化策略)。请耐心看完!谢谢。您可以在文章末尾处获取完整的源代码文件。
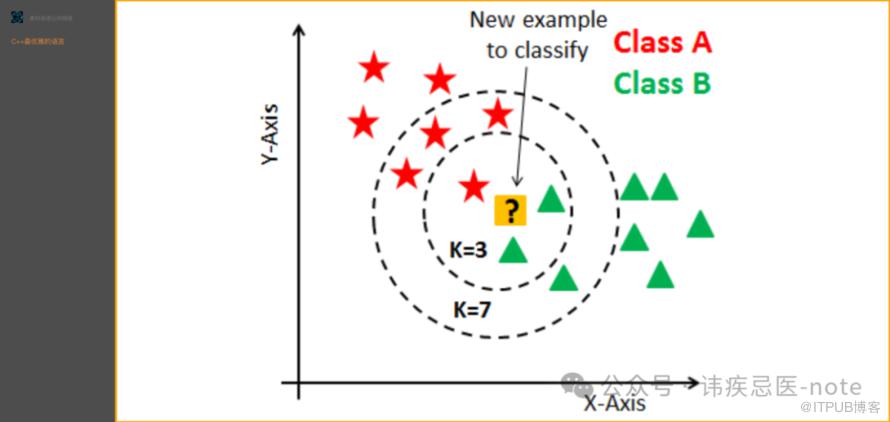
k 近邻(k-Nearest Neighbors,kNN)算法是一种基础的有监督机器学习算法,可用于分类和回归任务。本文重点介绍在 C++ 中实现用于分类问题的 kNN 算法,并通过优化手段和实际示例展示其在现实场景中的应用。
理论背景
kNN 算法基于一个简单却强大的原理:它根据特征空间中某一数据点的 k 个最近邻的多数类别来对该数据点进行分类。该算法的有效性依赖于两个关键假设:
1. 局部性原理:相邻的点可能具有相似的标签。 -
2. 平滑性假设:分类边界相对平滑。 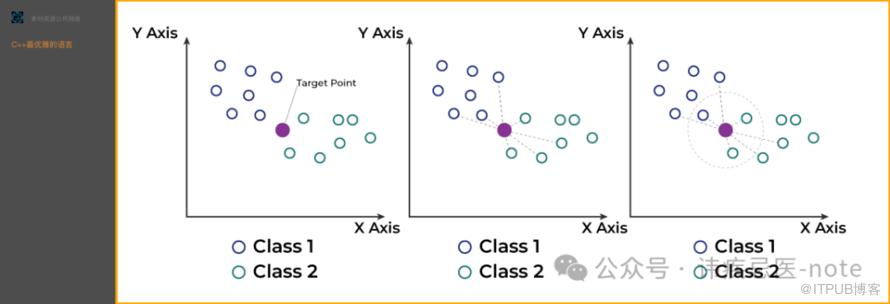
其中分类决策是基于k个最近训练样本的多数表决做出的。其数学基础可以表示为:
对于一个点 x,其预测类别 y 为:
y = argmax[c∈C] ∑[i∈Nk(x)] w(x, xi) * I(yi = c)
其中:
• Nk(x) 表示 x 的 k 个最近邻。 • w(x, xi) 是权重函数(通常为 1/距离)。 • I(yi = c) 是指示函数。 • C 是所有类别的集合。
距离度量:不同的距离度量会显著影响分类性能。常见的度量包括:
1. 欧几里得距离(L2 范数): d(p,q) = √(∑(pi - qi)²)2. 曼哈顿距离(L1 范数): d(p,q) = ∑|pi - qi|3. 闵可夫斯基距离(Lp 范数): d(p,q) = (∑|pi - qi|^p)^(1/p)
使用C++实现,通过代码去了解原理
上面看数学公式可能很生硬,我们可以通过代码来学习,我们来实现一个通用的 kNN 分类器,它能够处理不同的距离度量和数据类型。
#include <vector>
#include <algorithm>
#include <cmath>
#include <map>
#include <queue>

template<typename T>
classKNNClassifier {
private:
    std::vector<std::vector<T>> training_data;  // 训练数据
    std::vector<int> labels;  // 标签
    int k;  // k 值

    // 距离度量函数类型
    using DistanceFunc = double (*)(const std::vector<T>&, const std::vector<T>&);
    DistanceFunc distance_func;  // 距离度量函数

    // 欧几里得距离实现
    static double euclidean_distance(const std::vector<T>& a, const std::vector<T>& b) {
        double sum = 0.0;
        for (size_t i = 0; i < a.size(); ++i) {
            double diff = static_cast<double>(a[i] - b[i]);
            sum += diff * diff;
        }
        return std::sqrt(sum);
    }

public:
    KNNClassifier(int k_neighbors = 3) : k(k_neighbors) {
        distance_func = euclidean_distance;
    }

    void set_distance_function(DistanceFunc func) {
        distance_func = func;
    }

    void fit(const std::vector<std::vector<T>>& X, const std::vector<int>& y) {
        training_data = X;
        labels = y;
    }

    int predict(const std::vector<T>& sample) {
        // 优先队列用于存储 k 个最近邻
        using DistanceLabel = std::pair<double, int>;
        std::priority_queue<DistanceLabel> pq;

        // 找到 k 个最近邻
        for (size_t i = 0; i < training_data.size(); ++i) {
            double dist = distance_func(sample, training_data[i]);
            pq.push({-dist, labels[i]});  // 取负距离以实现小顶堆的效果
            if (pq.size() > k) pq.pop();
        }

        // 投票计数
        std::map<int, int> vote_count;
        while (!pq.empty()) {
            vote_count[pq.top().second]++;
            pq.pop();
        }

        // 找出多数类别
        int max_votes = 0;
        int predicted_class = -1;
        for (constauto& vote : vote_count) {
            if (vote.second > max_votes) {
                max_votes = vote.second;
                predicted_class = vote.first;
            }
        }

        return predicted_class;
    }
};
分类问题 1:鸢尾花数据集的多分类
鸢尾花数据集是多分类问题的经典示例。以下是实现方法:
// 鸢尾花特征结构体
structIrisFeatures {
    double sepal_length;  // 花萼长度
    double sepal_width;  // 花萼宽度
    double petal_length;  // 花瓣长度
    double petal_width;  // 花瓣宽度
};

// 鸢尾花数据集的自定义距离函数
double iris_distance(const std::vector<double>& a, const std::vector<double>& b) {
    // 加权欧几里得距离,对花瓣测量值赋予更高权重
    double sum = 0.0;
    constdouble petal_weight = 1.5;

    // 花萼特征(索引 0 和 1)
    for (int i = 0; i < 2; ++i) {
        double diff = a[i] - b[i];
        sum += diff * diff;
    }

    // 花瓣特征(索引 2 和 3)
    for (int i = 2; i < 4; ++i) {
        double diff = a[i] - b[i];
        sum += petal_weight * diff * diff;
    }

    return std::sqrt(sum);
}

void iris_classification_example() {
    // 使用自定义距离函数初始化分类器
    KNNClassifier<double> classifier(5);
    classifier.set_distance_function(iris_distance);

    // 加载并预处理鸢尾花数据集
    // 注意:这只是用于演示的数据集子集
    std::vector<std::vector<double>> X_train = {
        {5.1, 3.5, 1.4, 0.2}, // 山鸢尾
        {4.9, 3.0, 1.4, 0.2},
        {7.0, 3.2, 4.7, 1.4}, // 杂色鸢尾
        {6.4, 3.2, 4.5, 1.5},
        {6.3, 3.3, 6.0, 2.5}, // 维吉尼亚鸢尾
        {5.8, 2.7, 5.1, 1.9}
    };

    std::vector<int> y_train = {0, 0, 1, 1, 2, 2};

    // 训练分类器
    classifier.fit(X_train, y_train);

    // 测试预测
    std::vector<double> test_iris = {6.2, 3.4, 5.4, 2.3};
    int predicted_class = classifier.predict(test_iris);

    std::cout << "Predicted Iris class: " << predicted_class << std::endl;
}
优化技术方案:
1. 空间划分
• 实现 KD 树或球树,以加快最近邻搜索速度。 • 平均情况下,将时间复杂度从 O(nd) 降低到 O(log n)。
• 在距离计算中提前终止。 • 使用平方距离以避免平方根计算。 • 使用单指令多数据(SIMD)指令进行并行距离计算。
• 使用高效的数据结构存储训练数据。 -
• 正确使用移动语义和引用。 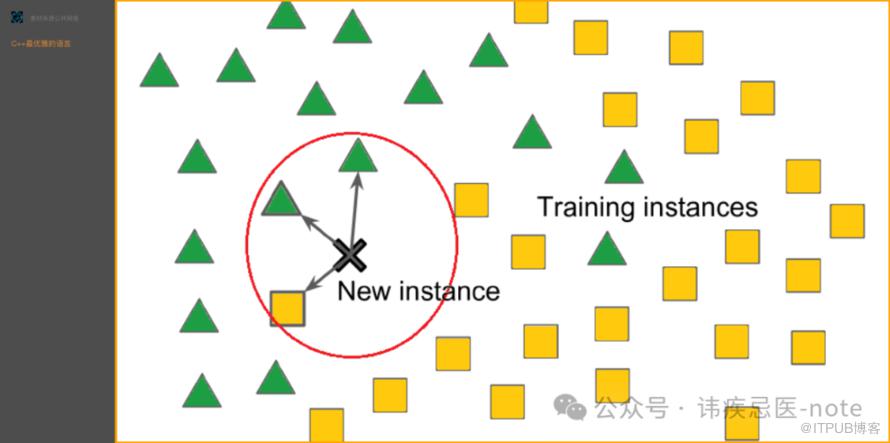
性能考量
上述实现具有以下复杂度:
• 训练时间:O(1) - 仅存储数据。 • 预测时间:O(n * d),其中 n 是训练样本数量,d 是特征数量。 • 空间复杂度:O(n * d)
对于大型数据集,可考虑以下优化:
// 避免平方根计算的平方欧几里得距离示例
static double squared_euclidean_distance(const std::vector<T>& a, const std::vector<T>& b) {
    double sum = 0.0;
    for (size_t i = 0; i < a.size(); ++i) {
        double diff = static_cast<double>(a[i] - b[i]);
        sum += diff * diff;
    }
    return sum;  // 无平方根计算
}
最佳实践与建议
1. 数据预处理
• 对特征进行归一化处理,使其具有相似的尺度。 • 妥善处理缺失值。 • 必要时去除异常值。
• 根据样本数量 n 的平方根选择 k 值。 • 使用交叉验证来调整参数。 • 考虑偏差 - 方差权衡。
• 使用模板以实现类型的灵活性。 • 实现清晰的接口。 -
• 添加适当的错误处理。 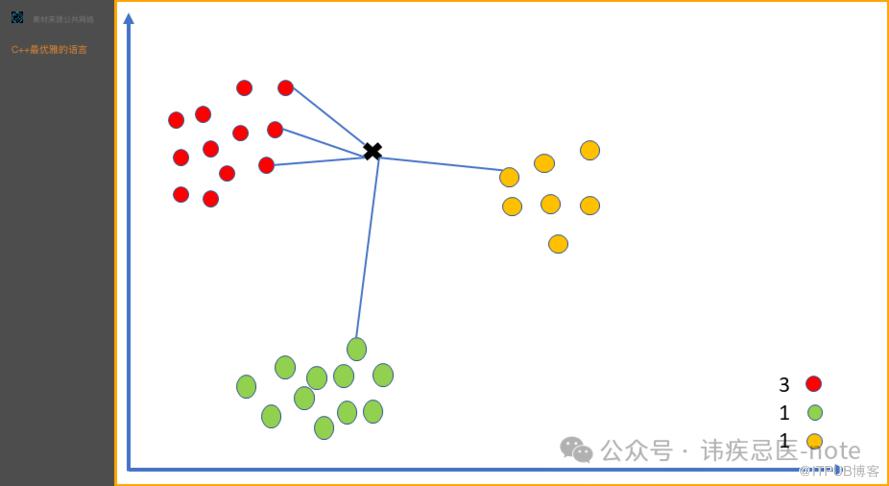
结论
kNN 算法虽然简单,但为理解机器学习概念提供了坚实的基础。本文在 C++ 中的实现展示了如何创建一个高效、灵活且易于维护的分类器,该分类器可适应各种不同的应用场景。以上就是我的分享。这些分析皆源自我的个人经验,希望上面分享的这些东西对大家有帮助,感谢大家!
参考文献
1. Fix, E., & Hodges, J. L. (1951). Discriminatory analysis, nonparametric discrimination: Consistency properties. 2. Bentley, J. L. (1975). Multidimensional binary search trees used for associative searching. 3. Peterson, L. E. (2009). K-nearest neighbor. Scholarpedia, 4(2), 1883.
文章中源代码怎么获取:关注官方微信公众号,就可以获取。

最新热门文章推荐:
用纯C++180行代码实现:HTTP请求响应精妙交互,浏览器背后你不知道的故事
用纯C++160行代码实现多人聊天室:Linux套接字的魅力
从零开始:用C++实现简易GDB通过代码了解背后的逻辑与实现
使用C++实现:一个简易版本的InnoDB存储引擎来学习高效存储技术
告别选择困难:用VSCode和Docker构建跨平台C++统一环境
国外Rust程序员分享:Crossbeam使多线程通信如此简单高效
国外Rust程序员分享:从头开始编写一个实时操作系统(RTOS)
C++开发中被低估的std::vector,竟是性能与安全的双重保障!
原文作者:讳疾忌医-note;如有侵权,请联系管理员删除。

最新文章
- CUDA与C++多线程性能之争:为何CUDA在金融计算中更胜一筹?
- C++高频交易系统延迟痛点大揭秘:从毫秒到纳秒的调优之路
- 为什么你的C++程序又大又慢?大部份开发者忽视的LTO链接优化陷阱
- 中国人眼中的沃尔特?布莱特:D语言比C++ 更优?多数开发者的认知误区
- 榨干每一滴性能:编译器不想让你知道的C++性能秘诀
- 国外C++架构师分享:从架构小白到架构师,看看他是如何做到的?
- 国外C++程序员分享:当OCR遇上C++和OpenCV,图像文本提取变多简单?
- 探索C++语言的起源密码:一段鲜为人知的技术传奇
- 震惊!从物理跨界C++:如何凭 STL 重塑C++编程格局
- 打工人必备!GitHub惊现神器,上班提高效果再也不怕被抓
