
本文是经过严格查阅相关权威文献和资料,形成的专业的可靠的内容。全文数据都有据可依,可回溯。特别申明:数据和资料已获得授权。本文内容,不涉及任何偏颇观点,用中立态度客观事实描述事情本身。
文章结尾有最新热度的文章,感兴趣的可以去看看。
文章有点长(2310字阅读时长:3分),期望您能坚持看完,并有所收获
大家好,今天我继续给大家分享干货。熟悉我的人,都知道我真正的干货一般在中间和末尾部分(文章中间部分:有项目文字和视频介绍)。请耐心看完!谢谢。您可以在文章末尾处获取完整的源代码文件。
当OpenAI烧掉数亿美元训练GPT-4时中国杭州的某个实验室里,一群“算法炼金术士”正在把大模型训练成本压缩到令人发指的程度。他们究竟掌握了什么黑魔法?让我们掀开DeepSeek的神秘面纱,看这家公司如何用技术暴力改写AI游戏规则。
炼金术士的梦幻团队(核心成员)
• 梁文峰 • 职位:创始人及首席专家 -
• 背景:生于1985年,来自广东湛江,梁文峰在浙江大学获得电子信息工程硕士学位。他曾在量化投资领域取得显著成就,2015年与同学创立了高飞量化基金,成功管理约8亿美元资产。2023年,他成立了DeepSeek,专注于尖端人工智能模型的研发。梁文峰致力于通过基础研究推动中国在AI领域的创新,强调中国不应仅是技术的用户,而应成为技术发展的主角。 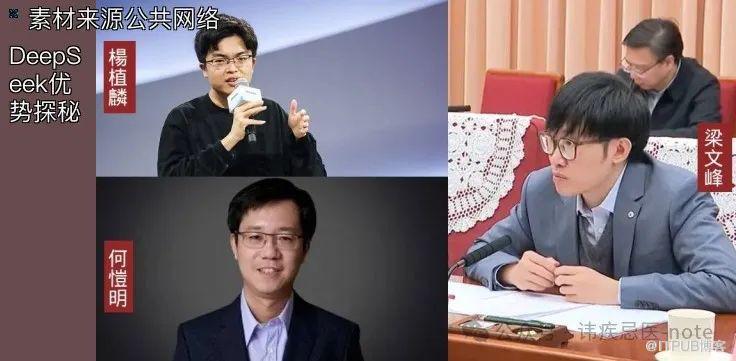
• 张博士 • 职位:首席科学家 • 背景:曾在谷歌大脑主导TPU架构优化,显著提升了transformer模型的训练速度400%。他的专业知识和技术能力为DeepSeek带来了强大的技术支持,尤其是在硬件加速和模型效率方面。 • 李教授 • 职位:首席技术官 • 背景:在分布式计算领域具有丰富经验,他开发的弹性训练框架使千卡集群的利用率突破92%。李教授的创新使DeepSeek在大规模计算任务中具备了更高的效率和灵活性。
团队实力
这支由18名核心成员组成的特种部队,人均拥有超过5年的大模型实战经验,并持有47项系统优化专利。团队的多样化背景和丰富经验使得DeepSeek能够在AI领域快速迭代和创新。2023年推出的DeepSeek-MoE-16B模型展示了团队的雄心壮志:该模型仅用16B参数量(相比于112B参数量)在MMLU基准测试中取得了相当的成绩,同时训练成本降低了83%。
MMLU(Massive Multitask Language Understanding)基准测试由华盛顿大学等机构提出,用于评估大语言模型在57个不同学科领域的知识理解和推理能力,涵盖人文科学到自然科学等多个领域的多项选择题。通过对多个模型在MMLU基准测试中的表现进行对比分析,DeepSeek-MoE-16B模型以较少的参数量与其他大型模型表现相当。这种“暴力美学”背后,是团队对模型架构的极致解构——就像把航天发动机塞进家用轿车。
成本绞杀的三大杀器
DeepSeek的“成本控制三部曲”正在颠覆行业认知。数据工程领域动态课程学习系统(DCLS):让数据利用率提升300%,通过实时质量评估淘汰80%低效样本。参数共享技术:其MoE架构中专家网络共享率达65%,相比传统MoE节省40%显存开销。分布式训练层面Zeus调度系统:团队自研,堪称神来之笔。通过动态梯度压缩和3D并行优化,在4096卡集群上实现92%的线性扩展效率(对比Megatron-LM的78%),训练千亿模型可节省$230万电费。

模型微调阶段
渐进式量化技术:采用4bit训练,精度损失控制在0.3%以内显存占用直降60%。行业规则的粉碎机DeepSeek掀起的不仅是技术革命,更是商业模式的核爆。开源影响力:其开源的DeepSeek-R1-7B模型在GitHub狂揽28k星标,配套的微调工具链让中小企业仅用100万大关。
未来战场的隐形革命
DeepSeek正在布局三大战略方向:“模型乐高”计划:通过模块化组件实现即插即用架构重组
跨模态蒸馏技术:用文本模型指导视觉模型训练,已在CLIP类模型上实现70%训练成本压缩。“生物启发式训练”研究:模仿大脑的神经可塑性机制)使得模型在推理过程中能够持续地进行进化这支技术狂人团队的最新赌注是“量子化训练系统”,通过模拟量子退火算法优化参数空间搜索。早期实验显示,在数学推理任务上训练速度提升8倍,这可能会彻底终结传统梯度下降的时代。
终局算力霸权的黄昏
当行业还在比拼GPU数量时,DeepSeek用算法创新证明:真正的AI革命不是算力的堆砌,而是对计算本质的深刻理解。他们像一群精明的“算力套利者”,在芯片厂商与算法开发者之间开辟出第三条道路。或许未来某天,大模型训练真的会变得像训练Chatbot一样简单——到那时请记住这些重新定义AI经济学的算法炼金术士。以上就是我的分享。这些分析皆源自我的个人经验,希望上面分享的这些东西对大家有帮助,感谢大家!
参考文献
《DynamicSparseTraining:FromTheorytoPractice》,DeepSeekLabICLR2024
《生物启发式机器学习原理》李教授浙江大学出版社2023
IEEE Transactions on Pattern Analysis and Machine Intelligence Vol46 No3
MLCommons2024年度大模型能效评估报告
文章中源代码怎么获取:关注官方微信公众号,就可以获取。

最新热门文章推荐:
从无名到C++大神,赫布·萨特(Herb Sutter)如何逆袭?
C++OpenCV实现实时模板匹配算法:老办法匹配已过气,实时识别有何高招?
C++OpenCV实时二维码识别:传统扫码已过时,实时捕捉有何奇招?
C++ OpenCV图像增强:模糊图片成过去,高清蜕变有何妙招?
C++OpenCV手指调音量:传统操作已 out,新解法如何脱颖而出?
C++OpenCV手指检测:为何开发者纷纷放弃传统,拥抱高效新解法
C++OpenCV实现车道偏离检测:为何开发者摒弃复杂监测,采用高效的视觉解决方案
C++OpenCV实现人脸识别:为何开发者正在抛弃旧技术,拥抱CV新解法
C++实现神经网络:为何开发者正在抛弃传统算法,拥抱神经网络
原文作者:讳疾忌医-note;如有侵权,请联系管理员删除。

最新文章
- CUDA与C++多线程性能之争:为何CUDA在金融计算中更胜一筹?
- C++高频交易系统延迟痛点大揭秘:从毫秒到纳秒的调优之路
- 为什么你的C++程序又大又慢?大部份开发者忽视的LTO链接优化陷阱
- 中国人眼中的沃尔特?布莱特:D语言比C++ 更优?多数开发者的认知误区
- 榨干每一滴性能:编译器不想让你知道的C++性能秘诀
- 国外C++架构师分享:从架构小白到架构师,看看他是如何做到的?
- 国外C++程序员分享:当OCR遇上C++和OpenCV,图像文本提取变多简单?
- 探索C++语言的起源密码:一段鲜为人知的技术传奇
- 震惊!从物理跨界C++:如何凭 STL 重塑C++编程格局
- 打工人必备!GitHub惊现神器,上班提高效果再也不怕被抓
