关系型数据库在 AI 战场:从语义搜索到 RAG 的实战指南
本文整理于 HOW 2026 演讲内容,演讲嘉宾:Bruce Momjian,PostgreSQL 全球开发组核心组成员、EDB 副总裁,中国 PostgreSQL 分会国际顾问委员会委员。
在生成式 AI 席卷全球的今天,一个老问题被重新提起: 拥有 50 多年历史的关系型数据库,是否正在被 AI 时代的新技术边缘化?
来自 EnterpriseDB(EDB)的 Bruce Momjian 在济南的这场技术分享中给出了自己的判断: 关系型数据库依然适用,而且在 AI 应用的多个环节具有重要价值。
这场演讲既是一次技术祛魅——拆解了高维向量、Transformer 等工作原理;也是一次架构指引——分析了关系型数据库在语义搜索、RAG(检索增强生成)和 MCP(模型上下文协议)等场景中的应用价值。
以下是本场演讲的精华整理,希望能帮你避开在数据库上跑大模型训练的误区,厘清技术边界。
一、回顾 AI 的转折点:从判别式到生成式
2022 年 11 月 30 日 ChatGPT 的发布,是人工智能公众认知的分水岭。在此之前,大众接触的 AI 主要是 判别式的,擅长分类、推荐和预测(如欺诈检测、视频推荐)。而 ChatGPT 带来了 生成式 AI,它不仅能分析,还能创造全新的内容——文本、图像,乃至软件代码。
两者的区别在于:
- 判别式:通过训练数据划定决策边界,判断“实例在边界的哪一侧”。
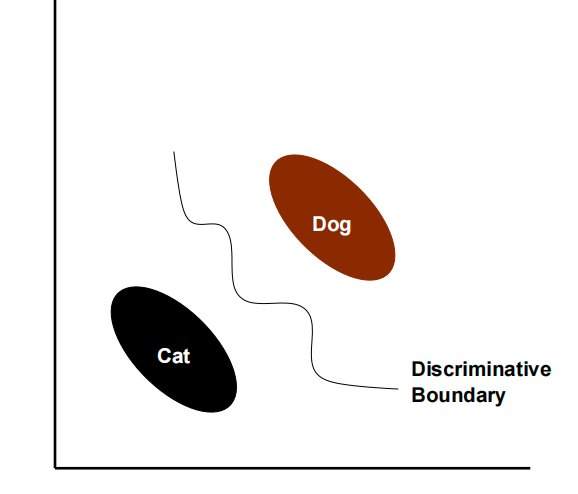
- 生成式:通过学习数据的分布及其生成规律,生成新的内容。在传统机器学习中,生成式模型也可以用于判断某一类别生成特定实例的概率。
二、基石:高维向量与文本嵌入
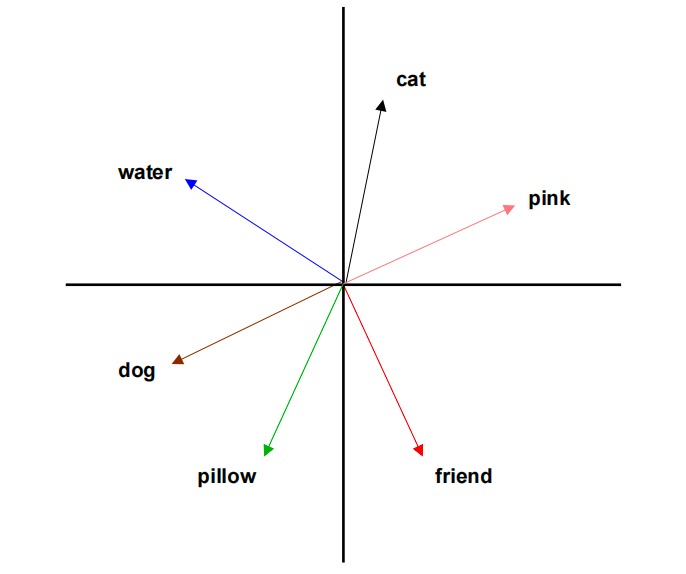
理解生成式 AI,需从 高维向量开始。数学能帮我们表示难以在现实世界中直接呈现的概念,如无穷大、极高维度。在 AI 领域,文本可以被转化为高维向量,用于表示词语、句子或文档的语义特征。
不同模型使用的向量维度并不相同,可能从数百维到上万维。需要注意的是, 大语言模型内部的向量表示与专门用于语义搜索的文本嵌入向量并不完全相同,其维度取决于具体模型及任务。
训练文本嵌入的简版逻辑:
- 初始化:为词汇表中的每个词(或子词 Token)初始化一个向量。
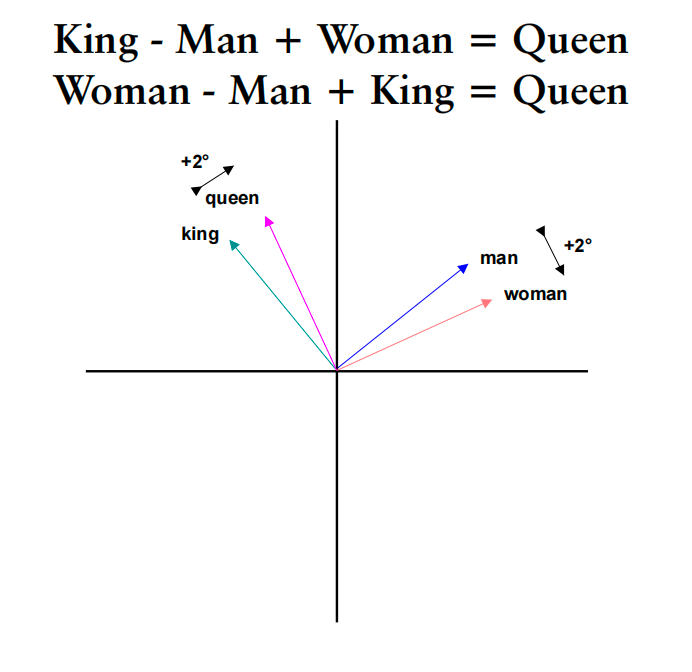
- 调整:利用海量文本进行训练,不断调整向量表示。以 Word2Vec 为例,训练会利用词语之间的上下文关系,使具有相关语义或相似使用环境的词在向量空间中形成一定的关联。例如,训练中“king”会与“man”建立关联,“queen”会与“woman”建立关联。
- 奇妙结果:经过训练,向量之间可能呈现出有规律的语义关系。著 名的例子是: King - Man + Woman ≈ Queen。
三、实战一:语义/向量搜索
这是关系型数据库在 AI 领域最直接的应用之一,能够弥补传统全文搜索在理解语义关系方面的不足。
工作原理:
- 将文档切分为“块”(如句子或段落)。
- 利用预训练的 Embedding 模型,将每个文本块转换为向量,并将文本及其向量存入数据库(借助
pgvector等扩展)。 - 使用相同的 Embedding 模型将用户查询转换为查询向量。
- 在数据库中计算查询向量与文档块向量之间的距离,找到最接近的内容。
演讲中的 PostgreSQL 示例采用 L2 欧氏距离,通过
pgvector的<->运算符进行计算和排序。实际应用中,也可以根据需要使用余弦距离等其他度量方式。
为便于理解,Bruce 在演讲中使用了对词向量求平均值的方法来解释文本块向量的形成过程。但在实际应用中,通常直接使用预训练文本嵌入模型为整段文本生成向量,而不是简单地对词向量求平均。
语义搜索的优势:
搜索 “Who is pretty?”,能匹配到 “The queen is a beautiful woman.”,因为 “pretty” 与 “beautiful” 存在语义关联。
另一个例子是搜索 “Where is the chair?”,也能检索到包含 “They sit together in the throne room of the castle.” 的句子。这是因为 “chair” 与 “sit” 存在语义关联,即使原文中没有直接出现 “chair”,向量检索仍可能找到相关内容。
不过,语义相关并不等于事实匹配。对于精确关键词、人名、编号等查询,传统全文搜索仍有优势,两者可以结合使用。
四、实战二:生成式 AI 与 Transformer
Transformer 架构是 ChatGPT 等模型生成文本的关键。
简化流程:
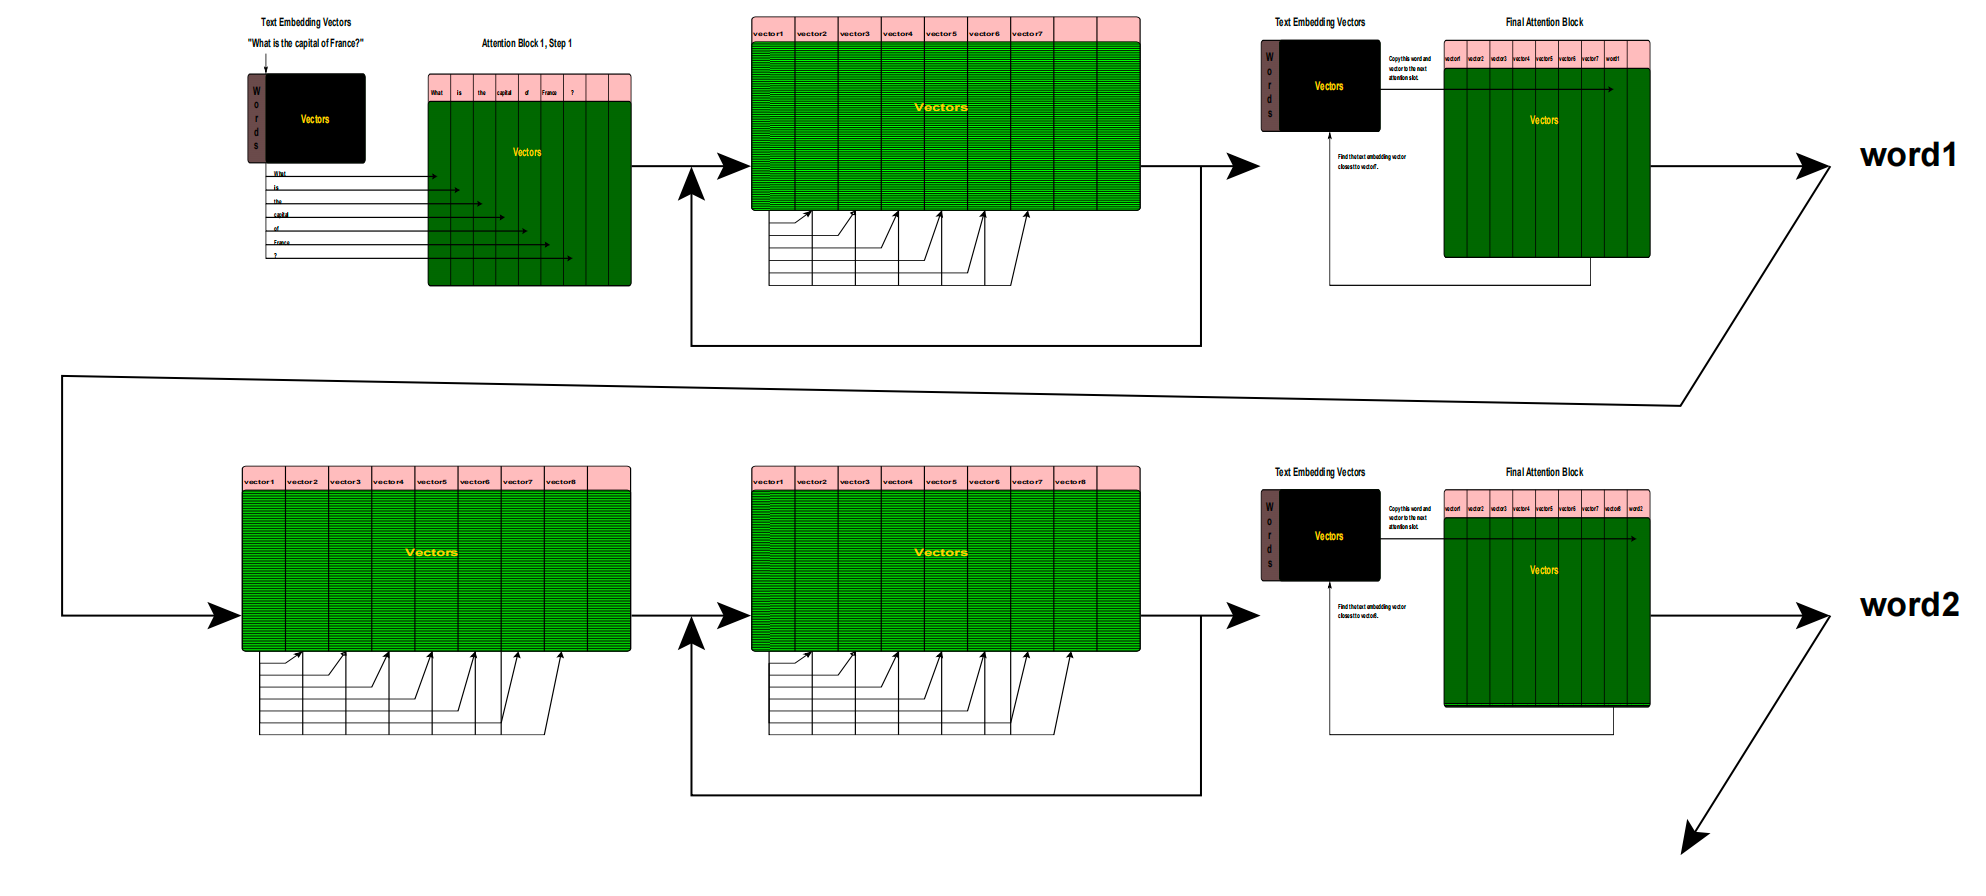
- 将用户查询转换为 Token,并映射为模型内部的向量表示,输入 Transformer 的注意力模块。
- 模型通过注意力机制计算不同 Token 之间的关联,结合上下文更新各个位置的向量表示。
- 此过程在多个 Transformer 层中重复进行(如 GPT-3 使用 96 层 Transformer)。
- 处理完毕后,模型根据最后一个位置的表示,预测下一个 Token,再将其加入上下文,重复此过程, 逐个 Token 生成回答。
这里的 Token 不一定对应一个完整的词或单个汉字,也可能是一个词的一部分。
这些计算大量依赖 矩阵乘法,可以通过 GPU 高效并行处理,这也是 GPU 在现代 AI 计算中发挥重要作用的原因。
五、革命性应用:RAG
RAG(Retrieval-Augmented Generation,检索增强生成) 是当前数据库与 AI 结合的重要模式。它允许在用户查询时,将外部数据作为上下文提供给模型,从而引导模型基于特定数据生成答案,而非仅依赖其内部训练参数。
示例:
将订单 JSON 数据
[{"order_id": 735, "product": "gears", ...}, ...] 作为上下文。
- 问:“What is the total of all invoices?”
- 答:在演讲示例中,模型根据提供的订单数据计算出总金额为“39”,展示了利用外部数据辅助回答问题的能力。
- 问:“Which invoices are overdue?”
- 答:模型可以结合提供的订单日期等信息及当前日期,判断哪些订单已经逾期。
需要注意的是,这些是演讲中的具体演示结果,并不代表模型在所有情况下都能准确完成计算或判断。对于金额汇总等要求严格准确的任务,更稳妥的做法是由数据库完成计算,再将结果提供给模型。
更重要的是,RAG 数据可以 动态获取:通过语义搜索找到相关文档,或让数据库将查询结果转为 JSON,作为上下文供给模型。
这也意味着,数据库不仅可以负责存储业务数据,还能够参与 AI 应用的数据检索、上下文组织和结果生成流程。
六、前沿:MCP
MCP(Model Context Protocol,模型上下文协议) 是 AI 应用连接外部工具与数据源的一种标准化协议。它为 AI 应用与外部系统之间的交互提供了统一方式,使模型能够借助外部工具获取实时数据或执行操作,弥补单纯依靠模型内部知识无法获取动态信息的局限。
应用场景:
- 查询实时数据:获取特定地区天气、商品价格等信息。
- 执行业务操作:在获得适当授权后,通过外部工具发送邮件、预订机票等。
对关系型数据库而言,MCP 提供了新的集成方式。AI 应用可以通过符合 MCP 规范的工具访问数据库中的业务数据,或者执行经过授权的数据库操作,而不必将全部数据预先写入模型上下文。
七、理性定位:哪里该用关系型数据库?
基于以上分析,Bruce 对关系型数据库在不同 AI 场景中的适用性进行了总结:
| 环节 | AI 特性 | 数据库适用性 |
|---|---|---|
| 文本嵌入训练 | 批量变更、数据庞大 | 不适合(性能与计算开销问题) |
| 语义/向量搜索 | 检索现有内容 | 适合(Good) |
| Transformer 推理 | 海量向量计算 | 不适合 |
| RAG | 为查询补充上下文 | 适合(Good) |
| MCP | 获取外部数据与执行操作 | 适合(Good) |
| 自然语言转 SQL | 将自然语言转换为数据库查询 | 不确定(Unknown) |
其中,自然语言转 SQL 被标注为 Unknown,并不意味着这项技术不可行,而是其在数据库应用中的适用性仍需要结合具体场景进一步验证,尤其要考虑生成 SQL 的准确性、安全性和可控性。
总体来看,关系型数据库并不适合承担大模型训练、Transformer 推理等密集计算任务,但在数据存储、检索、上下文提供以及外部工具集成等环节,仍然具有明显的应用价值。
结语
Bruce 在演讲结尾引用了两个不同视角的观点,反映出人们对 AI 发展的两种思考。
一方面,AI 进步的速度远超以往预期。Jon Krohn 曾表示,如果在几年前有人描述今天 ChatGPT 所能实现的能力,他可能会怀疑这些能力能否在有生之年出现。
另一方面,Yann LeCun 提醒人们,语言表达能力并不必然等于智能。模型能够流畅地生成和处理语言,并不意味着它具备与人类相同的理解能力。
这两种观点也提醒我们:在看到生成式 AI 技术突破的同时,仍需关注模型输出的准确性、可靠性,以及实际部署中的技术边界。对于可能出现的错误或“幻觉”,不能仅依赖模型自身来保证结果可信。
核心结论: 关系型数据库没有过时。在 语义搜索、RAG、MCP 等场景中,它依然能够发挥重要作用;而在大规模训练、Transformer 推理等重计算任务面前,则应选择更适合的专用计算框架。
厘清技术边界,让数据库与 AI 各自发挥优势,才能构建更加可靠、可持续的 AI 应用架构。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70043484/viewspace-3185446/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- PostgreSQL 日报|堆表选择性索引更新(10 月 13 日)
- IvorySQL 5.6 RISC-V 实测:零补丁编译,468 项回归测试全过
- PostgreSQL 日报|逻辑解码 DDL 子事务缺陷修复(10 月 12 日)
- PGConf.Asia 2026 议程公布!53 场技术分享,11 月相约香港
- PostgreSQL 日报| PostgreSQL JDBC 安全更新(10 月 10 日)
- 从轮询到等待——PostgreSQL WAIT FOR LSN 特性深度解析
- PostgreSQL 日报|修复截断 zstd 备份检测(10 月 9 日)
- VACUUM FULL 之后 ROWID 就废了? IvorySQL 兼容性实测
- PostgreSQL 日报|原生 BM25 全文搜索索引(10 月 8 日)
- PostgreSQL 日报|临时复制槽泄漏致数据丢失(9 月 30 日)
