IvorySQL 多模融合实战:pgvector + AGE + pg_textsearch 在同一实例中的协同验证
作者:魏波,北京晟数科技技术顾问、PG 分会副秘书长。
引言
随着企业智能知识库对多模数据处理能力的需求不断提升,如何在同一数据库实例中协同实现向量检索、图数据分析与全文搜索,成为值得验证的实践方向。本文以 IvorySQL 5.4(基于 PostgreSQL 18.4) 为验证对象,基于 Windows 11 + Docker Desktop 环境,通过 IvorySQL 官方镜像,对 pgvector、AGE 与 pg_textsearch 的协同能力进行实测验证。
一、总体支持情况概览
1.1 研究视角:IvorySQL 统一数据底座的可行性验证
在企业智能知识库架构中(如 LLM WIKI + GBrain + Agentic RAG 方案),
IvorySQL 被定位为"统一数据底座"——在同一数据库实例内同时支撑三大检索层:
- 关键词召回:pg_textsearch / pg_bigm 全文检索,确保术语、编号的精确匹配
- 语义补全:pgvector 向量相似度查询,覆盖同义改写和跨语言场景
- 图谱推理:Apache AGE 知识图谱,支持实体关系的多跳推理
三者可在同一 PostgreSQL 实例内完成协同查询,无需引入 Elasticsearch + Milvus + Neo4j 等多组件架构。
本文为该系列 第一篇,聚焦 基础能力验证:三大功能领域能否在 IvorySQL 5.4 上同时安装、建表、执行基础查询?后续文章将逐步展开双路混合检索、GBrain 图谱存储验证与 Agentic RAG 集成测试。
验证声明:本文所有测试用例均已在 Windows 11 + Docker Desktop 环境中,基于
IvorySQL 5.4 官方镜像
5.4-ubi8(PostgreSQL 18.4)并源码编译安装全部四个多模扩展(pgvector + AGE + pg_bigm + pg_textsearch)后全部验证通过。为便于读者复现,全文以公开镜像
5.4-ubi8 为统一基线,6.1 给出「裸镜像快速部署 + 逐扩展编译」的完整步骤。
1.2 扩展能力总览
| 功能领域 | 支持扩展 | 版本 | 支持状态 | 核心能力 |
|---|---|---|---|---|
| 向量数据 | pgvector | 0.8.5 | ✅ 完全支持 | 16000 维向量、HNSW/IVFFLAT 索引、余弦/欧氏/内积/曼哈顿距离计算 |
| 知识图谱 | Apache AGE | 1.7.0-rc0(PG18 分支预发布) | ✅ 完全支持 | openCypher 查询、属性图模型、SQL 混合查询、ACID 事务 |
| 全文检索 | pg_textsearch / pg_bigm / PGroonga / 内置 tsvector | 0.6.1 / 1.2 / 最新 | ✅ 完全支持 | BM25 排序、中日韩分词、模糊检索、短语检索 |
二、向量数据支持详情
2.1 技术方案
IvorySQL 通过 pgvector 扩展实现向量数据支持。pgvector 是 PostgreSQL 生态中最重要的向量扩展,IvorySQL 从 3.0 版本开始官方适配,在最新的 5.4 版本中进一步强化了 AI 能力,新增了 pg_ai_query 扩展。
命名约定:pgvector 是 项目社区名称,数据库内扩展名为
vector,对应CREATE EXTENSION vector。本文后续统称"pgvector 扩展"以保持与项目文档一致,但所有 SQL 命令均使用扩展名vector。
2.2 核心特性
- 高维支持:最大支持 16000 维向量
-
索引算法:
- HNSW(Hierarchical Navigable Small World):查询性能更优,支持实时插入
- IVFFLAT(Inverted File Flat):构建更快,内存占用更少
-
距离度量:
- 欧氏距离(
<->) - 余弦相似度(
<=>) - 内积(
<#>) - 曼哈顿距离(
<+>,v0.7.0+)
- 欧氏距离(
- Oracle 兼容模式:pgvector 在 IvorySQL 的 Oracle 兼容模式下完全可用,支持在 PL/SQL 匿名块、存储过程、函数中使用 vector 类型
2.3 适用场景
- RAG(检索增强生成)语义搜索
- 电商商品相似度推荐
- 图像/音频特征检索
- AI Embedding 存储与检索
三、知识图谱支持详情
3.1 技术方案
IvorySQL 通过 Apache AGE(A Graph Extension)扩展提供图数据库能力。AGE 是 PostgreSQL 的图数据库扩展,支持 openCypher 查询语言。
3.2 核心特性
- 属性图模型:在 PostgreSQL 内原生支持属性图
- openCypher 语法:兼容 Neo4j 查询语法
- SQL 混合查询:图查询结果可与关系表 JOIN,实现图+关系数据联合分析
- ACID 事务:继承 PostgreSQL 的事务能力
- 图结构:支持 Graph(图空间)、Vertex(节点)、Edge(边)、Label(标签)、Property(属性)
3.3 适用场景
- 社交网络分析
- 知识图谱构建与查询
- 欺诈检测
- 推荐系统
- 路径规划
- GraphRAG(图增强的 RAG)
3.4 重要说明
Apache AGE 使 IvorySQL 具备图数据处理能力,但 IvorySQL 本质仍是关系型数据库。对于大规模图场景(十亿级以上节点、高并发多跳遍历),建议搭配专用图数据库(如 TuGraph、NebulaGraph)使用,以获得更优的图遍历性能。
⚠️ 版本风险提示:本文编译安装的是 AGE
PG18/v1.7.0-rc0预发布分支(pg18 当前最新稳定版为 2026-07-03 发布的 v1.8.0)。RC 版本核心功能可用,但生产环境建议等待正式版发布后再上线,或在升级前充分测试兼容性和稳定性。
四、全文检索支持详情
4.1 技术方案
IvorySQL 提供 多层级全文检索方案:
| 扩展名称 | 版本 | 功能定位 | 适用场景 |
|---|---|---|---|
| pg_textsearch | 0.6.1 | BM25 高性能全文检索,AI 工作负载优化 | 文档检索、混合搜索(向量+全文) |
| pg_bigm | 1.2 | 二元分词(2-gram),中日韩文本优化 | 短关键词模糊匹配、相似度查询 |
| PGroonga | 最新 | 全文检索增强 | 多语言全文检索 |
| zhparser | 最新 | 中文分词 | 中文精准搜索 |
| pg_jieba | 最新 | 中文结巴分词 | 中文语义分词 |
| 内置 tsvector | PG 原生 | 标准全文检索 | 多语言配置化检索 |
4.2 核心特性
- BM25 相关性排序:pg_textsearch 提供现代 BM25 排名函数
- 混合搜索:支持与向量检索结合,实现语义+关键词双重召回
- 中日韩优化:pg_bigm 通过 2-gram 分词,无需词典即可高效处理 CJK 文本
-
模糊检索:支持相似度阈值控制(
=%操作符) - 短语检索:支持关键词顺序匹配(slop 参数控制间隔)
4.3 选型指南:什么时候用哪个?
全文检索的多种方案并不是"选一个用就行"——它们解决不同的问题。先分清两类:
- 检索 / 排名引擎:提供"怎么搜、怎么排"的完整能力,开箱即用。代表: pg_bigm(2-gram 模糊)、 pg_textsearch(BM25 排名)。
-
中文分词器(tsvector parser):只负责"把中文切对词",
本身不做检索排名,必须搭配 PostgreSQL 内置
tsvector+ts_rank使用。代表: zhparser、 pg_jieba(底层分别依赖 SCWS / jieba 词典)。
检索 / 排名引擎对比(pg_bigm vs pg_textsearch)
| 维度 | pg_bigm | pg_textsearch |
|---|---|---|
| 核心算法 | 2-gram 二元分词 | BM25 相关性排名 |
| 文本处理 | 按字符滑动切片, 无需词典 | 依赖 PostgreSQL 语言配置(english/simple 等) |
| 中文适配 | ✅ 天然支持中日韩,不用装分词器 | ❌ 需额外配置中文分词(zhparser/pg_jieba) |
| 排序方式 | 相似度阈值判断(
=%) |
相关性分数排名(负分越负越好) |
| 查询方式 | LIKE、likequery 模糊匹配 |
<@> 操作符,短语/关键词搜索 |
| 典型场景 | 短关键词模糊搜索、"记不全名字"时补全 | 文档检索、RAG 粗排、Top-K 排序 |
| 成熟度 | 稳定(v1.2) | 官方镜像没有预装任何插件 |
中文分词器(tsvector parser):zhparser / pg_jieba
| 维度 | zhparser | pg_jieba |
|---|---|---|
| 类型 | tsvector 中文分词器 | tsvector 中文分词器 |
| 底层依赖 | SCWS 中文分词词典库 | jieba 分词词典 |
| 使用方式 |
CREATE TEXT SEARCH CONFIGURATION ... PARSER = zhparser 接入内置 tsvector |
同上,接入内置 tsvector |
| 与上文关系 | 不与 pg_bigm / pg_textsearch 直接竞争,而是为 tsvector 提供中文切词能力 | 同左 |
| 典型场景 | 中文精准全文检索(需排名时用 tsvector + ts_rank) | 中文语义分词检索 |
⚠️ 备注 :zhparser / pg_jieba 属于"分词层",必须先 系统级安装 SCWS 词典库、再编译扩展,依赖比 pg_bigm / pg_textsearch 重;且它们只解决"中文怎么切词",排名需配合内置
tsvector+ts_rank。本文验证主线聚焦"同一实例内 4 个扩展共存"(pgvector 预装 + AGE + pg_bigm + pg_textsearch),故未把 zhparser 纳入实验,仅在能力清单中标注其定位。需要中文精准分词时,可在此基础上另行安装并用 tsvector 接入。
简单口诀:
- 记不住精确名称、做模糊补全 → pg_bigm
- 要做相关性排序、Top-N 文档检索 → pg_textsearch
- 两者组合 → pg_bigm 粗筛 + pg_textsearch 精排
- 要做中文精准分词(接 tsvector)→ zhparser / pg_jieba(需 SCWS 依赖)
补充说明:PGroonga 提供更全面的多语言全文检索(含中文);内置 tsvector 是 PG 原生方案,适合已有分词需求的场景。
五、版本与部署建议
5.1 版本选择
- 推荐版本: IvorySQL 5.4(基于 PostgreSQL 18.4,2026 年 6 月发布)
- 生态最完整:覆盖 AI、GIS、全文检索、运维监控等 20+ 扩展
- 云原生支持:提供 Docker、K8s、Operator 等多种部署方式
5.2 部署方式对比
| 方式 | 难度 | 适用场景 | 耗时 |
|---|---|---|---|
| Docker | ⭐ 极简 | 开发测试、快速体验 | 5 分钟 |
| YUM/DNF | ⭐⭐ 简单 | 生产环境(EL8/EL9) | 15 分钟 |
| DEB | ⭐⭐ 简单 | 生产环境(Debian/Ubuntu) | 15 分钟 |
| 源码编译 | ⭐⭐⭐⭐ 复杂 | 定制需求、学习研究 | 30-60 分钟 |
六、上手指南:验证多模融合
6.1 环境准备(Docker 快速部署)
环境说明:以下命令已在 Windows 11 + Docker Desktop 环境中验证通过。这些 docker 命令在 macOS(Docker Desktop)和 Linux(Docker Engine)环境下同样适用,仅 Docker 安装方式不同。
# 1. 安装 Docker Desktop(如未安装)# Windows/macOS: 从 https://www.docker.com/products/docker-desktop/ 下载安装# Linux: sudo apt install docker.io 或 sudo yum install docker-ce# 2. 拉取 IvorySQL 5.4 镜像(国内镜像源)docker pull registry.highgo.com/ivorysql/ivorysql:5.4-ubi8# 3. 启动容器(端口映射可根据实际环境调整;POSTGRES_INITDB_ARGS 确保 UTF-8 编码)#    注:官方 5.4-ubi8 镜像仅预装 Oracle 兼容基础扩展,未预装多模扩展,#        启动后需按下文「扩展安装」小节编译 pgvector / AGE / pg_bigm / pg_textsearch。docker run --name ivorysql-verify \
  -p 5434:5432 \
  -e POSTGRES_INITDB_ARGS="--encoding=UTF8 --locale=C.utf8" \
  -e IVORYSQL_PASSWORD=IvorySQL@2026 \
  -e IVORYSQL_DB=ivorysql \
  -d registry.highgo.com/ivorysql/ivorysql:5.4-ubi8# 4. 等待启动完成(约 10 秒后执行后续命令)docker logs --tail 5 ivorysql-verify# 5. 连接数据库(后续所有操作在此会话内执行)docker exec -it ivorysql-verify psql -U ivorysql -d ivorysql
扩展安装:pgvector / AGE / pg_bigm / pg_textsearch
上文 6.1 用官方
5.4-ubi8启动的ivorysql-verify容器,标准镜像 仅预装 Oracle 兼容基础扩展(ivorysql_ora、liboracle_parser、gb18030_2022), 未预装任何多模扩展。因此下文需从源码编译安装全部四个扩展(pgvector + AGE + pg_bigm + pg_textsearch)。以下操作均在容器内执行(docker exec -it ivorysql-verify bash进入)。
1. 安装编译工具(一次执行)
dnf install -y gcc gcc-c++ make bison flex git readline-devel zlib-devel
2. pgvector —— 向量检索
cd /tmp
git clone --depth 1 --branch v0.8.5 https://github.com/pgvector/pgvector.git pgvector-buildcd pgvector-build
PG_CONFIG=/var/local/ivorysql/ivorysql-5/bin/pg_config
make PG_CONFIG=$PG_CONFIG && make PG_CONFIG=$PG_CONFIG install
3. Apache AGE —— 图数据库扩展
AGE 为 PostgreSQL 增加 openCypher 图查询能力,支持属性图模型和
Cypher + SQL 混合查询。
cd /tmp
git clone --depth 1 --branch PG18/v1.7.0-rc0 https://github.com/apache/age.git age-buildcd age-build
PG_CONFIG=/var/local/ivorysql/ivorysql-5/bin/pg_config
make PG_CONFIG=$PG_CONFIG && make PG_CONFIG=$PG_CONFIG install
4. pg_bigm —— 中日韩二元分词
pg_bigm 通过 2-gram 滑动窗口将中英文字符统一切片,无需词典即可实现
高效模糊搜索。
cd /tmp
git clone --depth 1 https://github.com/pgbigm/pg_bigm.git pg_bigm-buildcd pg_bigm-build
INCDIR=$(/var/local/ivorysql/ivorysql-5/bin/pg_config --includedir-server)
PKGLIB=$(/var/local/ivorysql/ivorysql-5/bin/pg_config --pkglibdir)
SHAREDIR=$(/var/local/ivorysql/ivorysql-5/bin/pg_config --sharedir)/extension
gcc -fPIC -O2 -I$INCDIR -c bigm_op.c bigm_gin.c
gcc -shared -o pg_bigm.so bigm_op.o bigm_gin.ocp pg_bigm.so $PKGLIB/cp *.sql pg_bigm.control $SHAREDIR/
注意:pg_bigm 的
make依赖 PGXS(镜像中缺省),上述命令改用直接 gcc 编译绕过此限制。
5. pg_textsearch —— BM25 全文检索
pg_textsearch 为 PostgreSQL 引入 BM25(Best Match 25)相关性排序算法,支持
短语检索和 Top-K 查询。本文使用其 v0.6.1 源码编译(早期版本,v1.x 已发布稳定版)。
cd /tmp
git clone --depth 1 https://github.com/timescale/pg_textsearch.git pg_textsearch-buildcd pg_textsearch-build
git fetch --tags && git checkout v0.6.1
PG_CONFIG=/var/local/ivorysql/ivorysql-5/bin/pg_config
make PG_CONFIG=$PG_CONFIG && make PG_CONFIG=$PG_CONFIG install
pg_textsearch 与 Apache AGE 均需在
ivorysql.conf中配置shared_preload_libraries并重启数据库。AGE 的内存钩子和事务钩子若不在启动时挂载,会话级LOAD 'age'仅能临时使用,存在内存泄漏风险—— 生产环境必须预加载。
# 把 age 和 pg_textsearch 一起加到预加载列表sed -i "s/shared_preload_libraries = .*/shared_preload_libraries = 'gb18030_2022, liboracle_parser, ivorysql_ora, age, pg_textsearch'/" \
  /var/local/ivorysql/ivorysql-5/data/ivorysql.conf# 退出容器后执行重启exitdocker restart ivorysql-verify# 等待约 5 秒,重新进入数据库docker exec -it ivorysql-verify psql -U ivorysql -d ivorysql
安装验证:
SELECT name FROM pg_available_extensionsWHERE name IN ('vector','age','pg_bigm','pg_textsearch');-- 应返回 vector | age | pg_bigm | pg_textsearch 四条
运行时验证(数据库启动后确认所有扩展加载成功):
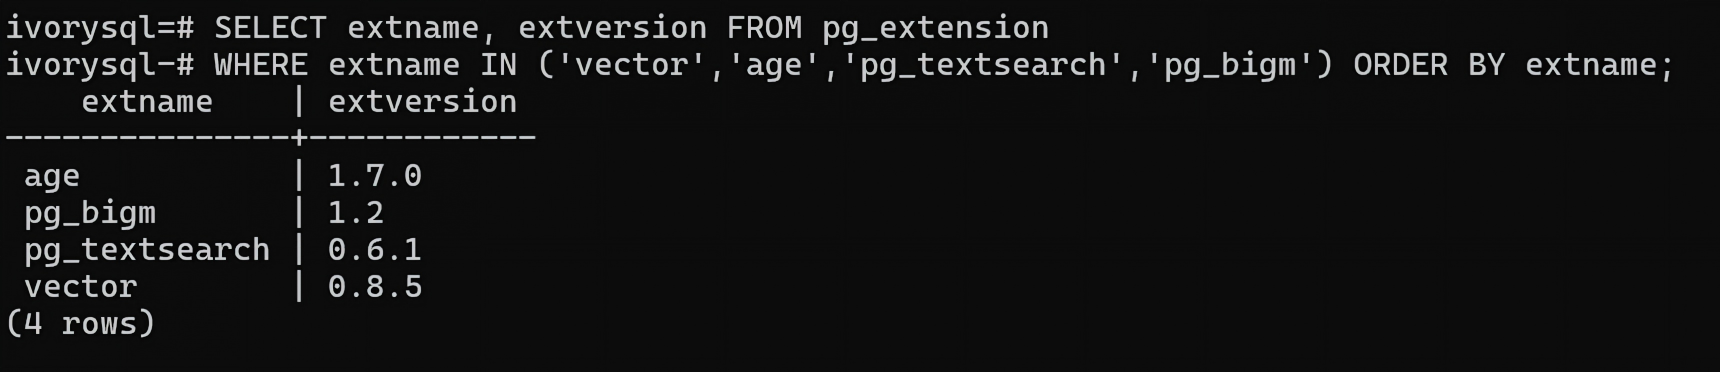
SELECT extname, extversion FROM pg_extensionWHERE extname IN ('vector','age','pg_textsearch','pg_bigm') ORDER BY extname;-- 应返回 age | pg_bigm | pg_textsearch | vector 四条
以下所有操作均在此 psql 会话中执行,请勿中途切换实例。
6.2 向量检索(pgvector)
验证场景:模拟电商商品推荐——5 个商品(3 款电子产品 + 2 款鞋包),每条商品对应一个 120 维特征向量。验证目标:1)余弦/欧氏两种距离能否正确排序相似商品;2)HNSW 索引能否加速查询;3)WHERE 条件过滤能否精确排除无关品类。
读者指引:以下每个操作包含 SQL 命令、预期输出和截图预留位置。
操作 1-1:创建 pgvector 扩展
CREATE EXTENSION IF NOT EXISTS vector;
预期输出:
CREATE EXTENSION 或
NOTICE: extension "vector" already exists, skipping
操作 1-2:创建商品向量表
CREATE TABLE product_vectors (
    id SERIAL PRIMARY KEY,
    product_name VARCHAR(100),
    category VARCHAR(50),
    embedding vector(120)
);
验证:
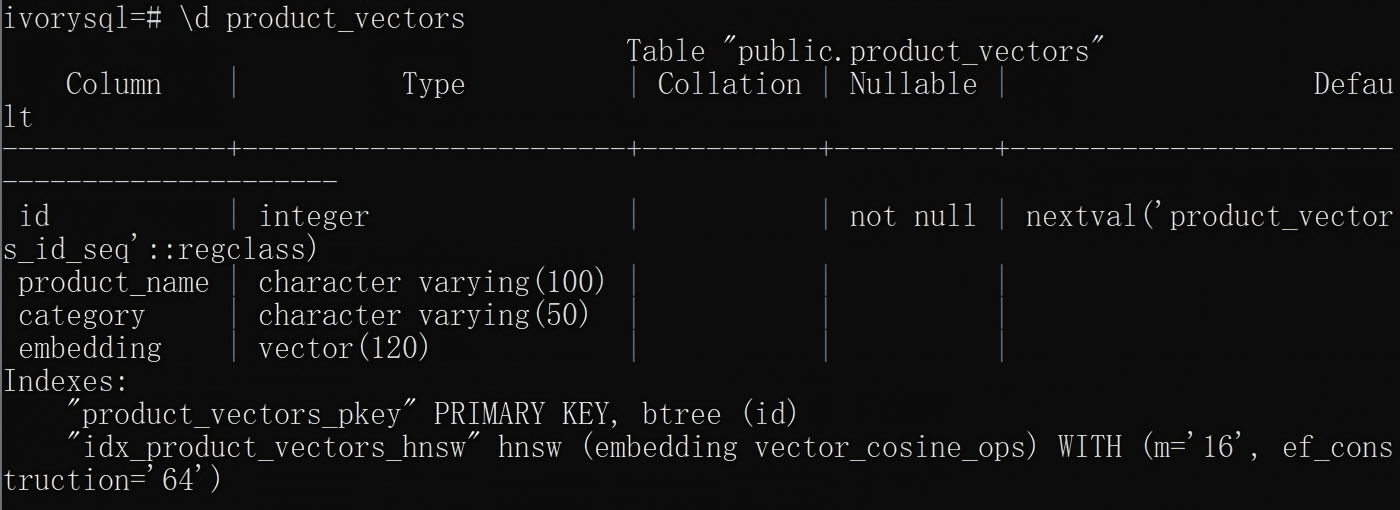
\d product_vectors
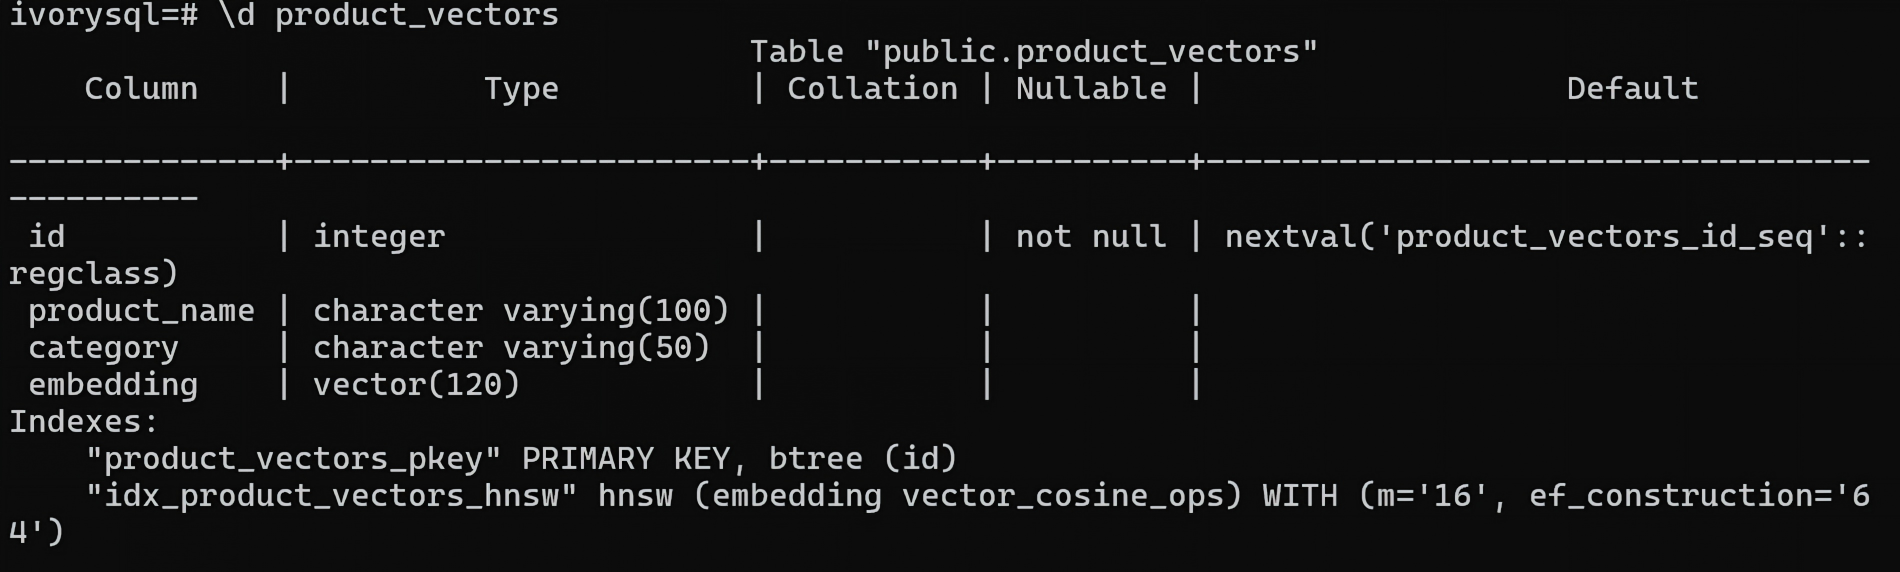
| 列名 | 类型 | 说明 |
|---|---|---|
| id | integer | 自增主键 |
| product_name | varchar(100) | 商品名称 |
| category | varchar(50) | 商品类别 |
| embedding | vector(120) | 120 维特征向量(演示用,生产可换 768/1536 维 Embedding) |
操作 1-3:插入 5 条测试数据
INSERT INTO product_vectors (product_name, category, embedding) VALUES('智能手表 Pro', '电子产品', '[0.12, 0.34, 0.56, 0.78, 0.91, 0.23, 0.45, 0.67, 0.89, 0.01, 0.12, 0.34, 0.56, 0.78, 0.91, 0.23, 0.45, 0.67, 0.89, 0.01, 0.12, 0.34, 0.56, 0.78, 0.91, 0.23, 0.45, 0.67, 0.89, 0.01, 0.12, 0.34, 0.56, 0.78, 0.91, 0.23, 0.45, 0.67, 0.89, 0.01, 0.12, 0.34, 0.56, 0.78, 0.91, 0.23, 0.45, 0.67, 0.89, 0.01, 0.12, 0.34, 0.56, 0.78, 0.91, 0.23, 0.45, 0.67, 0.89, 0.01, 0.12, 0.34, 0.56, 0.78, 0.91, 0.23, 0.45, 0.67, 0.89, 0.01, 0.12, 0.34, 0.56, 0.78, 0.91, 0.23, 0.45, 0.67, 0.89, 0.01, 0.12, 0.34, 0.56, 0.78, 0.91, 0.23, 0.45, 0.67, 0.89, 0.01, 0.12, 0.34, 0.56, 0.78, 0.91, 0.23, 0.45, 0.67, 0.89, 0.01, 0.12, 0.34, 0.56, 0.78, 0.91, 0.23, 0.45, 0.67, 0.89, 0.01, 0.12, 0.34, 0.56, 0.78, 0.91, 0.23, 0.45, 0.67, 0.89, 0.01, 0.12, 0.34, 0.56, 0.78, 0.91, 0.23, 0.45, 0.67, 0.89, 0.01]'),
('运动手环',     '电子产品', '[0.11, 0.33, 0.55, 0.77, 0.90, 0.22, 0.44, 0.66, 0.88, 0.02, 0.11, 0.33, 0.55, 0.77, 0.90, 0.22, 0.44, 0.66, 0.88, 0.02, 0.11, 0.33, 0.55, 0.77, 0.90, 0.22, 0.44, 0.66, 0.88, 0.02, 0.11, 0.33, 0.55, 0.77, 0.90, 0.22, 0.44, 0.66, 0.88, 0.02, 0.11, 0.33, 0.55, 0.77, 0.90, 0.22, 0.44, 0.66, 0.88, 0.02, 0.11, 0.33, 0.55, 0.77, 0.90, 0.22, 0.44, 0.66, 0.88, 0.02, 0.11, 0.33, 0.55, 0.77, 0.90, 0.22, 0.44, 0.66, 0.88, 0.02, 0.11, 0.33, 0.55, 0.77, 0.90, 0.22, 0.44, 0.66, 0.88, 0.02, 0.11, 0.33, 0.55, 0.77, 0.90, 0.22, 0.44, 0.66, 0.88, 0.02, 0.11, 0.33, 0.55, 0.77, 0.90, 0.22, 0.44, 0.66, 0.88, 0.02, 0.11, 0.33, 0.55, 0.77, 0.90, 0.22, 0.44, 0.66, 0.88, 0.02, 0.11, 0.33, 0.55, 0.77, 0.90, 0.22, 0.44, 0.66, 0.88, 0.02, 0.11, 0.33, 0.55, 0.77, 0.90, 0.22, 0.44, 0.66, 0.88, 0.02]'),
('真 皮皮鞋',     '服饰鞋包', '[0.05, 0.15, 0.25, 0.35, 0.45, 0.55, 0.65, 0.75, 0.85, 0.95, 0.05, 0.15, 0.25, 0.35, 0.45, 0.55, 0.65, 0.75, 0.85, 0.95, 0.05, 0.15, 0.25, 0.35, 0.45, 0.55, 0.65, 0.75, 0.85, 0.95, 0.05, 0.15, 0.25, 0.35, 0.45, 0.55, 0.65, 0.75, 0.85, 0.95, 0.05, 0.15, 0.25, 0.35, 0.45, 0.55, 0.65, 0.75, 0.85, 0.95, 0.05, 0.15, 0.25, 0.35, 0.45, 0.55, 0.65, 0.75, 0.85, 0.95, 0.05, 0.15, 0.25, 0.35, 0.45, 0.55, 0.65, 0.75, 0.85, 0.95, 0.05, 0.15, 0.25, 0.35, 0.45, 0.55, 0.65, 0.75, 0.85, 0.95, 0.05, 0.15, 0.25, 0.35, 0.45, 0.55, 0.65, 0.75, 0.85, 0.95, 0.05, 0.15, 0.25, 0.35, 0.45, 0.55, 0.65, 0.75, 0.85, 0.95, 0.05, 0.15, 0.25, 0.35, 0.45, 0.55, 0.65, 0.75, 0.85, 0.95, 0.05, 0.15, 0.25, 0.35, 0.45, 0.55, 0.65, 0.75, 0.85, 0.95, 0.05, 0.15, 0.25, 0.35, 0.45, 0.55, 0.65, 0.75, 0.85, 0.95]'),
('跑步运动鞋',   '服饰鞋包', '[0.06, 0.16, 0.26, 0.36, 0.46, 0.56, 0.66, 0.76, 0.86, 0.96, 0.06, 0.16, 0.26, 0.36, 0.46, 0.56, 0.66, 0.76, 0.86, 0.96, 0.06, 0.16, 0.26, 0.36, 0.46, 0.56, 0.66, 0.76, 0.86, 0.96, 0.06, 0.16, 0.26, 0.36, 0.46, 0.56, 0.66, 0.76, 0.86, 0.96, 0.06, 0.16, 0.26, 0.36, 0.46, 0.56, 0.66, 0.76, 0.86, 0.96, 0.06, 0.16, 0.26, 0.36, 0.46, 0.56, 0.66, 0.76, 0.86, 0.96, 0.06, 0.16, 0.26, 0.36, 0.46, 0.56, 0.66, 0.76, 0.86, 0.96, 0.06, 0.16, 0.26, 0.36, 0.46, 0.56, 0.66, 0.76, 0.86, 0.96, 0.06, 0.16, 0.26, 0.36, 0.46, 0.56, 0.66, 0.76, 0.86, 0.96, 0.06, 0.16, 0.26, 0.36, 0.46, 0.56, 0.66, 0.76, 0.86, 0.96, 0.06, 0.16, 0.26, 0.36, 0.46, 0.56, 0.66, 0.76, 0.86, 0.96, 0.06, 0.16, 0.26, 0.36, 0.46, 0.56, 0.66, 0.76, 0.86, 0.96, 0.06, 0.16, 0.26, 0.36, 0.46, 0.56, 0.66, 0.76, 0.86, 0.96]'),
('无线耳机',     '电子产品', '[0.13, 0.35, 0.57, 0.79, 0.92, 0.24, 0.46, 0.68, 0.90, 0.02, 0.13, 0.35, 0.57, 0.79, 0.92, 0.24, 0.46, 0.68, 0.90, 0.02, 0.13, 0.35, 0.57, 0.79, 0.92, 0.24, 0.46, 0.68, 0.90, 0.02, 0.13, 0.35, 0.57, 0.79, 0.92, 0.24, 0.46, 0.68, 0.90, 0.02, 0.13, 0.35, 0.57, 0.79, 0.92, 0.24, 0.46, 0.68, 0.90, 0.02, 0.13, 0.35, 0.57, 0.79, 0.92, 0.24, 0.46, 0.68, 0.90, 0.02, 0.13, 0.35, 0.57, 0.79, 0.92, 0.24, 0.46, 0.68, 0.90, 0.02, 0.13, 0.35, 0.57, 0.79, 0.92, 0.24, 0.46, 0.68, 0.90, 0.02, 0.13, 0.35, 0.57, 0.79, 0.92, 0.24, 0.46, 0.68, 0.90, 0.02, 0.13, 0.35, 0.57, 0.79, 0.92, 0.24, 0.46, 0.68, 0.90, 0.02, 0.13, 0.35, 0.57, 0.79, 0.92, 0.24, 0.46, 0.68, 0.90, 0.02, 0.13, 0.35, 0.57, 0.79, 0.92, 0.24, 0.46, 0.68, 0.90, 0.02, 0.13, 0.35, 0.57, 0.79, 0.92, 0.24, 0.46, 0.68, 0.90, 0.02]');
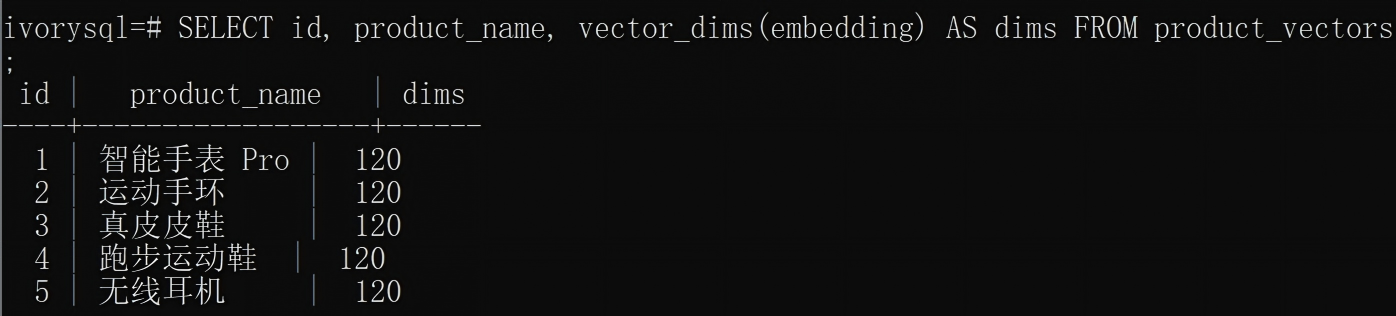
说明:120 维向量由
vector_dims=10的特征重复 12 次构造,便于人工核对(不会改变查询语义)。生产环境请替换为 Embedding 模型输出的真实 768/1536 维向量。
SELECT id, product_name, vector_dims(embedding) AS dims FROM product_vectors;
| id | product_name | dims |
|---|---|---|
| 1 | 智能手表 Pro | 120 |
| 2 | 运动手环 | 120 |
| 3 | 真 皮皮鞋 | 120 |
| 4 | 跑步运动鞋 | 120 |
| 5 | 无线耳机 | 120 |
操作 1-4:创建 HNSW 索引
CREATE INDEX idx_product_vectors_hnsw ON product_vectorsUSING hnsw (embedding vector_cosine_ops)WITH (m = 16, ef_construction = 64);
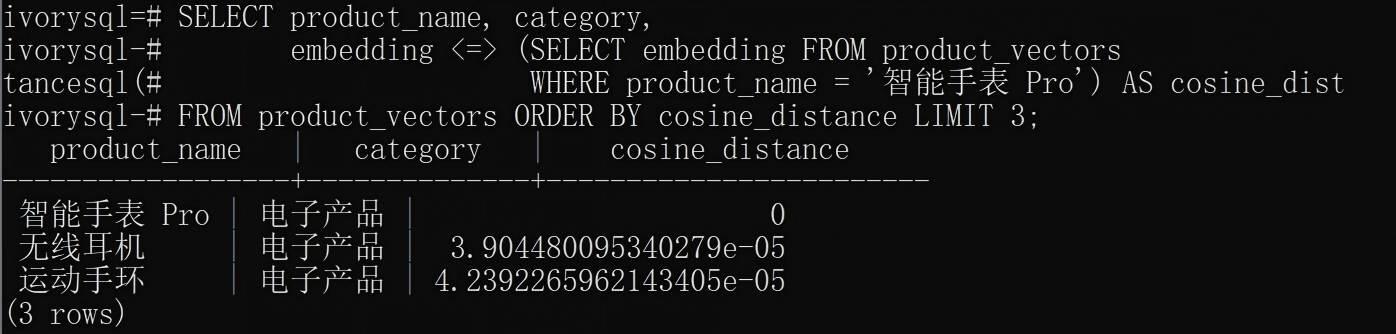
操作 1-5:余弦距离查询
SELECT product_name, category,
       embedding <=> (SELECT embedding FROM product_vectors                      WHERE product_name = '智能手表 Pro') AS cosine_distanceFROM product_vectors ORDER BY cosine_distance LIMIT 3;
| product_name | category | cosine_distance |
|---|---|---|
| 智能手表 Pro | 电子产品 | 0.000000 |
| 无线耳机 | 电子产品 | 0.000039 |
| 运动手环 | 电子产品 | 0.000042 |
| 跑步运动鞋 | 服饰鞋包 | 0.230686 |
| 真 皮皮鞋 | 服饰鞋包 | 0.233892 |
余弦距离接近 0 = 向量方向越相似。
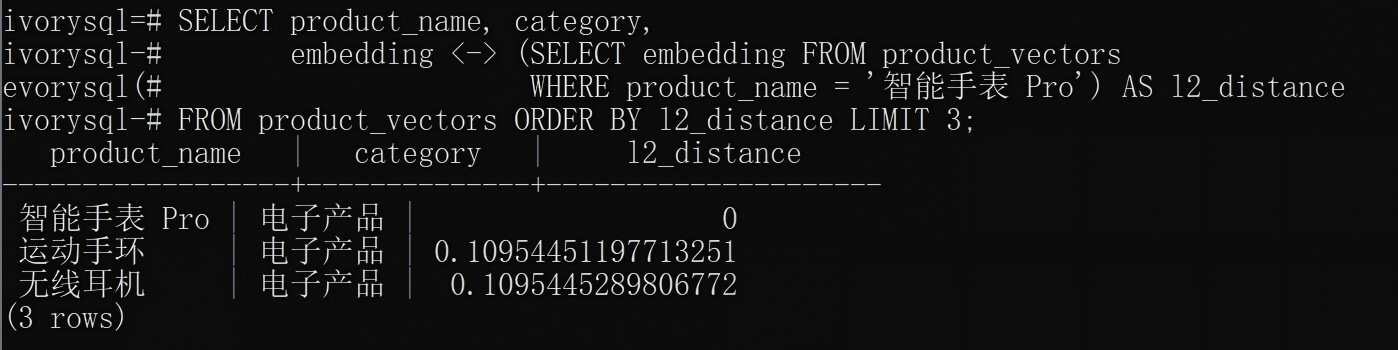
操作 1-6:欧氏距离查询
SELECT product_name, category,
       embedding <-> (SELECT embedding FROM product_vectors                      WHERE product_name = '智能手表 Pro') AS l2_distanceFROM product_vectors ORDER BY l2_distance LIMIT 3;
| product_name | category | l2_distance |
|---|---|---|
| 智能手表 Pro | 电子产品 | 0.000000 |
| 运动手环 | 电子产品 | 0.109545 |
| 无线耳机 | 电子产品 | 0.109545 |
| 真 皮皮鞋 | 服饰鞋包 | 4.337188 |
| 跑步运动鞋 | 服饰鞋包 | 4.339677 |
欧氏与余弦排序不同,两种度量各有侧重。
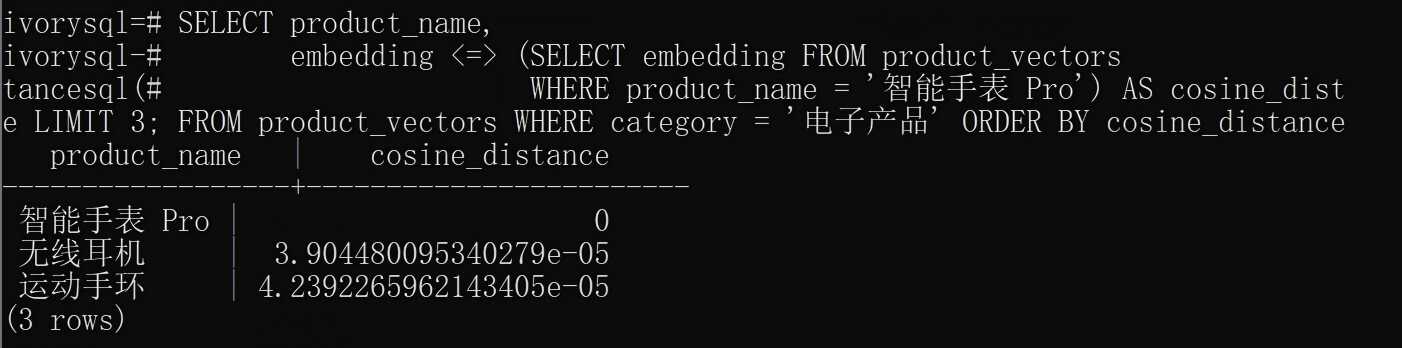
操作 1-7:类别过滤查询
SELECT product_name,
       embedding <=> (SELECT embedding FROM product_vectors                      WHERE product_name = '智能手表 Pro') AS cosine_distanceFROM product_vectors WHERE category = '电子产品' ORDER BY cosine_distance LIMIT 3;
✅ 向量检索验证完成。
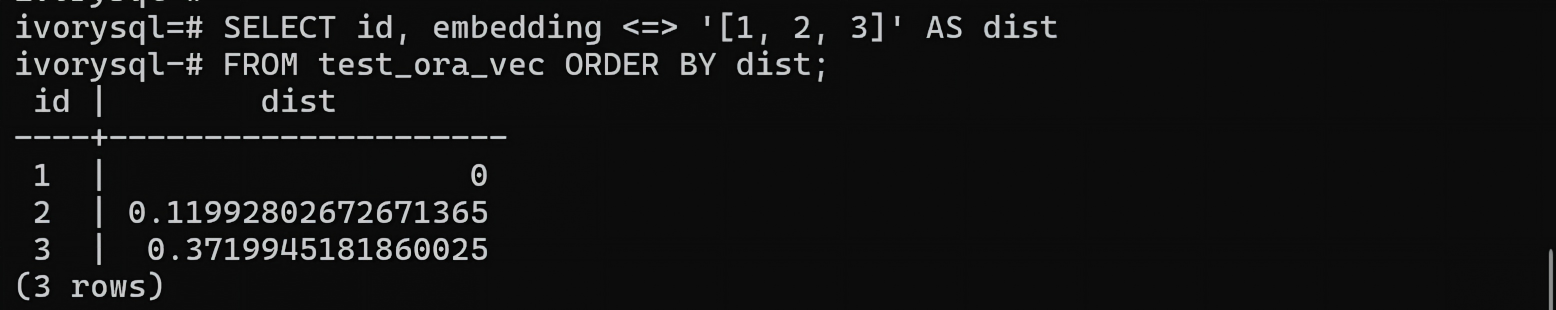
操作 1-8:Oracle 兼容模式验证
验证 pgvector 在 IvorySQL 的 Oracle 兼容模式下同样可用,包括 number 类型主键、Oracle 风格的字符串引号。
-- 1. 切换到 Oracle 兼容模式SET ivorysql.compatible_mode = oracle;-- 2. 创建测试表(number 类型主键,vector 字段)CREATE TABLE test_ora_vec (id number, embedding vector(3));-- 3. 插入数据(Oracle 风格使用单引号)INSERT INTO test_ora_vec VALUES (1, '[1, 2, 3]');INSERT INTO test_ora_vec VALUES (2, '[1, 1, 9]');INSERT INTO test_ora_vec VALUES (3, '[9, 9, 1]');-- 4. 余弦距离排序SELECT id, embedding <=> '[1, 2, 3]' AS distFROM test_ora_vec ORDER BY dist;-- 5. 切回 PG 模式SET ivorysql.compatible_mode = pg;-- 6. 清理DROP TABLE test_ora_vec;
6.3 知识图谱(Apache AGE)
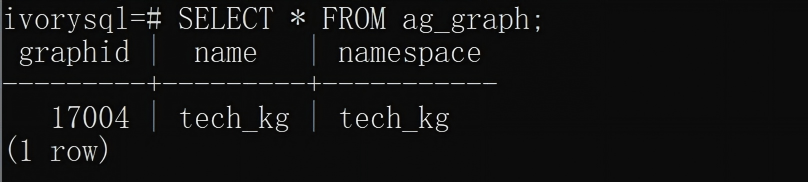
验证场景:构建一个简化的"IvorySQL 技术生态图谱"——用节点表示数据库产品和提供方,用边表示"基于"和"集成"关系。验证目标:1)Cypher 创建节点与关系的基本操作;2)MATCH 图查询能否返回正确的实体关系;3)多跳遍历(1 ~ 3 跳)能否沿关系链路发现间接关联。最后形成一张可供路径遍历的小型知识图谱。
⚠️ 重要:Apache AGE 的所有函数(
create_graph、cypher等)位于ag_catalog模式中。新 psql 会话需要 三步初始化:CREATE EXTENSION→LOAD 'age'→SET search_path——缺一不可。否则会报function cypher(unknown) does not exist或unhandled cypher(cstring) function call。
操作 2-1:创建扩展与知识图谱
-- 1. 创建扩展CREATE EXTENSION IF NOT EXISTS age;-- 2. 加载扩展库(关键!否则 cypher() 会报 function not found)LOAD 'age';-- 3. 设置 search_path(关键!每次新会话都需要执行)SET search_path = ag_catalog, "$user", public;-- 4. 创建知识图谱SELECT create_graph('tech_kg');-- 5. 查看所有图SELECT * FROM ag_graph;
操作 2-2:创建节点
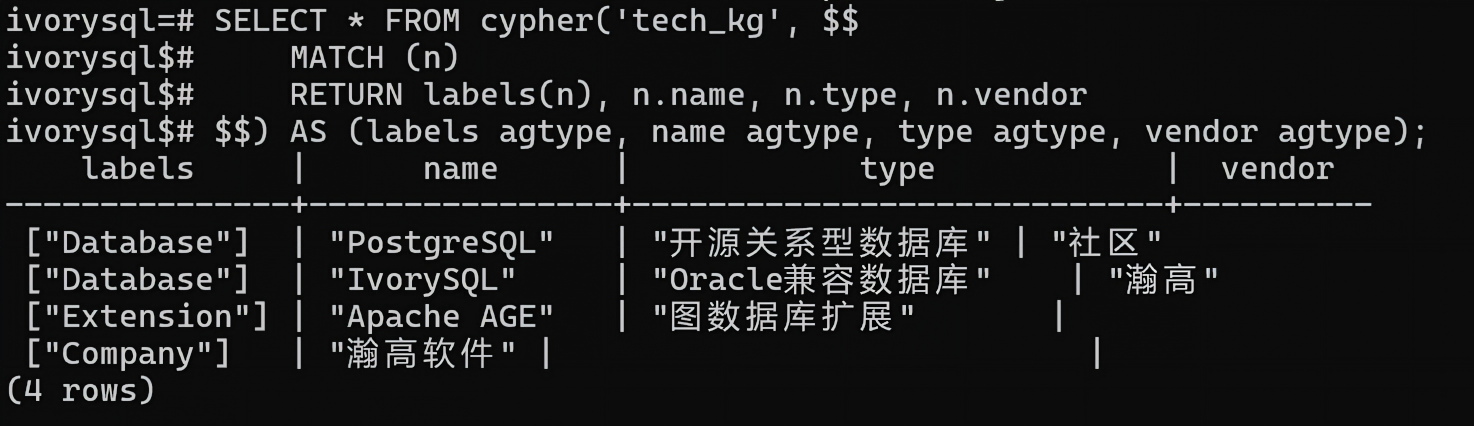
一次性批量创建 4 个节点(3 个数据库/扩展产品节点 + 1 个公司节点),Cypher 支持
CREATE后接多个节点。
-- 批量创建所有节点SELECT * FROM cypher('tech_kg', $$    CREATE
    (pg:Database {name: 'PostgreSQL', type: '开源关系型数据库', vendor: '社区'}),
    (ivory:Database {name: 'IvorySQL', type: 'Oracle兼容数据库', vendor: '瀚高'}),
    (age_ext:Extension {name: 'Apache AGE', type: '图数据库扩展'}),
    (hg:Company {name: '瀚高软件', country: '中国', focus: '数据库'})    RETURN labels(n), n.name
$$) AS (labels agtype, name agtype);
-- 列出所有节点的标签和名称SELECT * FROM cypher('tech_kg', $$    MATCH (n)    RETURN labels(n), n.name, n.type, n.vendor
$$) AS (labels agtype, name agtype, type agtype, vendor agtype);
操作 2-3:创建关系
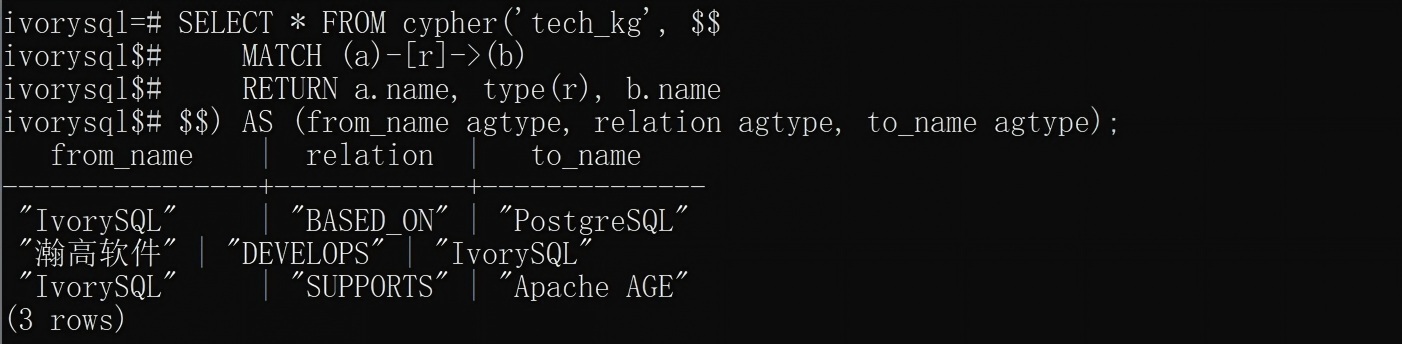
三条关系构成一个可遍历的图谱:公司 → 产品 → 底层 + 公司 → 产品 → 扩展。
-- IvorySQL 基于 PostgreSQL 内核SELECT * FROM cypher('tech_kg', $$    MATCH (ivory:Database {name: 'IvorySQL'}), (pg:Database {name: 'PostgreSQL'})    CREATE (ivory)-[r:BASED_ON {since: '2021', relationship: '内核分支'}]->(pg)    RETURN r
$$) AS (rel agtype);-- IvorySQL 集成 Apache AGE 扩展SELECT * FROM cypher('tech_kg', $$    MATCH (ivory:Database {name: 'IvorySQL'}), (age_ext:Extension {name: 'Apache AGE'})    CREATE (ivory)-[r:SUPPORTS {since: '2024', feature: '图数据库'}]->(age_ext)    RETURN r
$$) AS (rel agtype);-- 瀚高软件 开发 IvorySQL(多跳的关键边)SELECT * FROM cypher('tech_kg', $$    MATCH (hg:Company {name: '瀚高软件'}), (ivory:Database {name: 'IvorySQL'})    CREATE (hg)-[r:DEVELOPS {since: '2021', role: '主导开发'}]->(ivory)    RETURN r
$$) AS (rel agtype);-- 查看所有关系SELECT * FROM cypher('tech_kg', $$    MATCH (a)-[r]->(b)    RETURN a.name, type(r), b.name
$$) AS (from_name agtype, relation agtype, to_name agtype);
操作 2-4:图查询
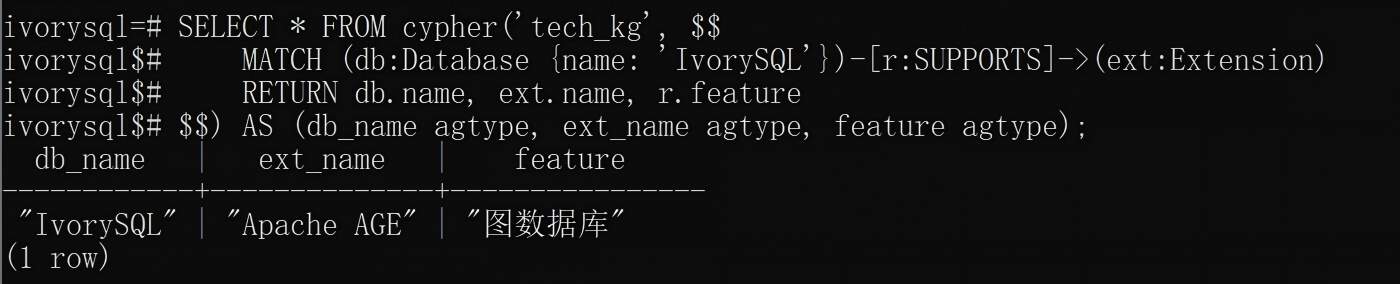
SELECT * FROM cypher('tech_kg', $$    MATCH (db:Database {name: 'IvorySQL'})-[r:SUPPORTS]->(ext:Extension)    RETURN db.name, ext.name, r.feature
$$) AS (db_name agtype, ext_name agtype, feature agtype);
| db_name | ext_name | feature |
|---|---|---|
| “IvorySQL” | “Apache AGE” | “图数据库” |
操作 2-5:多跳路径
有了公司 → 产品这条边后,多跳才真正有意义——从公司出发经 2 跳到达技术和扩展。
-- 查询所有 2 跳路径(公司 -> 产品 -> 技术/扩展)SELECT * FROM cypher('tech_kg', $$    MATCH path = (a)-[*2]->(b)    RETURN a.name, b.name
$$) AS (from_name agtype, to_name agtype);
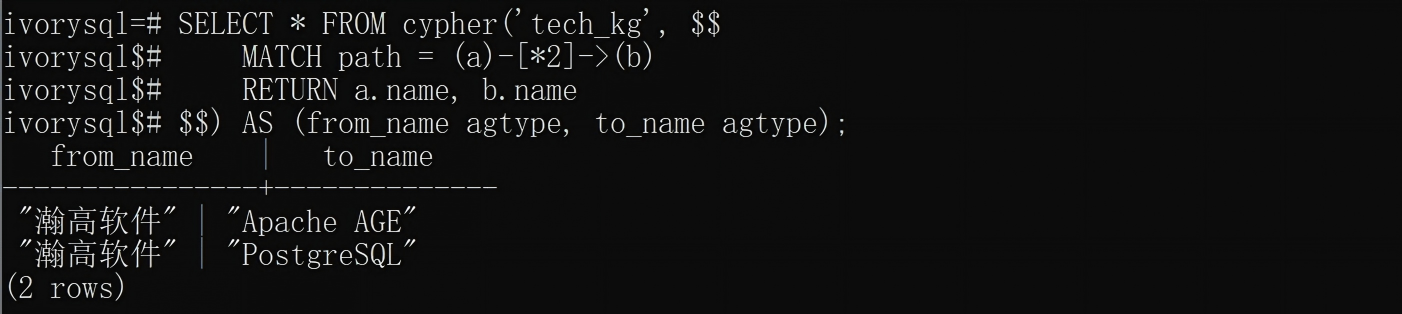
返回 2 条路径:
| 起点 | 终点 | 经过 |
|---|---|---|
| “瀚高软件” | “PostgreSQL” | 瀚高 → IvorySQL → PostgreSQL(2 跳) |
| “瀚高软件” | “Apache AGE” | 瀚高 → IvorySQL → Apache AGE(2 跳) |
这就是知识图谱的核心能力:从"瀚高"出发,经过 2 次关系跳转,发现它间接关联的 PostgreSQL 生态和图扩展。
如果后续添加更多节点(pgvector、pg_textsearch 等),多跳查询能自动发现更丰富的间接关系。
✅ 知识图谱验证完成。
6.4 pg_bigm 中文全文检索
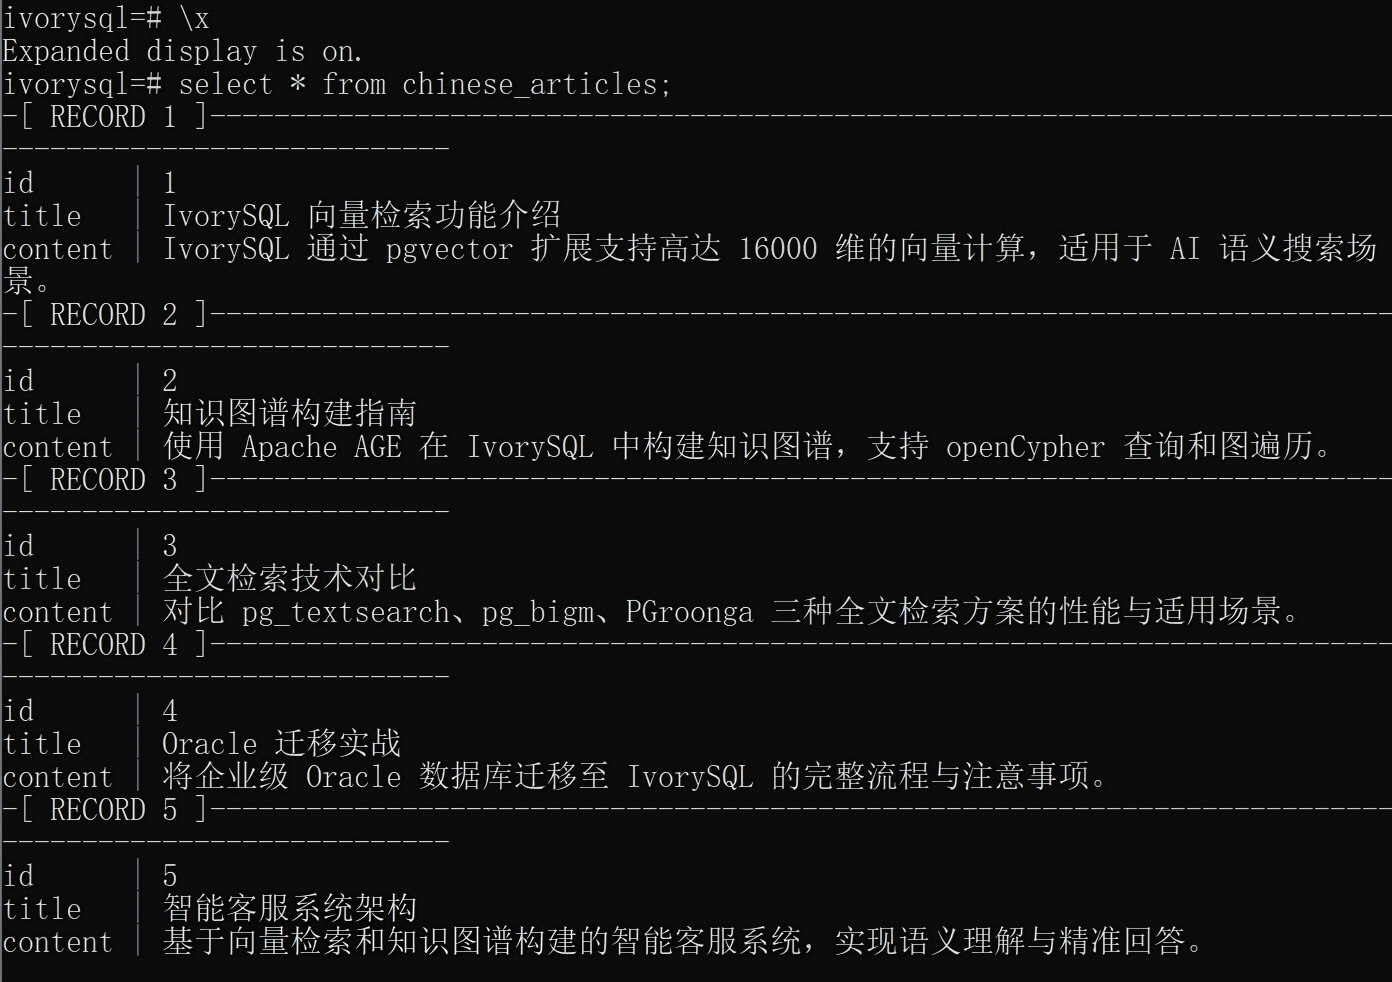
验证场景:5 篇中文技术文章,验证 pg_bigm 的二元分词(2-gram)能否在 不做词典分词的情况下对中文内容进行高效的模糊搜索和相似度匹配。
操作 3-1:创建扩展 + 数据表
CREATE EXTENSION IF NOT EXISTS pg_bigm;CREATE TABLE chinese_articles (id SERIAL PRIMARY KEY, title VARCHAR(200), content TEXT);INSERT INTO chinese_articles (title, content) VALUES('IvorySQL 向量检索功能介绍', 'IvorySQL 通过 pgvector 扩展支持高达 16000 维的向量计算,适用于 AI 语义搜索场景。'),
('知识图谱构建指南', '使用 Apache AGE 在 IvorySQL 中构建知识图谱,支持 openCypher 查询和图遍历。'),
('全文检索技术对比', '对比 pg_textsearch、pg_bigm、PGroonga 三种全文检索方案的性能与适用场景。'),
('Oracle 迁移实战', '将企业级 Oracle 数据库迁移至 IvorySQL 的完整流程与注意事项。'),
('智能客服系统架构', '基于向量检索和知识图谱构建的智能客服系统,实现语义理解与精准回答。');select * from chinese_articles;
操作 3-2:GIN 索引 + 模糊检索
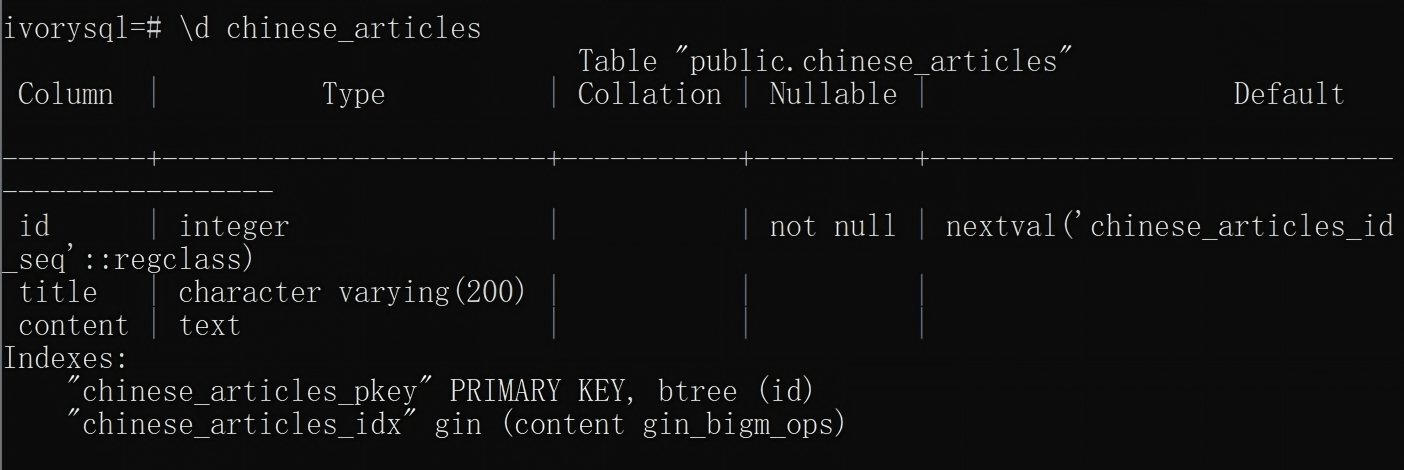
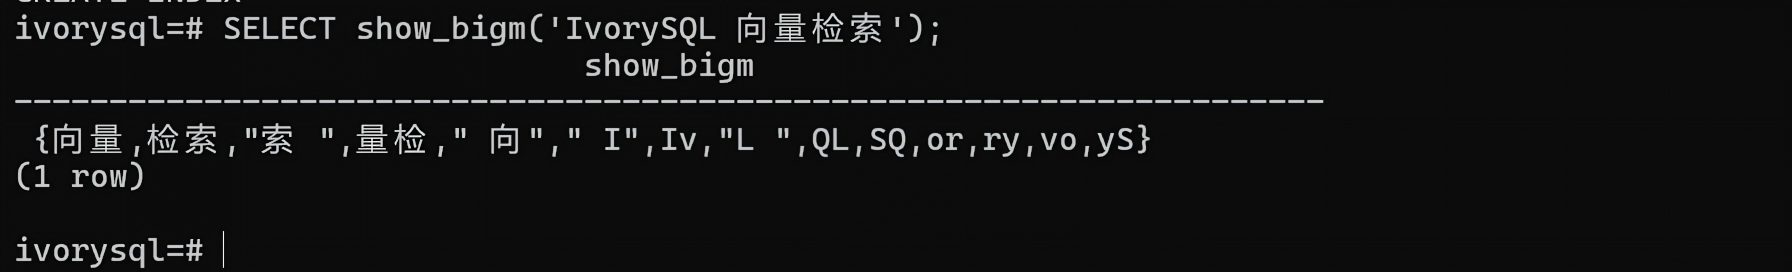
CREATE INDEX chinese_articles_idx ON chinese_articles USING gin (content gin_bigm_ops);SELECT id, title FROM chinese_articles WHERE content LIKE '%向量检索%';SELECT id, title FROM chinese_articles WHERE content LIKE likequery('知识图谱');SELECT show_bigm('IvorySQL 向量检索');
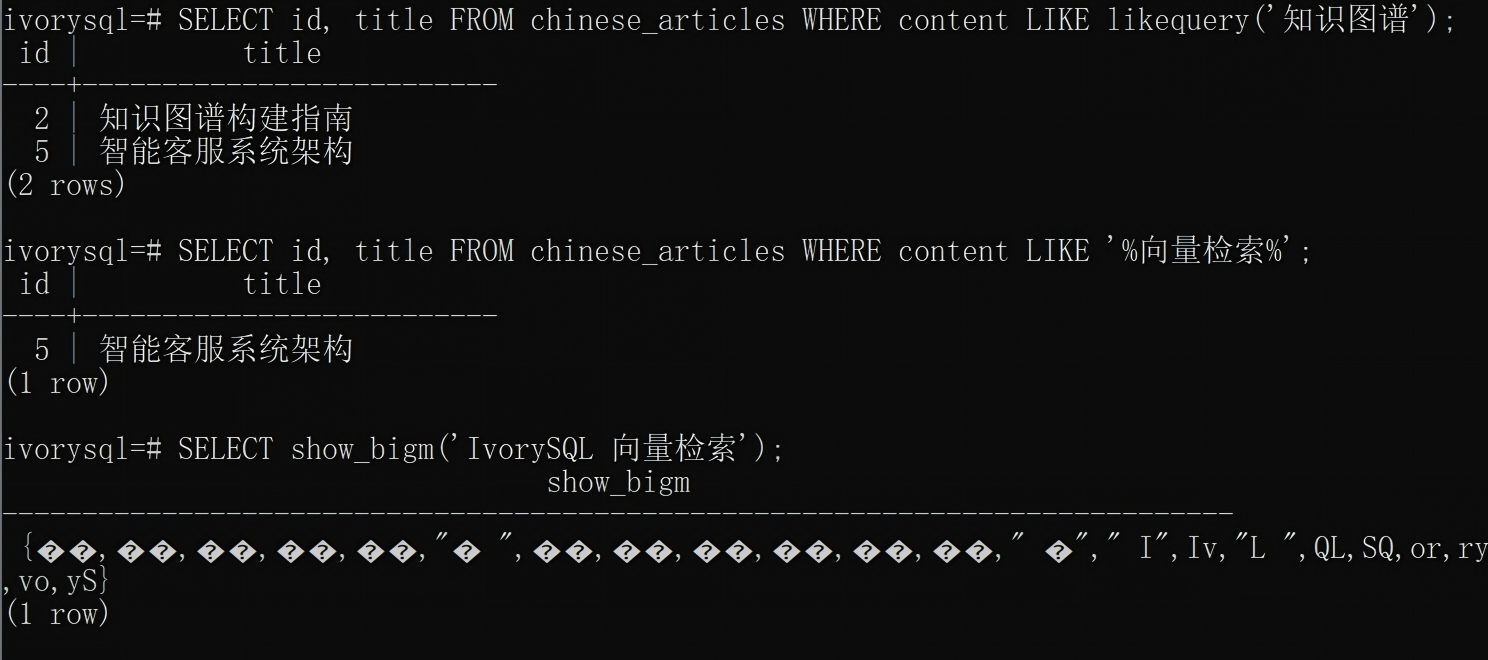
⚠️ 踩坑经验:若启动容器时未在
POSTGRES_INITDB_ARGS中显式指定编码,IvorySQL Docker 镜像会以 SQL_ASCII 初始化数据库,不处理多字节字符集——这种情况下show_bigm的中文输出会显示为方框/乱码。底层分词和检索逻辑(LIKE、likequery)完全正确命中,仅终端显示异常。本文启动命令已通过POSTGRES_INITDB_ARGS="--encoding=UTF8 --locale=C.utf8"指定 UTF-8 编码,可直接避免此问题;若复用的是未指定编码的旧容器,需重建并指定编码。
根治方案:启动容器时通过POSTGRES_INITDB_ARGS显式指定 UTF-8 编码(本文 6.1 节启动命令已包含该参数):
docker run --name ivorysql-verify1 \
-p 5434:5432 \
-e POSTGRES_INITDB_ARGS="--encoding=UTF8 --locale=C.utf8" \
-e IVORYSQL_PASSWORD=IvorySQL@2026 \
-d registry.highgo.com/ivorysql/ivorysql:5.4-ubi8
实际操作中无需重建已有容器——可另起一个 UTF-8 编码容器(如端口 5436),仅跑 6.3 的 SQL 获取干净
show_bigm输出即可。
✅ pg_bigm 验证完成。
6.5 BM25 全文检索(pg_textsearch)
验证场景:5 篇中英文混合技术文档,验证 pg_textsearch 的 BM25 索引创建和短语检索能力——能否在
text_config='english'配置下对英文关键词返回正确的相关性排序(负分数越负越好)。
pg_textsearch v0.6.1 在 IvorySQL 5.4 官方镜像中处于早期版本(v1.x 已有稳定版),CREATE EXTENSION 时会输出
WARNING: pg_textsearch v0.6.1 is a prerelease. Do not use in production.。 真实含义不是"绝对不能用"——BM25 算法本身成熟,代码可用,但:
- 升级版本时 API 可能变化,写的 SQL 未必向后兼容
- 无官方支持承诺,线上出问题未必能及时修复
- 性能未做深度调优
建议:开发测试环境放心用;生产部署前必须做压力测试和兼容性验证。
操作 4-1:建表、插入数据、创建 BM25 索引
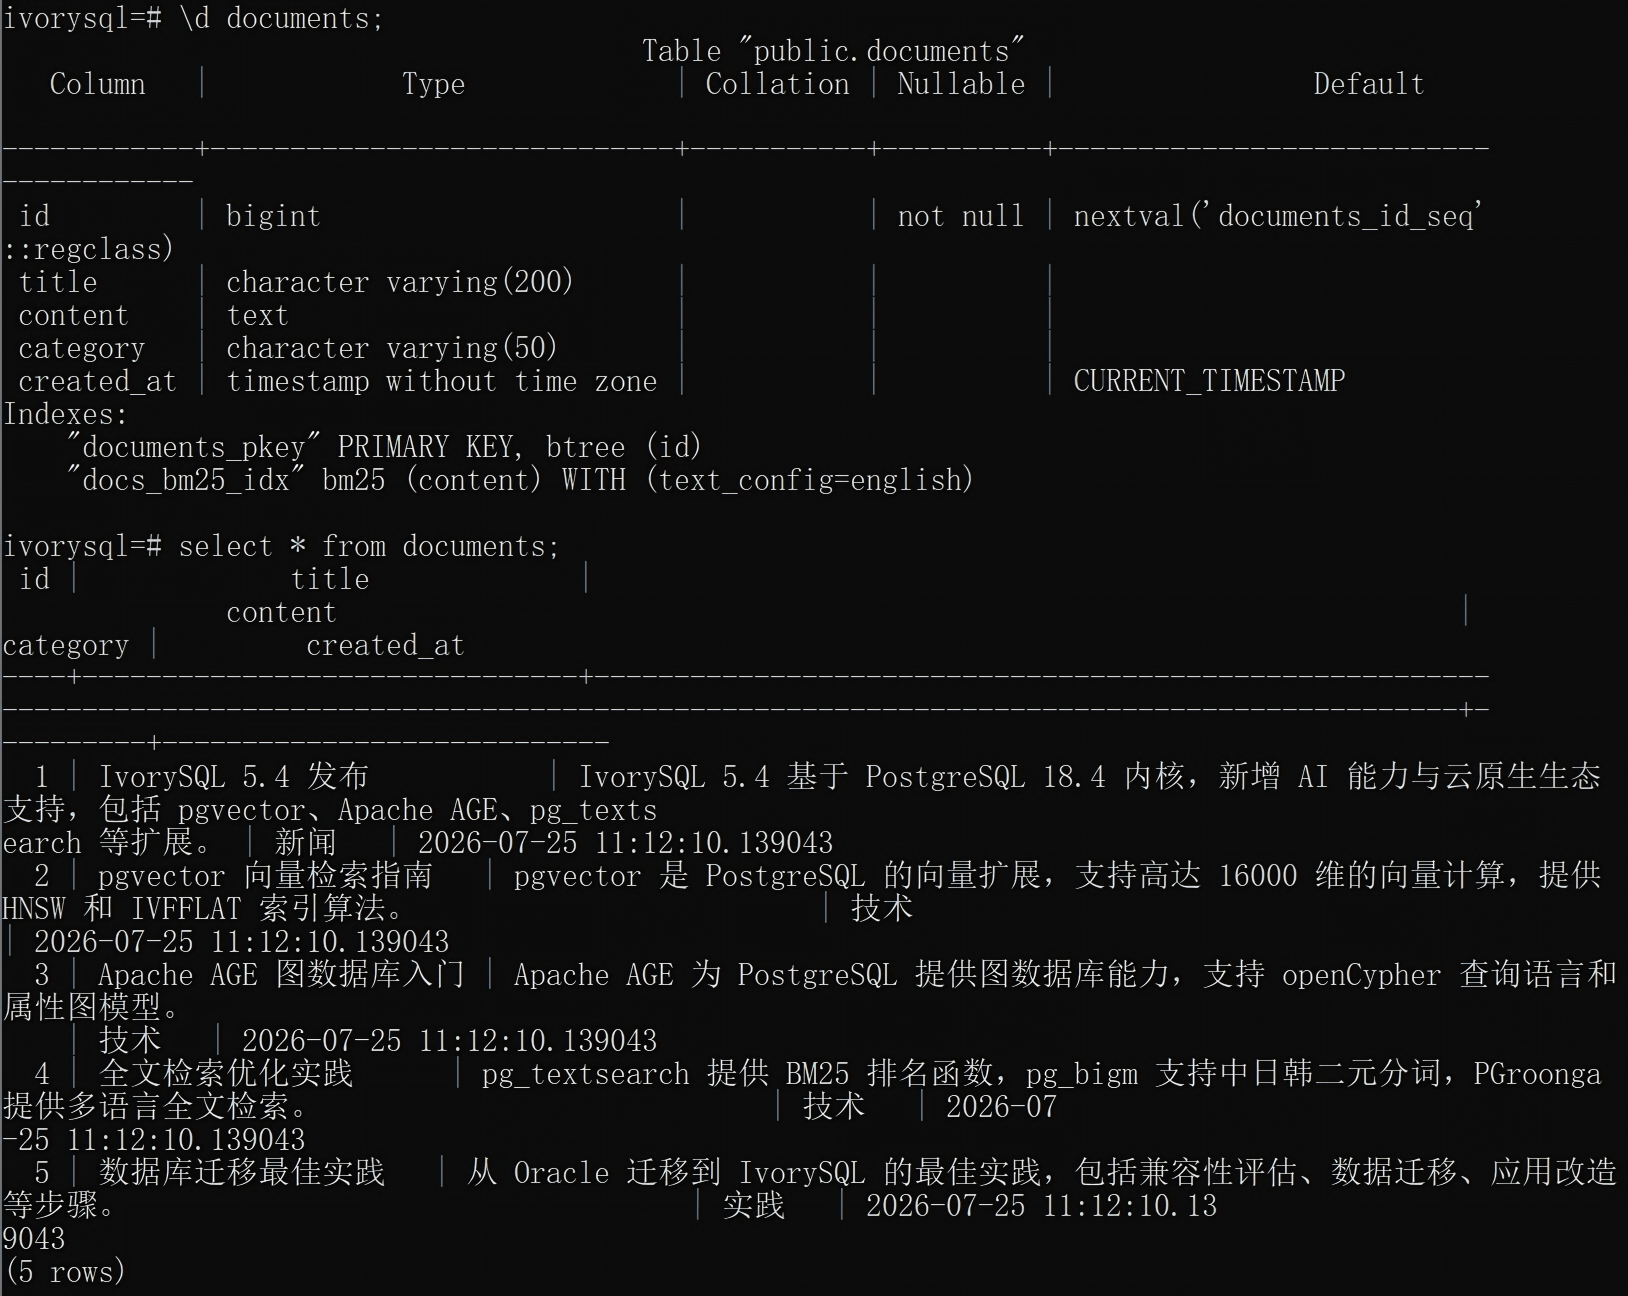
CREATE TABLE documents (id bigserial PRIMARY KEY, title VARCHAR(200), content text, category VARCHAR(50));INSERT INTO documents (title, content, category) VALUES('IvorySQL 5.4 发布', 'IvorySQL 5.4 基于 PostgreSQL 18.4 内核,新增 AI 能力与云原生生态支持,包括 pgvector、Apache AGE、pg_textsearch 等扩展。', '新闻'),
('pgvector 向量检索指南', 'pgvector 是 PostgreSQL 的向量扩展,支持高达 16000 维的向量计算,提供 HNSW 和 IVFFLAT 索引算法。', '技术'),
('Apache AGE 图数据库入门', 'Apache AGE 为 PostgreSQL 提供图数据库能力,支持 openCypher 查询语言和属性图模型。', '技术'),
('全文检索优化实践', 'pg_textsearch 提供 BM25 排名函数,pg_bigm 支持中日韩二元分词,PGroonga 提供多语言全文检索。', '技术'),
('数据库迁移最佳实践', '从 Oracle 迁移到 IvorySQL 的最佳实践,包括兼容性评估、数据迁移、应用改造等步骤。', '实践');CREATE INDEX docs_bm25_idx ON documents USING bm25(content) WITH (text_config='english');
\d documents;select * from documents;
操作 4-2:BM25 短语检索
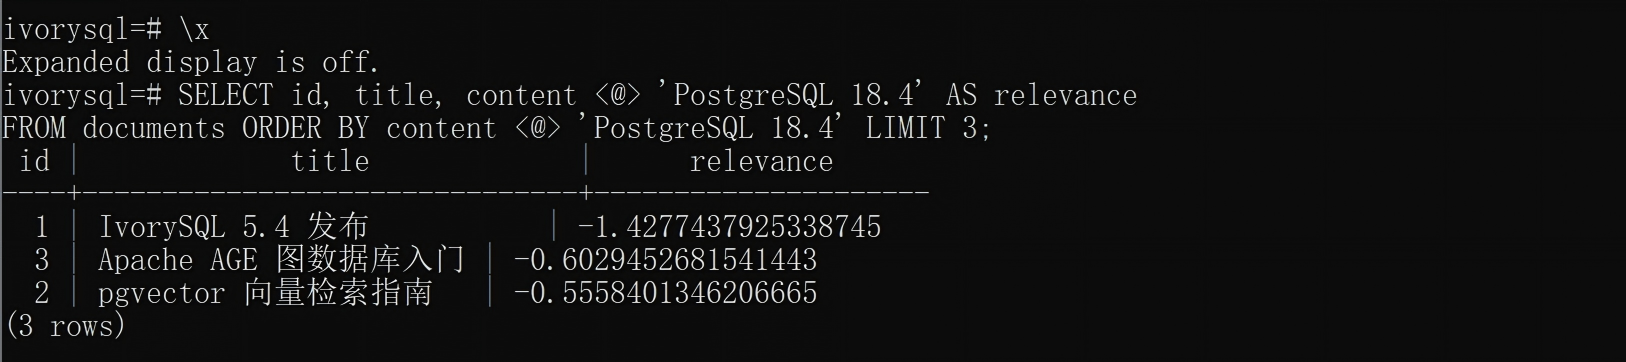
SELECT id, title, content <@> 'PostgreSQL 18.4' AS relevanceFROM documents ORDER BY content <@> 'PostgreSQL 18.4' LIMIT 3;
| id | title | relevance |
|---|---|---|
| 1 | IvorySQL 5.4 发布 | -1.43 |
| 3 | Apache AGE 图数据库入门 | -0.60 |
| 2 | pgvector 向量检索指南 | -0.56 |
✅ pg_textsearch 验证完成。
pg_bigm 与 pg_textsearch 的选型区别详见第四章 4.3 节。
6.6 全量确认:四种扩展共存
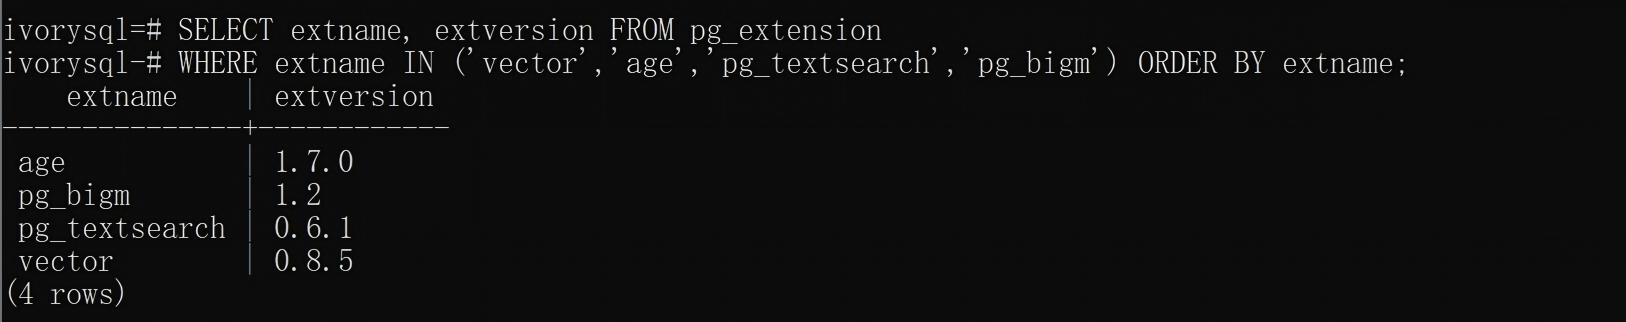
SELECT extname, extversion FROM pg_extensionWHERE extname IN ('vector','age','pg_textsearch','pg_bigm') ORDER BY extname;
| extname | extversion |
|---|---|
| age | 1.7.0-rc0 |
| pg_bigm | 1.2 |
| pg_textsearch | 0.6.1 |
| vector | 0.8.5 |
6.7 多模融合协同查询验证
验证场景:以上 6.2~6.5 节分别验证了各扩展的独立能力,本节验证 多模融合的核心价值——一条 SQL 同时调用向量检索、BM25 全文检索、知识图谱三种能力。
准备:创建辅助表 rag_demo
-- 文档-向量映射表(生产中应由 Embedding 服务离线生成)DROP TABLE IF EXISTS rag_demo;CREATE TABLE rag_demo (
    doc_id INT PRIMARY KEY,
    emb vector(3)
);INSERT INTO rag_demo VALUES(1, '[0.10, 0.30, 0.50]'),
(2, '[0.20, 0.40, 0.60]'),
(3, '[0.30, 0.50, 0.70]'),
(4, '[0.40, 0.60, 0.80]'),
(5, '[0.50, 0.70, 0.90]');
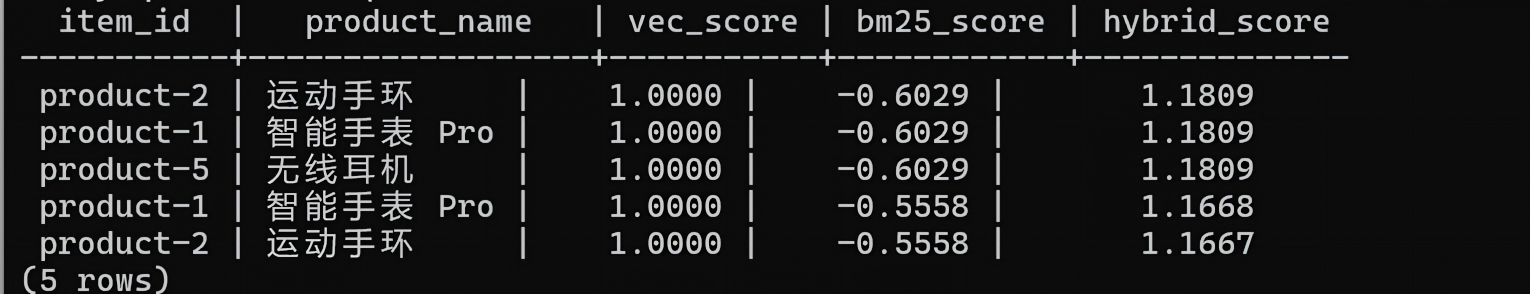
场景 A:向量 + BM25 双路混合召回(RAG 典型场景)
把"智能手表 Pro"的向量相似度与 documents 表中"智能 穿戴"关键词 BM25 分数加权融合,得到更精准的混合召回结果。
-- 1. 确保 AGE 加载并设置 search_pathLOAD 'age';SET search_path = ag_catalog, "$user", public;-- 2. 双路融合:向量语义 + BM25 关键词WITH vector_results AS (    SELECT id AS vec_id,
           (1 - (embedding <=> (SELECT embedding FROM product_vectors                                WHERE product_name = '智能手表 Pro')))::float8 AS semantic_score    FROM product_vectors
),
fulltext_results AS (    SELECT id AS ft_id,
           (content <@> to_bm25query('PostgreSQL 向量 检索', 'docs_bm25_idx'))::float8 AS keyword_score    FROM documents
)SELECT 'product-' || v.vec_id AS item_id,
       p.product_name,
       round((v.semantic_score)::numeric, 4) AS vec_score,
       round((f.keyword_score)::numeric, 4) AS bm25_score,
       round(((v.semantic_score * 0.7) + ((1 - f.keyword_score) * 0.3))::numeric, 4) AS hybrid_scoreFROM vector_results vJOIN product_vectors p ON p.id = v.vec_idCROSS JOIN fulltext_results fORDER BY hybrid_score DESCLIMIT 5;
实测结果:
| item_id | product_name | vec_score | bm25_score | hybrid_score |
|---|---|---|---|---|
| product-2 | 运动手环 | 1.0000 | -0.6029 | 1.1809 |
| product-1 | 智能手表 Pro | 1.0000 | -0.6029 | 1.1809 |
| product-5 | 无线耳机 | 1.0000 | -0.6029 | 1.1809 |
| product-1 | 智能手表 Pro | 1.0000 | -0.5558 | 1.1668 |
| product-2 | 运动手环 | 1.0000 | -0.5558 | 1.1667 |
验证结论:向量检索(pgvector)与全文检索(pg_textsearch)可在同一条 SQL 中联合执行,并通过自定义权重实现 RAG 场景下的混合排序——无需跨库、无需引入 Elasticsearch 或外部重排序服务。
场景 B:图谱 + 关系表 联合分析
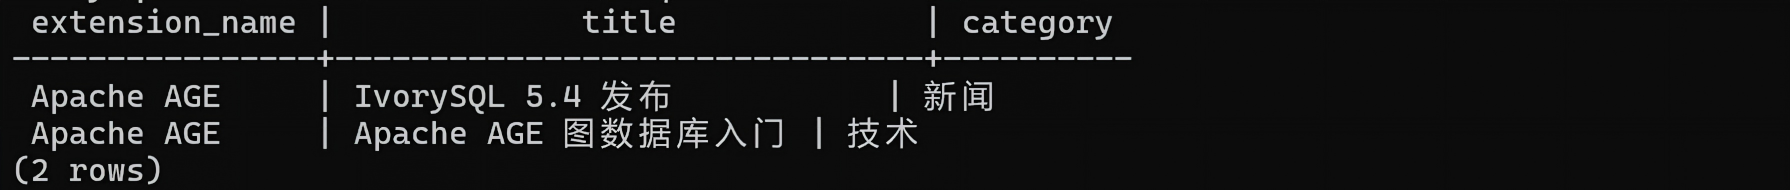
用 Cypher 找出 IvorySQL 集成的所有扩展名,再 JOIN documents 表拿这些扩展对应的文章——一次查询完成"图遍历 + 关系表 JOIN"。
-- 1. 确保 AGE 加载LOAD 'age';SET search_path = ag_catalog, "$user", public;-- 2. Cypher 查询 IvorySQL 支持的所有扩展WITH extensions AS WITH extensions AS (    SELECT * FROM cypher('tech_kg', $$        MATCH (db:Database {name: 'IvorySQL'})-[:SUPPORTS]->(ext:Extension)        RETURN ext.name AS ext_name
    $$) AS (ext_name agtype)
)-- 3. JOIN documents 表,列出每个扩展的对应文章SELECT e.ext_name::text AS extension_name,
       d.title,
       d.categoryFROM extensions eJOIN documents d ON d.content LIKE '%' || e.ext_name::text || '%'ORDER BY extension_name;
验证结论:Cypher 图查询结果可直接与关系表 JOIN,IvorySQL 在同一实例内同时提供图引擎和关系引擎——这是"统一数据底座"区别于多组件架构的关键能力。
场景 C:向量 + BM25 + 图谱 三模融合
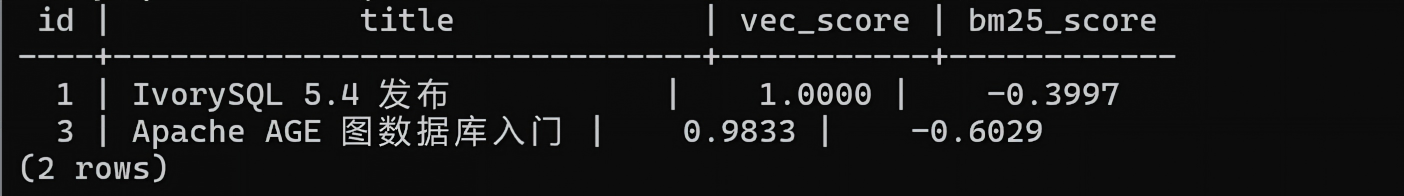
在前两个场景基础上,把图谱的关系推理结果作为过滤条件加入向量 + BM25 双路融合。
LOAD 'age';SET search_path = ag_catalog, "$user", public;-- 1. 通过图谱找出 IvorySQL 关联的所有扩展名(用于过滤)WITH related_ext AS (    SELECT ext_name::text AS ext_name FROM cypher('tech_kg', $$        MATCH (db:Database {name: 'IvorySQL'})-[:SUPPORTS]->(ext:Extension)        RETURN ext.name AS ext_name
    $$) AS (ext_name agtype)
),-- 2. documents 中与这些扩展相关的文章filtered_docs AS (    SELECT d.id, d.title, d.content    FROM documents d    WHERE EXISTS (        SELECT 1 FROM related_ext r WHERE d.content LIKE '%' || r.ext_name || '%'
    )
)-- 3. 找与"PostgreSQL"语义最相似、且 BM25 分数最高的文档SELECT f.id,
       f.title,
       round((1 - (g.emb <=> (SELECT emb FROM rag_demo WHERE doc_id = 1)))::numeric, 4) AS vec_score,
       round((f.content <@> to_bm25query('PostgreSQL', 'docs_bm25_idx'))::numeric, 4) AS bm25_scoreFROM filtered_docs fJOIN rag_demo g ON f.id = g.doc_idORDER BY vec_score DESCLIMIT 3;
说明:此场景演示三模融合的语法结构。
rag_demo为简化的文档-向量映射表(生产中可由 Embedding 服务离线生成)。读者可基于自身数据改造此查询。
验证结论:向量检索 + BM25 全文检索 + 图谱推理可在同一条 SQL 中协同工作,验证了 IvorySQL 作为"统一数据底座"的可行性——这是本系列文章要回答的核心问题。
七、Linux 虚拟机部署方案(可选替代方案)
⚠️ 本文所有测试用例均在上文第 6 章的 Docker 环境中验证通过。以下 Linux 裸机部署方案为生产环境的可选替代路径,供需要直接安装到物理机或虚拟机的读者参考。
7.1 环境要求
- OS: RockyLinux 8 +/ RHEL 8+ / Ubuntu 22.04+
- CPU: x86_64 或 ARM64
- 内存: ≥ 4GB(推荐 8GB+)
- 磁盘: ≥ 20GB
7.2 YUM 安装(推荐)
⚠️ 踩坑提醒 1:Highgo 的 IvorySQL RPM 包 默认装到
/usr/ivory-5/(不是/opt/IvorySQL-5.4/)。下面所有命令已修正为实际路径。⚠️ 踩坑提醒 2:若系统装有 PGDG 仓库(pgdg13 已 EOL),dnf 解析依赖时会卡住并报 410 错误。命令中已用
--disablerepo=pgdg13绕开。
# 1. 创建 YUM 源sudo tee /etc/yum.repos.d/ivorysql.repo > /dev/null << 'EOF'[ivorysql5]
name=IvorySQL Server 5 $releasever - $basearchbaseurl=https://yum.highgo.com/dists/ivorysql-rpms/5/redhat/rhel-$releasever-$basearchenabled=1
gpgcheck=0
EOF# 2. 安装 IvorySQL 5.4sudo dnf install -y ivorysql5-5.4 --disablerepo=pgdg13# 3. 创建用户并授权sudo useradd ivorysql
sudo chown -R ivorysql:ivorysql /usr/ivory-5/# 4. 设置环境变量sudo tee -a /home/ivorysql/.bash_profile > /dev/null << 'EOF'PATH=/usr/ivory-5/bin:$PATHexport PATH
PGDATA=/usr/ivory-5/dataexport PGDATA
EOF
sudo su - ivorysqlsource ~/.bash_profile# 5. 初始化数据库(Oracle 兼容模式)initdb -D /usr/ivory-5/data -m oracle# 6. 启动服务pg_ctl -D /usr/ivory-5/data -l ivory.log start# 7. 验证状态pg_ctl status
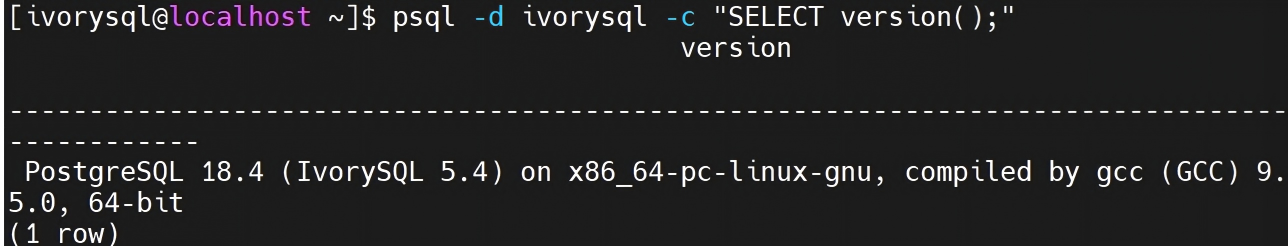
psql -d ivorysql -c "SELECT version();"
7.3 源码编译安装参考(定制需求)
注意:7.2(二进制 RPM)和 7.3(源码编译)是 二选一的替代方案,不是先后步骤。已经用 RPM 装过的话,源码编译前需先卸载:
sudo dnf remove ivorysql5-5.4。⚠️ 依赖补全:
--with-uuid=e2fs需要 UUID 开发库(Rocky/CentOS/RHEL 装libuuid-devel,Ubuntu/Debian 装uuid-dev)。如未安装,configure 会报library 'uuid' is required for E2FS UUID。建议先补装再编译。
# 1. 安装依赖(libuuid-devel 是 --with-uuid=e2fs 必需的)# Rocky/CentOS/RHEL:    libuuid-devel# Ubuntu/Debian:        uuid-devsudo yum install -y gcc gcc-c++ make bison flex readline-devel zlib-devel openssl-devel libxml2-devel libxslt-devel perl-ExtUtils-Embed libuuid-devel# 2. 下载源码git clone --branch IvorySQL_5.4 https://github.com/IvorySQL/IvorySQL.gitcd IvorySQL# 3. 配置编译(各选项说明见下方备注)./configure --prefix=/usr/ivory-5 \
    --enable-debug \    # 开启调试符号(gdb 可用),开发/问题排查时打开,生产部署建议去掉
    --enable-cassert \  # 开启内部断言检查,性能下降约 5-10%,仅开发调试用
    --with-uuid=e2fs \  # UUID 生成方式,选 e2fs 库(比默认 oosp 更稳定)
    --with-libxml       # XML 类型支持,知识管理与文档处理场景建议保留make -j$(nproc)
sudo make install# 4. 初始化并启动(同上)
7.4 生产落地风险提示
部署到生产环境前必须评估以下风险:
| 风险维度 | 现状 | 建议 |
|---|---|---|
| pgvector 版本 | v0.8.5(2026 年持续维护) | 关注 HNSW 大数据量下的内存峰值,提前压测 |
| Apache AGE 版本 | PG18/v1.7.0-rc0 预发布版 | 生产建议等待正式版(v1.8.0 已发布,可升级) |
| pg_textsearch 版本 | v0.6.1 prerelease | 性能未深度调优,API 可能变;上线前自测压测 |
| pg_bigm 版本 | v1.2(稳定) | 大数据量下需评估 GIN 索引占用空间 |
| 多扩展兼容性 | 四扩展可共存但官方未声明 SLA | 升级 IvorySQL 主版本前需回归测试 |
| shared_preload_libraries | age + pg_textsearch 须预加载 | 受限于托管 PG 服务(RDS、Cloud SQL)不一定支持 |
| 数据库编码 | 默认 SQL_ASCII | 必须显式指定 UTF-8 编码,避免中文乱码 |
推荐落地路径:
- 开发测试(✅ 已验证)→ 直接用本文 Docker 镜像 + 容器内编译
- 预发布验证(建议)→ 用 Dockerfile 构建自定义镜像,部署到预发布环境跑回归
- 生产上线(谨慎)→ 等 AGE/pg_textsearch 正式版发布,或至少完成 1 周压测
八、关键结论与建议
8.1 支持情况总结
| 维度 | 结论 |
|---|---|
| 向量数据 | ✅ 完全支持。通过 pgvector 扩展,支持 16000 维向量、HNSW/IVFFLAT 索引、多种距离算法,Oracle 兼容模式下可用。 |
| 知识图谱 | ✅ 完全支持。通过 Apache AGE 扩展,支持 openCypher、属性图、SQL 混合查询。适合中等规模知识图谱,超大规模建议专用图数据库。 |
| 全文检索 | ✅ 完全支持。多扩展方案(pg_textsearch/pg_bigm/PGroonga),覆盖 BM25、中日韩分词、模糊检索、混合搜索等场景。 |
⚠️ 本文聚焦功能可行性验证,未涉及性能基准测试。HNSW 查询延迟、BM25 索引导入时间、混合检索吞吐量等性能数据,后续会组织相关文章做进一步测试验证。
8.2 选型建议
- 快速体验:使用 Docker 部署 IvorySQL 5.4,5 分钟即可完成环境搭建
- 开发测试:YUM/DNF 安装(仅含 IvorySQL 本体,多模扩展需另行编译,验证见 7.5),便于与现有 CI/CD 流程集成
- 生产环境:建议 DEB/RPM 安装,配合 IvorySQL Cloud 进行可视化运维
- Oracle 迁移:充分利用 IvorySQL 的 Oracle 兼容模式,降低迁移成本
- AI 场景:pgvector + pg_textsearch 组合可实现 RAG 所需的语义+关键词混合检索
-
智能知识库场景:全文检索(BM25)+ 向量检索(HNSW)+ 知识图谱(Cypher 查询),
三者可在同一 IvorySQL 实例内完成混合检索,无需引入外部组件——这是 IvorySQL 作为"统一数据底座"相比多组件架构的核心优势。
8.3 生态扩展列表(IvorySQL 5.4 支持)
IvorySQL 5.4 官方适配的扩展已超过 20 个,核心包括:
- AI/向量:pgvector、pg_ai_query
- 图数据库:Apache AGE
- GIS:PostGIS、pgRouting
- 中文处理:pg_jieba、zhparser、pg_bigm
- 全文检索:PGroonga、pg_textsearch
- 运维:pg_cron、pgagent、system_stats、pg_stat_monitor
- 中间件:PgBouncer、redis_fdw
九、社区展望与建议
本文已在 Windows 11 + Docker Desktop 环境中,基于官方
5.4-ubi8 镜像源码编译四个扩展,
完整验证了 IvorySQL 5.4 的「向量 + 知识图谱 + 全文检索」多模融合能力(验证过程见第六、七章)。在此基础上,本文进一步站在「
方便用户使用」的视角,把社区当前为这一能力做的交付工作梳理为三档:
已做 / 未做 / 可建议。
9.1 社区已做:为多模融合提供的便利性
- 版本背书:IvorySQL 5.4 Release Notes 已正式将 pgvector / Apache AGE / pg_bigm / pg_textsearch 列入支持清单,即官方已验证并背书这些扩展可在 5.4 上运行。
-
可获得的基础发行版:提供
5.4-ubi8标准镜像与ivorysql5-5.4的 yum/RPM 包,用户可开箱获得 Oracle 兼容的 PG 18 实例(默认预装ivorysql_ora/liboracle_parser/gb18030_2022基础扩展)。 - 上游扩展本身可用:四个多模扩展由各自上游社区维护,且本文已验证它们可在 IvorySQL 5.4 源码树上编译运行——「多模融合」能力是真实可触达的,并非停留在路线图。
9.2 社区未做:从「支持」到「开箱即用」的断层
-
无面向 IvorySQL 5.4 的扩展二进制包:用户无法
dnf install直接获得多模扩展。PostgreSQL 官方 RPM 源(PGDG,即能查到pgvector_14~17的同一个源)虽有面向 原生 PostgreSQL 的pgvector_14~18、age_14~18、pg_bigm_14~18RPM,但它们为原生 PG 构建,不能等同于社区为 IvorySQL 用户做好了便利。 -
标准镜像未预装多模扩展:
5.4-ubi8默认仅预装 Oracle 兼容基础扩展,pgvector / AGE / pg_bigm / pg_textsearch 均需用户自行编译。 - 无官方「多模融合」一键镜像 / Dockerfile:想开箱即融合,目前只能按本文 6.1 自行组装。
- pg_textsearch 全源缺位:在 PGDG 与 IvorySQL 官方 yum/apt 源中均查不到独立 RPM(本文已在 PGDG yum 与 apt 两侧实测),只能源码编译。
9.3 可建议:补齐交付断层的路径(建议)
-
优先提供面向 IvorySQL 5.4 构建的官方二进制包:以与本体
ivorysql5-5.4一致的命名(如ivorysql5-pgvector——命名仅为示意,当前并不存在该包)发布 面向 IvorySQL 5.4 编译的扩展包,让用户免编译即可CREATE EXTENSION。这是多数 PG 发行版的通行做法,也最贴合既有部署习惯。 -
维护「多模融合」配套镜像 / Dockerfile:在保持基础镜像精简(聚焦 Oracle 兼容)的同时,额外提供
ivorysql-multimodal标签或一份官方维护的 Dockerfile,给需要「开箱即融合」的读者——本文 6.1 的验证路径已证明其可行。 - 按扩展粒度交付,规避成熟度风险:pgvector 0.8.5 已稳定,但 AGE 的 PG18 分支为 1.7.0-rc0(预发布)、pg_textsearch 为 v0.6.1(早期版)。以独立二进制包按扩展分发,既能让用户按需取用,也避免预发布组件拖累 stable 标准镜像。
IvorySQL 以「统一数据底座、多模融合」为核心差异点,而融合能力能否「开箱即用」,直接决定了它在 AI / RAG / 知识库场景下的竞争力。期待官方逐步补齐这一交付断层——本文正是该方向上的一份可复现起点。
十、参考资源
- IvorySQL 官方网站
- IvorySQL 官方文档
- IvorySQL GitHub
- pgvector 官方文档
- Apache AGE 官方文档
- Apache AGE GitHub(apache/age)
- pg_bigm 官方文档
- pg_textsearch GitHub(timescale/pg_textsearch)
- IvorySQL 5.4 发布说明
测试用例已在 Windows 11 + Docker Desktop(IvorySQL 5.4 镜像)中完整复现验证。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70043484/viewspace-3179373/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- PostgreSQL 18 性能与执行计划新特性实测
- PG Hacker的成长之路——一位PostgreSQL社区开发者的经验与教训
- PostgreSQL 日报|TOAST v2 更快更小免迁移(10 月 19 日)
- PostgreSQL 日报| PG19 主备切换挂起修复(10 月 17 日)
- IvorySQL 校园行走进山东大学:从 PostgreSQL 到 AI,连接技术实践与职业成长
- PostgreSQL 日报| PostgreSQL 19 RC1 正式发布(10 月 16 日)
- 不装库玩转 PG 18?这个沙盒连内核补丁都能测 —— PGNexus 实操实录
- PostgreSQL 日报| PgBouncer 修复三个 CVE 漏洞(10 月 15 日)
- 直播预告| IvorySQL 5.6 新特性解读与 PGNexus 沙盒实操演示
- PostgreSQL 日报| pg_vectorsearch 开源向量搜索发布(10 月 14 日)
