云环境下PostgreSQL的Cgroup内存管理实践
本文整理于 HOW 2026 演讲内容,演讲者:刘智龙,平安科技PG数据库专家。
一、Cgroup内存管理概述
1.1 Cgroup的基本原理
Cgroup(Control Group)是Linux内核提供的进程组资源管理机制,可对一组进程的CPU时间、物理内存、IO、网络等资源进行配额限制、隔离与使用统计。在云环境中,同一物理主机上通常运行多个PG实例,每个实例通过Cgroup进行资源管理——这是各家云厂商的常见做法,容器技术同样基于Cgroup实现资源约束。
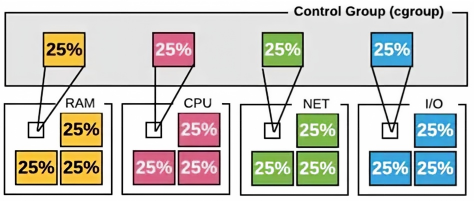
1.2 CPU管理与内存管理的本质差异
Cgroup对CPU和内存的管理逻辑有根本性的不同:
- CPU控制的核心是时间分配。CPU通过时间片轮转实现共享,即使某Cgroup的CPU上限达到,任务只是运行变慢,仍可继续执行。
- 内存控制的核心是Page计数。内存必须即时可用,一个任务占用的工作内存无法被其他任务复用(共享内存除外)。当内存达到上限时,不存在"降速运行"的选项,只能进行回收,若回收失败则进程被终止。
关键区别在于:CPU上限打满,任务还能跑,只是慢一些;内存上限打满,任务面临的是回收或死亡。
1.3 云环境下的超卖现象
在共享云主机上,多个Cgroup实例并发运行。若将所有Cgroup的限额简单相加,可能远超主机的物理内存,即"超卖"。但对于PG来说,超卖并不必然意味着实际内存不足——因为内存中的Cache部分是可以回收的。
实际内存占用可分为三类: 私有内存(不可回收)、 共享内存(如PG的Shared Buffers,由多进程共享,不可回收)、 Cache(文件缓存,可回收)。多个实例的Cache存在大量空闲或可回收空间时,即使限额之和超过物理内存,实际使用量可能并未超限。
但若进行扩容或新增实例,导致OS内存水位线超标,系统会频繁回收Cache。此时回收谁的内存成了"运气问题",可能波及关键实例,引发性能抖动。
1.4 PG在OS上的内存层次
PG进程的内存占用可分解为三层结构:
- RSS(常驻内存) :分为私有内存和共享内存,通常无法回收
- Page Cache:文件缓存,可回收
- Kernel层:内核自身的内存开销
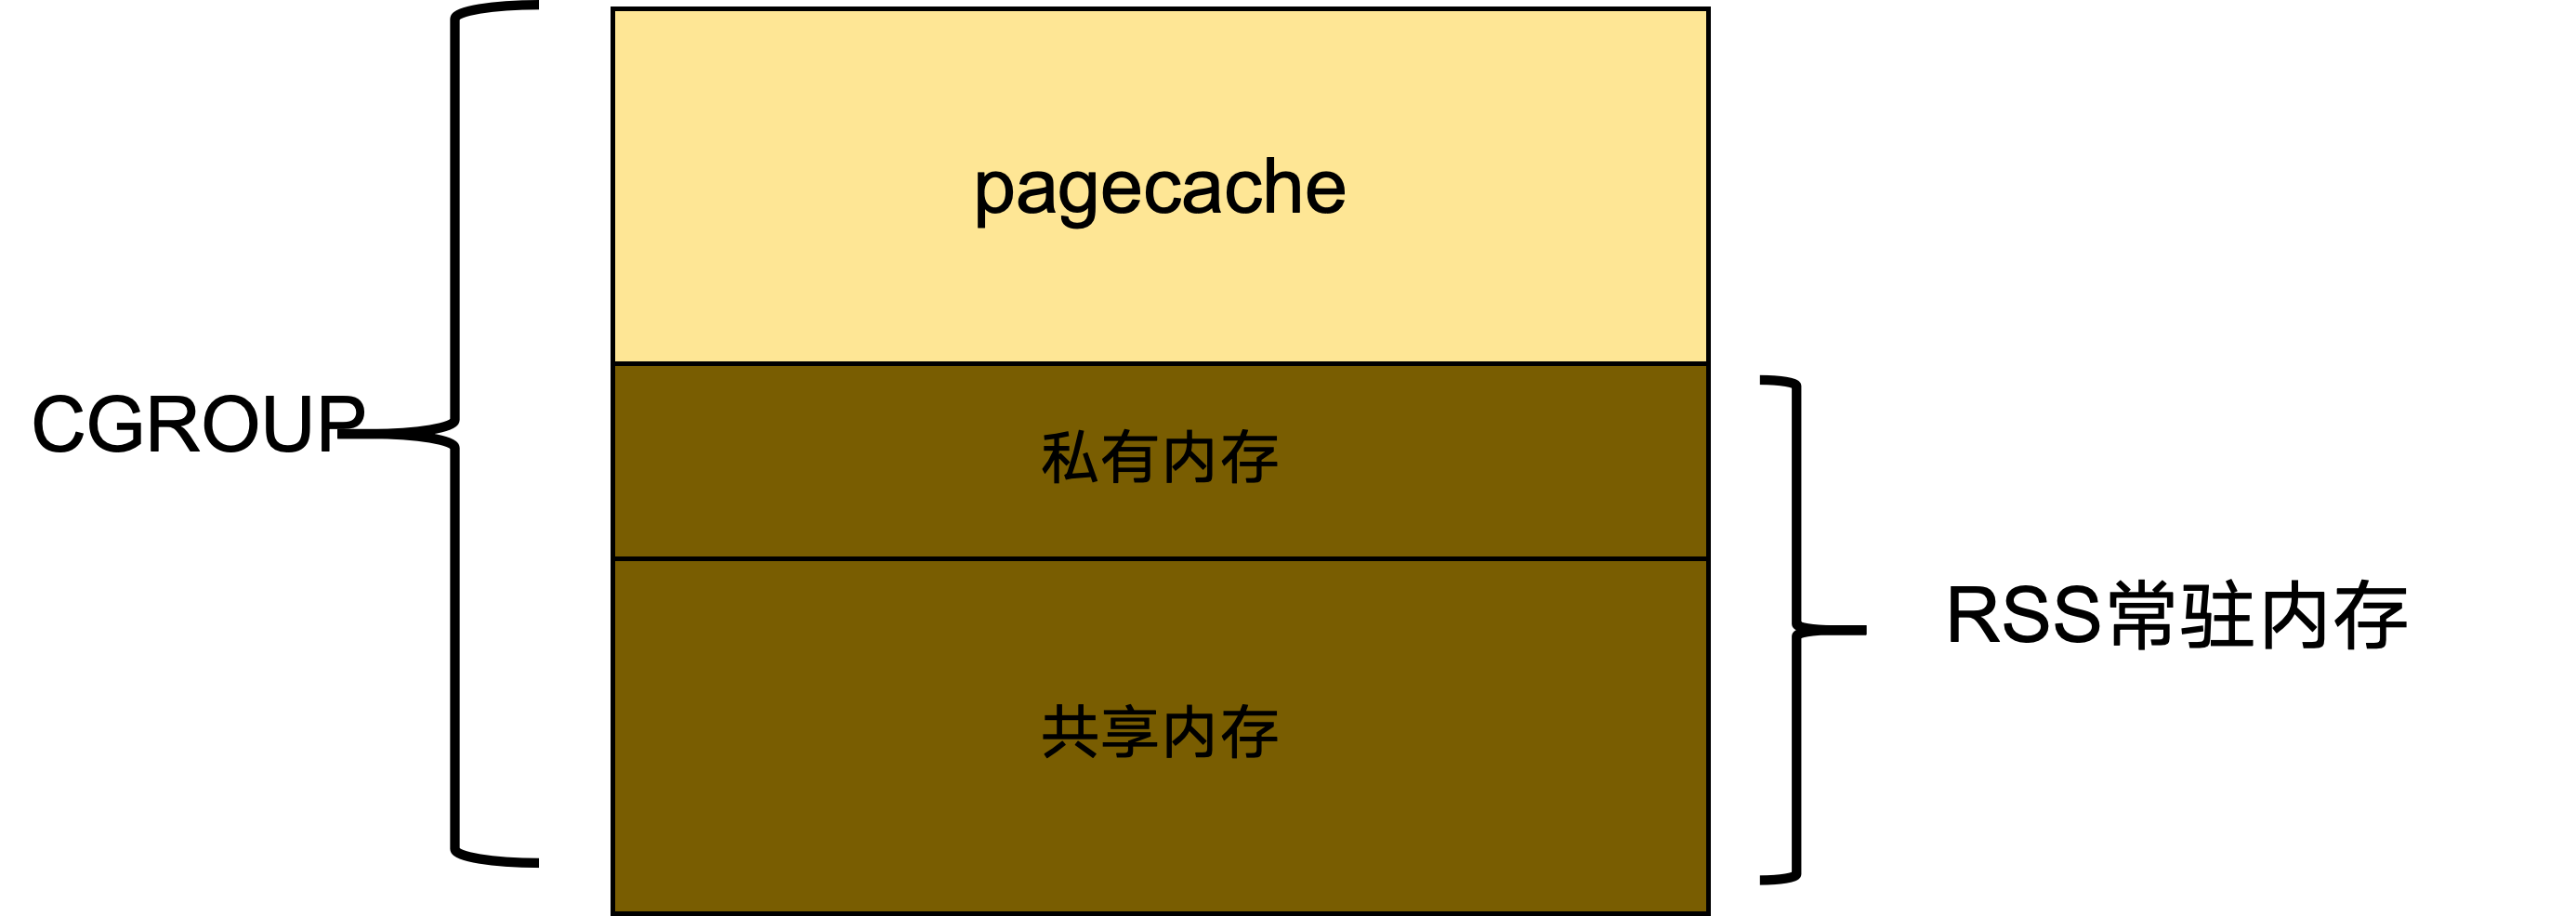
在Cgroup层面,各实例拥有独立的LRU列表,回收时仅影响本Cgroup,实现了资源隔离。
二、Pages的计算与统计口径辨析
2.1 关键接口文件
Cgroup内存管理涉及的核心文件包括:
- memory.stat:包含各类内存指标的详细统计,是观测内存使用的主要入口
- memory.usage_in_bytes:官方不推荐直接使用,准确用量需自行计算
- cgroup.procs:需确保所有PG进程(postmaster、checkpointer、bgwriter、walwriter、backend等)均加入此文件
- memory.limit_in_bytes:定义Cgroup的内存上限
2.2 memory.stat 的核心指标解读
以一个实际案例为例:PG实例的
shared_buffers=64GB,
shared_memory_type=mmap,客户端约800个。
memory.stat中的关键指标包括:
-
cache:Page Cache的大小 -
rss:匿名页和Swap内存, 注意:这里的RSS与OS进程的RSS含义不同 -
mapped_file:文件共享内存大小, PG的共享内存在此项中统计 -
pgpgin / pgpgout:RSS+Cache的charge/uncharge页数 -
inactive_anon / active_anon:匿名页和Swap缓存的LRU分布 -
inactive_file / active_file:文件缓存的LRU分布
2.3 统计口径的核心偏差
通过手动计算可以发现Cgroup v1中的统计混乱问题:
shared_mem_mapped = inactive_anon + active_anon - rss
cache - shared_mem_mapped = inactive_file + active_file
rss + mapped_file = inactive_anon + active_anon
inactive_file + active_file + rss + mapped_file = rss + cache
- Cgroup v1的RSS统计 不包含file map类型的共享内存
- PG的共享内存(无论mmap还是sysv方式)均被归类到
mapped_file下 - 大页场景下,共享内存甚至不出现在任何统计指标中(包括
rss_huge)
2.4 进程RSS与Cgroup RSS的差异
查看PG各进程的RSS排序,通常checkpointer和bgwriter的RSS最大(均达60GB级别),这是因为这些进程频繁操作Shared Buffers,实际占用了大量共享内存。postmaster的RSS则小得多,因为它只需开辟共享内存的虚拟地址空间,fork给子进程使用。
查看
/proc/[pid]/smaps会发现:checkpointer、bgwriter和postmaster的共享内存虚拟地址完全一致,但RSS不同。fork出的子进程虽然继承了相同的虚拟地址映射,但只有实际访问了对应物理页面的进程,其RSS才会增长。
2.5 如何正确模拟Cgroup OOM
由于PG采用Double Buffer架构(Shared Buffers + Page Cache),在
shared_buffers = 1/4 × cg_mem的典型配置下,Page Cache最多可占3/4的Cgroup内存。正常业务中私有内存占用不会太多,即使Cgroup内存打满,系统也可从Page Cache中回收内存,因此实例未必会OOM。
想要有效触发Cgroup OOM,最直接的方法是创建大量占用私有内存的会话(如大量排序、Hash Join等),而非通过持续写入填满Page Cache。 后者只会触发Cache回收,不会导致真正的内存耗尽。
三、Cgroup OOM的行为与影响
3.1 OOM触发机制
Cgroup OOM可分为两种情况:
OOM Killer On:内核根据OOM Score选择得分最高的进程终止(通常是Backend用户进程),发送SIGKILL信号。PG的postmaster检测到子进程异常终止后,若共享内存未被破坏,会自动拉起新进程,业务可能短暂中断但实例整体可恢复。系统日志(dmesg)和PG日志中均有相关记录。
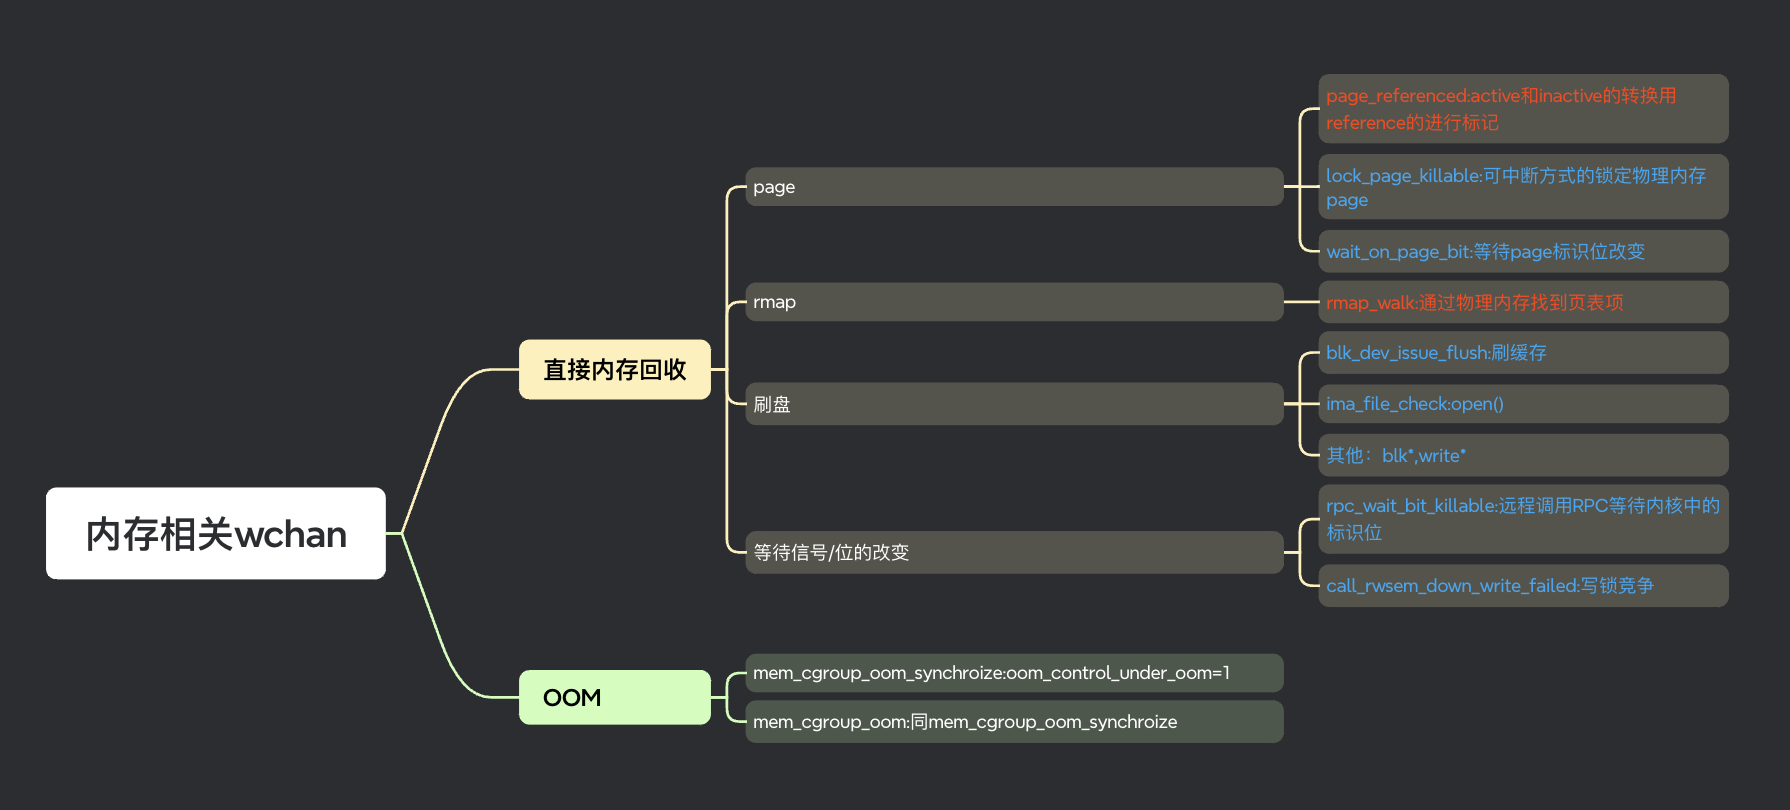
OOM Killer Off:不触发内核Kill,但PG进程可能因内存分配失败而Hang住(状态变为D,等待事件为
mem_cgroup_oom)。关键进程如walwriter若无法获得内存,实例可能直接崩溃。这种情况下,即使OOM Killer关闭,实例仍然可能挂掉——不是因为被杀,而是跑死了。
3.2 关键区别
- Cgroup OOM ≠ 系统级VM OOM。系统级VM OOM由
vm.overcommit机制独立判断 - Cgroup v1的
memory.oom_control关闭时,OOM Killer不启动,但进程仍可能因内存不足而Hang或崩溃
四、Cgroup v1的缺陷与v2的改进
4.1 v1的统计盲区
- 缺少Page Table统计:大量进程可导致Page Table占用数十GB,v1无法观测
- 缺少Slab统计:内核Slab内存开销未纳入统计
- 缺少HugePage统计:大页内存完全不被计入,形成统计黑洞
-
无法区分异步/同步回收:
pgscan_kswapd与pgscan_direct在v1中无法按Cgroup粒度区分 - 共享内存统计混乱:shmem和file_mapped混在一起
- RSS统计口径不一致:Cgroup RSS与进程RSS含义不同
4.2 v2的改进
Cgroup v2(Linux 4.5+正式发布)在内存管理上提供了显著增强:
管理层面:
- 层级结构更清晰,配置更直观
- 新增
memory.min/low/high水位线参数,可更精细地控制回收行为 - 更好地应对突刺负载
- 移除直接关闭OOM Killer的接口,改用更柔和的控制方式
- 新增
memory_hugetlb_accounting,终于将大页纳入统计
观测层面:
- 新增Slab、Page Table、
pgscan_kswapd/pgscan_direct/pgsteal_kswapd等指标 - 新增Socket、Vmalloc、透明大页、Zswap、全零页交换等专项统计
- 共享内存(shmem)与文件映射(file_mapped)指标分离,不再混淆
- 大页信息终于可观测
五、大页(Huge Pages)的管理与挑战
5.1 大页的优势
大页对PG的稳定性和性能有多方面好处:
- 略微提升TPS
- 减少TLB(Translation Lookaside Buffer)刷新压力,降低CPU缓存竞争
- 显著减少Page Table在主内存中的大小。这不仅节约内存,还能在内存回收时加速通过物理地址查找虚拟地址的映射过程
- 大页的物理连续性带来更好的内存访问局部性
- 非大页的共享内存理论上可被OS回收,大页不会
对于内存碎片和Cgroup内直接内存回收问题,大页有非常好的缓解效果。
5.2 Shared Buffers与大页的配置建议
将
shared_buffers设置为Cgroup内存的1/4似乎是行业标准,但实际情况更为复杂。调小
shared_buffers可略微增加Page Cache,即增大整体缓存容量;调大
shared_buffers则略微减小整体缓存,但提升了Shared Buffers命中率。两种方向各有利弊。
若
shared_buffers太小,PG自身可用的工作内存不足,相当于把内存管理责任推给OS,而OS回收Page Cache本身就有性能开销;若
shared_buffers太大,不仅挤占Page Cache,还需同步调整bgwriter相关参数(如
bgwriter_delay、
bgwriter_lru_maxpages),否则刷脏效率跟不上写入负载。
基于实际压测与生产运维经验,一个更靠谱的建议值(至少比简单的1/4公式更可靠):
-
不开大页:
shared_buffers = min(1/4 × 总内存, 20GB) -
开大页:
shared_buffers = min(1/4 × 总内存, 60GB)
读多写少的场景可适当调大,但必须同步调整刷脏参数。
5.3 大页带来的管理难题
统计黑洞:在Cgroup v1中,大页完全不进入任何统计指标。一个实例的Cgroup限额设为20GB,若使用大页,实际可能已占用30GB物理内存,但监控显示一切正常。RDS等监控系统的内存指标在大页场景下可能全面失真。
资源规划困难:大页需在主机启动时预先分配,无法按需动态扩展。问题在于:
- 同一主机可能混合部署PG、MySQL等多种数据库,不同数据库对大页的使用策略不同
- 不知道主机上要部署多少实例、什么规格的实例,大页大小难以预先确定
- 若大页分配过大,后续实例分配不到大页,只能退而使用普通页,违背了启用大页的初衷;若分配过小,则造成大量内存浪费
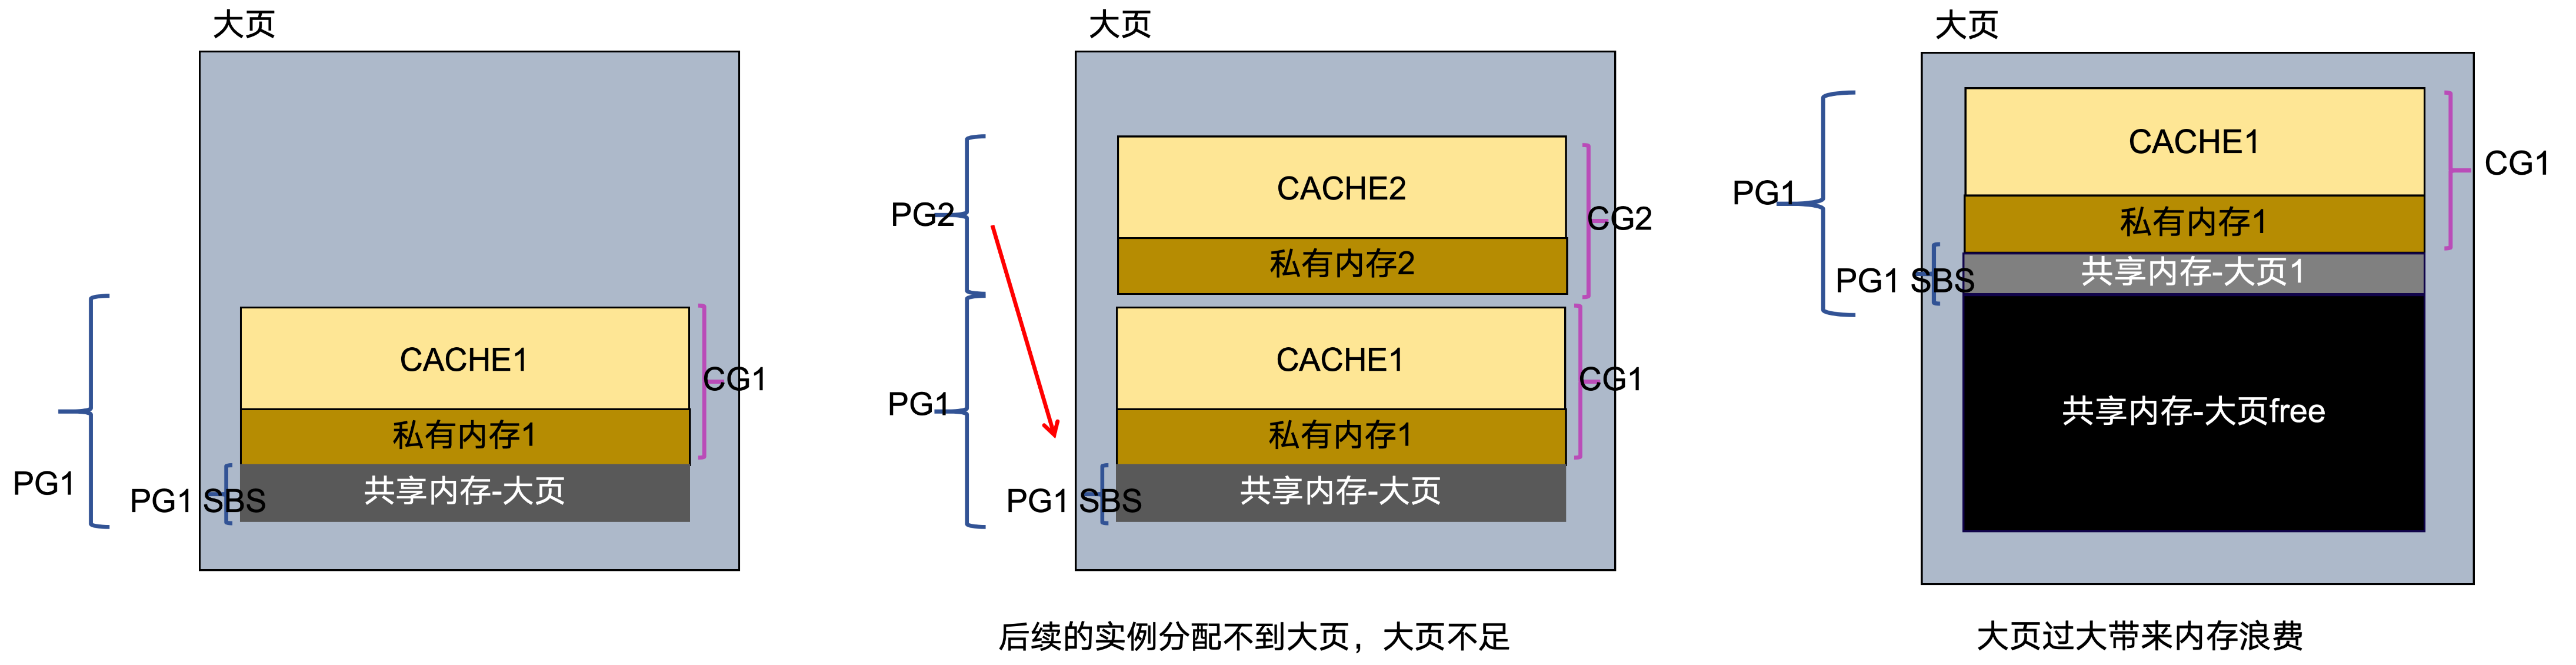
示例场景:第一个PG实例获得充足大页,第二个实例要上线时大页已耗尽,无法满足需求。若试图为一个大实例分配过多大页,则主机上只能运行这一个实例,资源利用率极低。
六、内存故障模型与排查思路
6.1 故障分类
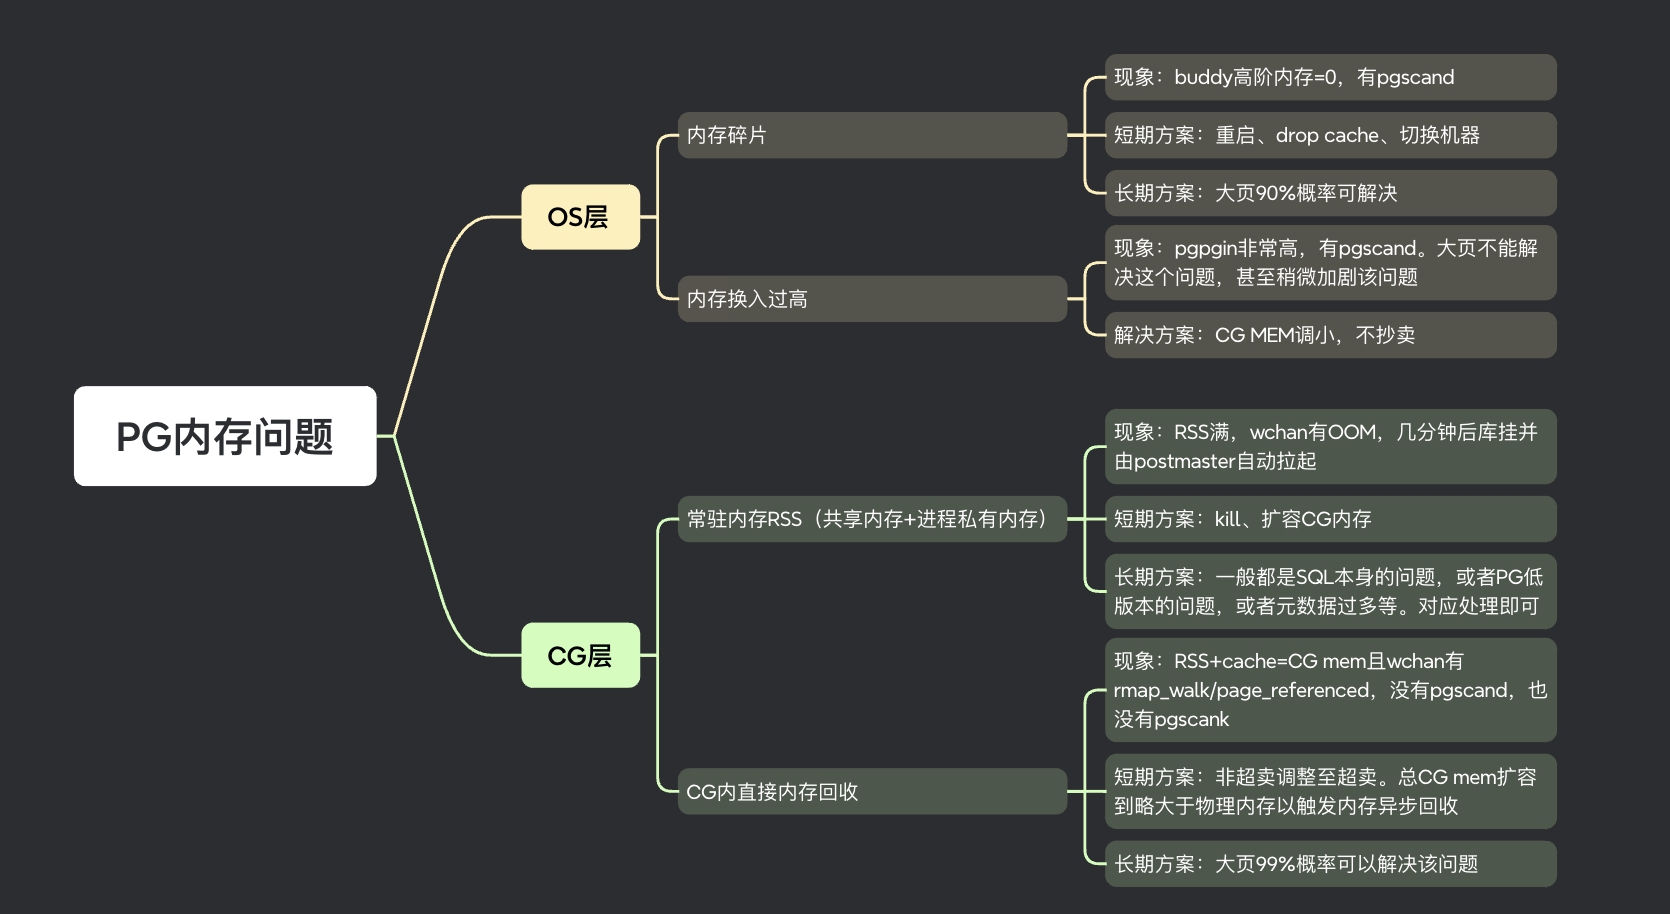
内存问题大致可分为四个层面:
操作系统层面:内存碎片、Swap换入过高。注意:启用大页可缓解碎片问题,但可能略微加剧Swap换入问题,需权衡。
PG内核层面:元数据膨胀、版本Bug等。
Cgroup层面:Cgroup内内存回收引发的性能抖动,通常由Cgroup打满触发。启用大页对此有显著改善效果。
私有内存层面:个别Backend进程占用过多私有内存(如大结果集排序、Hash Join),导致Cgroup整体内存紧张。
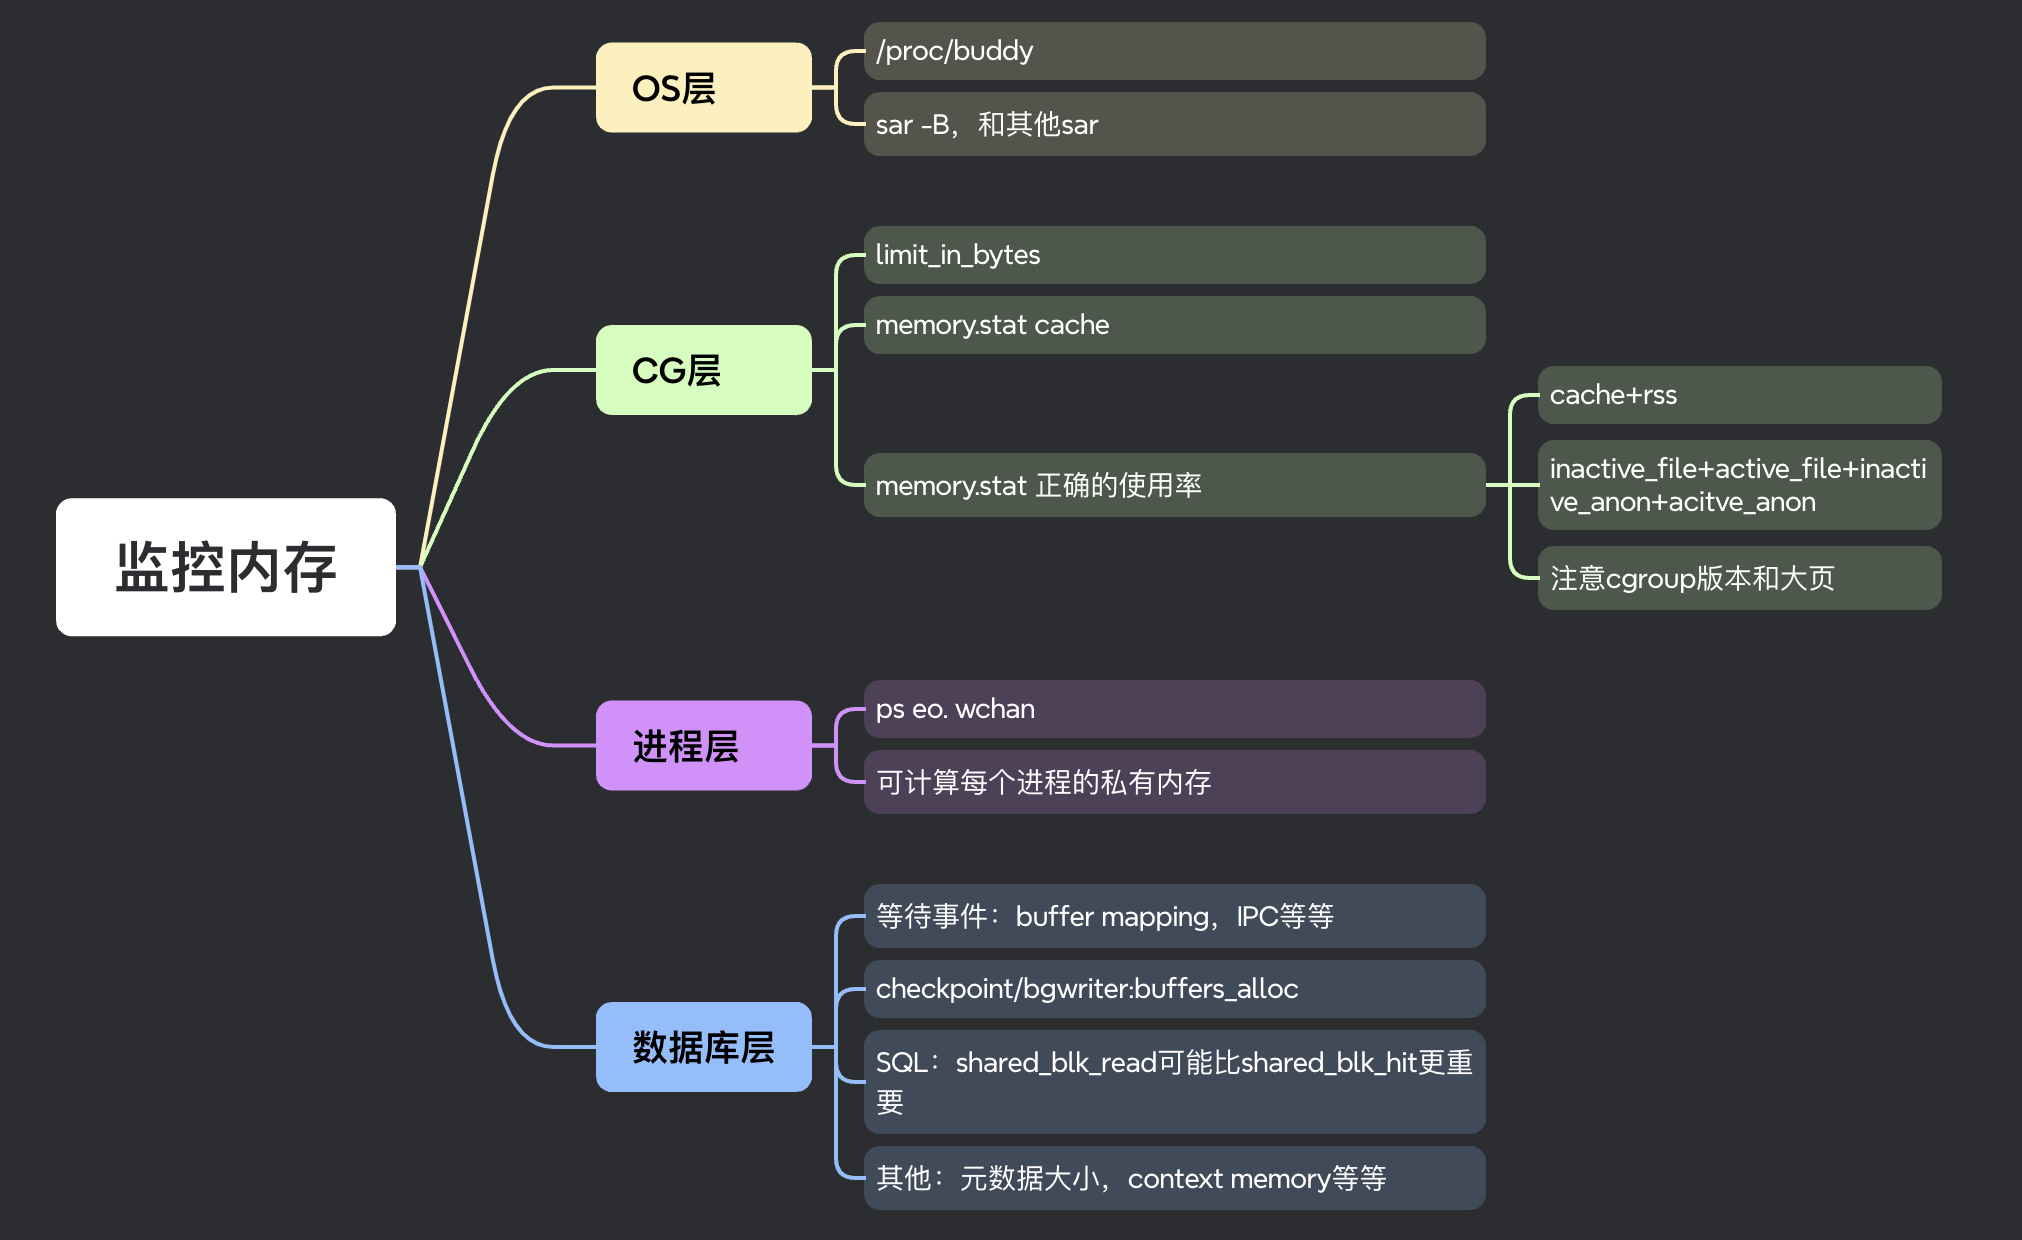
6.2 监控要点
-
系统层:
/proc/buddyinfo查看碎片;/proc/meminfo的si/so(Swap In/Out)判断换入换出压力;/proc/vmstat中的pgscan_kswapd和pgscan_direct区分异步/同步回收 -
Cgroup层:
memory.stat中的各项指标,注意v1和v2的统计差异 -
进程层:
ps查看各进程RSS/PSS,计算私有内存;关注进程等待事件(如mem_cgroup_oom) -
数据库层:
pg_stat_bgwriter的checkpoint和buffers分配;等待事件中的IPC类事件
Buffer命中率方面,Read次数比Hit Rate更值得关注。Hit Rate很高但Read也很高时,意味着即使命中率高,仍然产生了大量Buffer读取操作(可能因扫描范围太大),这是无效的缓存竞争,仅看命中率会被误导。
6.3 故障先导信号
常见的前置信号包括:
page allocation failure、
kswapd长时间高CPU、
direct reclaim频繁触发、进程状态频繁切换为D(不可中断睡眠)、
malloc相关等待事件增多等。OOM则属于最终结果,往往伴随着明显的进程消失和日志记录。
总结
云环境下PG的Cgroup内存管理比单机场景复杂得多。几个核心结论:
- 迁移到Cgroup v2可解决v1中 共 享内存统计、大页统计、回收观测等多方面盲区
- 大页能提升稳定性和性能,但需配合v2使用,否则形成统计黑洞,资源规划需谨慎
- Cgroup OOM的on/off各有风险,on时Backend进程可能被杀但实例可恢复,off时关键进程可能Hang住导致实例不可用
- Shared Buffers不宜超过60GB(开大页时),超过后刷脏压力和非大页内存管理成本急剧上升
- 内存监控的核心是掌握真实使用量,尤其要理解Cgroup RSS与进程RSS的区别、共享内存的统计归属
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70043484/viewspace-3176106/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- PostgreSQL 18 性能与执行计划新特性实测
- PG Hacker的成长之路——一位PostgreSQL社区开发者的经验与教训
- PostgreSQL 日报|TOAST v2 更快更小免迁移(10 月 19 日)
- PostgreSQL 日报| PG19 主备切换挂起修复(10 月 17 日)
- IvorySQL 校园行走进山东大学:从 PostgreSQL 到 AI,连接技术实践与职业成长
- PostgreSQL 日报| PostgreSQL 19 RC1 正式发布(10 月 16 日)
- 不装库玩转 PG 18?这个沙盒连内核补丁都能测 —— PGNexus 实操实录
- PostgreSQL 日报| PgBouncer 修复三个 CVE 漏洞(10 月 15 日)
- 直播预告| IvorySQL 5.6 新特性解读与 PGNexus 沙盒实操演示
- PostgreSQL 日报| pg_vectorsearch 开源向量搜索发布(10 月 14 日)
