从双解析器到循环工程:IvorySQL 五年技术演进路线的深度观察
作者:魏波,北京晟数科技技术顾问、PG分会副秘书长。
写在前面
作为一个在 PG 社区摸爬滚打了十几年的老兵,见证了太多基于 PG 的衍生项目起起落落。很多项目上来就喊全兼容 Oracle,结果做着做着就变成了 PG 改个名,或者兼容层越做越厚,最后跟 PG 主分支越离越远,成了没人维护的死分支。
所以当 2021 年底 IvorySQL 刚出来的时候,我其实是持观望态度的。又是一个做 Oracle 兼容的?能撑多久?
但四年多过去,看着 IvorySQL 从 1.0 走到 5.4,从简单的函数兼容做到双解析器架构,再到现在 AI + 云原生 + 循环工程的全面布局,我必须说: 这支团队走出了一条不一样的路,而且走得很稳。
最近翻了翻他们的官方 GitHub 仓库,几组数据让我印象深刻:
- 60,770 次提交、49 个分支、574 个标签——迭代密度相当高
- 30+ 位贡献者——社区已经形成规模,不是单靠一家公司在推
- 代码构成:C 75.9%、PLpgSQL 12.0%、Perl 6.0%、Yacc 2.1%——典型的数据库内核项目结构,Yacc 的占比也侧面印证了双解析器的实现方式
- Apache-2.0 协议——商业友好,没有 copyleft 限制
今天我想从技术视角,结合官方仓库的一手信息,跟大家聊聊 IvorySQL 这五年的演进路线,以及背后的技术选型思考。
一、架构之辩:为什么双解析器是正确的路?
做 Oracle 兼容,最难的不是兼容多少功能,而是 用什么方式兼容。
这个问题上,行业里大概有三条路线:
路线一:中间件代理层
在应用和数据库之间加一个代理,把 Oracle 语法翻译成 PG 语法。代表产品很多,优点是对数据库内核没侵入,缺点也很明显:
- 性能损耗大,每次 SQL 都要经过翻译层
- 存储过程、包这些复杂对象根本翻译不了
- 调试困难,出了问题不知道是翻译层的锅还是数据库的锅
这条路本质是绕着走,适合简单场景,但深入不了核心系统。
路线二:内核深度修改
直接在 PG 内核里改,把 Oracle 语法揉进 PG 的解析器里。优点是性能好,缺点是:
- 对 PG 内核侵入太大,后续升级版本成本极高
- 改着改着就跟 PG 主分支分叉了,最后变成自己维护一个分支
- 社区贡献很难回流,越做越封闭
这条路是硬刚,技术上能走通,但工程成本太高,很多团队死在升级路上。
路线三:双解析器架构(IvorySQL 的选择)
IvorySQL 3.0 推出的双解析器架构,我认为是目前最优雅的方案:
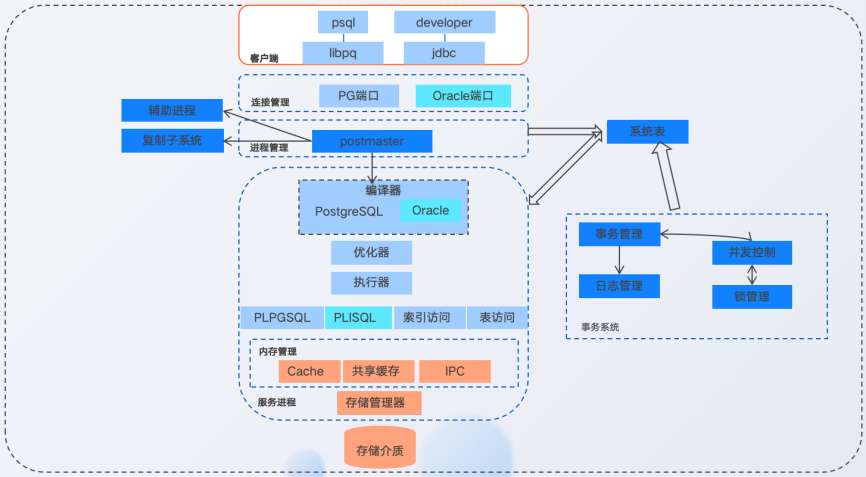
从官方仓库的代码结构来看,Oracle 解析器的语法文件(ora_gram.y)是独立存在的,跟 PG 原生的 gram.y 互不干扰。这印证了双解析器的设计思路——不是在原有解析器上打补丁,而是新增一套完整的解析器。
这个设计的精妙之处在于:
1. 语法层分离,执行层统一
- SQL 解析各走各的,PG 语法走原生解析器,Oracle 语法走新增的 ora_gram.y
- 解析完都生成 PG 的内部语法树,后面的优化、执行完全复用 PG 原生能力
- 这意味着 PG 内核的所有性能优化、新特性,IvorySQL 都能直接继承
2. 对内核侵入最小化
- 只在解析器入口加了一个 hook,根据端口或 GUC 参数决定走哪个解析器
- 核心执行引擎几乎没改,后续升级 PG 版本成本极低
- 从 16 到 17 再到 18,每次大版本升级 IvorySQL 都能在 2 个月内跟上,这就是架构优势
3. 插件化兼容层
- Oracle 特有的数据类型、函数、系统视图,都放在 ivorysql_ora 插件里
- 想用就加载,不想用就关掉,不影响原生 PG 的运行
- 兼容特性的迭代可以跟内核解耦,各自独立演进
我一直认为,好的架构不是功能最多,而是取舍最合理。 双解析器架构就是典型的取舍智慧——它不追求 100% 完美兼容,而是在兼容度、可维护性、性能三者之间找到了一个最优平衡点。
二、PL/iSQL:Oracle 迁移最深的那道坎
如果说 SQL 语法兼容是面子,那 PL/SQL 兼容就是里子。
很多企业的 Oracle 数据库里,跑着成千上万行存储过程、函数、包,这些才是业务逻辑的核心。迁数据库,最头疼的不是改 SQL,而是重写这些存储过程。
IvorySQL 在这方面的思路也很有意思—— 不是翻译,而是原生支持。
IvorySQL 的 PL/iSQL 模块,并非简单地在 plpgsql 上修修补补,而是基于 PostgreSQL 成熟的过程语言框架,全新实现了一套兼容 Oracle PL/SQL 语法的解析器和执行引擎:
- 词法分析器改成 Oracle PL/SQL 风格
- 语法分析器支持 Oracle 的语法糖(%ROWTYPE、%TYPE、EXCEPTION 处理等)
- 执行引擎复用 PG 的过程语言框架
这个方案的好处是:
- 原生执行,没有翻译层的性能损耗
- 可以直接调用 PG 内部的所有函数和类型
- 跟 PL/pgSQL 共存,同一个数据库里两种过程语言都能用
到了 5.x 系列,PL/iSQL 已经支持:
- 基本的流程控制(IF、LOOP、WHILE、FOR)
- 游标操作
- 异常处理
- %TYPE 和 %ROWTYPE 属性
- 嵌套子程序
- 包(Package)完整生命周期支持
这意味着什么? 意味着很多中等复杂度的 Oracle 存储过程,拿过来改改就能直接在 IvorySQL 上跑,不用完全重写。对于迁移项目来说,这可能就是能做和不能做的区别。
当然,PL/SQL 的兼容是个无底洞,Oracle 几十年积累的特性太多了。但 IvorySQL 这个路线是对的—— 先把 80% 常用的场景做好,剩下 20% 慢慢补,而且有架构支撑,补起来不费劲。
三、从 1.x 到 5.x:版本演进的技术逻辑
很多人看版本更新,只看加了什么功能,但我更关心为什么这个版本加这个功能。IvorySQL 的五个大版本,每一步都踩得很准:
1.x(2021-2022):验证技术路线
基于 PG 14,先做最基础的数据类型、函数兼容。目标不是做全,而是验证基于 PG 做 Oracle 兼容这条路走得通。快速迭代,收集用户反馈。
技术视角:这是典型的 MVP 思路。先跑通最小闭环,再考虑做大做全。很多团队死在一开始就想做完美的产品。
值得注意的是:直到今天,1.x 系列还在更新,最新版本是 1.22,基于 PG 14.22。这说明IvorySQL团队不仅致力于新版本的开发,也对已有的稳定版本保持着积极的维护和Bug修复,这对于生产环境的用户至关重要。
1.22 还新增了几个很实用的特性:
- 全局唯一索引(Global Unique Index):分区表的跨分区唯一索引,非分区键也能保证全局唯一性,PG 和 Oracle 双模式都支持
- 基表列类型变更时自动重建视图:改列类型时自动保存依赖视图定义,改完后按依赖顺序自动重建,省了很多手工操作
- 无主键表逻辑复制自动回退到 FULL IDENTITY:新增 GUC 参数,逻辑复制时遇到没主键的表自动用 REPLICA IDENTITY FULL,不用一张张表手动改
这些特性看起来不大,但都是实际生产中经常遇到的痛点。能关注到这些细节,说明团队是真的在跟用户一起打磨产品。
2.x(2022-2023):扩大兼容覆盖面
基于 PG 15,补更多的 Oracle 常用函数、系统视图。开始接触真实的迁移项目,收集一线需求。
技术视角:这是需求驱动的阶段。从我想做什么变成用户需要什么,这是开源项目从玩具到工具的关键一步。
3.x(2023-2024):架构重构,奠定基础
基于 PG 16,推出双解析器架构、双端口、PL/iSQL。从补丁式兼容升级为架构级兼容。
技术视角:这是最关键的一步。很多项目在 2.x 的阶段就卡住了——兼容特性越堆越多,代码越来越乱,最后重构不动。IvorySQL 敢在 3.0 做这么大的架构调整,说明团队有技术魄力,也有工程能力。
4.x(2024-2025):深化企业级能力
基于 PG 17,完善 Package、不可见列、权限管理。全平台支持,适配国产操作系统。推出在线体验环境,降低使用门槛。
技术视角:这是补短板的阶段。技术架构搭好了,接下来就是把企业级用得到的特性一个个补全。
5.x(2025-至今):拥抱 AI,开辟新战场
基于 PG 18,集成 AI 能力、云原生全面升级、支持 Skills 和循环工程,向 AI Agent 基础设施演进。
技术视角:这是最让我意外的一步。我原以为 IvorySQL 会一直在 Oracle 兼容这个赛道上深耕,没想到他们直接切入了 AI 赛道。
但仔细想想,这步棋走得很对:
- Oracle 迁移是存量市场,总有一天会饱和
- AI 是增量市场,空间大得多
- PG 生态天然适合做 AI 基础设施(pgvector 就是最好的例子)
- IvorySQL 有 PG 的底子,做 AI 能力是顺水推舟
而且最关键的是:他们不是为了蹭热点而加 AI,而是真的在做深度集成。
比如 5.4 推出的 IvorySQL Skills,官方描述是赋能 AI 助手成为 IvorySQL 数据库专家。这个定位很有意思——不是数据库加个 AI 插件就完事了,而是让 AI 助手能真正懂 IvorySQL,成为数据库专家。其效果如何,还需要更多用户在实际场景中检验。
结合现在 AI Agent 的趋势来看,这步棋很有前瞻性。以后数据库的使用方式可能会从写 SQL 变成跟 AI 说需求,那谁的数据库能让 AI 理解得更好、用得更溜,谁就有优势。
还有一点值得单独提——2026 年 6 月 Addy Osmani、Boris Cherny 等人提出的 Loop Engineering(循环工程)正在成为 Agent 时代的新工程范式,核心是“人从循环内的操作者退到循环之上的监督者”。这套范式包含自动化(Automations)、工作树(Worktrees)、技能(Skills)、连接器(Connectors)、子代理(Sub-agents)和记忆层(Memory)这六组件,其中 Skills(技能锚点)用来给 Agent 提供项目级事实基准,避免模型瞎编。
IvorySQL 5.4 配套的 IvorySQL Skills(Shawn Yan 开源,22 个技能包,覆盖部署、架构、Oracle 兼容、迁移等场景)正好踩在 Skills 这个组件上——让 Claude Code / Codex 这类 Agent"更懂 IvorySQL",而不是只会背 PG 通用知识。目前 IvorySQL 在 Loop Engineering 全套六组件里只落地了 Skills 这一段,但方向是对的:Agent 时代,谁能把数据库的领域知识做成 Agent 可消费的 Skills,谁就有话语权。
另外,5.4 一下子支持了 24 个 PostgreSQL 扩展,覆盖 AI、GIS、全文检索、调度、审计等各个领域:
- AI 相关:pgvector、pg_ai_query、AGE
- GIS 相关:PostGIS、pgRouting
- 全文检索:pg_bigm、pg_jieba、PGroonga、pg_textsearch、Zhparser
- 运维调度:pg_cron、pgagent
- 性能优化:pg_hint_plan、pg_show_plans、pg_stat_monitor、plpgsql_check
- 数据集成:pgsql-http、redis_fdw、pg_curl
- 其他:ddlx、pg_partman、PgBouncer、system_stats、wal2json
这个扩展列表很有含金量,基本覆盖了企业级应用的所有常见场景。数据库的竞争,到最后拼的就是生态。
四、工程化:一个开源项目成熟度的试金石
看一个开源项目靠不靠谱,别光看功能列表,去看看它的工程化水平。代码规范、CI/CD、测试覆盖、发布流程,这些才是项目能不能长期维护的关键。
IvorySQL 在这方面做得相当扎实,从官方仓库能看到不少细节:
1. 代码规范与格式化
仓库里有 .githooks/pre-commit 钩子,提交代码时自动用 pgindent 格式化 C 代码。还有 make code-format 命令可以手动格式化。
Cirrus CI 上有专门的 FormatCheck 工作流,PR 里如果代码格式不对,CI 直接挂掉。这保证了整个代码库的风格一致性,对长期维护非常重要。
2. CI/CD 体系
用的是 Cirrus CI,从配置文件来看,任务分得很细:格式检查、构建测试、回归测试、多平台验证等等。PR 合并前必须过 CI,这是开源项目的基本操作,但能坚持做好不容易。
还有 CodeRabbit 的配置,说明他们在用 AI 辅助代码审查。这个挺潮的,也符合他们拥抱 AI 的整体路线。
3. 开发环境
提供了基于 Docker 的开发环境,docker compose up -d 就能起一个带所有依赖的开发容器。还有 Dev Container 配置,VS Code 里一键打开开发环境。
这对新贡献者很友好——不用花半天时间搭环境,拉代码直接就能开发。开源项目的贡献门槛越低,社区就越容易活跃。
4. 构建系统
除了传统的 Makefile,还全面支持 Meson 构建系统。PostgreSQL 社区近年已将 Meson 作为现代化的标准构建系统,而紧跟 PG 18 内核步伐的 IvorySQL 完美继承了这一技术底座。兼容两种构建系统,既照顾了老用户的使用习惯,又彻底拥抱了最新的工程化标准,给开发者更多选择。
5. 多仓库组织架构
IvorySQL 的开发分布在四个官方仓库:
- IvorySQL/IvorySQL:数据库主仓库,核心代码
- IvorySQL/Ivory-www:官方网站
- IvorySQL/IvorySQL_docs:文档
- IvorySQL/docker_library:Docker 镜像
这种分仓库的组织方式很专业,各仓库职责清晰,各自独立迭代。文档和代码分开,也方便文档贡献者参与,不用把整个数据库代码都拉下来。
总的来说,IvorySQL 的工程化水平在国内开源数据库项目里属于第一梯队。 很多项目只关注功能,不关注工程化,结果越做越乱,最后维护不动。IvorySQL 在这方面的投入,说明他们是认真想做长期项目的。
五、云原生:数据库的下一个战场
5.x 系列另一个让我印象深刻的变化,是云原生能力的全面升级。
以前的 IvorySQL,你得自己下载安装包、编译、配置、搭集群。现在:
- Docker Compose 一键起单机
- Podman、Swarm 都支持
- Helm Chart 一键部署到 K8s
- IvorySQL Operator 管理全生命周期
- IvorySQL Cloud 可视化管理平台
这背后是数据库交付模式的变化。 以前企业买数据库,买的是软件 license;现在企业用数据库,要的是服务——一键部署、弹性伸缩、自动备份、监控告警、故障自愈。
IvorySQL Cloud 的推出,标志着他们从卖数据库软件转向卖数据库服务。这个转型在云原生时代是必须的,转得越早,优势越大。
IvorySQL 采用清晰的开源 + 商业双轨架构:
✧ 社区版:内核、Operator、Helm Chart 等核心能力全部开源
✧ 企业版:瀚高 HighgoDB(HGDB)提供企业级特性与技术支持
✧ 云服务:最新发布的 Higobase 提供全托管数据库服务能力
这个模式很典型——开源做生态、做广度;商业做服务、做深度。既保证了社区的活力,又有商业闭环。
六、几点冷静的观察和建议
说了这么多优点,作为技术人,还是得说点实在的问题和建议:
1. Oracle 兼容的最后一公里还很长
目前 IvorySQL 已经覆盖了大部分常用场景,但一些偏门的 Oracle 特性(比如某些优化器 hint、特殊的内置包、高级分区特性)还不支持。对于核心系统迁移来说,可能就卡那么一两个特性。
建议:可以考虑做行业兼容包——比如针对金融行业,重点补财务系统常用的那些 Oracle 特性,比漫无目的地全量补效率高得多。
2. 性能优化还有空间
双解析器架构在解析层的开销很小,几乎可以忽略。但 Oracle 兼容层(数据类型转换、函数实现等)还是有一些性能损耗的,特别是高频调用的场景。
建议:可以针对常见的 Oracle 函数做专门的性能优化,甚至用 C 重写一些热点函数。毕竟企业迁移,性能是硬指标。
3. 生态建设要跟上
PG 生态强大,很大程度上是因为扩展多。IvorySQL 虽然理论上兼容所有 PG 扩展,但实际使用中,有些扩展跟 Oracle 兼容模式一起用可能会有兼容性问题。
建议:建立一个官方认证的扩展兼容列表,告诉用户哪些扩展在 Oracle 模式下经过了测试,哪些可能有坑。这样用户用起来更放心。
4. AI 能力要做出差异化
现在大家都在加 pgvector,都在做 NL2SQL,如果只是简单集成,很难做出差异化。
建议:IvorySQL Skills 目前 22 个技能已覆盖部署、架构、Oracle 兼容、迁移等场景,是个很好的起点——Shawn Yan 那边已经开源了 ivorysql-migration(Oracle/MySQL → IvorySQL)和 ivorysql-oracle-compat(21 项兼容点)两个技能包,方向上社区已经铺了砖。下一步可以往迁移评估自动化再深一步:比如让 Agent 读 Oracle 源库的 DDL + PL/SQL 包,自动输出不兼容点矩阵 + 改写后的 IvorySQL DDL/PL/iSQL,附带人工复核建议。这块如果做成,对迁移动目的价值是指数级的。
另外结合 IvorySQL 的 Oracle 兼容优势,还可以做兼容 Oracle 语法的向量能力——比如 PL/SQL 里直接调向量检索、Oracle 风格的向量操作函数,从 Oracle 过来的用户不用学新东西就能用 AI 能力,这才是真正的差异化,比单纯集成 pgvector 有意义得多。
七、写在最后
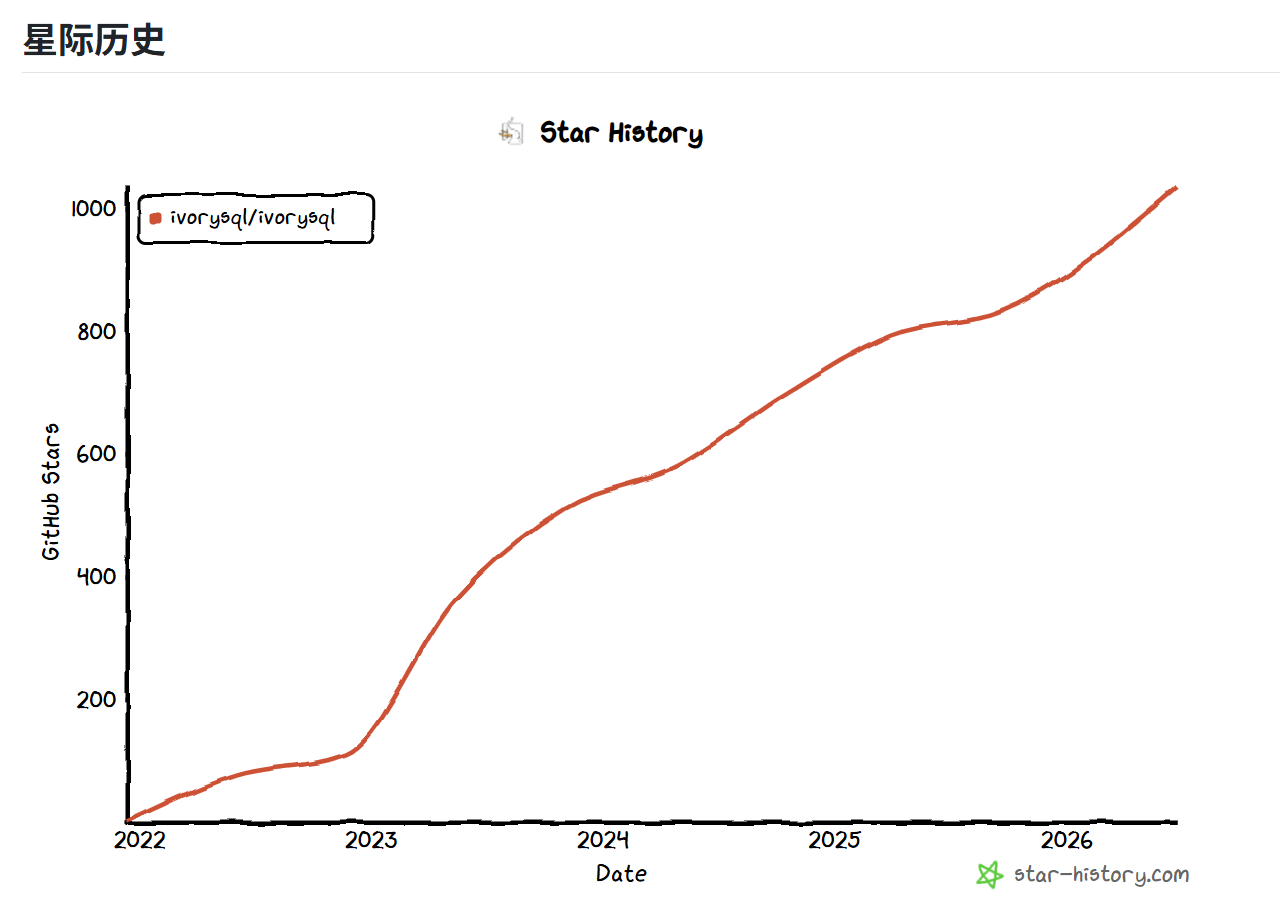
做数据库是个苦活累活,慢工出细活。很多项目轰轰烈烈地来,悄无声息地走,能坚持五年以上的不多,上图也能看到 IvorySQL 在开源项目中的受欢迎程度。
IvorySQL 这五年走下来,我看到的是一支有技术追求、有工程耐心、有商业头脑的团队。他们不喊全面超越 Oracle 这种口号,而是踏踏实实地一个特性一个特性地补,一个版本一个版本地迭代。
从双解析器架构的技术选型,到开源加商业的商业模式,再到 AI 加云原生的战略布局,每一步都走得很稳、很准。
作为 PG 社区的参与者,很高兴看到这样的项目——它不是在重复造轮子,而是在 PG 的基础上做有价值的创新,既回馈了社区,又满足了市场需求。
未来几年,信创替换还会持续深入,AI 应用会越来越普及,数据库作为基础设施,会迎来新的机遇和挑战。IvorySQL 能不能抓住这个机会,从 Oracle 迁移首选成长为 AI 时代的企业级数据库,我们拭目以待。
从目前的技术路线、工程质量和执行节奏来看,这支团队的表现是值得信赖的。
参考资料
- IvorySQL 官方主仓库:https://github.com/IvorySQL/IvorySQL
- IvorySQL 官方网站:https://www.ivorysql.org/zh-hans/
- IvorySQL 文档仓库:https://github.com/IvorySQL/IvorySQL_docs
- IvorySQL Docker 镜像仓库:https://github.com/IvorySQL/docker_library
- IvorySQL 在线体验平台:https://trial.ivorysql.org/
- PostgreSQL 官方网站:https://www.postgresql.org/
- Shawn Yan. IvorySQL Skills GitHub 仓库:https://github.com/shawn0915/ivorysql-skills
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70043484/viewspace-3175318/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- PostgreSQL 18 性能与执行计划新特性实测
- PG Hacker的成长之路——一位PostgreSQL社区开发者的经验与教训
- PostgreSQL 日报|TOAST v2 更快更小免迁移(10 月 19 日)
- PostgreSQL 日报| PG19 主备切换挂起修复(10 月 17 日)
- IvorySQL 校园行走进山东大学:从 PostgreSQL 到 AI,连接技术实践与职业成长
- PostgreSQL 日报| PostgreSQL 19 RC1 正式发布(10 月 16 日)
- 不装库玩转 PG 18?这个沙盒连内核补丁都能测 —— PGNexus 实操实录
- PostgreSQL 日报| PgBouncer 修复三个 CVE 漏洞(10 月 15 日)
- 直播预告| IvorySQL 5.6 新特性解读与 PGNexus 沙盒实操演示
- PostgreSQL 日报| pg_vectorsearch 开源向量搜索发布(10 月 14 日)
