当数据库宕机时,PostgreSQL 高可用在背后做了什么?
本文整理自 IvorySQL 2025 生态大会暨 PostgreSQL 高峰论坛的演讲分享,演讲嘉宾:孟飞龙,瀚高股份研发工程师。
本文主要从以下 4 个方面进行分享:
- 前言
- 故障检测与转移
- 问题探讨
- 结语
前言
前言部分主要介绍一些 PostgreSQL 高可用相关的概念,让大家对高可用有一个大概的了解。
PostgreSQL 高可用简述
-
高可用的作用
在数据库宕机的危机时刻,PostgreSQL 高可用架构会通过一系列精密设计的机制,悄然接管服务并保障业务连续性。 -
高可用的基础
流复制,主库将预写日志(WAL)实时发送至备库,备库通过应用日志实现数据同步。同步复制模式下牺牲部分性能换取零数据丢失。
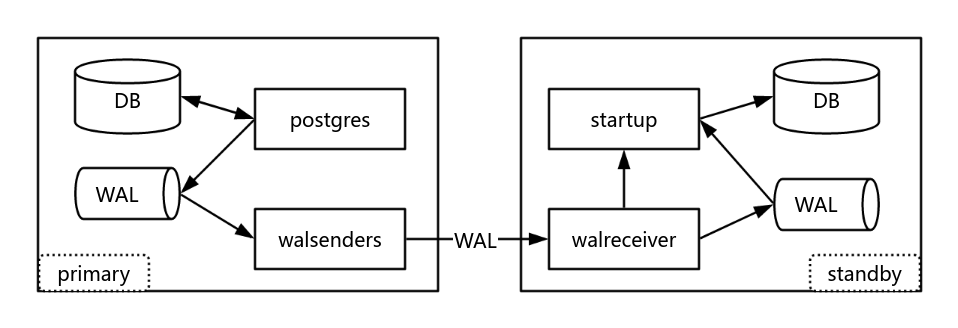
上图为流复制示意图。左侧为主库,当用户写入数据,数据库不会直接把数据写入磁盘,而是先把 WAL 写到磁盘,然后通过 walsenders 进程将 WAL 发送到备库。右侧的备库,通过 walreceiver 进程接收 WAL 日志,然后通过 startup 进程将日志进行重做,使数据落盘,从而实现主备之间的数据同步。为了实现数据的零丢失,一般会将流复制模式设置为同步模式。
-
高可用的动作
提升备库为新主库,通常通过设置 vip 使应用无感知地连接主库。 -
高可用的难题
脑裂防护,如因网络分区造成的多主问题。
PostgreSQL 高可用开源软件
- Pgpool-II
- 核心功能:连接池、负载均衡、读写分离、故障转移
- 局限:配置复杂度较高,故障转移需结合自定义脚本
- Repmgr
- 核心功能:主从复制管理、自动化故障转移、监控复制状态
- 局限:在某些复杂场景下的灵活性和自动化程度较弱
- Stolon
- 核心功能:云原生高可用,支持 Kubernetes 集成。
- 局限:依赖外部存储,性能受存储层限制
- Patroni
- 核心功能:自动化、强一致性和云原生支持,比较主流
- 局限:依赖分布式协调服务的强一致性,增加了架构的复杂度
故障检测与转移
故障检测
1. 数据库故障检测
高可用组件通过检查主库进程状态或数据库连接来判断健康状况:
- 主库故障:触发新主选举。
- 同步备故障:降为异步备。
工作原理:
- Patroni:通过监控 PG 进程检测故障,若主库进程缺失,尝试重启或根据配置降级。
- Repmgr:通过连接数据库判断健康状况,主库故障时通知备节点竞选新主,同步备故障影响主库写入需处理。
2. 服务器故障检测
高可用组件通过主库状态判断健康状况:
- Patroni:依据 DCS 中的 leader 状态。
- Repmgr:通过连接主库和 witness 判断。
- 故障类型:断电、断网。
工作原理:
- Patroni 实时监控 Node A 数据库状态,若异常且无法恢复,删除 etcd 中的 leader 键。
- Node B 和 C 检测到 leader 缺失,发起竞选。
- 若 Node A 服务器故障,Patroni 未更新 etcd leader(超过 TTL,如 30 秒),etcd 清除 leader,备节点重新竞选。

故障转移
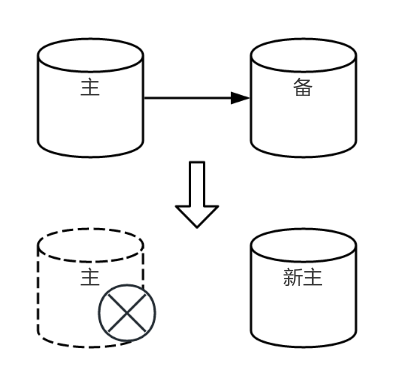
当主库故障且高可用软件判断无法恢复时,需选举新主节点并执行 promote 操作以恢复服务。由于通常配置多个备节点(Node B),需通过选举确定哪一节点成为新主。
- 选举依据:高可用软件优先考虑 LSN(日志序列号),选择与主库数据量最接近的节点。通常提供“故障优先级”参数,优先级越高者选举优先级越高。
- 同步节点提升:如 Patroni,会优先提升同步备节点为新主。
- 新主处理:新主执行 promote 操作后,其他备节点更新其 primary connection 信息,追随新主建立流复制。可配置物理或逻辑复制槽,高可用工具会相应处理这些槽。
问题探讨
RPO 和 RTO
-
RPO 与性能
RPO(Recovery Point Objective,恢复点目标) 是衡量系统在故障或灾难发生后,允许丢失的数据量(以时间为单位)——数据丢多少。
想要做到 RPO=0 需要将流复制设置为同步模式,备库延迟过高会影响主库的写入。
-
RTO 与稳定
RTO(Recovery Time Objective,恢复时间目标)是衡量系统在故障或灾难发生后,业务功能恢复到可接受水平所需的最大可接受时间——多久能恢复。
想要减小 RTO 就需要减小高可用的检测间隔,但较小的检测间隔又会影响集群的稳定,一点网络波动就会造成误判,导致集群频频切换主备。
离线节点回归
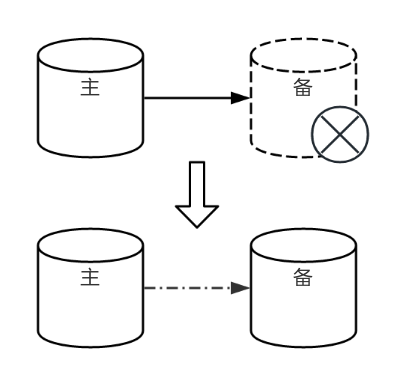
问题描述
长时间离线节点回归集群时,因缺失 WAL(Write Ahead Log)日志,无法与主库建立流复制。
解决方法
-
配置物理复制槽
- 优点:可支持节点回归。
- 缺点:配置复杂,且若节点yongjiu离线,主库物理复制槽保留 WAL 日志,占用磁盘空间。
-
配置日志归档与恢复
- 方法:将 WAL 日志备份至远程磁盘,确保离线节点回归后可恢复。
- 缺点:需额外远程服务器资源。
-
无配置时的应急方法
- 方法:重做备库(最原始方式)。
注意事项
- 主节点离线回归:若主节点长时间离线并接收新数据,与新主数据不一致,需同步数据。
- 日志覆盖问题:新主覆盖 WAL 日志后,原主节点尝试恢复仍可能成功,但因缺失日志无法启动,会持续寻求主库发送缺失日志(操作失败)。
脑裂防护
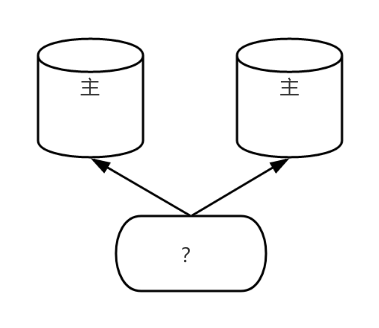
问题描述
数据库脑裂会导致应用无法判断数据写入目标主库,引发数据分歧或丢失。
解决方法
- Repmgr:通过配置 witness(见证节点)或手动设置 location 参数,解决网络分区问题,防止脑裂。
-
Patroni:依赖 DCS(如 etcd)的 Raft 协议,需多数派共识才能维持服务,天然规避脑裂。但若 Patroni 进程异常退出(如主库进程未随退出),备节点可能选举新主,导致脑裂。
-
解决措施:
- Watchdog:若长时间未接收 Patroni 心跳,触发系统重启。
- 故障重启:故障重启:通过 systemd 服务配置 Patroni 故障重启机制。
- 最佳实践:设置 VIP 绑定新主,避免脑裂影响。
-
解决措施:
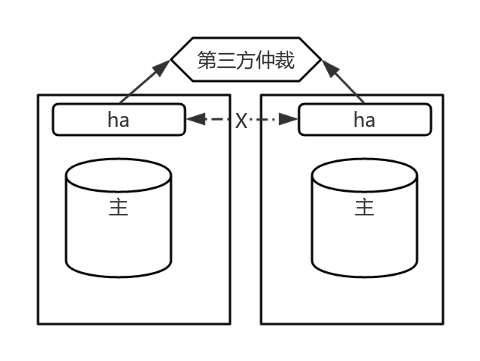
两节点部署的极限问题
问题背景
通常,稳定的 PG 高可用集群需至少三个节点支持。但客户仅提供两台服务器,需实现高可用。
解决方法
- 第三方仲裁方式:引入网关 IP 作为仲裁。当一节点故障,另一节点尝试与仲裁联通,若成功则视为正常节点。
风险与局限
- 脑裂风险:若两节点正常但因网络隔离互不可达,均可与第三方仲裁联通,可能导致脑裂。目前两节点极限部署无完美解决方案。
- 实际应用:客户需求迫切下,采用此方案,脑裂风险发生概率较低。
结语
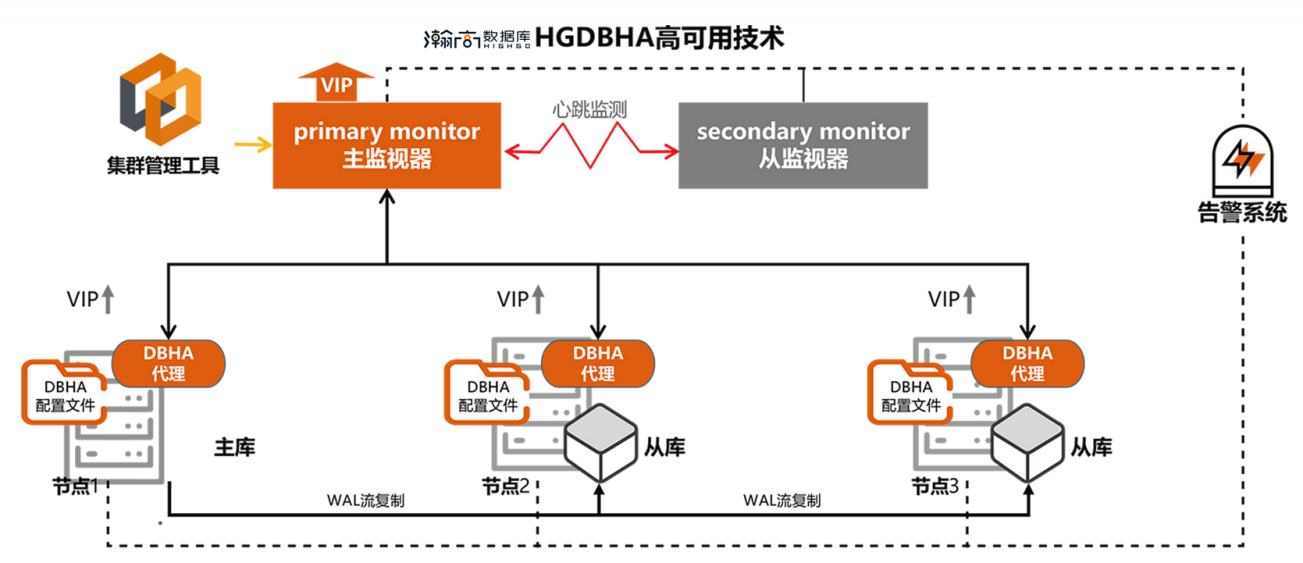
PostgreSQL 高可用架构通过“监控-检测-转移-恢复”的闭环设计,将数据库宕机的影响降至最低。其背后是流复制、分布式协调、智能选主等技术的深度融合,更是对业务连续性需求的精准回应。在实际部署中,需结合场景选择同步/异步复制模式,配置合理的监控告警,并定期演练故障恢复流程,方能筑牢数据安全的最后一道防线。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70043484/viewspace-3094982/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- PostgreSQL 18 性能与执行计划新特性实测
- PG Hacker的成长之路——一位PostgreSQL社区开发者的经验与教训
- PostgreSQL 日报|TOAST v2 更快更小免迁移(10 月 19 日)
- PostgreSQL 日报| PG19 主备切换挂起修复(10 月 17 日)
- IvorySQL 校园行走进山东大学:从 PostgreSQL 到 AI,连接技术实践与职业成长
- PostgreSQL 日报| PostgreSQL 19 RC1 正式发布(10 月 16 日)
- 不装库玩转 PG 18?这个沙盒连内核补丁都能测 —— PGNexus 实操实录
- PostgreSQL 日报| PgBouncer 修复三个 CVE 漏洞(10 月 15 日)
- 直播预告| IvorySQL 5.6 新特性解读与 PGNexus 沙盒实操演示
- PostgreSQL 日报| pg_vectorsearch 开源向量搜索发布(10 月 14 日)
