2020CCF虚拟身份归一处理性能优化-冠军方案


本次冠军方案由翼数所普拉斯团队分享,该团队在2020CCF数据湖赛道也取得了亚军成绩,让我们看看最优化大佬的专属自己的一套解决方案吧!学废了你也是冠军潜力种子选手!

https://www.datafountain.cn/competitions/464/datasets

背景:随着近年来互联网的高速发展,各种类型多样的网络应用程序呈现爆炸式增长,人们对于互联网的依赖迅速增长,与现实社会不同的是,用户可以通过网络虚拟身份而非真实身份实现所有的网络行为,网民拥有的网络虚拟身份组成了一个巨大的虚拟网络社区,社区中的虚拟身份可能有着直接或者间接的关系。
移动互联网时代,每天都会产生海量的数据,如现实生活中的住宿、驾车、出行等,虚拟世界中的即时通讯、第三方支付等;数据量大、无统一的标识特征,导致各类数据零散、无法关联,如何自动分析并将相关数据的身份进行归一化,成为提升海量数据分析能力和分析效率的工作难点。
本赛题目标为在从样本数据中,提取所有具有关联关系的虚拟身份信息进行归一化,识别多个属于同一个现实用户的所有虚拟身份,并将其合并到一起,最终生成一个虚拟身份库。任务:参赛者采用统计学理论方法、数据挖掘中的关联分析、图论相关算法完成虚拟身份归一化。

数据简介:样本数据采用随机生成方式产生,用作后续模型计算。
数据说明:提供两个数据样本集,分别账号样本集(accounts.txt)和关联样本集(relatins.txt)。
-
【账号样本集】
账号样本集,包含两个字段,分别为临时唯一id和账号字段(随机生成),两个字段采用空格分隔。字段信息 类型 描述 Id Long 全局唯一id Account string 账号名称 -
【关联样本集】
关联账号样本集,包含4个字段,分别为关联A账号临时唯一id、关联A账号账号字段、分别为关联B账号临时唯一id和关联B账号账号字段字段信息 类型 描述 src_Id Long 账号A全局唯一id src_Account string 账号A名称 dest_Id Long 账号B全局唯一id dest_Account string 账号B名称

采用JAVA语言实现虚拟账号归一化,通过JVM配置内存约束,避免内存等因素对执行性能的影响(不要应用分布式计算框架实现)。
代码编写采用Java SE 8,小版本在100以上。禁用类似通过JNI等手段调用本地库实现计算。参赛者在线提供可运行程序jar包(Runnable JAR File。注意执行jar包的执行方式为:java -jar -Xms2024m -Xmx2024m -Xmn1024m),样本数据文件accounts.txt,relations.txt存储在可运行程序包同级目录下(使用相对目录方式读取文件内容,无需将测试数据文件打到可运行jar包中,在测试过程中,会将测试文件与可运行程序包放到相同的目录下,可运行程序包在读取测试数据文件时需要注意控制相对目录),计算结果输出到同目录的result.txt文件中。
参赛者以txt文件格式输出,具体字段为虚拟身份归一ID,虚拟身份账号字段(多个虚拟账号值存到当前字段中,各个虚拟账号之间通过逗号进行分割,统一身份id与虚拟身份账号之间采用空格分隔)。在计算结果中,对于每个簇,采用当前簇的最小账号的id作为整个簇的id,结果集按照uniqueid进行排序输出。具体示例请参考【输出结果示例】。
参赛者需要严格按照排序规则进行文件的输出,平台在检查结果输出时将判别参赛者提交的文件的MD5值来检查是否输出的正确的结果。
字段信息 类型 描述 uniqueid Long 虚拟账号全局唯一id accounts string 多虚拟账号(逗号分割)
【输出结果示例】
1、ac3cc39016a628a5, 915cdc8925ad0bab,
93b63bb31a91726c,d6a5b95a735cb0d5,870bc291129ddc1c
2、aa9bac15560ca792,dd3dd92dd2b271ca,a6abbcbac29a649c,
3、c1d00bd2b61b835

同一时间段,只能运行一个可执行程序,避免多任务同时运行,降低对测试结果的影响。
应用同一台机器进行测试,统一设置JVM信息(标准JVM为1G)。关于测试执行采用外置脚本启动测试,从发出运行命令开始计时,在捕获进程结束时捕获结束时间,两个时间的差作为程序执行时间(时间单位纳秒)。
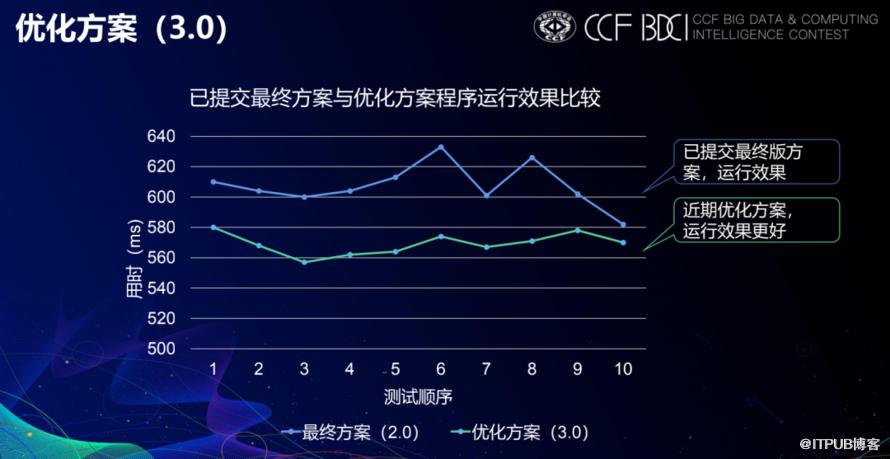
在正式测试之前,对所有的参赛者提交的试题进行试跑1次,在试跑完成后,正式执行赛题的性能测试,首先,对参赛者提交的试题10次,去掉两个最高分,去掉两个最低分,其余6次测试结果取平均值。
裁判方运行验证程序判断输出结果与标准输出结果的偏差,如果输出结果存在偏差,即为0分。在输出结果完全正确的前提下,以执行时间作为二次裁决依据,时间越短,排名越高。
为方便大家横向比较自己的性能情况。将执行的秒数定义为x,排行榜展示的得分。

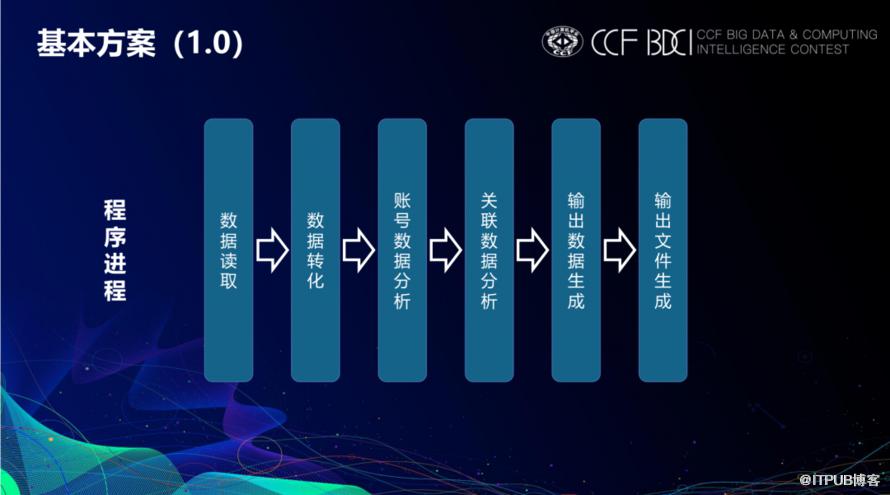
优化策略:从线程分配、关系计算、数据处理三个方面来考虑
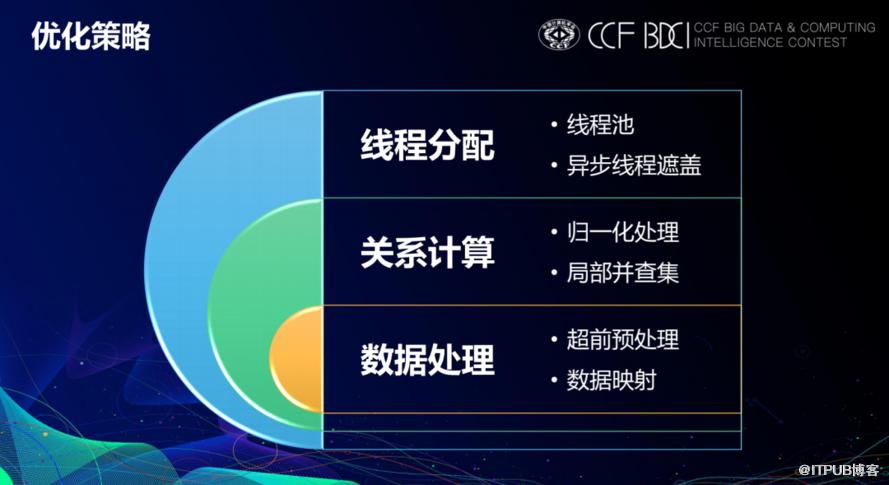

数据映射:对文本文件进行映射读写
超前预处理:预估账号数量和关系数量
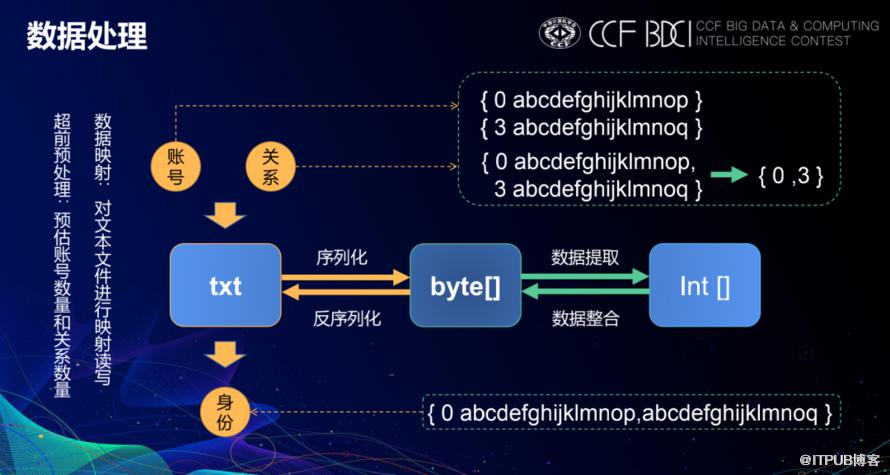

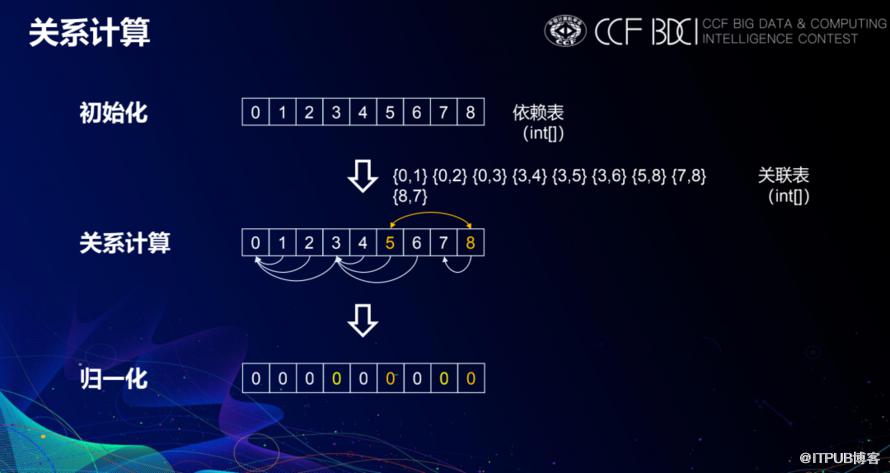
(1)初始化、关系计算、归一化;
-
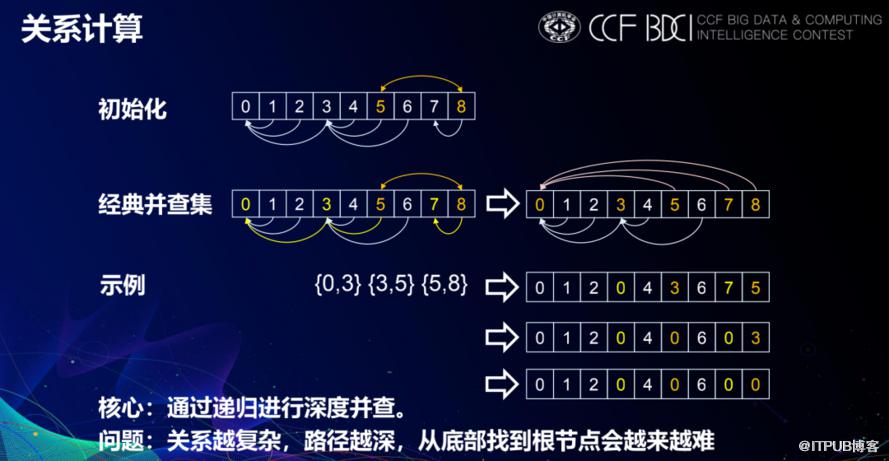
(2)初始化、经典并查集、示例;
核心:通过递归进行深度并查;
问题:关系越复杂,路径越深,从低部找到根结点会越来越难。
-
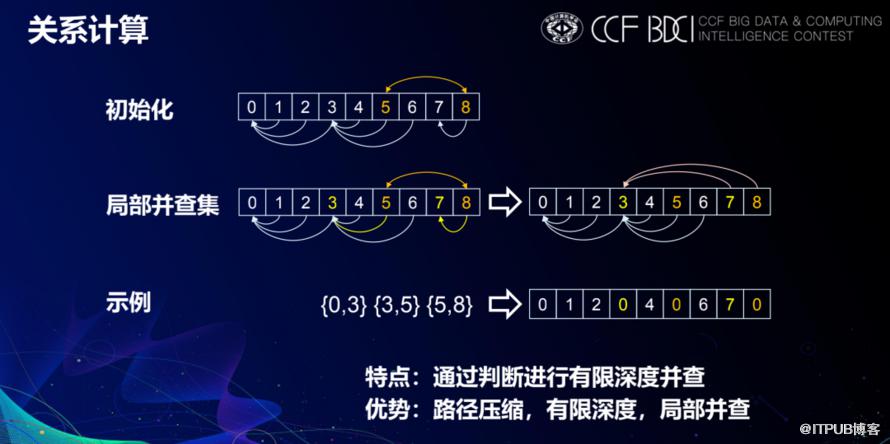
(3)初始化、局部并查集、示例。
特点:通过判断进行有限深度并查;
优势:路径压缩,有限深度,局部并查。

特点:数据读写、关联关系计算耗时较长
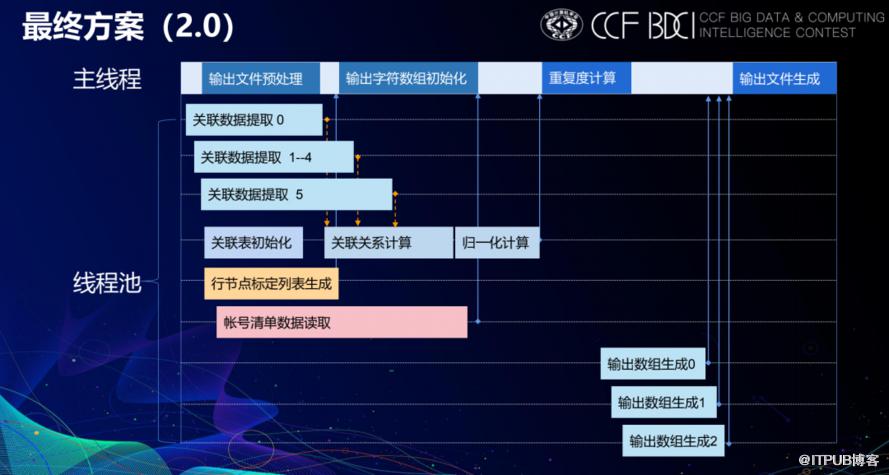
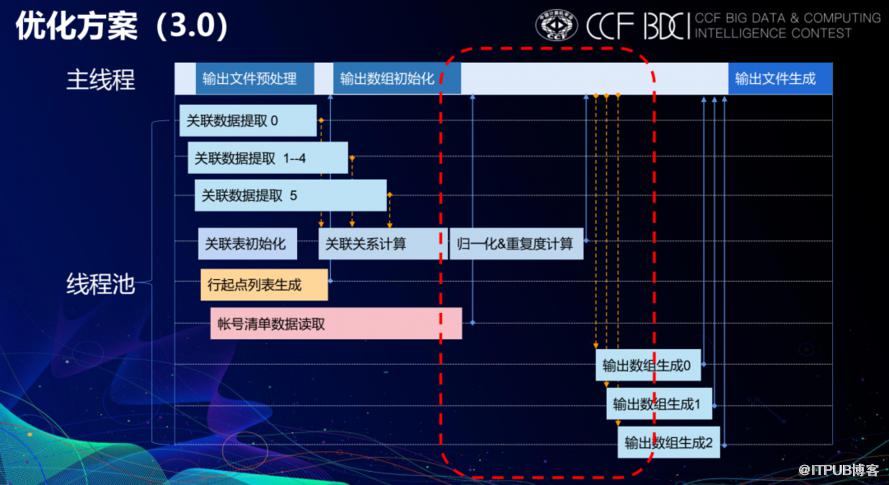
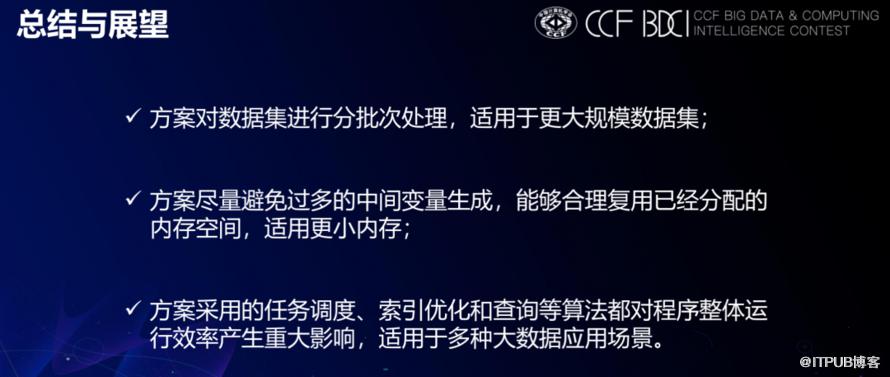
处理:分批次递增式多线程读取;依赖关系分析任务即时调用;分批次数据生成
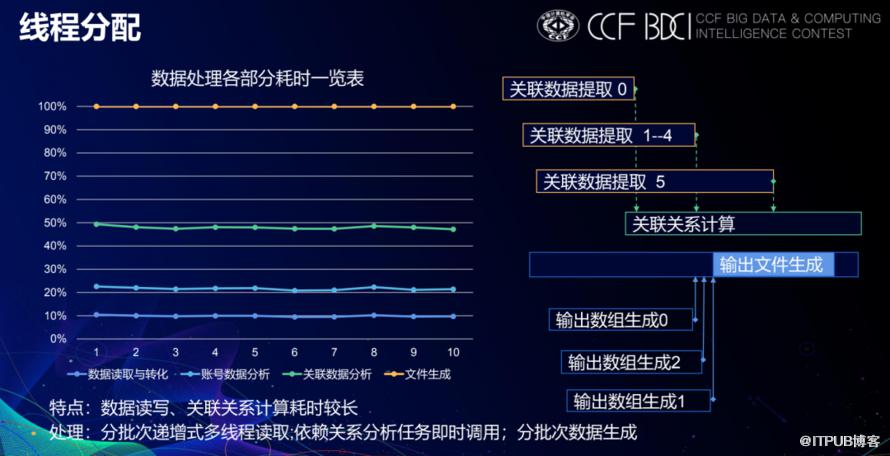

主线程:输出文件预处理、输出自负数组初始化、重复度计算、输出文件生成





欢迎阅读,完整代码详见https://github.com/wang-zhq/RuiAn
欢迎扫码关注ChallengeHub学习交流群,敬请期待该团队在数据湖赛道的亚军方案!

原文作者:ChallengeHub;如有侵权,请联系管理员删除。

