2020CCF元信息发现与分析-亚军方案


续接上篇大佬的冠军文章,本篇亚军方案来自大佬的另一支队伍「别忘了我们是学控制的」团队,继续来学习大佬的解决思路吧!

https://www.datafountain.cn/competitions/485

背景:数据湖分析(阿里云数据湖:https://www.aliyun.com/product/datalakeanalytics)是目前炙手可热的、全新的大数据方向,主要在低成本、无限容量的对象存储(比如阿里云OSS)系统中,存储各种各样的数据,并以存储计算分离架构方式,构建出结构化的元信息,最终围绕这些元信息和数据,在上层构建各种各样的分析和计算服务。一般包含结构化、半结构化、非结构化等类型的数据,并且数据量巨大,分析难度很高。结构化和半结构化数据是数据湖目前主要的处理对象。
本题希望选手模拟数据湖分析场景,在云平台环境上,为纷繁复杂的云数据构建元信息,并实现简单的分析能力。任务:在数据湖场景中,通过对大数据集信息的发现,结合索引优化,模糊匹配等相关技术,对给定的条件,快速过滤并准确计算出满足条件的记录行的总数。
出题单位:阿里云

数据简介:样本数据采用随机生成方式产生,实际测试数据集结构不同,规模更大
数据说明
1.具体文件数据举例如下:
root> cat database/table3/xxx.csv2000-08-05|umwcj|17720704453|9250751
2020-08-10|uopxt|14608876010|8887905
2002-04-09|wfdam|14611136027|2455334
2020-12-30|dqmti|15567374296|5436070
2.每一行的查询参数格式如下,每一行代表一次对数据集的查询分析:
${表名} ${比较列} ${操作列} ${比较值} ${like匹配列} ${like匹配类型} ${like匹配值数组}
${表名} ${比较列} ${操作列} ${比较值} ${like匹配列} ${like匹配类型} ${like匹配值数组}
${表名} ${比较列} ${操作列} ${比较值} ${like匹配列} ${like匹配类型} ${like匹配值数组}
......
# 参数解释如下
${表名}:字符串,表示定位一个表名(一定存在)
${比较列}:字符串,表示该表的某个列名(包括数据列和分区列,一定存在),用来做数据粗筛
${操作符}:字符串,取值范围'>','<','=','!=',表示${比较列}需要满足一定的筛选条件,注意统一满足字符串的比较语义
${比较值}:字符串,表示${比较列}满足一定条件所对应的比较值,用单引号引用
${like匹配列}:字符串,用来做like语义的列名(一定存在)
${like类型}:字符串,'ALL_LIKE'表示所有模式串都能匹配才成功,'ANY_LIKE'表示任意一个模式串匹配就成功,'NONE_LIKE'表示任意一个模式串都不匹配才成功
${like匹配值数组}:不定长的like匹配字符串列表,"['模式串1','模式串2','模式串3',....'模式串n']",用单引号引用,其中模式串个数n > 0 && n <= 10
# 参数举例
table1 column0 > '1996-08-20' column1 ALL_LIKE ['156%6','%39_']
比较列和匹配列同时满足匹配条件时,该行记录才算匹配
其中like搜索值同于数据库like关键字的语义,
%表示匹配0到多个字符,_表示有且只匹配一个字符,\可以用来转义%和_和\。

参赛者将所需要的各类文档、源代码等压缩打包后,通过大数据竞赛平台提交,主办方进行下载后评审
程序通过输入给定的数据集根目录,以及包含多组查询参数的纯文本地址(每组查询参数只在同一行),要求在当前目录下输出一个名为out.txt的文件,文件的每一行对应着每行查询参数参与计算后的匹配记录的总行数。其中要求:
为模拟真实的查询场景,程序在查询计算过程中要求对每一条查询参数逐行读取并单独计算
不允许使用任何开源框架,只能依赖JDK原生API
其中JDK版本要求JAVA8,maven版本要求3.x(不允许依赖外部库)。
需提交可编译的java项目源码(打包code.zip)
程序入口Main.java
提交示例
root> ls -Fdatabase/ params.txt code/root>root> cat params.txttable1 column0 > '1996-08-20' column1 ALL_LIKE ['156%6','%39_']
table2 column0 = '2020-10-10' column2 NONE_LIKE ['%hello%']
table3 column0 < '2015-07-07' column3 ANY_LIKE ['%com','%edu','%xyz']root> cd code/code> mvn compilecode> mvn exec:java -Dexec.mainClass="Main"code> cd ..root> ls -Froot> database/ params.txt code/ out.txt

评测环境,4c8G40GB的阿里云ECS实例
单次评测的运行时间限制在10分钟内,否则判超时
多次执行,去掉最高和最低耗时,取平均耗时(毫秒为单位)为结果
评测状态有三种:超时,错误,正确+运行毫秒值
在输出结果完全正确的前提下,执行时间越短,排名越高


数据载入采用高IO性能与位置索引特性的Byte数组;
自建快速模糊查询算法;
配合高效的目录索引和列索引机制;
充分利用多线程实现并行处理;
充分考虑JAVA的内存回收机理。


》针对Byte数组的快速模糊查询引擎
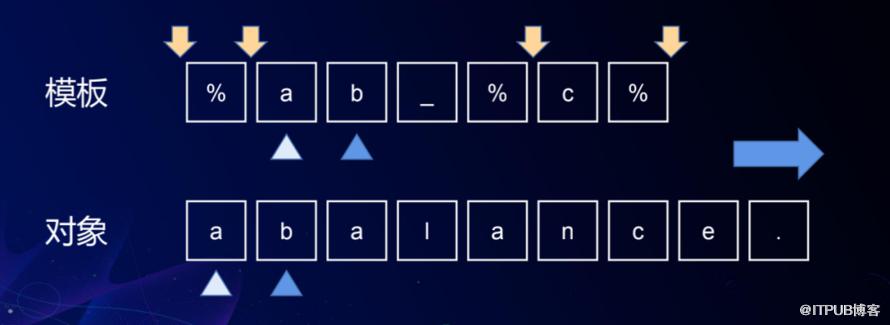
注:每一个“%”表示一个新的匹配区间的开始
》反向匹配,保证通配符标记再一次发挥作用
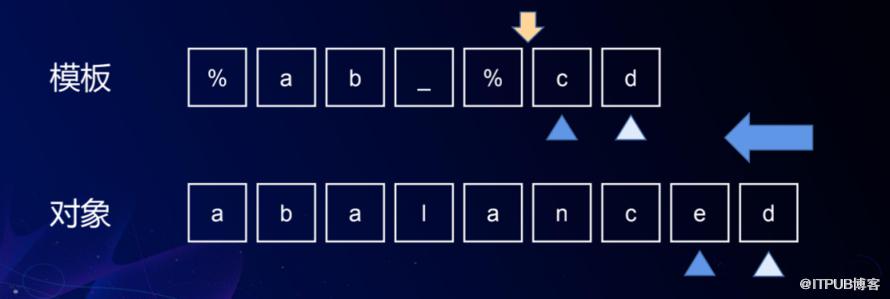
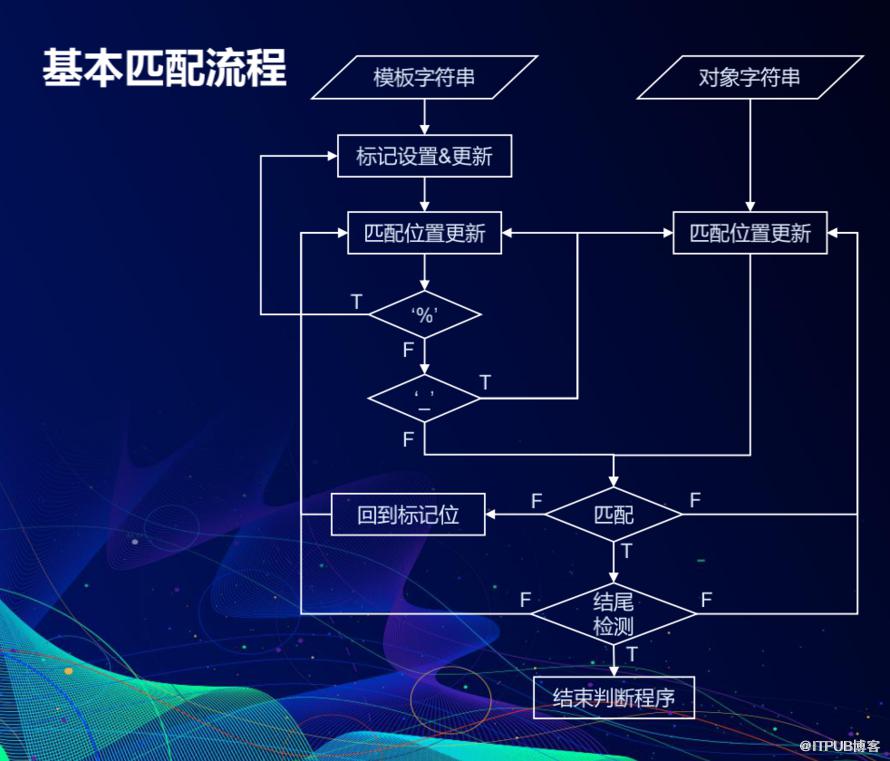
》搭建如下的匹配流程,有如下的优势:
此匹配算法的对比周期不会长于通配符的区间长度,对于超长的匹配对象具有很高的匹配效率。
结合集合的逻辑判断特性,对于ANY_LIKE、ALL_LIKE、NONE_LIKE等组合查询设计提前中止条件
适用于其他字符类数组结构以及数据流流模式


-
Step1. 建立目录索引
1.1. 分table扫描数据目录和文档大小,建立子目录索引;
1.2.建立HashMap<table名称,目录索引信息>
-
Step2. 逐条进行参数查询,分级查[table][目录路径][列数据]
2.1 建立文档列索引与HashMap<目录路径,Byte[]数据>
2.2 利用目录索引和查询引擎进行目录匹配
2.3 利用列索引和查询引擎进行列数据匹配
Step3 提取记录信息,生成输出文件。

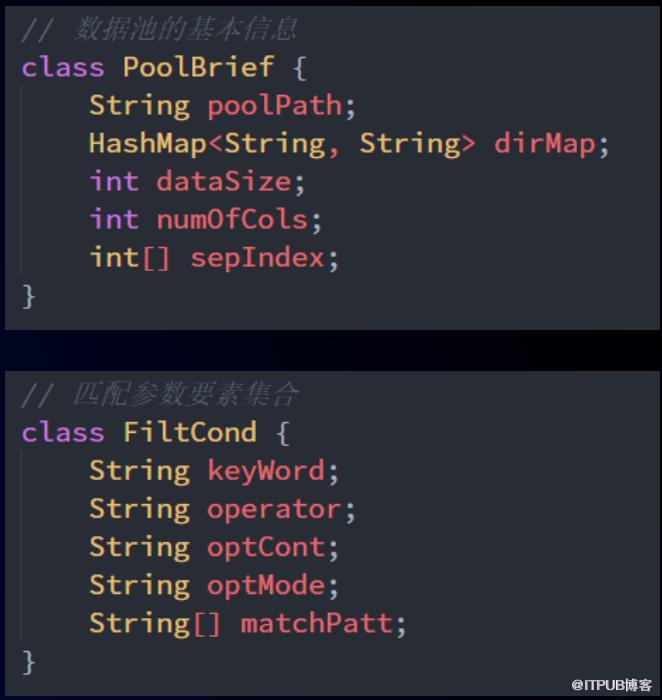
自定义兼容性数据类,结构化管理索引数据与查询参数信息,方便快速提取信息;
建立线程池,在建立列索引和查询列数据时,均以末端子目录为单元建立多线程任务,提交线程池进行自动调度
数据缓存复用,再不切换table时,可以反复使用所载入的数据缓存
内存动态管理,建立缓存容量阈值,如达到上限,则释放部分内存,载入所需数据

合理复用已经分配的内存空间,尽量避免过多的中间变量生成;
根据不同的应用场景和数据特点开发相应的算法,如模糊查询与精确查询存在很大的不同,正则表达式等方法用于模糊查询并不高效;
对于数据湖分析这样的大数据场景,任务调度、索引优化和查询算法都将对整体效率产生重大影响。
本方案在索引设计、内存管理、多线程调度等方面还有较大的提升空间

欢迎阅读,完整代码详见 https://github.com/wang-zhq/data-lake
欢迎扫码关注ChallengeHub学习交流群,欢迎关注ChallengeHub公众号!


原文作者:ChallengeHub;如有侵权,请联系管理员删除。

