Prometheus+Grafana+Alertmanager搭建全方位的监控告警系统-超详细文档
微信公众号搜索DevOps和k8s全栈技术,每天分享技术和生活点滴,共同成长,共同进步~
前两篇文章
k8s中部署prometheus监控告警系统-prometheus系列文章第一篇
k8s中部署Grafana-prometheus系列文章第二篇
前言
本篇文章介绍k8s集群中部署prometheus、grafana、alertmanager,并且配置prometheus的动态、静态服务发现,实现对容器、物理节点、service、pod等资源指标监控,并在Grafana的web界面展示prometheus的监控指标,然后通过配置自定义告警规则,通过alertmanager实现qq、钉钉、微信报警,文章内容较多,大概1.5万以上字数,可以先关注和转发,在慢慢学习。
prometheus简介
Prometheus是一个开源的系统监控和报警系统,现在已经加入到CNCF基金会,成为继k8s之后第二个在CNCF托管的项目,在kubernetes容器管理系统中,通常会搭配prometheus进行监控,同时也支持多种exporter采集数据,还支持pushgateway进行数据上报,Prometheus性能足够支撑上万台规模的集群。
prometheus特点
1.多维度数据模型
时间序列数据由metrics名称和键值对来组成可以对数据进行聚合,切割等操作所有的metrics都可以设置任意的多维标签。
2.灵活的查询语言(PromQL)
可以对采集的metrics指标进行加法,乘法,连接等操作;3.可以直接在本地部署,不依赖其他分布式存储;
4.通过基于HTTP的pull方式采集时序数据;
5.可以通过中间网关pushgateway的方式把时间序列数据推送到prometheus server端;
6.可通过服务发现或者静态配置来发现目标服务对象(targets)。
7.有多种可视化图像界面,如Grafana等。
8.高效的存储,每个采样数据占3.5 bytes左右,300万的时间序列,30s间隔,保留60天,消耗磁盘大概200G。
prometheus组件介绍
1.Prometheus Server: 用于收集和存储时间序列数据。
2.Client Library: 客户端库,检测应用程序代码,当Prometheus抓取实例的HTTP端点时,客户端库会将所有跟踪的metrics指标的当前状态发送到prometheus server端。
3.Exporters: prometheus支持多种exporter,通过exporter可以采集metrics数据,然后发送到prometheus server端
4.Alertmanager: 从 Prometheus server 端接收到 alerts 后,会进行去重,分组,并路由到相应的接收方,发出报警,常见的接收方式有:电子邮件,微信,钉钉, slack等。
5.Grafana:监控仪表盘
6.pushgateway: 各个目标主机可上报数据到pushgatewy,然后prometheus server统一从pushgateway拉取数据。
prometheus架构图
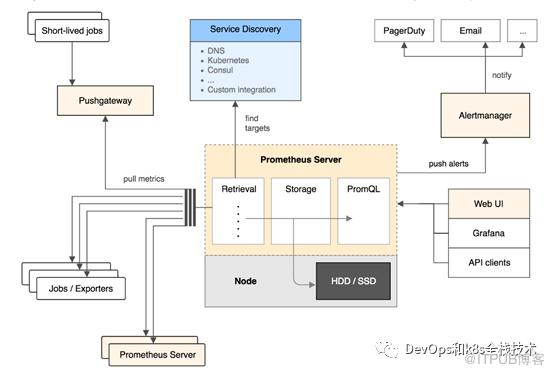
从上图可发现,Prometheus整个生态圈组成主要包括prometheus server,Exporter,pushgateway,alertmanager,grafana,Web ui界面,Prometheus server由三个部分组成,Retrieval,Storage,PromQL
Retrieval负责在活跃的target主机上抓取监控指标数据Storage存储主要是把采集到的数据存储到磁盘中PromQL是Prometheus提供的查询语言模块。prometheus工作流程:
1. Prometheus server可定期从活跃的(up)目标主机上(target)拉取监控指标数据,目标主机的监控数据可通过配置静态job或者服务发现的方式被prometheus server采集到,这种方式默认的pull方式拉取指标;也可通过pushgateway把采集的数据上报到prometheus server中;还可通过一些组件自带的exporter采集相应组件的数据;
2.Prometheus server把采集到的监控指标数据保存到本地磁盘或者数据库;
3.Prometheus采集的监控指标数据按时间序列存储,通过配置报警规则,把触发的报警发送到alertmanager
4.Alertmanager通过配置报警接收方,发送报警到邮件,微信或者钉钉等
5.Prometheus 自带的web ui界面提供PromQL查询语言,可查询监控数据
6.Grafana可接入prometheus数据源,把监控数据以图形化形式展示出
安装node-exporter组件
机器规划:
我的实验环境使用的k8s集群是一个master节点和一个node节点
master节点的机器ip是192.168.0.6,主机名是master1
node节点的机器ip是192.168.0.56,主机名是node1
master高可用集群安装可参考如下文章:
k8s1.18多master节点高可用集群安装-超详细中文官方文档
node-exporter是什么?
采集机器(物理机、虚拟机、云主机等)的监控指标数据,能够采集到的指标包括CPU, 内存,磁盘,网络,文件数等信息。
安装node-exporter组件,在k8s集群的master1节点操作
cat >node-export.yaml <<EOFapiVersion: apps/v1kind: DaemonSetmetadata:name: node-exporternamespace: monitor-salabels:name: node-exporterspec:selector:matchLabels:name: node-exportertemplate:metadata:labels:name: node-exporterspec:hostPID: truehostIPC: truehostNetwork: truecontainers:- name: node-exporterimage: prom/node-exporter:v0.16.0ports:- containerPort: 9100resources:requests:cpu: 0.15securityContext:privileged: trueargs:- --path.procfs- /host/proc- --path.sysfs- /host/sys- --collector.filesystem.ignored-mount-points- '"^/(sys|proc|dev|host|etc)($|/)"'volumeMounts:- name: devmountPath: /host/dev- name: procmountPath: /host/proc- name: sysmountPath: /host/sys- name: rootfsmountPath: /rootfstolerations:- key: "node-role.kubernetes.io/master"operator: "Exists"effect: "NoSchedule"volumes:- name: prochostPath:path: /proc- name: devhostPath:path: /dev- name: syshostPath:path: /sys- name: rootfshostPath:path: /EOF
#通过kubectl apply更新node-exporter
kubectl apply -f node-export.yaml
#查看node-exporter是否部署成功
kubectl get pods -n monitor-sa
显示如下,看到pod的状态都是running,说明部署成功
NAME READY STATUS RESTARTS AGEnode-exporter-9qpkd 1/1 Running 0 89snode-exporter-zqmnk 1/1 Running 0 89s
通过node-exporter采集数据
curl http://主机ip:9100/metrics
#node-export默认的监听端口是9100,可以看到当前主机获取到的所有监控数据,截取一部分,如下
# HELP node_cpu_seconds_total Seconds the cpus spent in each mode.# TYPE node_cpu_seconds_total counternode_cpu_seconds_total{cpu="0",mode="idle"} 56136.98# HELP node_load1 1m load average.# TYPE node_load1 gaugenode_load1 0.58#HELP:解释当前指标的含义,上面表示在每种模式下node节点的cpu花费的时间,以s为单位#TYPE:说明当前指标的数据类型,上面是counter类型node_load1该指标反映了当前主机在最近一分钟以内的负载情况,系统的负载情况会随系统资源的使用而变化,因此node_load1反映的是当前状态,数据可能增加也可能减少,从注释中可以看出当前指标类型为gauge(标准尺寸)node_cpu_seconds_total{cpu="0",mode="idle"} :cpu0上idle进程占用CPU的总时间,CPU占用时间是一个只增不减的度量指标,从类型中也可以看出node_cpu的数据类型是counter(计数器)counter计数器:只是采集递增的指标gauge标准尺寸:统计的指标可增加可减少
k8s集群中部署prometheus
1.创建namespace、sa账号,在k8s集群的master节点操作
#创建一个monitor-sa的名称空间
kubectl create ns monitor-sa
#创建一个sa账号
kubectl create serviceaccount monitor -n monitor-sa
#把sa账号monitor通过clusterrolebing绑定到clusterrole上
kubectl create clusterrolebinding monitor-clusterrolebinding -n monitor-sa --clusterrole=cluster-admin --serviceaccount=monitor-sa:monitor
2.创建数据目录
#在k8s集群的任何一个node节点操作,因为我的k8s集群只有一个node节点node1,所以我在node1上操作如下命令:
mkdir /data
chmod 777 /data/
3.安装prometheus,以下步骤均在在k8s集群的master1节点操作
1)创建一个configmap存储卷,用来存放prometheus配置信息
cat >prometheus-cfg.yaml <<EOF---kind: ConfigMapapiVersion: v1metadata:labels:app: prometheusname: prometheus-confignamespace: monitor-sadata:prometheus.yml: |global:scrape_interval: 15sscrape_timeout: 10sevaluation_interval: 1mscrape_configs:- job_name: 'kubernetes-node'kubernetes_sd_configs:- role: noderelabel_configs:- source_labels: [__address__]regex: '(.*):10250'replacement: '${1}:9100'target_label: __address__action: replace- action: labelmapregex: __meta_kubernetes_node_label_(.+)- job_name: 'kubernetes-node-cadvisor'kubernetes_sd_configs:- role: nodescheme: httpstls_config:ca_file: /var/run/secrets/kubernetes.io/serviceaccount/ca.crtbearer_token_file: /var/run/secrets/kubernetes.io/serviceaccount/tokenrelabel_configs:- action: labelmapregex: __meta_kubernetes_node_label_(.+)- target_label: __address__replacement: kubernetes.default.svc:443- source_labels: [__meta_kubernetes_node_name]regex: (.+)target_label: __metrics_path__replacement: /api/v1/nodes/${1}/proxy/metrics/cadvisor- job_name: 'kubernetes-apiserver'kubernetes_sd_configs:- role: endpointsscheme: httpstls_config:ca_file: /var/run/secrets/kubernetes.io/serviceaccount/ca.crtbearer_token_file: /var/run/secrets/kubernetes.io/serviceaccount/tokenrelabel_configs:- source_labels: [__meta_kubernetes_namespace, __meta_kubernetes_service_name, __meta_kubernetes_endpoint_port_name]action: keepregex: default;kubernetes;https- job_name: 'kubernetes-service-endpoints'kubernetes_sd_configs:- role: endpointsrelabel_configs:- source_labels: [__meta_kubernetes_service_annotation_prometheus_io_scrape]action: keepregex: true- source_labels: [__meta_kubernetes_service_annotation_prometheus_io_scheme]action: replacetarget_label: __scheme__regex: (https?)- source_labels: [__meta_kubernetes_service_annotation_prometheus_io_path]action: replacetarget_label: __metrics_path__regex: (.+)- source_labels: [__address__, __meta_kubernetes_service_annotation_prometheus_io_port]action: replacetarget_label: __address__regex: ([^:]+)(?::\d+)?;(\d+)replacement: $1:$2- action: labelmapregex: __meta_kubernetes_service_label_(.+)- source_labels: [__meta_kubernetes_namespace]action: replacetarget_label: kubernetes_namespace- source_labels: [__meta_kubernetes_service_name]action: replacetarget_label: kubernetes_nameEOF
注意:通过上面命令生成的promtheus-cfg.yaml文件会有一些问题,$1和$2这种变量在文件里没有,需要在k8s的master1节点打开promtheus-cfg.yaml文件,手动把$1和$2这种变量写进文件里,promtheus-cfg.yaml文件需要手动修改部分如下:
22行的replacement: ':9100'变成replacement: '${1}:9100'42行的replacement: /api/v1/nodes//proxy/metrics/cadvisor变成replacement: /api/v1/nodes/${1}/proxy/metrics/cadvisor73行的replacement: 变成replacement: $1:$2
#通过kubectl apply更新configmap
kubectl apply -f prometheus-cfg.yaml
2)通过deployment部署prometheus
cat >prometheus-deploy.yaml <<EOF---apiVersion: apps/v1kind: Deploymentmetadata:name: prometheus-servernamespace: monitor-salabels:app: prometheusspec:replicas: 1selector:matchLabels:app: prometheuscomponent: server#matchExpressions:#- {key: app, operator: In, values: [prometheus]}#- {key: component, operator: In, values: [server]}template:metadata:labels:app: prometheuscomponent: serverannotations:prometheus.io/scrape: 'false'spec:nodeName: node1serviceAccountName: monitorcontainers:- name: prometheusimage: prom/prometheus:v2.2.1imagePullPolicy: IfNotPresentcommand:- prometheus- --config.file=/etc/prometheus/prometheus.yml- --storage.tsdb.path=/prometheus- --storage.tsdb.retention=720hports:- containerPort: 9090protocol: TCPvolumeMounts:- mountPath: /etc/prometheus/prometheus.ymlname: prometheus-configsubPath: prometheus.yml- mountPath: /prometheus/name: prometheus-storage-volumevolumes:- name: prometheus-configconfigMap:name: prometheus-configitems:- key: prometheus.ymlpath: prometheus.ymlmode: 0644- name: prometheus-storage-volumehostPath:path: /datatype: DirectoryEOF
注意:在上面的prometheus-deploy.yaml文件有个nodeName字段,这个就是用来指定创建的这个prometheus的pod调度到哪个节点上,我们这里让nodeName=node1,也即是让pod调度到node1节点上,因为node1节点我们创建了数据目录/data,所以大家记住:你在k8s集群的哪个节点创建/data,就让pod调度到哪个节点。
#通过kubectl apply更新prometheus
kubectl apply -f prometheus-deploy.yaml
#查看prometheus是否部署成功
kubectl get pods -n monitor-sa
显示如下,可看到pod状态是running,说明prometheus部署成功
NAME READY STATUS RESTARTS AGEnode-exporter-9qpkd 1/1 Running 0 76mnode-exporter-zqmnk 1/1 Running 0 76mprometheus-server-85dbc6c7f7-nsg94 1/1 Running 0 6m7
3)给prometheus pod创建一个service
cat > prometheus-svc.yaml << EOF---apiVersion: v1kind: Servicemetadata:name: prometheusnamespace: monitor-salabels:app: prometheusspec:type: NodePortports:- port: 9090targetPort: 9090protocol: TCPselector:app: prometheuscomponent: serverEOF
#通过kubectl apply 更新service
kubectl apply -f prometheus-svc.yaml
#查看service在物理机映射的端口
kubectl get svc -n monitor-sa
显示如下:
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGEprometheus NodePort 10.96.45.93 <none> 9090:31043/TCP 50s
通过上面可以看到service在宿主机上映射的端口是31043,这样我们访问k8s集群的master1节点的ip:31043,就可以访问到prometheus的web ui界面了
#访问prometheus web ui界面
火狐浏览器输入如下地址:
http://192.168.0.6:31043/graph
可看到如下页面:
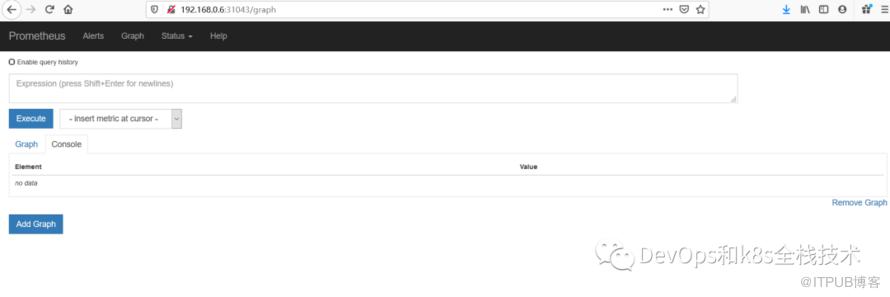
#点击页面的Status->Targets,可看到如下,说明我们配置的服务发现可以正常采集数据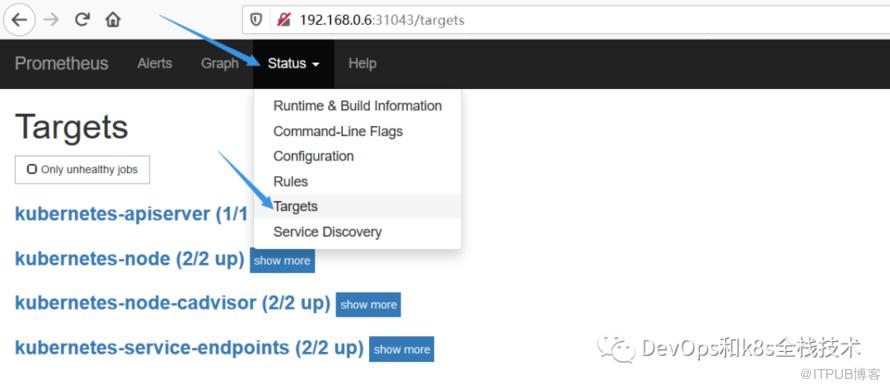
prometheus热更新
#为了每次修改配置文件可以热加载prometheus,也就是不停止prometheus,就可以使配置生效,如修改prometheus-cfg.yaml,想要使配置生效可用如下热加载命令:
curl -X POST http://10.244.1.66:9090/-/reload
#10.244.1.66是prometheus的pod的ip地址,如何查看prometheus的pod ip,可用如下命令:
kubectl get pods -n monitor-sa -o wide | grep prometheus
显示如下, 10.244.1.7就是prometheus的ip
prometheus-server-85dbc6c7f7-nsg94 1/1 Running 0 29m 10.244.1.7 node1 <none> <none>#热加载速度比较慢,可以暴力重启prometheus,如修改上面的prometheus-cfg.yaml文件之后,可执行如下强制删除:
kubectl delete -f prometheus-cfg.yaml
kubectl delete -f prometheus-deploy.yaml
然后再通过apply更新:
kubectl apply -f prometheus-cfg.yaml
kubectl apply -f prometheus-deploy.yaml
注意:
线上最好热加载,暴力删除可能造成监控数据的丢失
Grafana安装和配置
下载安装Grafana需要的镜像
上传heapster-grafana-amd64_v5_0_4.tar.gz镜像到k8s的各个master节点和k8s的各个node节点,然后在各个节点手动解压:
docker load -i heapster-grafana-amd64_v5_0_4.tar.gz
镜像所在的百度网盘地址如下:
链接:https://pan.baidu.com/s/1TmVGKxde_cEYrbjiETboEA提取码:052u
在k8s的master1节点创建grafana.yaml
cat >grafana.yaml << EOFapiVersion: apps/v1kind: Deploymentmetadata:name: monitoring-grafananamespace: kube-systemspec:replicas: 1selector:matchLabels:task: monitoringk8s-app: grafanatemplate:metadata:labels:task: monitoringk8s-app: grafanaspec:containers:- name: grafanaimage: k8s.gcr.io/heapster-grafana-amd64:v5.0.4ports:- containerPort: 3000protocol: TCPvolumeMounts:- mountPath: /etc/ssl/certsname: ca-certificatesreadOnly: true- mountPath: /varname: grafana-storageenv:- name: INFLUXDB_HOSTvalue: monitoring-influxdb- name: GF_SERVER_HTTP_PORTvalue: "3000"# The following env variables are required to make Grafana accessible via# the kubernetes api-server proxy. On production clusters, we recommend# removing these env variables, setup auth for grafana, and expose the grafana# service using a LoadBalancer or a public IP.- name: GF_AUTH_BASIC_ENABLEDvalue: "false"- name: GF_AUTH_ANONYMOUS_ENABLEDvalue: "true"- name: GF_AUTH_ANONYMOUS_ORG_ROLEvalue: Admin- name: GF_SERVER_ROOT_URL# If you're only using the API Server proxy, set this value instead:# value: /api/v1/namespaces/kube-system/services/monitoring-grafana/proxyvalue: /volumes:- name: ca-certificateshostPath:path: /etc/ssl/certs- name: grafana-storageemptyDir: {}---apiVersion: v1kind: Servicemetadata:labels:# For use as a Cluster add-on (https://github.com/kubernetes/kubernetes/tree/master/cluster/addons)# If you are NOT using this as an addon, you should comment out this line.kubernetes.io/cluster-service: 'true'kubernetes.io/name: monitoring-grafananame: monitoring-grafananamespace: kube-systemspec:# In a production setup, we recommend accessing Grafana through an external Loadbalancer# or through a public IP.# type: LoadBalancer# You could also use NodePort to expose the service at a randomly-generated port# type: NodePortports:- port: 80targetPort: 3000selector:k8s-app: grafanatype: NodePortEOF
通过kubectl apply 更新grafana
kubectl apply -f grafana.yaml
查看grafana是否部署成功
kubectl get pods -n kube-system
显示如下,说明部署成功
monitoring-grafana-7d7f6cf5c6-vrxw9 1/1 Running 0 3h51m查看grafana的service
kubectl get svc -n kube-system
显示如下:
monitoring-grafana NodePort 10.111.173.47 <none> 80:31044/TCP 3h54m上面可以看到grafana暴露的宿主机端口是31044
我们访问k8s集群的master节点ip:31044即可访问到grafana的web界面
Grafan界面接入prometheus数据源
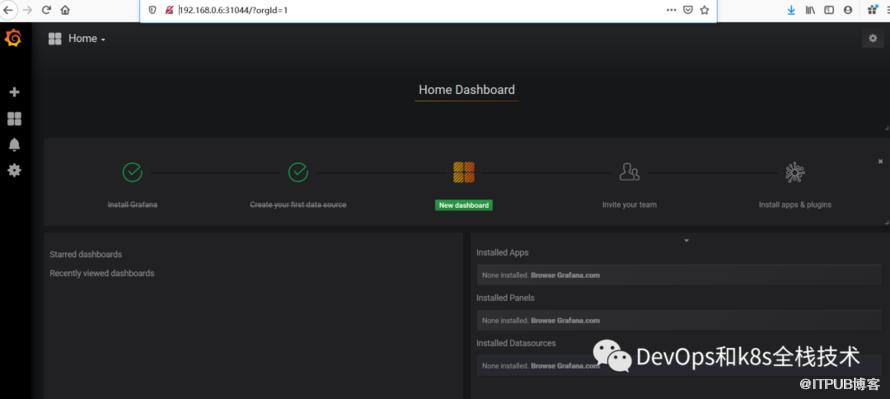
1)登陆grafana,在浏览器访问
192.168.0.6:31044
账号密码都是admin
可看到如下界面:
2)配置grafana界面:
开始配置grafana的web界面:
选择Create your first data source
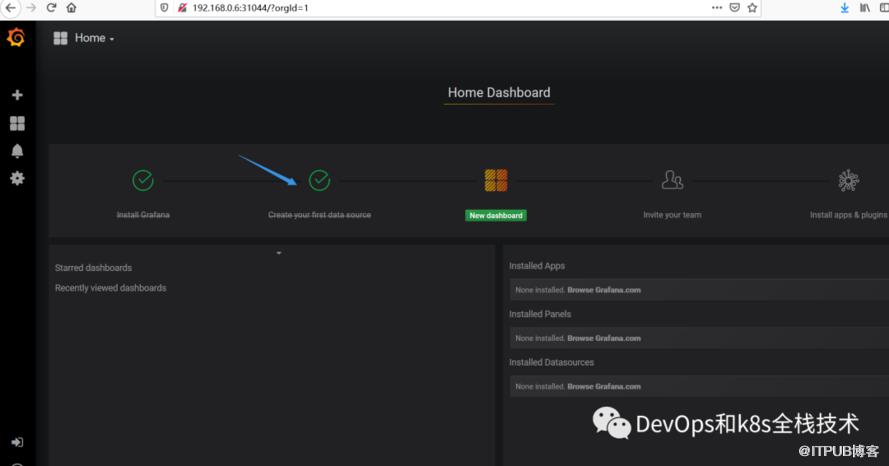
出现如下
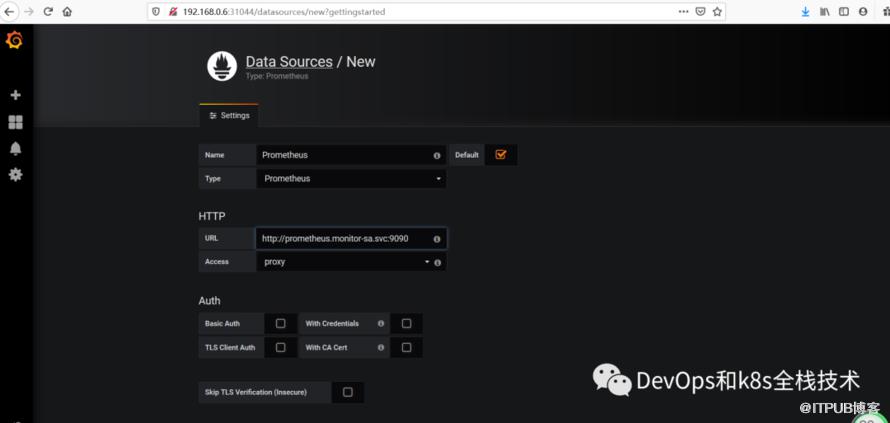
Name: Prometheus
Type: Prometheus
HTTP 处的URL写 如下:
http://prometheus.monitor-sa.svc:9090
配置好的整体页面如下:
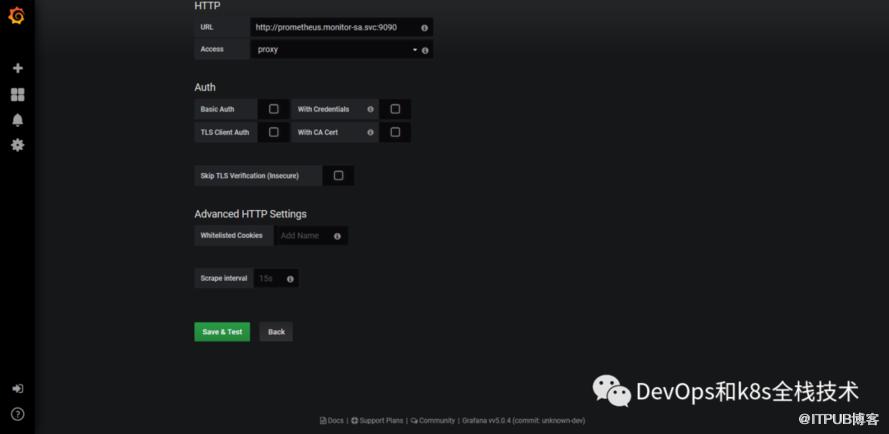
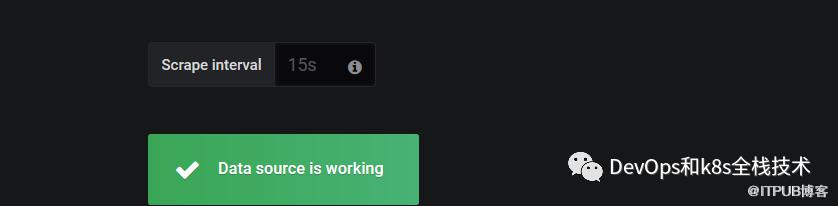
点击左下角Save & Test,出现如下Data source is working,说明prometheus数据源成功的被grafana接入了
导入监控模板,可在如下链接搜索
https://grafana.com/dashboards?dataSource=prometheus&search=kubernetes
也可直接导入node_exporter.json监控模板,这个可以把node节点指标显示出来
node_exporter.json在百度网盘地址如下:
链接:https://pan.baidu.com/s/1vF1kAMRbxQkUGPlZt91MWg提取码:kyd6
还可直接导入docker_rev1.json,可以把容器相关的数据展示出来
docker_rev1.json在百度网盘地址如下:
链接:https://pan.baidu.com/s/17o_nja5N2R-g9g5PkJ3aFA提取码:vinv
怎么导入监控模板,按如下步骤
上面Save & Test测试没问题之后,就可以返回Grafana主页面
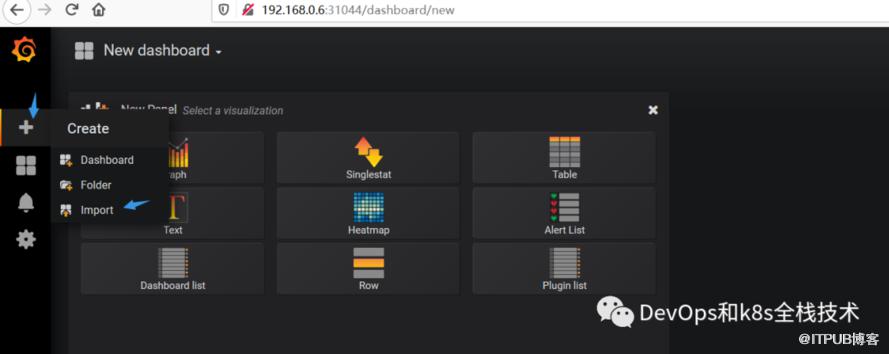
点击左侧+号下面的Import,出现如下界面
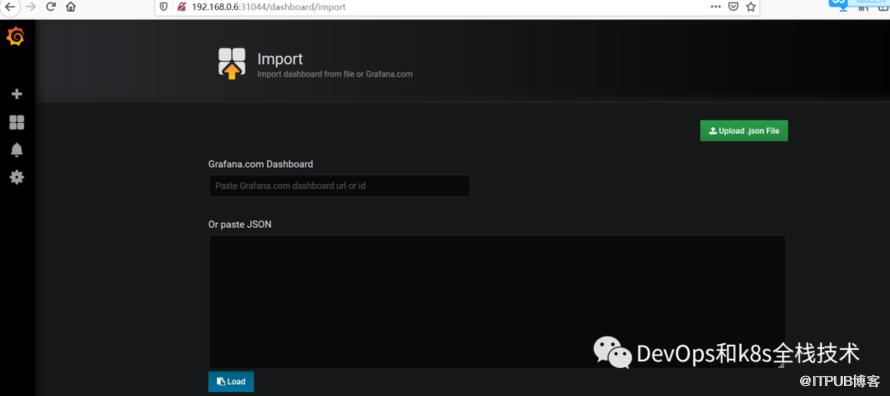
选择Upload json file,出现如下
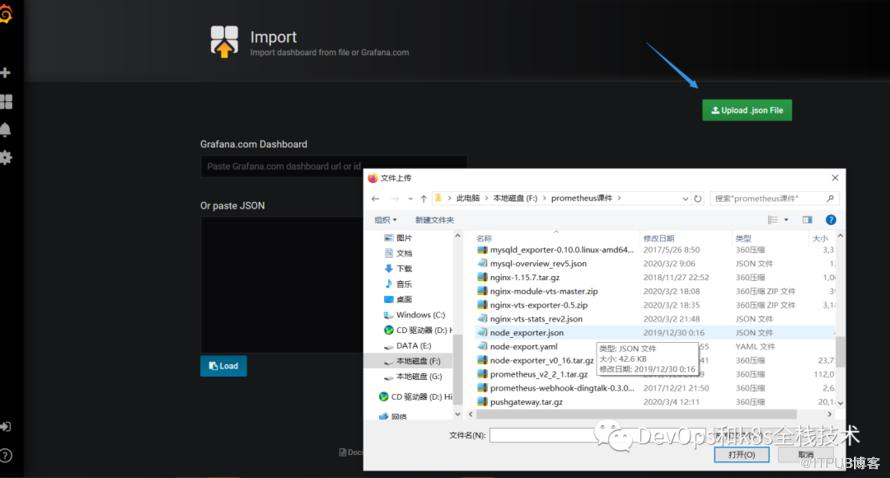
选择一个本地的json文件,我们选择的是上面让大家下载的node_exporter.json这个文件,选择之后出现如下
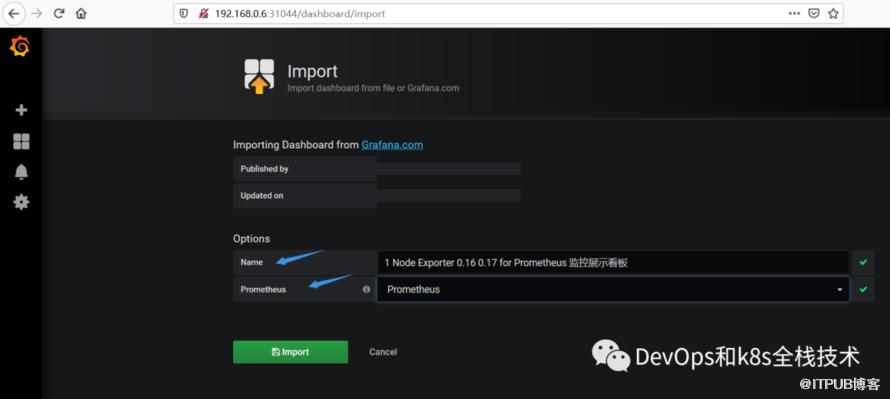
注:箭头标注的地方Name后面的名字是node_exporter.json定义的
Prometheus后面需要变成Prometheus,然后再点击Import,就可以出现如下界面:
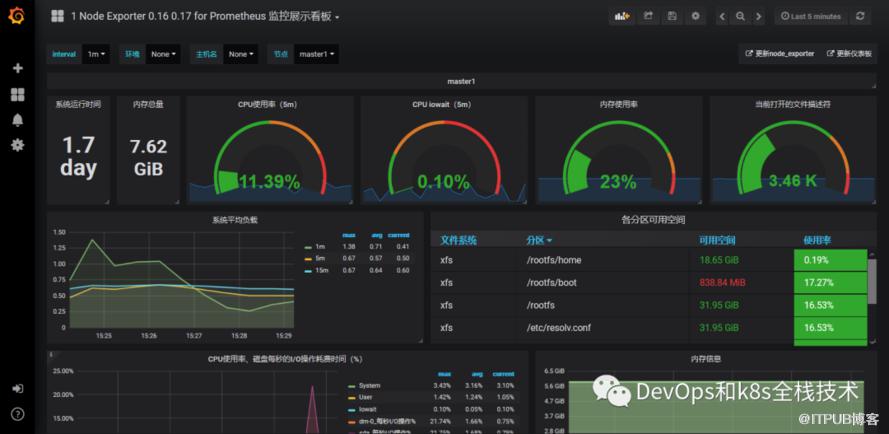
导入docker_rev1.json监控模板,步骤和上面导入node_exporter.json步骤一样,导入之后显示如下:
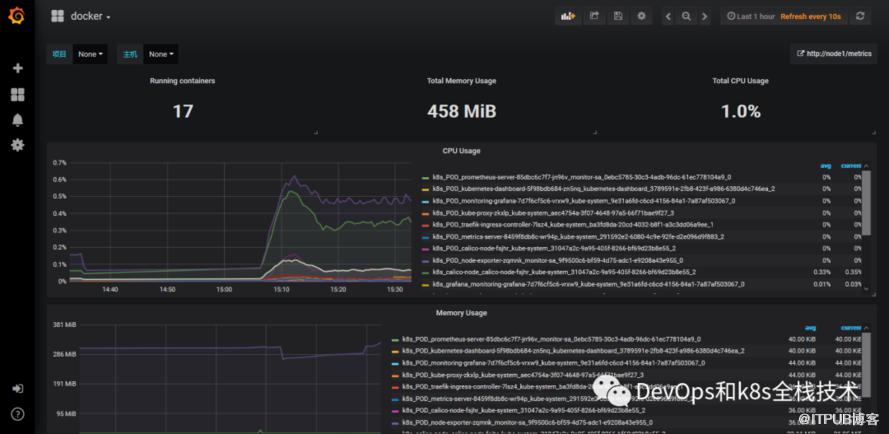
安装配置kube-state-metrics组件
kube-state-metrics是什么?
kube-state-metrics通过监听API Server生成有关资源对象的状态指标,比如Deployment、Node、Pod,需要注意的是kube-state-metrics只是简单的提供一个metrics数据,并不会存储这些指标数据,所以我们可以使用Prometheus来抓取这些数据然后存储,主要关注的是业务相关的一些元数据,比如Deployment、Pod、副本状态等;调度了多少个replicas?现在可用的有几个?多少个Pod是running/stopped/terminated状态?Pod重启了多少次?我有多少job在运行中。
安装kube-state-metrics组件
1)创建sa,并对sa授权
在k8s的master1节点生成一个kube-state-metrics-rbac.yaml文件
cat > kube-state-metrics-rbac.yaml <<EOF---apiVersion: v1kind: ServiceAccountmetadata:name: kube-state-metricsnamespace: kube-system---apiVersion: rbac.authorization.k8s.io/v1kind: ClusterRolemetadata:name: kube-state-metricsrules:- apiGroups: [""]resources: ["nodes", "pods", "services", "resourcequotas", "replicationcontrollers", "limitranges", "persistentvolumeclaims", "persistentvolumes", "namespaces", "endpoints"]verbs: ["list", "watch"]- apiGroups: ["extensions"]resources: ["daemonsets", "deployments", "replicasets"]verbs: ["list", "watch"]- apiGroups: ["apps"]resources: ["statefulsets"]verbs: ["list", "watch"]- apiGroups: ["batch"]resources: ["cronjobs", "jobs"]verbs: ["list", "watch"]- apiGroups: ["autoscaling"]resources: ["horizontalpodautoscalers"]verbs: ["list", "watch"]---apiVersion: rbac.authorization.k8s.io/v1kind: ClusterRoleBindingmetadata:name: kube-state-metricsroleRef:apiGroup: rbac.authorization.k8s.iokind: ClusterRolename: kube-state-metricssubjects:- kind: ServiceAccountname: kube-state-metricsnamespace: kube-systemEOF
通过kubectl apply更新yaml文件
kubectl apply -f kube-state-metrics-rbac.yaml
2)安装kube-state-metrics组件
在k8s的master1节点生成一个kube-state-metrics-deploy.yaml文件
cat > kube-state-metrics-deploy.yaml <<EOFapiVersion: apps/v1kind: Deploymentmetadata:name: kube-state-metricsnamespace: kube-systemspec:replicas: 1selector:matchLabels:app: kube-state-metricstemplate:metadata:labels:app: kube-state-metricsspec:serviceAccountName: kube-state-metricscontainers:name: kube-state-metrics# image: gcr.io/google_containers/kube-state-metrics-amd64:v1.3.1image: quay.io/coreos/kube-state-metrics:v1.9.0ports:containerPort: 8080EOF
通过kubectl apply更新yaml文件
kubectl apply -f kube-state-metrics-deploy.yaml
查看kube-state-metrics是否部署成功
kubectl get pods -n kube-system
显示如下,看到pod处于running状态,说明部署成功
kube-state-metrics-79c9686b96-4njrs 1/1 Running 0 76s3)创建service
在8s的master1节点生成一个kube-state-metrics-svc.yaml文件
cat >kube-state-metrics-svc.yaml <<EOFapiVersion: v1kind: Servicemetadata:annotations:: 'true'name: kube-state-metricsnamespace: kube-systemlabels:app: kube-state-metricsspec:ports:name: kube-state-metricsport: 8080protocol: TCPselector:: kube-state-metricsEOF
通过kubectl apply更新yaml
kubectl apply -f kube-state-metrics-svc.yaml
查看service是否创建成功
kubectl get svc -n kube-system | grep kube-state-metrics
显示如下,说明创建成功
kube-state-metrics ClusterIP 10.105.53.102 <none> 8080/TCP 2m38s在grafana web界面导入Kubernetes Cluster (Prometheus)-1577674936972.json,出现如下页面
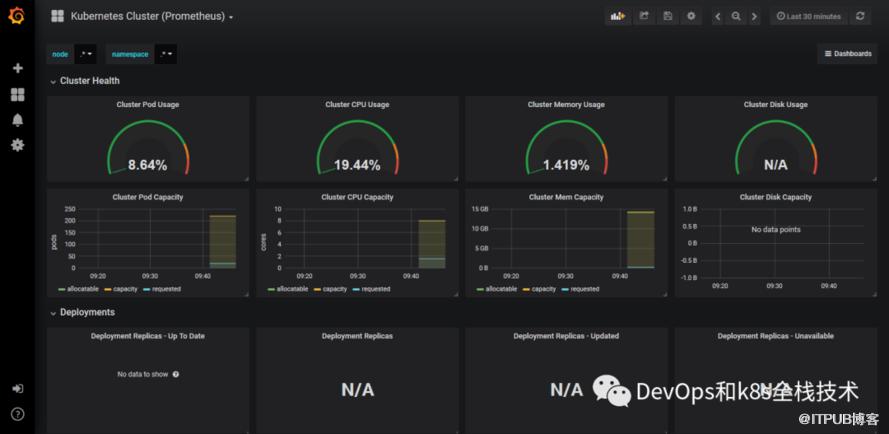
在grafana web界面导入Kubernetes cluster monitoring (via Prometheus) (k8s 1.16)-1577691996738.json,出现如下页面
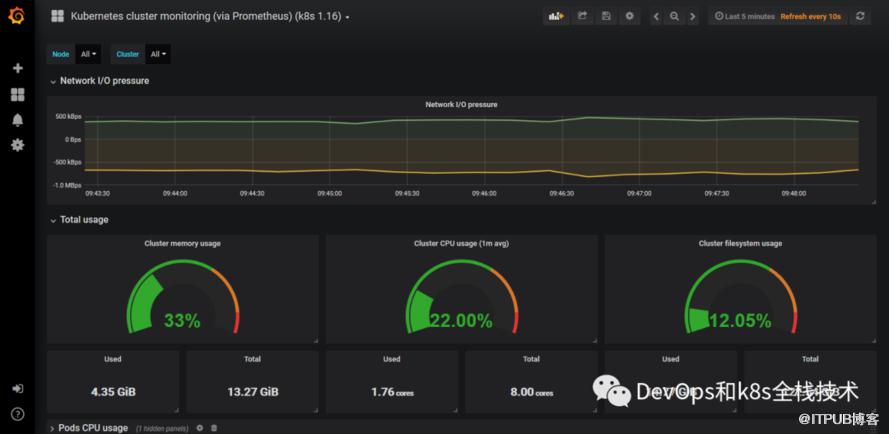
Kubernetes Cluster (Prometheus)-1577674936972.json和Kubernetes cluster monitoring (via Prometheus) (k8s 1.16)-1577691996738.json文件在百度网盘,地址如下:
链接:https://pan.baidu.com/s/1QAMqT8scsXx-lzEPI6MPgA提取码:i4yd
安装和配置Alertmanager-发送报警到qq邮箱
在k8s的master1节点创建alertmanager-cm.yaml文件
cat >alertmanager-cm.yaml <<EOFkind: ConfigMapapiVersion: v1metadata:name: alertmanagernamespace: monitor-sadata:: |-global:resolve_timeout: 1msmtp_smarthost: 'smtp.163.com:25'smtp_from: '15011572657@163.com'smtp_auth_username: '15011572657'smtp_auth_password: 'BDBPRMLNZGKWRFJP'smtp_require_tls: falseroute:group_by: [alertname]group_wait: 10sgroup_interval: 10srepeat_interval: 10mreceiver: default-receiverreceivers:name: 'default-receiver'email_configs:to: '1980570647@qq.com': trueEOF
通过kubectl apply 更新文件
kubectl apply -f alertmanager-cm.yaml
alertmanager配置文件解释说明:
smtp_smarthost: 'smtp.163.com:25'#用于发送邮件的邮箱的SMTP服务器地址+端口smtp_from: '15011572657@163.com'#这是指定从哪个邮箱发送报警smtp_auth_username: '15011572657'#这是发送邮箱的认证用户,不是邮箱名smtp_auth_password: 'BDBPRMLNZGKWRFJP'#这是发送邮箱的授权码而不是登录密码email_configs:- to: '1980570647@qq.com'#to后面指定发送到哪个邮箱,我发送到我的qq邮箱,大家需要写自己的邮箱地址,不应该跟smtp_from的邮箱名字重复
在k8s的master1节点重新生成一个prometheus-cfg.yaml文件
cat prometheus-cfg.yaml
kind: ConfigMapapiVersion: v1metadata:labels:app: prometheusname: prometheus-confignamespace: monitor-sadata:: |rule_files:/etc/prometheus/rules.ymlalerting:alertmanagers:static_configs:targets: ["localhost:9093"]global:scrape_interval: 15sscrape_timeout: 10sevaluation_interval: 1mscrape_configs:job_name: 'kubernetes-node'kubernetes_sd_configs:role: noderelabel_configs:source_labels: [__address__]regex: '(.*):10250'replacement: '${1}:9100'target_label: __address__action: replaceaction: labelmapregex: __meta_kubernetes_node_label_(.+)job_name: 'kubernetes-node-cadvisor'kubernetes_sd_configs:role: nodescheme: httpstls_config:ca_file: /var/run/secrets/kubernetes.io/serviceaccount/ca.crtbearer_token_file: /var/run/secrets/kubernetes.io/serviceaccount/tokenrelabel_configs:action: labelmapregex: __meta_kubernetes_node_label_(.+)target_label: __address__replacement: kubernetes.default.svc:443source_labels: [__meta_kubernetes_node_name]regex: (.+)target_label: __metrics_path__replacement: /api/v1/nodes/${1}/proxy/metrics/cadvisorjob_name: 'kubernetes-apiserver'kubernetes_sd_configs:role: endpointsscheme: httpstls_config:ca_file: /var/run/secrets/kubernetes.io/serviceaccount/ca.crtbearer_token_file: /var/run/secrets/kubernetes.io/serviceaccount/tokenrelabel_configs:source_labels: [__meta_kubernetes_namespace, __meta_kubernetes_service_name, __meta_kubernetes_endpoint_port_name]action: keepregex: default;kubernetes;httpsjob_name: 'kubernetes-service-endpoints'kubernetes_sd_configs:role: endpointsrelabel_configs:source_labels: [__meta_kubernetes_service_annotation_prometheus_io_scrape]action: keepregex: truesource_labels: [__meta_kubernetes_service_annotation_prometheus_io_scheme]action: replacetarget_label: __scheme__regex: (https?)source_labels: [__meta_kubernetes_service_annotation_prometheus_io_path]action: replacetarget_label: __metrics_path__regex: (.+)source_labels: [__address__, __meta_kubernetes_service_annotation_prometheus_io_port]action: replacetarget_label: __address__regex: ([^:]+)(?::\d+)?;(\d+)replacement: $1:$2action: labelmapregex: __meta_kubernetes_service_label_(.+)source_labels: [__meta_kubernetes_namespace]action: replacetarget_label: kubernetes_namespacesource_labels: [__meta_kubernetes_service_name]action: replacetarget_label: kubernetes_namejob_name: kubernetes-podskubernetes_sd_configs:role: podrelabel_configs:action: keepregex: truesource_labels:__meta_kubernetes_pod_annotation_prometheus_io_scrapeaction: replaceregex: (.+)source_labels:__meta_kubernetes_pod_annotation_prometheus_io_pathtarget_label: __metrics_path__action: replaceregex: ([^:]+)(?::\d+)?;(\d+)replacement: $1:$2source_labels:__address____meta_kubernetes_pod_annotation_prometheus_io_porttarget_label: __address__action: labelmapregex: __meta_kubernetes_pod_label_(.+)action: replacesource_labels:__meta_kubernetes_namespacetarget_label: kubernetes_namespaceaction: replacesource_labels:__meta_kubernetes_pod_nametarget_label: kubernetes_pod_namejob_name: 'kubernetes-schedule'scrape_interval: 5sstatic_configs:: ['192.168.0.6:10251']job_name: 'kubernetes-controller-manager'scrape_interval: 5sstatic_configs:: ['192.168.0.6:10252']job_name: 'kubernetes-kube-proxy'scrape_interval: 5sstatic_configs:: ['192.168.0.6:10249','192.168.0.56:10249']job_name: 'kubernetes-etcd'scheme: httpstls_config:ca_file: /var/run/secrets/kubernetes.io/k8s-certs/etcd/ca.crtcert_file: /var/run/secrets/kubernetes.io/k8s-certs/etcd/server.crtkey_file: /var/run/secrets/kubernetes.io/k8s-certs/etcd/server.keyscrape_interval: 5sstatic_configs:: ['192.168.0.6:2379']: |groups:name: examplerules:alert: kube-proxy的cpu使用率大于80%expr: rate(process_cpu_seconds_total{job=~"kubernetes-kube-proxy"}[1m]) * 100 > 80for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.job}}组件的cpu使用率超过80%"alert: kube-proxy的cpu使用率大于90%expr: rate(process_cpu_seconds_total{job=~"kubernetes-kube-proxy"}[1m]) * 100 > 90for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.job}}组件的cpu使用率超过90%"alert: scheduler的cpu使用率大于80%expr: rate(process_cpu_seconds_total{job=~"kubernetes-schedule"}[1m]) * 100 > 80for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.job}}组件的cpu使用率超过80%"alert: scheduler的cpu使用率大于90%expr: rate(process_cpu_seconds_total{job=~"kubernetes-schedule"}[1m]) * 100 > 90for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.job}}组件的cpu使用率超过90%"alert: controller-manager的cpu使用率大于80%expr: rate(process_cpu_seconds_total{job=~"kubernetes-controller-manager"}[1m]) * 100 > 80for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.job}}组件的cpu使用率超过80%"alert: controller-manager的cpu使用率大于90%expr: rate(process_cpu_seconds_total{job=~"kubernetes-controller-manager"}[1m]) * 100 > 0for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.job}}组件的cpu使用率超过90%"alert: apiserver的cpu使用率大于80%expr: rate(process_cpu_seconds_total{job=~"kubernetes-apiserver"}[1m]) * 100 > 80for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.job}}组件的cpu使用率超过80%"alert: apiserver的cpu使用率大于90%expr: rate(process_cpu_seconds_total{job=~"kubernetes-apiserver"}[1m]) * 100 > 90for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.job}}组件的cpu使用率超过90%"alert: etcd的cpu使用率大于80%expr: rate(process_cpu_seconds_total{job=~"kubernetes-etcd"}[1m]) * 100 > 80for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.job}}组件的cpu使用率超过80%"alert: etcd的cpu使用率大于90%expr: rate(process_cpu_seconds_total{job=~"kubernetes-etcd"}[1m]) * 100 > 90for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.job}}组件的cpu使用率超过90%"alert: kube-state-metrics的cpu使用率大于80%expr: rate(process_cpu_seconds_total{k8s_app=~"kube-state-metrics"}[1m]) * 100 > 80for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.k8s_app}}组件的cpu使用率超过80%"value: "{{ $value }}%"threshold: "80%"alert: kube-state-metrics的cpu使用率大于90%expr: rate(process_cpu_seconds_total{k8s_app=~"kube-state-metrics"}[1m]) * 100 > 0for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.k8s_app}}组件的cpu使用率超过90%"value: "{{ $value }}%"threshold: "90%"alert: coredns的cpu使用率大于80%expr: rate(process_cpu_seconds_total{k8s_app=~"kube-dns"}[1m]) * 100 > 80for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.k8s_app}}组件的cpu使用率超过80%"value: "{{ $value }}%"threshold: "80%"alert: coredns的cpu使用率大于90%expr: rate(process_cpu_seconds_total{k8s_app=~"kube-dns"}[1m]) * 100 > 90for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.k8s_app}}组件的cpu使用率超过90%"value: "{{ $value }}%"threshold: "90%"alert: kube-proxy打开句柄数>600expr: process_open_fds{job=~"kubernetes-kube-proxy"} > 600for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.job}}打开句柄数>600"value: "{{ $value }}"alert: kube-proxy打开句柄数>1000expr: process_open_fds{job=~"kubernetes-kube-proxy"} > 1000for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.job}}打开句柄数>1000"value: "{{ $value }}"alert: kubernetes-schedule打开句柄数>600expr: process_open_fds{job=~"kubernetes-schedule"} > 600for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.job}}打开句柄数>600"value: "{{ $value }}"alert: kubernetes-schedule打开句柄数>1000expr: process_open_fds{job=~"kubernetes-schedule"} > 1000for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.job}}打开句柄数>1000"value: "{{ $value }}"alert: kubernetes-controller-manager打开句柄数>600expr: process_open_fds{job=~"kubernetes-controller-manager"} > 600for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.job}}打开句柄数>600"value: "{{ $value }}"alert: kubernetes-controller-manager打开句柄数>1000expr: process_open_fds{job=~"kubernetes-controller-manager"} > 1000for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.job}}打开句柄数>1000"value: "{{ $value }}"alert: kubernetes-apiserver打开句柄数>600expr: process_open_fds{job=~"kubernetes-apiserver"} > 600for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.job}}打开句柄数>600"value: "{{ $value }}"alert: kubernetes-apiserver打开句柄数>1000expr: process_open_fds{job=~"kubernetes-apiserver"} > 1000for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.job}}打开句柄数>1000"value: "{{ $value }}"alert: kubernetes-etcd打开句柄数>600expr: process_open_fds{job=~"kubernetes-etcd"} > 600for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.job}}打开句柄数>600"value: "{{ $value }}"alert: kubernetes-etcd打开句柄数>1000expr: process_open_fds{job=~"kubernetes-etcd"} > 1000for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.job}}打开句柄数>1000"value: "{{ $value }}"alert: corednsexpr: process_open_fds{k8s_app=~"kube-dns"} > 600for: 2slabels:severity: warnningannotations:description: "插件{{$labels.k8s_app}}({{$labels.instance}}): 打开句柄数超过600"value: "{{ $value }}"alert: corednsexpr: process_open_fds{k8s_app=~"kube-dns"} > 1000for: 2slabels:severity: criticalannotations:description: "插件{{$labels.k8s_app}}({{$labels.instance}}): 打开句柄数超过1000"value: "{{ $value }}"alert: kube-proxyexpr: process_virtual_memory_bytes{job=~"kubernetes-kube-proxy"} > 2000000000for: 2slabels:severity: warnningannotations:description: "组件{{$labels.job}}({{$labels.instance}}): 使用虚拟内存超过2G"value: "{{ $value }}"alert: schedulerexpr: process_virtual_memory_bytes{job=~"kubernetes-schedule"} > 2000000000for: 2slabels:severity: warnningannotations:description: "组件{{$labels.job}}({{$labels.instance}}): 使用虚拟内存超过2G"value: "{{ $value }}"alert: kubernetes-controller-managerexpr: process_virtual_memory_bytes{job=~"kubernetes-controller-manager"} > 2000000000for: 2slabels:severity: warnningannotations:description: "组件{{$labels.job}}({{$labels.instance}}): 使用虚拟内存超过2G"value: "{{ $value }}"alert: kubernetes-apiserverexpr: process_virtual_memory_bytes{job=~"kubernetes-apiserver"} > 2000000000for: 2slabels:severity: warnningannotations:description: "组件{{$labels.job}}({{$labels.instance}}): 使用虚拟内存超过2G"value: "{{ $value }}"alert: kubernetes-etcdexpr: process_virtual_memory_bytes{job=~"kubernetes-etcd"} > 2000000000for: 2slabels:severity: warnningannotations:description: "组件{{$labels.job}}({{$labels.instance}}): 使用虚拟内存超过2G"value: "{{ $value }}"alert: kube-dnsexpr: process_virtual_memory_bytes{k8s_app=~"kube-dns"} > 2000000000for: 2slabels:severity: warnningannotations:description: "插件{{$labels.k8s_app}}({{$labels.instance}}): 使用虚拟内存超过2G"value: "{{ $value }}"alert: HttpRequestsAvgexpr: sum(rate(rest_client_requests_total{job=~"kubernetes-kube-proxy|kubernetes-kubelet|kubernetes-schedule|kubernetes-control-manager|kubernetes-apiservers"}[1m])) > 1000for: 2slabels:team: adminannotations:description: "组件{{$labels.job}}({{$labels.instance}}): TPS超过1000"value: "{{ $value }}"threshold: "1000"alert: Pod_restartsexpr: kube_pod_container_status_restarts_total{namespace=~"kube-system|default|monitor-sa"} > 0for: 2slabels:severity: warnningannotations:description: "在{{$labels.namespace}}名称空间下发现{{$labels.pod}}这个pod下的容器{{$labels.container}}被重启,这个监控指标是由{{$labels.instance}}采集的"value: "{{ $value }}"threshold: "0"alert: Pod_waitingexpr: kube_pod_container_status_waiting_reason{namespace=~"kube-system|default"} == 1for: 2slabels:team: adminannotations:description: "空间{{$labels.namespace}}({{$labels.instance}}): 发现{{$labels.pod}}下的{{$labels.container}}启动异常等待中"value: "{{ $value }}"threshold: "1"alert: Pod_terminatedexpr: kube_pod_container_status_terminated_reason{namespace=~"kube-system|default|monitor-sa"} == 1for: 2slabels:team: adminannotations:description: "空间{{$labels.namespace}}({{$labels.instance}}): 发现{{$labels.pod}}下的{{$labels.container}}被删除"value: "{{ $value }}"threshold: "1"alert: Etcd_leaderexpr: etcd_server_has_leader{job="kubernetes-etcd"} == 0for: 2slabels:team: adminannotations:description: "组件{{$labels.job}}({{$labels.instance}}): 当前没有leader"value: "{{ $value }}"threshold: "0"alert: Etcd_leader_changesexpr: rate(etcd_server_leader_changes_seen_total{job="kubernetes-etcd"}[1m]) > 0for: 2slabels:team: adminannotations:description: "组件{{$labels.job}}({{$labels.instance}}): 当前leader已发生改变"value: "{{ $value }}"threshold: "0"alert: Etcd_failedexpr: rate(etcd_server_proposals_failed_total{job="kubernetes-etcd"}[1m]) > 0for: 2slabels:team: adminannotations:description: "组件{{$labels.job}}({{$labels.instance}}): 服务失败"value: "{{ $value }}"threshold: "0"alert: Etcd_db_total_sizeexpr: etcd_debugging_mvcc_db_total_size_in_bytes{job="kubernetes-etcd"} > 10000000000for: 2slabels:team: adminannotations:description: "组件{{$labels.job}}({{$labels.instance}}):db空间超过10G"value: "{{ $value }}"threshold: "10G"alert: Endpoint_readyexpr: kube_endpoint_address_not_ready{namespace=~"kube-system|default"} == 1for: 2slabels:team: adminannotations:description: "空间{{$labels.namespace}}({{$labels.instance}}): 发现{{$labels.endpoint}}不可用"value: "{{ $value }}"threshold: "1"name: 物理节点状态-监控告警rules:alert: 物理节点cpu使用率expr: 100-avg(irate(node_cpu_seconds_total{mode="idle"}[5m])) by(instance)*100 > 90for: 2slabels:severity: ccriticalannotations:summary: "{{ $labels.instance }}cpu使用率过高"description: "{{ $labels.instance }}的cpu使用率超过90%,当前使用率[{{ $value }}],需要排查处理"alert: 物理节点内存使用率expr: (node_memory_MemTotal_bytes - (node_memory_MemFree_bytes + node_memory_Buffers_bytes + node_memory_Cached_bytes)) / node_memory_MemTotal_bytes * 100 > 90for: 2slabels:severity: criticalannotations:summary: "{{ $labels.instance }}内存使用率过高"description: "{{ $labels.instance }}的内存使用率超过90%,当前使用率[{{ $value }}],需要排查处理"alert: InstanceDownexpr: up == 0for: 2slabels:severity: criticalannotations:summary: "{{ $labels.instance }}: 服务器宕机"description: "{{ $labels.instance }}: 服务器延时超过2分钟"alert: 物理节点磁盘的IO性能expr: 100-(avg(irate(node_disk_io_time_seconds_total[1m])) by(instance)* 100) < 60for: 2slabels:severity: criticalannotations:summary: "{{$labels.mountpoint}} 流入磁盘IO使用率过高!"description: "{{$labels.mountpoint }} 流入磁盘IO大于60%(目前使用:{{$value}})"alert: 入网流量带宽expr: ((sum(rate (node_network_receive_bytes_total{device!~'tap.*|veth.*|br.*|docker.*|virbr*|lo*'}[5m])) by (instance)) / 100) > 102400for: 2slabels:severity: criticalannotations:summary: "{{$labels.mountpoint}} 流入网络带宽过高!"description: "{{$labels.mountpoint }}流入网络带宽持续5分钟高于100M. RX带宽使用率{{$value}}"alert: 出网流量带宽expr: ((sum(rate (node_network_transmit_bytes_total{device!~'tap.*|veth.*|br.*|docker.*|virbr*|lo*'}[5m])) by (instance)) / 100) > 102400for: 2slabels:severity: criticalannotations:summary: "{{$labels.mountpoint}} 流出网络带宽过高!"description: "{{$labels.mountpoint }}流出网络带宽持续5分钟高于100M. RX带宽使用率{{$value}}"alert: TCP会话expr: node_netstat_Tcp_CurrEstab > 1000for: 2slabels:severity: criticalannotations:summary: "{{$labels.mountpoint}} TCP_ESTABLISHED过高!"description: "{{$labels.mountpoint }} TCP_ESTABLISHED大于1000%(目前使用:{{$value}}%)"alert: 磁盘容量expr: 100-(node_filesystem_free_bytes{fstype=~"ext4|xfs"}/node_filesystem_size_bytes {fstype=~"ext4|xfs"}*100) > 80for: 2slabels:severity: criticalannotations:summary: "{{$labels.mountpoint}} 磁盘分区使用率过高!": "{{$labels.mountpoint }} 磁盘分区使用大于80%(目前使用:{{$value}}%)"
注意:通过上面命令生成的promtheus-cfg.yaml文件会有一些问题,$1和$2这种变量在文件里没有,需要在k8s的master1节点打开promtheus-cfg.yaml文件,手动把$1和$2这种变量写进文件里,promtheus-cfg.yaml文件需要手动修改部分如下:
22行的replacement: ':9100'变成replacement: '${1}:9100'42行的replacement: /api/v1/nodes//proxy/metrics/cadvisor变成replacement: /api/v1/nodes/${1}/proxy/metrics/cadvisor73行的replacement: 变成replacement: $1:$2103行的replacement: 变成replacement: $1:$2
通过kubectl apply 更新文件
kubectl apply -f prometheus-cfg.yaml
在k8s的master1节点重新生成一个prometheus-deploy.yaml文件
cat >prometheus-deploy.yaml <<EOF---apiVersion: apps/v1kind: Deploymentmetadata:name: prometheus-servernamespace: monitor-salabels:app: prometheusspec:replicas: 1selector:matchLabels:app: prometheuscomponent: server#matchExpressions:#- {key: app, operator: In, values: [prometheus]}#- {key: component, operator: In, values: [server]}template:metadata:labels:app: prometheuscomponent: serverannotations:: 'false'spec:nodeName: node1serviceAccountName: monitorcontainers:name: prometheusimage: prom/prometheus:v2.2.1imagePullPolicy: IfNotPresentcommand:"/bin/prometheus"args:"--config.file=/etc/prometheus/prometheus.yml""--storage.tsdb.path=/prometheus""--storage.tsdb.retention=24h""--web.enable-lifecycle"ports:containerPort: 9090protocol: TCPvolumeMounts:mountPath: /etc/prometheusname: prometheus-configmountPath: /prometheus/name: prometheus-storage-volumename: k8s-certsmountPath: /var/run/secrets/kubernetes.io/k8s-certs/etcd/name: alertmanagerimage: prom/alertmanager:v0.14.0imagePullPolicy: IfNotPresentargs:"--config.file=/etc/alertmanager/alertmanager.yml""--log.level=debug"ports:containerPort: 9093protocol: TCPname: alertmanagervolumeMounts:name: alertmanager-configmountPath: /etc/alertmanagername: alertmanager-storagemountPath: /alertmanagername: localtimemountPath: /etc/localtimevolumes:name: prometheus-configconfigMap:name: prometheus-configname: prometheus-storage-volumehostPath:path: /datatype: Directoryname: k8s-certssecret:secretName: etcd-certsname: alertmanager-configconfigMap:name: alertmanagername: alertmanager-storagehostPath:path: /data/alertmanagertype: DirectoryOrCreatename: localtimehostPath:: /usr/share/zoneinfo/Asia/ShanghaiEOF
生成一个etcd-certs,这个在部署prometheus需要
kubectl -n monitor-sa create secret generic etcd-certs --from-file=/etc/kubernetes/pki/etcd/server.key --from-file=/etc/kubernetes/pki/etcd/server.crt --from-file=/etc/kubernetes/pki/etcd/ca.crt
通过kubectl apply更新yaml文件
kubectl apply -f prometheus-deploy.yaml
#查看prometheus是否部署成功
kubectl get pods -n monitor-sa | grep prometheus
显示如下,可看到pod状态是running,说明prometheus部署成功
NAME READY STATUS RESTARTS AGEprometheus-server-85dbc6c7f7-nsg94 1/1 Running 0 6m7
在k8s的master1节点重新生成一个alertmanager-svc.yaml文件
cat >alertmanager-svc.yaml <<EOF---apiVersion: v1kind: Servicemetadata:labels:name: prometheus: 'true'name: alertmanagernamespace: monitor-saspec:ports:name: alertmanagernodePort: 30066port: 9093protocol: TCPtargetPort: 9093selector:app: prometheussessionAffinity: None: NodePortEOF
通过kubectl apply更新yaml文件
kubectl apply -f prometheus-svc.yaml
#查看service在物理机映射的端口
kubectl get svc -n monitor-sa
显示如下:
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGEalertmanager NodePort 10.111.49.65 <none> 9093:31043/TCP 25sprometheus NodePort 10.96.45.93 <none> 9090:30090/TCP 34h
注意:上面可以看到prometheus的service暴漏的端口是31043,alertmanager的service暴露的端口是30066
访问prometheus的web界面
点击status->targets,可看到如下
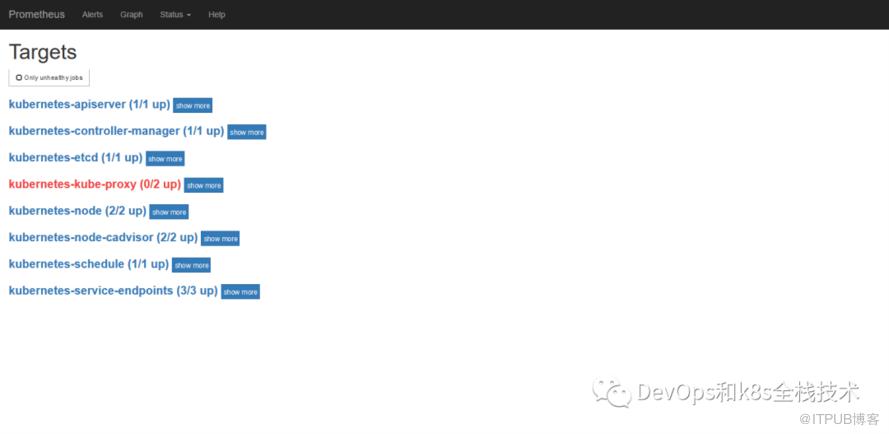
点击Alerts,可看到如下
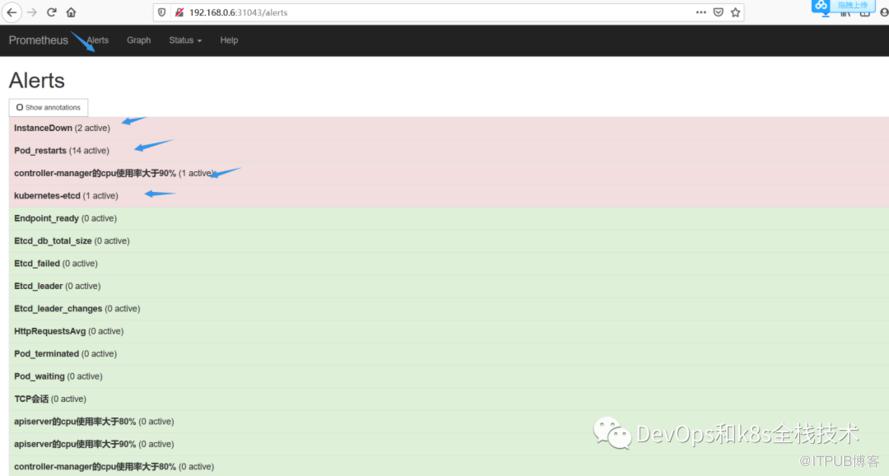
把controller-manager的cpu使用率大于90%展开,可看到如下
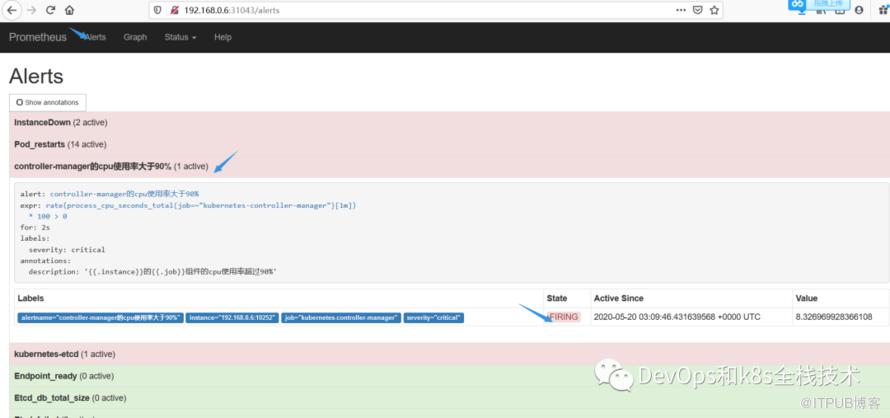
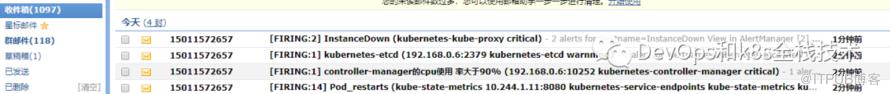
FIRING表示prometheus已经将告警发给alertmanager,在Alertmanager 中可以看到有一个 alert。
登录到alertmanager web界面
浏览器输入192.168.0.6:30066,显示如下
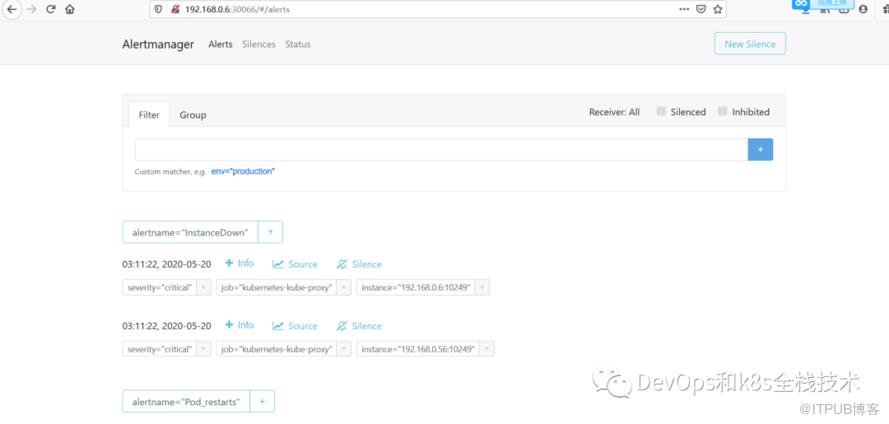
这样我在我的qq邮箱,1980570647@qq.com就可以收到报警了,如下
配置Alertmanager报警-发送报警到钉钉
打开电脑版钉钉创建机器人
1.创建钉钉机器人
打开电脑版钉钉,创建一个群,创建自定义机器人,按如下步骤创建https://ding-doc.dingtalk.com/doc#/serverapi2/qf2nxq我创建的机器人如下:群设置-->智能群助手-->添加机器人-->自定义-->添加机器人名称:kube-event接收群组:钉钉报警测试安全设置:自定义关键词:cluster1上面配置好之后点击完成即可,这样就会创建一个kube-event的报警机器人,创建机器人成功之后怎么查看webhook,按如下:点击智能群助手,可以看到刚才创建的kube-event这个机器人,点击kube-event,就会进入到kube-event机器人的设置界面出现如下内容:机器人名称:kube-event接受群组:钉钉报警测试消息推送:开启webhook:https://oapi.dingtalk.com/robot/send?access_token=9c03ff1f47b1d15a10d852398cafb84f8e81ceeb1ba557eddd8a79e5a5e5548e安全设置:自定义关键词:cluster1
2.安装钉钉的webhook插件,在k8s的master1节点操作
tar zxvf prometheus-webhook-dingtalk-0.3.0.linux-amd64.tar.gz
prometheus-webhook-dingtalk-0.3.0.linux-amd64.tar.gz压缩包所在的百度网盘地址如下:
链接:https://pan.baidu.com/s/1_HtVZsItq2KsYvOlkIP9DQ提取码:d59o
cd prometheus-webhook-dingtalk-0.3.0.linux-amd64
启动钉钉报警插件
nohup ./prometheus-webhook-dingtalk --web.listen-address="0.0.0.0:8060" --ding.profile="cluster1=https://oapi.dingtalk.com/robot/send?access_token=9c03ff1f47b1d15a10d852398cafb84f8e81ceeb1ba557eddd8a79e5a5e5548e" &
对原来的文件做备份
cp alertmanager-cm.yaml alertmanager-cm.yaml.bak
重新生成一个新的alertmanager-cm.yaml文件
cat >alertmanager-cm.yaml <<EOFkind: ConfigMapapiVersion: v1metadata:name: alertmanagernamespace: monitor-sadata:: |-global:resolve_timeout: 1msmtp_smarthost: 'smtp.163.com:25'smtp_from: '15011572657@163.com'smtp_auth_username: '15011572657'smtp_auth_password: 'BDBPRMLNZGKWRFJP'smtp_require_tls: falseroute:group_by: [alertname]group_wait: 10sgroup_interval: 10srepeat_interval: 10mreceiver: cluster1receivers:name: cluster1webhook_configs:url: 'http://192.168.124.16:8060/dingtalk/cluster1/send'send_resolved: trueEOF
通过kubectl apply使配置生效
kubectl delete -f alertmanager-cm.yaml
kubectl apply -f alertmanager-cm.yaml
kubectl delete -f prometheus-cfg.yaml
kubectl apply -f prometheus-cfg.yaml
kubectl delete -f prometheus-deploy.yaml
kubectl apply -f prometheus-deploy.yaml
通过上面步骤,就可以实现钉钉报警了
接下来会给大家写通过alertmanager发送微信报警,根据报警级别实现钉钉+微信+邮箱同时报警,同时还会扩展prometheus监控,如监控tomcat、nginx、mysql、redis、mongodb等组件,也会介绍使用prometheus的pushgateway进行自定义数据的监控等,请关注我的公众号来持续学习。
技术交流群
为了大家更快速的学习知识,掌握技术,随时沟通问题,特组建了技术交流群,大家在群里可以分享自己的技术栈,抛出日常问题,群里会有很多大佬及时解答,这样我们就会结识很多志同道合的人,群里还有很多关于kubernetes/docker/devops/openstack/openshift/linux/IaaS/PaaS的免费文章和视频,长按下图可加我微信,备注运维或者k8s或者devops即可进群,让我们共同努力,向着美好的未来出发吧~~~
微信:luckylucky421302
微信公众号
长按如下指纹可关注公众号
原文作者:DevOps和k8s全栈技术;如有侵权,请联系管理员删除。

最新文章
- 韩先超对兴业数金进行云原生k8s培训总结|干货分享|前沿技术必看
- Java 应用上 Kubernetes 的 20 条生产级必备条件
- Kubernetes 存活探测(Liveness Probe)详解:原理、配置与最佳实践
- 深耕为舟,远志为帆->韩先超2025年终总结
- 生产故障排查记录:Redis 中间件疑难错误排查与修复
- docker镜像加速器又又被封了:新整理一批可以用的|无需代理,国内可访问
- 运维秘籍:20个常识,关键时刻能救命!
- 提升运维效率:Linux和Kubernetes常见故障的20种解决方案
- K8s Scheduler Pod 启动失败:Error: failed to reserve container name
- K8S集群证书过期,一键修复指南 | 干货分享
