基于k8s+Prometheus+Alertmanager+Grafana构建企业级监控告警系统

特别提醒:
下文实验需要的yaml文件和压缩包可加我微信获取
微信: luckylucky421302
1.1 深度解读Prometheus
1.1.1 什么是Prometheus?
Prometheus是一个开源的系统监控和报警系统,现在已经加入到CNCF基金会,成为继k8s之后第二个在CNCF托管的项目,在kubernetes容器管理系统中,通常会搭配prometheus进行监控,同时也支持多种exporter采集数据,还支持pushgateway进行数据上报,Prometheus性能足够支撑上万台规模的集群。
1.1.2 prometheus特点
1.多维度数据模型
时间序列数据由metrics名称和键值对来组成
可以对数据进行聚合,切割等操作
所有的metrics都可以设置任意的多维标签。
2.灵活的查询语言(PromQL)
可以对采集的metrics指标进行加法,乘法,连接等操作;
3.可以直接在本地部署,不依赖其他分布式存储;
4.通过基于HTTP的pull方式采集时序数据;
5.可以通过中间网关pushgateway的方式把时间序列数据推送到prometheus server端;
6.可通过服务发现或者静态配置来发现目标服务对象(targets)。
7.有多种可视化图像界面,如Grafana等。
8.高效的存储,每个采样数据占3.5 bytes左右,300万的时间序列,30s间隔,保留60天,消耗磁盘大概200G。
9.做高可用,可以对数据做异地备份,联邦集群,部署多套prometheus,pushgateway上报数据
1.1.3 prometheus组件
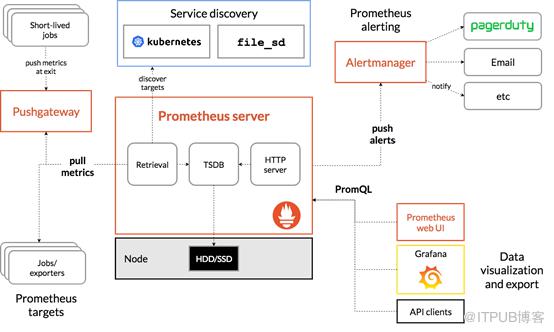
从上图可发现,Prometheus整个生态圈组成主要包括prometheus server,Exporter,pushgateway,alertmanager,grafana,Web ui界面,Prometheusserver由三个部分组成,Retrieval,Storage,PromQL
1.Retrieval负责在活跃的target主机上抓取监控指标数据
2.Storage存储主要是把采集到的数据存储到磁盘中
3.PromQL是Prometheus提供的查询语言模块。
1.PrometheusServer:
用于收集和存储时间序列数据。
2.ClientLibrary:
客户端库,检测应用程序代码,当Prometheus抓取实例的HTTP端点时,客户端库会将所有跟踪的metrics指标的当前状态发送到prometheus server端。
3.Exporters:
prometheus支持多种exporter,通过exporter可以采集metrics数据,然后发送到prometheus server端,所有向promtheus server提供监控数据的程序都可以被称为exporter
4.Alertmanager:
从 Prometheusserver 端接收到 alerts 后,会进行去重,分组,并路由到相应的接收方,发出报警,常见的接收方式有:电子邮件,微信,钉钉, slack等。
5.Grafana:
监控仪表盘,可视化监控数据
6.pushgateway:
各个目标主机可上报数据到pushgatewy,然后prometheus server统一从pushgateway拉取数据。
1.1.4 prometheus几种部署模式
基本HA模式

基本的HA模式只能确保Promthues服务的可用性问题,但是不解决Prometheus Server之间的数据一致性问题以及持久化问题(数据丢失后无法恢复),也无法进行动态的扩展。因此这种部署方式适合监控规模不大,Promthues Server也不会频繁发生迁移的情况,并且只需要保存短周期监控数据的场景。
基本HA + 远程存储方案

在解决了Promthues服务可用性的基础上,同时确保了数据的持久化,当Promthues Server发生宕机或者数据丢失的情况下,可以快速的恢复。同时PromthuesServer可能很好的进行迁移。因此,该方案适用于用户监控规模不大,但是希望能够将监控数据持久化,同时能够确保PromthuesServer的可迁移性的场景。
基本HA + 远程存储 + 联邦集群方案
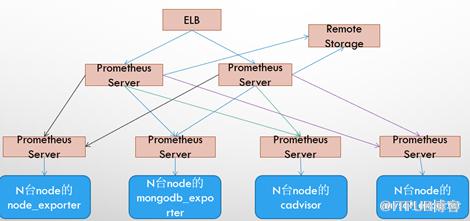
Promthues的性能瓶颈主要在于大量的采集任务,因此用户需要利用Prometheus联邦集群的特性,将不同类型的采集任务划分到不同的Promthues子服务中,从而实现功能分区。例如一个Promthues Server负责采集基础设施相关的监控指标,另外一个Prometheus Server负责采集应用监控指标。再有上层Prometheus Server实现对数据的汇聚。1.1.5 prometheus工作流程1. Prometheus server可定期从活跃的(up)目标主机上(target)拉取监控指标数据,目标主机的监控数据可通过配置静态job或者服务发现的方式被prometheus server采集到,这种方式默认的pull方式拉取指标;也可通过pushgateway把采集的数据上报到prometheus server中;还可通过一些组件自带的exporter采集相应组件的数据;2.Prometheus server把采集到的监控指标数据保存到本地磁盘或者数据库;3.Prometheus采集的监控指标数据按时间序列存储,通过配置报警规则,把触发的报警发送到alertmanager4.Alertmanager通过配置报警接收方,发送报警到邮件,微信或者钉钉等5.Prometheus 自带的web ui界面提供PromQL查询语言,可查询监控数据6.Grafana可接入prometheus数据源,把监控数据以图形化形式展示出1.1.6 prometheus如何更好的监控k8s?对于Kubernetes而言,我们可以把当中所有的资源分为几类:1、基础设施层(Node):集群节点,为整个集群和应用提供运行时资源2、容器基础设施(Container):为应用提供运行时环境3、用户应用(Pod):Pod中会包含一组容器,它们一起工作,并且对外提供一个(或者一组)功能4、内部服务负载均衡(Service):在集群内,通过Service在集群暴露应用功能,集群内应用和应用之间访问时提供内部的负载均衡5、外部访问入口(Ingress):通过Ingress提供集群外的访问入口,从而可以使外部客户端能够访问到部署在Kubernetes集群内的服务因此,在不考虑Kubernetes自身组件的情况下,如果要构建一个完整的监控体系,我们应该考虑,以下5个方面:1、集群节点状态监控:从集群中各节点的kubelet服务获取节点的基本运行状态;2、集群节点资源用量监控:通过Daemonset的形式在集群中各个节点部署NodeExporter采集节点的资源使用情况;3、节点中运行的容器监控:通过各个节点中kubelet内置的cAdvisor中获取个节点中所有容器的运行状态和资源使用情况;4、从黑盒监控的角度在集群中部署Blackbox Exporter探针服务,检测Service和Ingress的可用性;5、如果在集群中部署的应用程序本身内置了对Prometheus的监控支持,那么我们还应该找到相应的Pod实例,并从该Pod实例中获取其内部运行状态的监控指标。

安装采集节点资源指标组件node-exporternode-exporter是什么?内存,磁盘,网络,文件数等信息。安装node-exporter组件,在k8s集群的控制节点操作~]# kubectl create ns monitor-sacreated把课件里的node-exporter.tar.gz镜像压缩包上传到k8s的各个节点,手动解压:docker load -i node-exporter.tar.gznode-export.yaml文件在课件,可自行上传到自己k8s的控制节点,内容如下:[root@master1 ~]# cat node-export.yaml#通过kubectl apply更新node-exporter~]# kubectl apply -f node-export.yamlcreated#查看node-exporter是否部署成功~]# kubectl get pods -n monitor-saNAME READY STATUS RESTARTS AGE1/1 Running 0 22s1/1 Running 0 22s1/1 Running 0 22s通过node-exporter采集数据curl http://主机ip:9100/metrics#node-export默认的监听端口是9100,可以看到当前主机获取到的所有监控数据curl http://192.168.40.130:9100/metrics | grep node_cpu_seconds显示192.168.40.130主机cpu的使用情况# HELP node_cpu_seconds_total Seconds the cpus spent in each mode.# TYPE node_cpu_seconds_total counter="0",mode="idle"} 72963.37="0",mode="iowait"} 9.35="0",mode="irq"} 0="0",mode="nice"} 0="0",mode="softirq"} 151.4="0",mode="steal"} 0="0",mode="system"} 656.12="0",mode="user"} 267.1#HELP:解释当前指标的含义,上面表示在每种模式下node节点的cpu花费的时间,以s为单位#TYPE:说明当前指标的数据类型,上面是counter类型="0",mode="idle"} :cpu0上idle进程占用CPU的总时间,CPU占用时间是一个只增不减的度量指标,从类型中也可以看出node_cpu的数据类型是counter(计数器)counter计数器:只是采集递增的指标curl http://192.168.40.130:9100/metrics | grep node_load# HELP node_load1 1m load average.# TYPE node_load1 gaugenode_load1 0.1node_load1该指标反映了当前主机在最近一分钟以内的负载情况,系统的负载情况会随系统资源的使用而变化,因此node_load1反映的是当前状态,数据可能增加也可能减少,从注释中可以看出当前指标类型为gauge(标准尺寸)gauge标准尺寸:统计的指标可增加可减少在k8s集群中安装Prometheus server服务创建sa账号#在k8s集群的控制节点操作,创建一个sa账号~]# kubectl create serviceaccount monitor -n monitor-sacreated#把sa账号monitor通过clusterrolebing绑定到clusterrole上~]# kubectl create clusterrolebinding monitor-clusterrolebinding -n monitor-sa --clusterrole=cluster-admin --serviceaccount=monitor-sa:monitor创建数据目录#在node1作节点创建存储数据的目录:~]# mkdir /data~]# chmod 777 /data/安装prometheus服务以下步骤均在k8s集群的控制节点操作:创建一个configmap存储卷,用来存放prometheus配置信息prometheus-cfg.yaml文件在课件,可自行上传到自己k8s的控制节点,内容如下:[root@master1 ~]# cat prometheus-cfg.yaml#通过kubectl apply更新configmap~]# kubectl apply -f prometheus-cfg.yamlcreated通过deployment部署prometheusserver需要的镜像prometheus-2-2-1.tar.gz在课件,上传到k8s的工作节点node1上,手动解压:docker load -i prometheus-2-2-1.tar.gzprometheus-deploy.yaml文件在课件,上传到自己的k8s的控制节点,内容如下:[root@master1 ~]# cat prometheus-deploy.yaml=node1,也即是让pod调度到node1节点上,因为node1节点我们创建了数据目录/data,所以大家记住:你在k8s集群的哪个节点创建/data,就让pod调度到哪个节点。#通过kubectl apply更新prometheus~]# kubectl apply -f prometheus-deploy.yamlcreated#查看prometheus是否部署成功~]# kubectl get pods -n monitor-saNAME READY STATUS RESTARTS AGE1/1 Running 0 6m33s1/1 Running 0 6m33s1/1 Running 0 6m33s1/1 Running 0 26spod创建一个serviceprometheus-svc.yaml文件在课件,可上传到k8s的控制节点,内容如下:cat prometheus-svc.yaml---apiVersion: v1kind: Servicemetadata:name: prometheusnamespace: monitor-salabels:app: prometheusspec:type: NodePortports:port: 9090targetPort: 9090protocol: TCPselector:app: prometheuscomponent: server#通过kubectl apply 更新service~]# kubectl apply -f prometheus-svc.yamlcreated#查看service在物理机映射的端口~]# kubectl get svc -n monitor-saNAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGEprometheus NodePort 10.103.98.225 <none> 9090:30009/TCP 27s:30009,就可以访问到prometheus的web ui界面了#访问prometheus web ui界面火狐浏览器输入如下地址:http://192.168.40.130:30009/graph可看到如下页面:

1.4 安装和配置可视化UI界面Grafana安装Grafana需要的镜像heapster-grafana-amd64_v5_0_4.tar.gz在课件里,把镜像上传到k8s的各个控制节点和k8s的各个工作节点,然后在各个节点手动解压:docker load -i heapster-grafana-amd64_v5_0_4.tar.gzgrafana.yaml文件在课件里,可上传到k8s的控制节点,内容如下:[root@master1 ~]# cat grafana.yamlapiVersion: apps/v1kind: Deploymentmetadata:name: monitoring-grafananamespace: kube-systemspec:replicas: 1selector:matchLabels:task: monitoringk8s-app: grafanatemplate:metadata:labels:task: monitoringk8s-app: grafanaspec:containers:- name: grafanaimage: k8s.gcr.io/heapster-grafana-amd64:v5.0.4ports:- containerPort: 3000protocol: TCPvolumeMounts:- mountPath: /etc/ssl/certsname: ca-certificatesreadOnly: true- mountPath: /varname: grafana-storageenv:- name: INFLUXDB_HOSTvalue: monitoring-influxdb- name: GF_SERVER_HTTP_PORTvalue: "3000"# The following env variables are required to make Grafana accessible via# the kubernetes api-server proxy. On production clusters, we recommend# removing these env variables, setup auth for grafana, and expose the grafana# service using a LoadBalancer or a public IP.- name: GF_AUTH_BASIC_ENABLEDvalue: "false"- name: GF_AUTH_ANONYMOUS_ENABLEDvalue: "true"- name: GF_AUTH_ANONYMOUS_ORG_ROLEvalue: Admin- name: GF_SERVER_ROOT_URL# If you're only using the API Server proxy, set this value instead:# value: /api/v1/namespaces/kube-system/services/monitoring-grafana/proxyvalue: /volumes:- name: ca-certificateshostPath:path: /etc/ssl/certs- name: grafana-storageemptyDir: {}---apiVersion: v1kind: Servicemetadata:labels:# For use as a Cluster add-on (https://github.com/kubernetes/kubernetes/tree/master/cluster/addons)# If you are NOT using this as an addon, you should comment out this line.kubernetes.io/cluster-service: 'true'kubernetes.io/name: monitoring-grafananame: monitoring-grafananamespace: kube-systemspec:# In a production setup, we recommend accessing Grafana through an external Loadbalancer# or through a public IP.# type: LoadBalancer# You could also use NodePort to expose the service at a randomly-generated port# type: NodePortports:- port: 80targetPort: 3000selector:k8s-app: grafanatype: NodePort#更新yaml文件[root@master1 ~]# kubectl apply -f grafana.yamldeployment.apps/monitoring-grafana createdservice/monitoring-grafana created#验证是否安装成功[root@master1 ~]# kubectl get pods -n kube-system| grep monitormonitoring-grafana-675798bf47-4rp2b 1/1 Running 0#查看grafana前端的service[root@master1 ~]# kubectl get svc -n kube-system | grep grafanamonitoring-grafana NodePort 10.100.56.76 <none> 80:30989/TCP#登陆grafana,在浏览器访问192.168.40.130:30989可看到如下界面:
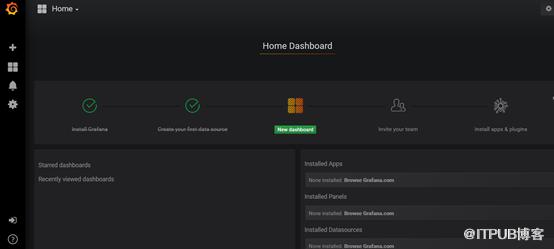
#配置grafana界面
开始配置grafana的web界面:
选择Create your first data source
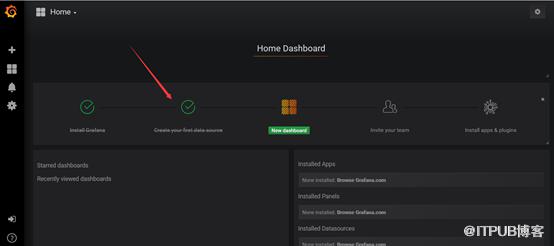
出现如下
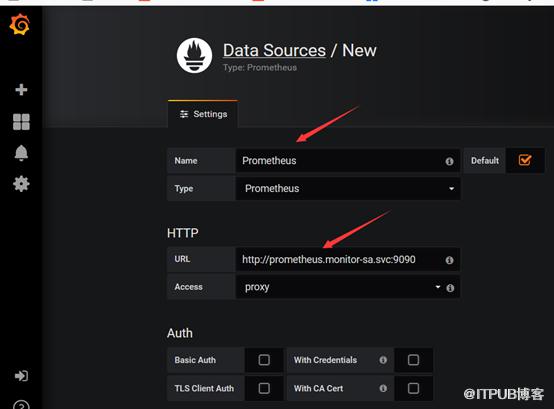
Name:Prometheus
Type:Prometheus
HTTP 处的URL如下:
http://prometheus.monitor-sa.svc:9090
配置好的整体页面如下:
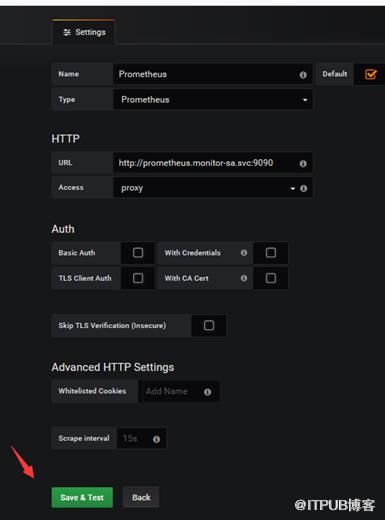
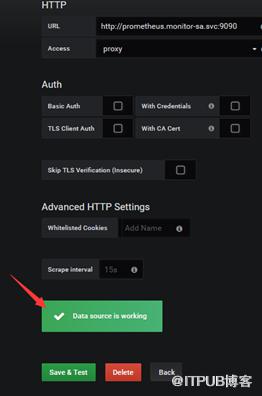
点击左下角Save& Test,出现如下Data source is working,说明prometheus数据源成功的被grafana接入了:
导入监控模板,可在如下链接搜索
https://grafana.com/dashboards?dataSource=prometheus&search=kubernetes
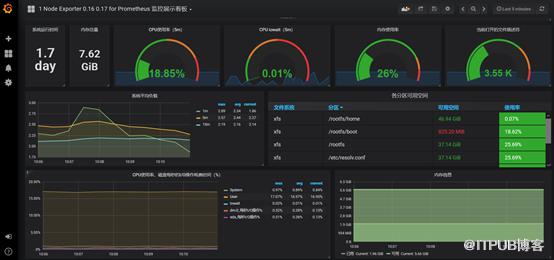
可直接导入node_exporter.json监控模板,这个可以把node节点指标显示出来
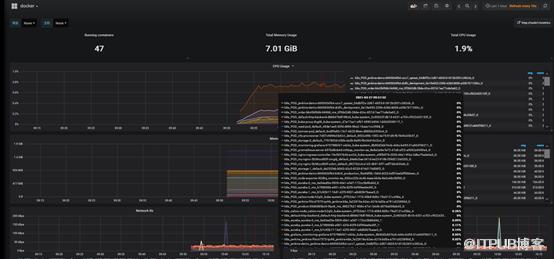
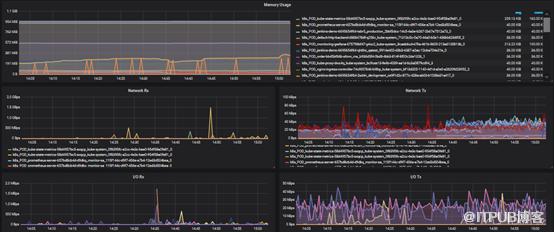
node_exporter.json在课件里,也可直接导入docker_rev1.json,这个可以把容器资源指标显示出来,node_exporter.json和docker_rev1.json都在课件里
怎么导入监控模板,按如下步骤
上面Save& Test测试没问题之后,就可以返回Grafana主页面
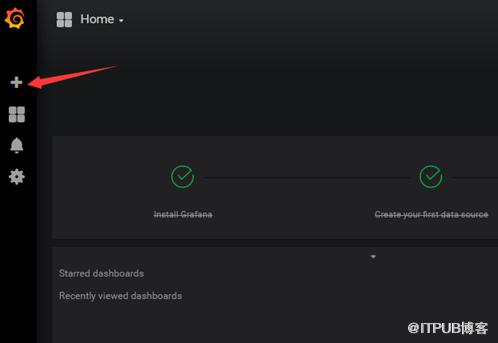
点击左侧+号下面的Import
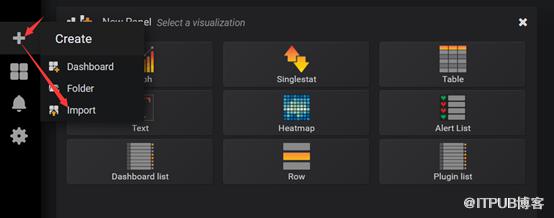
出现如下界面:
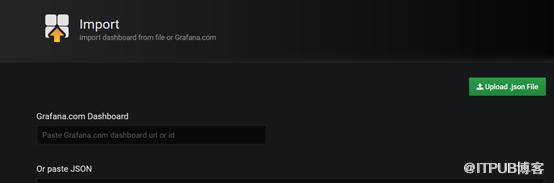
选择Upload json file,出现如下
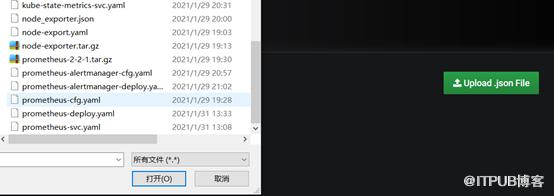
选择一个本地的json文件,我们选择的是上面让大家下载的node_exporter.json这个文件,选择之后出现如下:
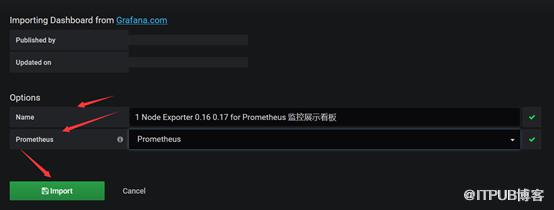
注:箭头标注的地方Name后面的名字是node_exporter.json定义的
Prometheus后面需要变成Prometheus,然后再点击Import,就可以出现如下界面:
导入docker_rev1.json监控模板,步骤和上面导入node_exporter.json步骤一样,导入之后显示如下:
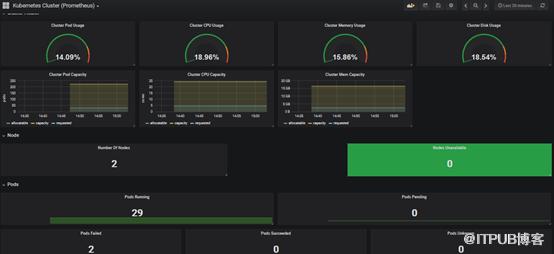
1.5 kube-state-metrics组件解读1.5.1 什么是kube-state-metrics?kube-state-metrics通过监听API Server生成有关资源对象的状态指标,比如Deployment、Node、Pod,需要注意的是kube-state-metrics只是简单的提供一个metrics数据,并不会存储这些指标数据,所以我们可以使用Prometheus来抓取这些数据然后存储,主要关注的是业务相关的一些元数据,比如Deployment、Pod、副本状态等;调度了多少个replicas?现在可用的有几个?多少个Pod是running/stopped/terminated状态?Pod重启了多少次?我有多少job在运行中。1.5.2 安装和配置kube-state-metrics创建sa,并对sa授权在k8s的控制节点生成一个kube-state-metrics-rbac.yaml文件,kube-state-metrics-rbac.yaml文件在课件,大家自行下载到k8s的控制节点即可,内容如下:[root@master1 ~]# cat kube-state-metrics-rbac.yaml---apiVersion: v1kind: ServiceAccountmetadata:name: kube-state-metricsnamespace: kube-system---apiVersion: rbac.authorization.k8s.io/v1kind: ClusterRolemetadata:name: kube-state-metricsrules:- apiGroups: [""]resources: ["nodes", "pods", "services", "resourcequotas", "replicationcontrollers", "limitranges", "persistentvolumeclaims", "persistentvolumes", "namespaces", "endpoints"]verbs: ["list", "watch"]- apiGroups: ["extensions"]resources: ["daemonsets", "deployments", "replicasets"]verbs: ["list", "watch"]- apiGroups: ["apps"]resources: ["statefulsets"]verbs: ["list", "watch"]- apiGroups: ["batch"]resources: ["cronjobs", "jobs"]verbs: ["list", "watch"]- apiGroups: ["autoscaling"]resources: ["horizontalpodautoscalers"]verbs: ["list", "watch"]---apiVersion: rbac.authorization.k8s.io/v1kind: ClusterRoleBindingmetadata:name: kube-state-metricsroleRef:apiGroup: rbac.authorization.k8s.iokind: ClusterRolename: kube-state-metricssubjects:- kind: ServiceAccountname: kube-state-metricsnamespace: kube-system通过kubectl apply更新yaml文件[root@master1 ~]# kubectl apply -f kube-state-metrics-rbac.yamlserviceaccount/kube-state-metrics createdclusterrole.rbac.authorization.k8s.io/kube-state-metrics createdclusterrolebinding.rbac.authorization.k8s.io/kube-state-metrics created安装kube-state-metrics组件安装kube-state-metrics组件需要的镜像在课件,可上传到k8s各个工作节点,手动解压:docker load -i kube-state-metrics_1_9_0.tar.gz在k8s的master1节点生成一个kube-state-metrics-deploy.yaml文件,kube-state-metrics-deploy.yaml在课件,可自行下载,内容如下:[root@master1 ~]# cat kube-state-metrics-deploy.yamlapiVersion: apps/v1kind: Deploymentmetadata:name: kube-state-metricsnamespace: kube-systemspec:replicas: 1selector:matchLabels:app: kube-state-metricstemplate:metadata:labels:app: kube-state-metricsspec:serviceAccountName: kube-state-metricscontainers:- name: kube-state-metricsimage: quay.io/coreos/kube-state-metrics:v1.9.0ports:- containerPort: 8080通过kubectl apply更新yaml文件[root@master1 ~]# kubectl apply -f kube-state-metrics-deploy.yamldeployment.apps/kube-state-metrics created查看kube-state-metrics是否部署成功[root@master1 ~]# kubectl get pods -n kube-system -l app=kube-state-metricsNAME READY STATUS RESTARTS AGEkube-state-metrics-58d4957bc5-9thsw 1/1 Running 0 30s创建service在k8s的控制节点生成一个kube-state-metrics-svc.yaml文件,kube-state-metrics-svc.yaml文件在课件,可上传到k8s的控制节点,内容如下:[root@master1 ~]# cat kube-state-metrics-svc.yamlapiVersion: v1kind: Servicemetadata:annotations:prometheus.io/scrape: 'true'name: kube-state-metricsnamespace: kube-systemlabels:app: kube-state-metricsspec:ports:- name: kube-state-metricsport: 8080protocol: TCPselector:app: kube-state-metrics通过kubectl apply更新yaml[root@master1 ~]# kubectl apply -f kube-state-metrics-svc.yamlservice/kube-state-metrics created查看service是否创建成功[root@master1 ~]# kubectl get svc -n kube-system | grep kube-state-metricskube-state-metrics ClusterIP 10.105.160.224 <none> 8080/TCP在grafana web界面导入Kubernetes Cluster (Prometheus)-1577674936972.json和Kubernetes cluster monitoring (via Prometheus) (k8s 1.16)-1577691996738.json,Kubernetes Cluster (Prometheus)-1577674936972.json和Kubernetes cluster monitoring (via Prometheus) (k8s 1.16)-1577691996738.json文件在课件导入Kubernetes Cluster (Prometheus)-1577674936972.json之后出现如下页面
在grafana web界面导入Kubernetes cluster monitoring(via Prometheus) (k8s 1.16)-1577691996738.json,出现如下页面

安装和配置Alertmanager-发送报警到qq邮箱在k8s的master1节点创建alertmanager-cm.yaml文件,alertmanager-cm.yaml文件在课件,可直接从课件传到k8s的master1节点,内容如下:~]# cat alertmanager-cm.yamlkind: ConfigMapapiVersion: v1metadata:name: alertmanagernamespace: monitor-sadata:: |-global:resolve_timeout: 1msmtp_smarthost: 'smtp.163.com:25'smtp_from: '1501157****@163.com'smtp_auth_username: '1501157****'smtp_auth_password: ' FLWYKIDBNBAIFFXVsmtp_require_tls: falseroute: #用于配置告警分发策略group_by: [alertname] # 采用哪个标签来作为分组依据group_wait: 10s # 组告警等待时间。也就是告警产生后等待10s,如果有同组告警一起发出group_interval: 10s # 两组告警的间隔时间repeat_interval: 10m # 重复告警的间隔时间,减少相同邮件的发送频率receiver: default-receiver # 设置默认接收人receivers:name: 'default-receiver'email_configs:to: '1980570***@qq.com'send_resolved: truealertmanager配置文件解释说明:smtp_smarthost: 'smtp.163.com:25'#用于发送邮件的邮箱的SMTP服务器地址+端口smtp_from: '1501157****@163.com'#这是指定从哪个邮箱发送报警smtp_auth_username: '1501157****'#这是发送邮箱的认证用户,不是邮箱名smtp_auth_password: 'BDBPRMLNZGKWRFJP'#这是发送邮箱的授权码而不是登录密码email_configs:to: '1980570***@qq.com'#to后面指定发送到哪个邮箱,我发送到我的qq邮箱,大家需要写自己的邮箱地址,不应该跟smtp_from的邮箱名字重复#通过kubectl apply 更新文件~]# kubectl apply -f alertmanager-cm.yamlcreated在k8s的master1节点生成一个prometheus-alertmanager-cfg.yaml文件,prometheus-alertmanager-cfg.yaml文件在课件,上传到k8s的master1节点,内容如下:~]# cat prometheus-alertmanager-cfg.yamlkind: ConfigMapapiVersion: v1metadata:labels:app: prometheusname: prometheus-confignamespace: monitor-sadata:: |rule_files:/etc/prometheus/rules.ymlalerting:alertmanagers:static_configs:targets: ["localhost:9093"]global:scrape_interval: 15sscrape_timeout: 10sevaluation_interval: 1mscrape_configs:job_name: 'kubernetes-node'kubernetes_sd_configs:role: noderelabel_configs:source_labels: [__address__]regex: '(.*):10250'replacement: '${1}:9100'target_label: __address__action: replaceaction: labelmapregex: __meta_kubernetes_node_label_(.+)job_name: 'kubernetes-node-cadvisor'kubernetes_sd_configs:role: nodescheme: httpstls_config:ca_file: /var/run/secrets/kubernetes.io/serviceaccount/ca.crtbearer_token_file: /var/run/secrets/kubernetes.io/serviceaccount/tokenrelabel_configs:action: labelmapregex: __meta_kubernetes_node_label_(.+)target_label: __address__replacement: kubernetes.default.svc:443source_labels: [__meta_kubernetes_node_name]regex: (.+)target_label: __metrics_path__replacement: /api/v1/nodes/${1}/proxy/metrics/cadvisorjob_name: 'kubernetes-apiserver'kubernetes_sd_configs:role: endpointsscheme: httpstls_config:ca_file: /var/run/secrets/kubernetes.io/serviceaccount/ca.crtbearer_token_file: /var/run/secrets/kubernetes.io/serviceaccount/tokenrelabel_configs:source_labels: [__meta_kubernetes_namespace, __meta_kubernetes_service_name, __meta_kubernetes_endpoint_port_name]action: keepregex: default;kubernetes;httpsjob_name: 'kubernetes-service-endpoints'kubernetes_sd_configs:role: endpointsrelabel_configs:source_labels: [__meta_kubernetes_service_annotation_prometheus_io_scrape]action: keepregex: truesource_labels: [__meta_kubernetes_service_annotation_prometheus_io_scheme]action: replacetarget_label: __scheme__regex: (https?)source_labels: [__meta_kubernetes_service_annotation_prometheus_io_path]action: replacetarget_label: __metrics_path__regex: (.+)source_labels: [__address__, __meta_kubernetes_service_annotation_prometheus_io_port]action: replacetarget_label: __address__regex: ([^:]+)(?::\d+)?;(\d+)replacement: $1:$2action: labelmapregex: __meta_kubernetes_service_label_(.+)source_labels: [__meta_kubernetes_namespace]action: replacetarget_label: kubernetes_namespacesource_labels: [__meta_kubernetes_service_name]action: replacetarget_label: kubernetes_namejob_name: kubernetes-podskubernetes_sd_configs:role: podrelabel_configs:action: keepregex: truesource_labels:__meta_kubernetes_pod_annotation_prometheus_io_scrapeaction: replaceregex: (.+)source_labels:__meta_kubernetes_pod_annotation_prometheus_io_pathtarget_label: __metrics_path__action: replaceregex: ([^:]+)(?::\d+)?;(\d+)replacement: $1:$2source_labels:__address____meta_kubernetes_pod_annotation_prometheus_io_porttarget_label: __address__action: labelmapregex: __meta_kubernetes_pod_label_(.+)action: replacesource_labels:__meta_kubernetes_namespacetarget_label: kubernetes_namespaceaction: replacesource_labels:__meta_kubernetes_pod_nametarget_label: kubernetes_pod_namejob_name: 'kubernetes-schedule'scrape_interval: 5sstatic_configs:targets: ['192.168.40.130:10251']job_name: 'kubernetes-controller-manager'scrape_interval: 5sstatic_configs:targets: ['192.168.40.130:10252']job_name: 'kubernetes-kube-proxy'scrape_interval: 5sstatic_configs:targets: ['192.168.40.130:10249','192.168.40.131:10249']job_name: 'kubernetes-etcd'scheme: httpstls_config:ca_file: /var/run/secrets/kubernetes.io/k8s-certs/etcd/ca.crtcert_file: /var/run/secrets/kubernetes.io/k8s-certs/etcd/server.crtkey_file: /var/run/secrets/kubernetes.io/k8s-certs/etcd/server.keyscrape_interval: 5sstatic_configs:targets: ['192.168.40.130:2379']: |groups:name: examplerules:alert: kube-proxy的cpu使用率大于80%expr: rate(process_cpu_seconds_total{job=~"kubernetes-kube-proxy"}[1m]) * 100 > 80for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.job}}组件的cpu使用率超过80%"alert: kube-proxy的cpu使用率大于90%expr: rate(process_cpu_seconds_total{job=~"kubernetes-kube-proxy"}[1m]) * 100 > 90for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.job}}组件的cpu使用率超过90%"alert: scheduler的cpu使用率大于80%expr: rate(process_cpu_seconds_total{job=~"kubernetes-schedule"}[1m]) * 100 > 80for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.job}}组件的cpu使用率超过80%"alert: scheduler的cpu使用率大于90%expr: rate(process_cpu_seconds_total{job=~"kubernetes-schedule"}[1m]) * 100 > 90for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.job}}组件的cpu使用率超过90%"alert: controller-manager的cpu使用率大于80%expr: rate(process_cpu_seconds_total{job=~"kubernetes-controller-manager"}[1m]) * 100 > 80for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.job}}组件的cpu使用率超过80%"alert: controller-manager的cpu使用率大于90%expr: rate(process_cpu_seconds_total{job=~"kubernetes-controller-manager"}[1m]) * 100 > 0for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.job}}组件的cpu使用率超过90%"alert: apiserver的cpu使用率大于80%expr: rate(process_cpu_seconds_total{job=~"kubernetes-apiserver"}[1m]) * 100 > 80for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.job}}组件的cpu使用率超过80%"alert: apiserver的cpu使用率大于90%expr: rate(process_cpu_seconds_total{job=~"kubernetes-apiserver"}[1m]) * 100 > 90for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.job}}组件的cpu使用率超过90%"alert: etcd的cpu使用率大于80%expr: rate(process_cpu_seconds_total{job=~"kubernetes-etcd"}[1m]) * 100 > 80for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.job}}组件的cpu使用率超过80%"alert: etcd的cpu使用率大于90%expr: rate(process_cpu_seconds_total{job=~"kubernetes-etcd"}[1m]) * 100 > 90for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.job}}组件的cpu使用率超过90%"alert: kube-state-metrics的cpu使用率大于80%expr: rate(process_cpu_seconds_total{k8s_app=~"kube-state-metrics"}[1m]) * 100 > 80for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.k8s_app}}组件的cpu使用率超过80%"value: "{{ $value }}%"threshold: "80%"alert: kube-state-metrics的cpu使用率大于90%expr: rate(process_cpu_seconds_total{k8s_app=~"kube-state-metrics"}[1m]) * 100 > 0for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.k8s_app}}组件的cpu使用率超过90%"value: "{{ $value }}%"threshold: "90%"alert: coredns的cpu使用率大于80%expr: rate(process_cpu_seconds_total{k8s_app=~"kube-dns"}[1m]) * 100 > 80for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.k8s_app}}组件的cpu使用率超过80%"value: "{{ $value }}%"threshold: "80%"alert: coredns的cpu使用率大于90%expr: rate(process_cpu_seconds_total{k8s_app=~"kube-dns"}[1m]) * 100 > 90for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.k8s_app}}组件的cpu使用率超过90%"value: "{{ $value }}%"threshold: "90%"alert: kube-proxy打开句柄数>600expr: process_open_fds{job=~"kubernetes-kube-proxy"} > 600for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.job}}打开句柄数>600"value: "{{ $value }}"alert: kube-proxy打开句柄数>1000expr: process_open_fds{job=~"kubernetes-kube-proxy"} > 1000for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.job}}打开句柄数>1000"value: "{{ $value }}"alert: kubernetes-schedule打开句柄数>600expr: process_open_fds{job=~"kubernetes-schedule"} > 600for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.job}}打开句柄数>600"value: "{{ $value }}"alert: kubernetes-schedule打开句柄数>1000expr: process_open_fds{job=~"kubernetes-schedule"} > 1000for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.job}}打开句柄数>1000"value: "{{ $value }}"alert: kubernetes-controller-manager打开句柄数>600expr: process_open_fds{job=~"kubernetes-controller-manager"} > 600for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.job}}打开句柄数>600"value: "{{ $value }}"alert: kubernetes-controller-manager打开句柄数>1000expr: process_open_fds{job=~"kubernetes-controller-manager"} > 1000for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.job}}打开句柄数>1000"value: "{{ $value }}"alert: kubernetes-apiserver打开句柄数>600expr: process_open_fds{job=~"kubernetes-apiserver"} > 600for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.job}}打开句柄数>600"value: "{{ $value }}"alert: kubernetes-apiserver打开句柄数>1000expr: process_open_fds{job=~"kubernetes-apiserver"} > 1000for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.job}}打开句柄数>1000"value: "{{ $value }}"alert: kubernetes-etcd打开句柄数>600expr: process_open_fds{job=~"kubernetes-etcd"} > 600for: 2slabels:severity: warnningannotations:description: "{{$labels.instance}}的{{$labels.job}}打开句柄数>600"value: "{{ $value }}"alert: kubernetes-etcd打开句柄数>1000expr: process_open_fds{job=~"kubernetes-etcd"} > 1000for: 2slabels:severity: criticalannotations:description: "{{$labels.instance}}的{{$labels.job}}打开句柄数>1000"value: "{{ $value }}"alert: corednsexpr: process_open_fds{k8s_app=~"kube-dns"} > 600for: 2slabels:severity: warnningannotations:description: "插件{{$labels.k8s_app}}({{$labels.instance}}): 打开句柄数超过600"value: "{{ $value }}"alert: corednsexpr: process_open_fds{k8s_app=~"kube-dns"} > 1000for: 2slabels:severity: criticalannotations:description: "插件{{$labels.k8s_app}}({{$labels.instance}}): 打开句柄数超过1000"value: "{{ $value }}"alert: kube-proxyexpr: process_virtual_memory_bytes{job=~"kubernetes-kube-proxy"} > 2000000000for: 2slabels:severity: warnningannotations:description: "组件{{$labels.job}}({{$labels.instance}}): 使用虚拟内存超过2G"value: "{{ $value }}"alert: schedulerexpr: process_virtual_memory_bytes{job=~"kubernetes-schedule"} > 2000000000for: 2slabels:severity: warnningannotations:description: "组件{{$labels.job}}({{$labels.instance}}): 使用虚拟内存超过2G"value: "{{ $value }}"alert: kubernetes-controller-managerexpr: process_virtual_memory_bytes{job=~"kubernetes-controller-manager"} > 2000000000for: 2slabels:severity: warnningannotations:description: "组件{{$labels.job}}({{$labels.instance}}): 使用虚拟内存超过2G"value: "{{ $value }}"alert: kubernetes-apiserverexpr: process_virtual_memory_bytes{job=~"kubernetes-apiserver"} > 2000000000for: 2slabels:severity: warnningannotations:description: "组件{{$labels.job}}({{$labels.instance}}): 使用虚拟内存超过2G"value: "{{ $value }}"alert: kubernetes-etcdexpr: process_virtual_memory_bytes{job=~"kubernetes-etcd"} > 2000000000for: 2slabels:severity: warnningannotations:description: "组件{{$labels.job}}({{$labels.instance}}): 使用虚拟内存超过2G"value: "{{ $value }}"alert: kube-dnsexpr: process_virtual_memory_bytes{k8s_app=~"kube-dns"} > 2000000000for: 2slabels:severity: warnningannotations:description: "插件{{$labels.k8s_app}}({{$labels.instance}}): 使用虚拟内存超过2G"value: "{{ $value }}"alert: HttpRequestsAvgexpr: sum(rate(rest_client_requests_total{job=~"kubernetes-kube-proxy|kubernetes-kubelet|kubernetes-schedule|kubernetes-control-manager|kubernetes-apiservers"}[1m])) > 1000for: 2slabels:team: adminannotations:description: "组件{{$labels.job}}({{$labels.instance}}): TPS超过1000"value: "{{ $value }}"threshold: "1000"alert: Pod_restartsexpr: kube_pod_container_status_restarts_total{namespace=~"kube-system|default|monitor-sa"} > 0for: 2slabels:severity: warnningannotations:description: "在{{$labels.namespace}}名称空间下发现{{$labels.pod}}这个pod下的容器{{$labels.container}}被重启,这个监控指标是由{{$labels.instance}}采集的"value: "{{ $value }}"threshold: "0"alert: Pod_waitingexpr: kube_pod_container_status_waiting_reason{namespace=~"kube-system|default"} == 1for: 2slabels:team: adminannotations:description: "空间{{$labels.namespace}}({{$labels.instance}}): 发现{{$labels.pod}}下的{{$labels.container}}启动异常等待中"value: "{{ $value }}"threshold: "1"alert: Pod_terminatedexpr: kube_pod_container_status_terminated_reason{namespace=~"kube-system|default|monitor-sa"} == 1for: 2slabels:team: adminannotations:description: "空间{{$labels.namespace}}({{$labels.instance}}): 发现{{$labels.pod}}下的{{$labels.container}}被删除"value: "{{ $value }}"threshold: "1"alert: Etcd_leaderexpr: etcd_server_has_leader{job="kubernetes-etcd"} == 0for: 2slabels:team: adminannotations:description: "组件{{$labels.job}}({{$labels.instance}}): 当前没有leader"value: "{{ $value }}"threshold: "0"alert: Etcd_leader_changesexpr: rate(etcd_server_leader_changes_seen_total{job="kubernetes-etcd"}[1m]) > 0for: 2slabels:team: adminannotations:description: "组件{{$labels.job}}({{$labels.instance}}): 当前leader已发生改变"value: "{{ $value }}"threshold: "0"alert: Etcd_failedexpr: rate(etcd_server_proposals_failed_total{job="kubernetes-etcd"}[1m]) > 0for: 2slabels:team: adminannotations:description: "组件{{$labels.job}}({{$labels.instance}}): 服务失败"value: "{{ $value }}"threshold: "0"alert: Etcd_db_total_sizeexpr: etcd_debugging_mvcc_db_total_size_in_bytes{job="kubernetes-etcd"} > 10000000000for: 2slabels:team: adminannotations:description: "组件{{$labels.job}}({{$labels.instance}}):db空间超过10G"value: "{{ $value }}"threshold: "10G"alert: Endpoint_readyexpr: kube_endpoint_address_not_ready{namespace=~"kube-system|default"} == 1for: 2slabels:team: adminannotations:description: "空间{{$labels.namespace}}({{$labels.instance}}): 发现{{$labels.endpoint}}不可用"value: "{{ $value }}"threshold: "1"name: 物理节点状态-监控告警rules:alert: 物理节点cpu使用率expr: 100-avg(irate(node_cpu_seconds_total{mode="idle"}[5m])) by(instance)*100 > 90for: 2slabels:severity: ccriticalannotations:summary: "{{ $labels.instance }}cpu使用率过高"description: "{{ $labels.instance }}的cpu使用率超过90%,当前使用率[{{ $value }}],需要排查处理"alert: 物理节点内存使用率expr: (node_memory_MemTotal_bytes - (node_memory_MemFree_bytes + node_memory_Buffers_bytes + node_memory_Cached_bytes)) / node_memory_MemTotal_bytes * 100 > 90for: 2slabels:severity: criticalannotations:summary: "{{ $labels.instance }}内存使用率过高"description: "{{ $labels.instance }}的内存使用率超过90%,当前使用率[{{ $value }}],需要排查处理"alert: InstanceDownexpr: up == 0for: 2slabels:severity: criticalannotations:summary: "{{ $labels.instance }}: 服务器宕机"description: "{{ $labels.instance }}: 服务器延时超过2分钟"alert: 物理节点磁盘的IO性能expr: 100-(avg(irate(node_disk_io_time_seconds_total[1m])) by(instance)* 100) < 60for: 2slabels:severity: criticalannotations:summary: "{{$labels.mountpoint}} 流入磁盘IO使用率过高!"description: "{{$labels.mountpoint }} 流入磁盘IO大于60%(目前使用:{{$value}})"alert: 入网流量带宽expr: ((sum(rate (node_network_receive_bytes_total{device!~'tap.*|veth.*|br.*|docker.*|virbr*|lo*'}[5m])) by (instance)) / 100) > 102400for: 2slabels:severity: criticalannotations:summary: "{{$labels.mountpoint}} 流入网络带宽过高!"description: "{{$labels.mountpoint }}流入网络带宽持续5分钟高于100M. RX带宽使用率{{$value}}"alert: 出网流量带宽expr: ((sum(rate (node_network_transmit_bytes_total{device!~'tap.*|veth.*|br.*|docker.*|virbr*|lo*'}[5m])) by (instance)) / 100) > 102400for: 2slabels:severity: criticalannotations:summary: "{{$labels.mountpoint}} 流出网络带宽过高!"description: "{{$labels.mountpoint }}流出网络带宽持续5分钟高于100M. RX带宽使用率{{$value}}"alert: TCP会话expr: node_netstat_Tcp_CurrEstab > 1000for: 2slabels:severity: criticalannotations:summary: "{{$labels.mountpoint}} TCP_ESTABLISHED过高!"description: "{{$labels.mountpoint }} TCP_ESTABLISHED大于1000%(目前使用:{{$value}}%)"alert: 磁盘容量expr: 100-(node_filesystem_free_bytes{fstype=~"ext4|xfs"}/node_filesystem_size_bytes {fstype=~"ext4|xfs"}*100) > 80for: 2slabels:severity: criticalannotations:summary: "{{$labels.mountpoint}} 磁盘分区使用率过高!"description: "{{$labels.mountpoint }} 磁盘分区使用大于80%(目前使用:{{$value}}%)"注意:配置文件解释说明job_name: 'kubernetes-schedule'scrape_interval: 5sstatic_configs:targets: ['192.168.40.130:10251'] #master1节点的ip:schedule端口job_name: 'kubernetes-controller-manager'scrape_interval: 5sstatic_configs:targets: ['192.168.40.130:10252'] #master1节点的ip:controller-manager端口job_name: 'kubernetes-kube-proxy'scrape_interval: 5sstatic_configs:targets: ['192.168.40.130:10249','192.168.40.131:10249']#master1和node1节点的ip:kube-proxy端口job_name: 'kubernetes-etcd'scheme: httpstls_config:ca_file: /var/run/secrets/kubernetes.io/k8s-certs/etcd/ca.crtcert_file: /var/run/secrets/kubernetes.io/k8s-certs/etcd/server.crtkey_file: /var/run/secrets/kubernetes.io/k8s-certs/etcd/server.keyscrape_interval: 5sstatic_configs:targets: ['192.168.40.130:2379']#master1节点的ip:etcd端口#更新资源清单文件~]# kubectl delete -f prometheus-cfg.yamlconfigmap "prometheus-config" deleted~]# kubectl apply -f prometheus-alertmanager-cfg.yamlcreated安装prometheus和alertmanager需要把alertmanager.tar.gz镜像包上传的k8s的各个节点,手动解压:docker load -i alertmanager.tar.gzmaster1节点上,内容如下:~]# cat prometheus-alertmanager-deploy.yaml---apiVersion: apps/v1kind: Deploymentmetadata:name: prometheus-servernamespace: monitor-salabels:app: prometheusspec:replicas: 1selector:matchLabels:app: prometheuscomponent: server#matchExpressions:#- {key: app, operator: In, values: [prometheus]}#- {key: component, operator: In, values: [server]}template:metadata:labels:app: prometheuscomponent: serverannotations:: 'false'spec:nodeName: node1serviceAccountName: monitorcontainers:name: prometheusimage: prom/prometheus:v2.2.1imagePullPolicy: IfNotPresentcommand:"/bin/prometheus"args:"--config.file=/etc/prometheus/prometheus.yml""--storage.tsdb.path=/prometheus""--storage.tsdb.retention=24h""--web.enable-lifecycle"ports:containerPort: 9090protocol: TCPvolumeMounts:mountPath: /etc/prometheusname: prometheus-configmountPath: /prometheus/name: prometheus-storage-volumename: k8s-certsmountPath: /var/run/secrets/kubernetes.io/k8s-certs/etcd/name: alertmanagerimage: prom/alertmanager:v0.14.0imagePullPolicy: IfNotPresentargs:"--config.file=/etc/alertmanager/alertmanager.yml""--log.level=debug"ports:containerPort: 9093protocol: TCPname: alertmanagervolumeMounts:name: alertmanager-configmountPath: /etc/alertmanagername: alertmanager-storagemountPath: /alertmanagername: localtimemountPath: /etc/localtimevolumes:name: prometheus-configconfigMap:name: prometheus-configname: prometheus-storage-volumehostPath:path: /datatype: Directoryname: k8s-certssecret:secretName: etcd-certsname: alertmanager-configconfigMap:name: alertmanagername: alertmanager-storagehostPath:path: /data/alertmanagertype: DirectoryOrCreatename: localtimehostPath:path: /usr/share/zoneinfo/Asia/Shanghai注意:: node1,这个位置要写你自己环境的node节点名字生成一个etcd-certs,这个在部署prometheus需要~]# kubectl -n monitor-sa create secret generic etcd-certs --from-file=/etc/kubernetes/pki/etcd/server.key --from-file=/etc/kubernetes/pki/etcd/server.crt --from-file=/etc/kubernetes/pki/etcd/ca.crtapply更新yaml文件~]# kubectl delete -f prometheus-deploy.yaml~]# kubectl apply -f prometheus-alertmanager-deploy.yamlcreated#查看prometheus是否部署成功kubectl get pods -n monitor-sa | grep prometheus显示如下,可看到pod状态是running,说明prometheus部署成功2/2 Running 0 38s在k8s的master1节点生成一个alertmanager-svc.yaml文件,alertmanager-svc.yaml文件在课件里,可以手动上传到k8s的master1节点,内容如下:~]# cat alertmanager-svc.yaml---apiVersion: v1kind: Servicemetadata:labels:name: prometheus: 'true'name: alertmanagernamespace: monitor-saspec:ports:name: alertmanagernodePort: 30066port: 9093protocol: TCPtargetPort: 9093selector:app: prometheussessionAffinity: Nonetype: NodePort#通过kubectl apply 更新yaml文件~]# kubectl apply -f alertmanager-svc.yamlcreated#查看service在物理机上映射的端口~]# kubectl get svc -n monitor-saNAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGEalertmanager NodePort 10.98.142.161 <none> 9093:30066/TCP 56sprometheus NodePort 10.103.98.225 <none> 9090:30009/TCP 56m注意:上面可以看到prometheus的service暴漏的端口是30009,alertmanager的service暴露的端口是30066访问prometheus的web界面点击status->targets,可看到如下
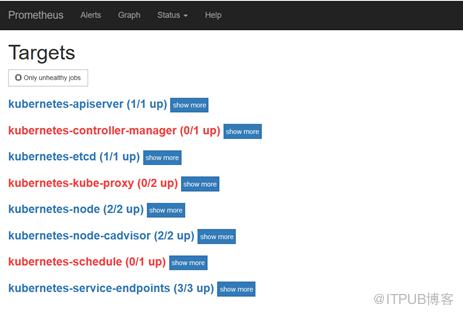
从上面可以发现kubernetes-controller-manager和kubernetes-schedule都显示连接不上对应的端口
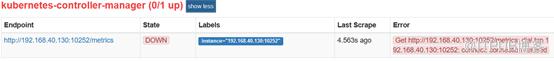

可按如下方法处理;vim /etc/kubernetes/manifests/kube-scheduler.yaml修改如下内容:把--bind-address=127.0.0.1变成--bind-address=192.168.40.130把httpGet:字段下的hosts由127.0.0.1变成192.168.40.130把—port=0删除#注意:192.168.40.130是k8s的控制节点master1节点ipvim /etc/kubernetes/manifests/kube-controller-manager.yaml把--bind-address=127.0.0.1变成--bind-address=192.168.40.130把httpGet:字段下的hosts由127.0.0.1变成192.168.40.130把—port=0删除修改之后在k8s各个节点执行systemctl restart kubeletkubectl get cs显示如下:NAME STATUS MESSAGE ERRORcontroller-manager Healthy okscheduler Healthy oketcd-0 Healthy {"health":"true"}ss -antulp | grep :10251ss -antulp | grep :10252可以看到相应的端口已经被物理机监听了点击status->targets,可看到如下
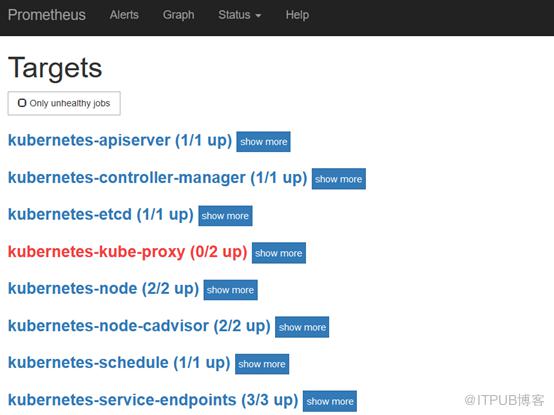
kubernetes-kube-proxy显示如下:
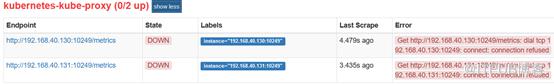
是因为kube-proxy默认端口10249是监听在127.0.0.1上的,需要改成监听到物理节点上,按如下方法修改,线上建议在安装k8s的时候就做修改,这样风险小一些:kubectl edit configmap kube-proxy -n kube-system把metricsBindAddress这段修改成metricsBindAddress: 0.0.0.0:10249然后重新启动kube-proxy这个podkubectl get pods -n kube-system | grep kube-proxy |awk '{print $1}' | xargs kubectl delete pods -n kube-systemss -antulp |grep :10249可显示如下[root@k8s-master ~]# ss -antulp | grep :10249tcp LISTEN 0 128 [::]:10249点击Alerts,可看到如下
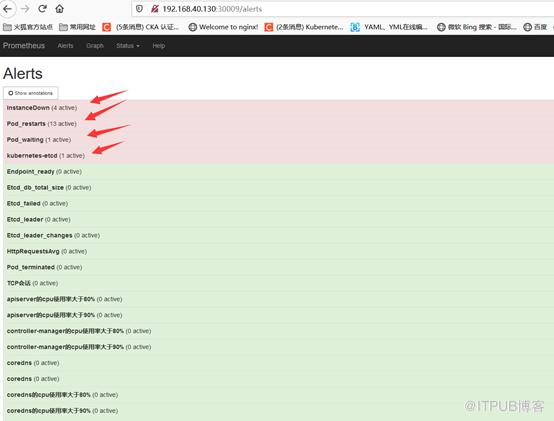
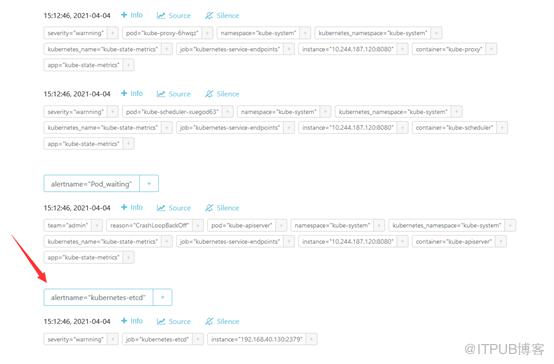
把kubernetes-etcd展开,可看到如下:

FIRING表示prometheus已经将告警发给alertmanager,在Alertmanager 中可以看到有一个 alert。
登录到alertmanagerweb界面,浏览器输入192.168.40.130:30066,显示如下
这样我在我的qq邮箱,1980570***@qq.com就可以收到报警了,如下
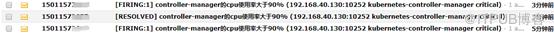
修改prometheus任何一个配置文件之后,可通过kubectl apply使配置生效,执行顺序如下:
kubectldelete -f alertmanager-cm.yaml
kubectlapply -f alertmanager-cm.yaml
kubectldelete -f prometheus-alertmanager-cfg.yaml
kubectlapply -f prometheus-alertmanager-cfg.yaml
kubectldelete -f prometheus-alertmanager-deploy.yaml
kubectl apply -f prometheus-alertmanager-deploy.yaml
精彩文章推荐
从0开始轻松玩转k8s,助力企业实现智能化转型+世界500强实战项目汇总
Docker+k8s+DevOps+Istio+Rancher+CKA+k8s故障排查训练营:
https://edu.51cto.com/topic/4735.html?qd=xglj
点亮,服务器10年不宕机
 点击阅读原文 | 了解更多
原文作者:DevOps和k8s全栈技术;如有侵权,请联系管理员删除。

最新文章
- 韩先超对兴业数金进行云原生k8s培训总结|干货分享|前沿技术必看
- Java 应用上 Kubernetes 的 20 条生产级必备条件
- Kubernetes 存活探测(Liveness Probe)详解:原理、配置与最佳实践
- 深耕为舟,远志为帆->韩先超2025年终总结
- 生产故障排查记录:Redis 中间件疑难错误排查与修复
- docker镜像加速器又又被封了:新整理一批可以用的|无需代理,国内可访问
- 运维秘籍:20个常识,关键时刻能救命!
- 提升运维效率:Linux和Kubernetes常见故障的20种解决方案
- K8s Scheduler Pod 启动失败:Error: failed to reserve container name
- K8S集群证书过期,一键修复指南 | 干货分享
