K8S网站被10T流量攻击,1秒钟内就快速处理
▲ 点击上方"DevOps和k8s全栈技术"关注公众
使用工具如Prometheus监控k8s节点cpu、内存、磁盘网络,以及k8s集群组件的健康情况,用Grafana可视化展示监控信息,基于Alertmanager实现报警。
1. 为什么使用Prometheus?
1.1 灵活性和可扩展性
Prometheus以其高度可扩展性而著称,能够轻松处理大规模的K8s集群。您可以根据需要添加自定义指标,监控多个应用程序和服务。
1.2 数据收集
Prometheus通过拉模型主动从目标上收集数据,而不需要被动等待数据推送。这使得它在K8s中易于实施,因为容器和Pod的生命周期动态变化。
2. 场景和实战
2.1 安装和配置Prometheus
首先,让我们安装和配置Prometheus。您可以使用Helm来部署Prometheus Operator,这是一个管理Prometheus实例的K8s自定义资源定义(CRD)的控制器。
helm repo add prometheus-community https://prometheus-community.github.io/helm-chartshelm install prometheus prometheus-community/prometheus
2.2 配置目标和指标
在Prometheus中,您需要定义目标(targets)和指标(metrics)。目标是您要监视的应用程序和服务,而指标是您要收集的数据。
创建一个prometheus-k8s.yaml配置文件,定义您要监控的K8s服务和应用程序:
apiVersion: v1kind: ConfigMapmetadata:name: prometheus-k8s-configdata:: |global:scrape_interval: 15sscrape_configs:job_name: 'kubernetes-nodes'kubernetes_sd_configs:role: nodejob_name: 'kubernetes-pods'kubernetes_sd_configs:: pod
2.3 创建服务监控规则
Prometheus允许您定义警报规则以监视指标并在满足某些条件时发出警报。例如,您可以创建规则来监视CPU使用率、内存利用率等。
apiVersion: monitoring.coreos.com/v1kind: PrometheusRulemetadata:labels:prometheus: k8sname: examplespec:groups:name: examplerules:alert: HighCpuUsageexpr: 100 - (avg by (instance) (irate(node_cpu{mode="idle"}[5m])) * 100) > 90for: 5mlabels:severity: warningannotations:: 'High CPU usage on instance {{ $labels.instance }}'
2.4 部署Alertmanager
Alertmanager是Prometheus的一部分,用于处理警报通知。您可以使用Helm来安装它:
helm install alertmanager prometheus-community/alertmanager2.5 监控可视化
Prometheus提供了一个简单的Web界面,您可以使用它来查询和可视化监控数据。另外,Grafana是一个流行的可视化工具,它可以与Prometheus集成,提供更丰富的监控仪表板。
helm install grafana prometheus-community/grafana2.6 测试
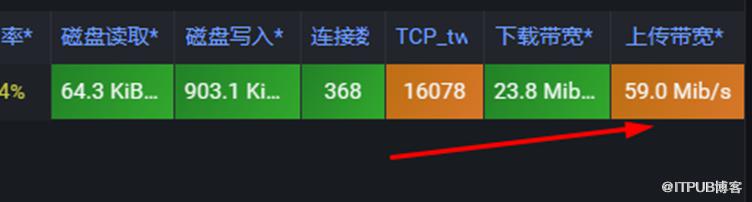
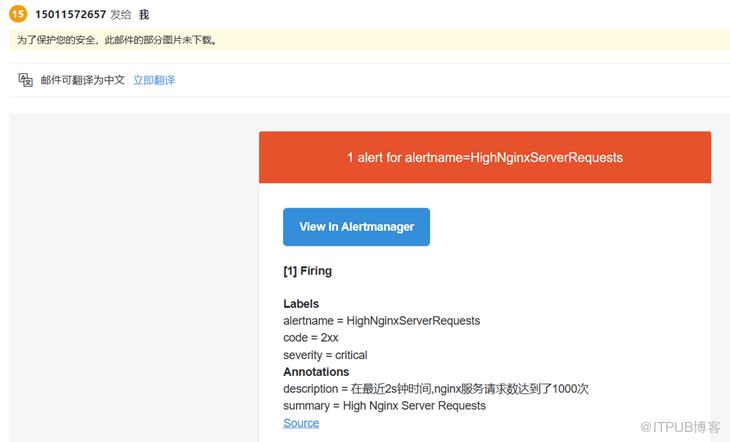
压测网站,测试报警:
[]登录grafana ui界面,可以看到流量已经上来了
登录邮箱,可以看到报警信息也发出来了
原文作者:DevOps和k8s全栈技术;如有侵权,请联系管理员删除。

最新文章
- 韩先超对兴业数金进行云原生k8s培训总结|干货分享|前沿技术必看
- Java 应用上 Kubernetes 的 20 条生产级必备条件
- Kubernetes 存活探测(Liveness Probe)详解:原理、配置与最佳实践
- 深耕为舟,远志为帆->韩先超2025年终总结
- 生产故障排查记录:Redis 中间件疑难错误排查与修复
- docker镜像加速器又又被封了:新整理一批可以用的|无需代理,国内可访问
- 运维秘籍:20个常识,关键时刻能救命!
- 提升运维效率:Linux和Kubernetes常见故障的20种解决方案
- K8s Scheduler Pod 启动失败:Error: failed to reserve container name
- K8S集群证书过期,一键修复指南 | 干货分享
