作者:ShunWah
在运维管理领域,我拥有多年深厚的专业积累,兼具坚实的理论基础与广泛的实践经验。精通运维自动化流程,对于OceanBase、MySQL等多种数据库的部署与运维,具备从初始部署到后期维护的全链条管理能力。拥有OceanBase的OBCA和OBCP认证、OpenGauss社区认证结业证书,以及崖山DBCA、亚信AntDBCA、翰高 HDCA、GBase 8a | 8c | 8s、Galaxybase的GBCA、Neo4j的Graph Data Science Certification、NebulaGraph的NGCI & NGCP、东方通TongTech TCPE等多项权威认证。
在OceanBase & 墨天轮的技术征文大赛中,多次荣获一、二、三等奖。同时,在OpenGauss第五届、第六届、第七届技术征文大赛,TiDB社区专栏征文大赛,金仓数据库有奖征文活动,以及YashanDB「产品体验官」征文等活动中,我也屡获殊荣。此外,我还活跃于墨天轮、CSDN、ITPUB等技术平台,经常发布原创技术文章,并多次被首页推荐。
前言
在数字化转型的浪潮中,数据库作为企业核心业务的基石,其性能与稳定性直接决定着业务系统的运行效率。金仓 KingbaseES V9.3作为国产数据库的杰出代表,在金融、政务等关键领域展现出强大的处理能力。本文聚焦CentOS 7环境下金仓 KingbaseES V9.3的智能运维实践,深入探讨如何构建高并发、低延迟的实时决策系统。
面对不同场景下毫秒级响应的严苛要求,金仓 KingbaseES V9.3 通过JSONB字段实现灵活的行式存储,配合FLOAT4[]数组模拟列式分析能力;采用哈希分区策略实现数据分布式存储,结合SSD/HDD分层存储架构优化I/O性能;利用物化视图+定时刷新机制解决实时分析需求。同时,我们构建了完整的智能运维体系,包括AI索引推荐引擎、实时监控看板和特征血缘追踪,为系统稳定运行提供全方位保障。
一、性能参数调优(OLTP场景聚焦)
1、 硬件与操作系统要求
- CPU:支持x86_64、龙芯、飞腾等架构(最低双核2.0GHz)
- 内存:≥512MB(生产环境建议≥8GB)
- 存储:系统盘≥11GB,数据盘推荐RAID5配置
- 操作系统:CentOS 7.6+、银河麒麟V10等主流Linux发行版
1.1 系统信息检查
1.1.1 检查操作系统信息
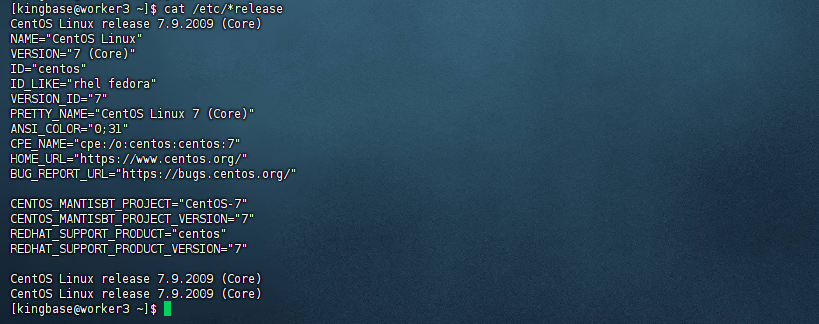
您可以通过以下命令查看操作系统信息:
[kingbase@worker3 ~]$ cat /etc/*release
CentOS Linux release 7.9.2009 (Core)
NAME="CentOS Linux"
VERSION="7 (Core)"
ID="centos"
ID_LIKE="rhel fedora"
VERSION_ID="7"
PRETTY_NAME="CentOS Linux 7 (Core)"
ANSI_COLOR="0;31"
CPE_NAME="cpe:/o:centos:centos:7"
HOME_URL="https://www.centos.org/"
BUG_REPORT_URL="https://bugs.centos.org/"
CENTOS_MANTISBT_PROJECT="CentOS-7"
CENTOS_MANTISBT_PROJECT_VERSION="7"
REDHAT_SUPPORT_PRODUCT="centos"
REDHAT_SUPPORT_PRODUCT_VERSION="7"
CentOS Linux release 7.9.2009 (Core)
CentOS Linux release 7.9.2009 (Core)
[kingbase@worker3 ~]$
注意:
为避免安装失败,或安装结束后文件发生异常,请在安装前关闭操作系统的应用保护,或于安装时在操作系统界面手动点击允许程序执行。
1.1.2 检查系统内存与存储空间
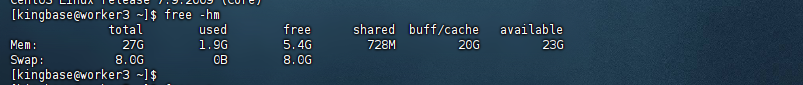
您可以通过以下命令查看内存信息(以MB单位显示):
[kingbase@worker3 ~]$ free -hm
              total        used        free      shared  buff/cache   available
Mem:            27G        1.9G        5.4G        728M         20G         23G
Swap:          8.0G          0B        8.0G
[kingbase@worker3 ~]$
1.1.3 检查存储空间
您可以通过以下命令查看磁盘存储信息(以GB单位显示):
[kingbase@worker3 ~]$ df -lh
Filesystem               Size  Used Avail Use% Mounted on
devtmpfs                  14G     0   14G   0% /dev
tmpfs                     14G  8.0K   14G   1% /dev/shm
tmpfs                     14G  677M   14G   5% /run
tmpfs                     14G     0   14G   0% /sys/fs/cgroup
/dev/mapper/centos-root   91G   60G   27G  70% /
/dev/sda2                190M  119M   58M  68% /boot
/dev/sdb1                200G   17G  184G   9% /data
tmpfs                    2.8G   28K  2.8G   1% /run/user/0
/dev/loop0               2.5G  2.5G     0 100% /mnt
[kingbase@worker3 ~]$

注意: /tmp目录需要至少10G空间。如果安装过程中出现存储空间不足的情况,请先释放足够的磁盘空间,再执行安装程序。如果硬件配置不满足要求,需要更换满足要求的硬件设备再进行安装。
1.2 系统参数优化
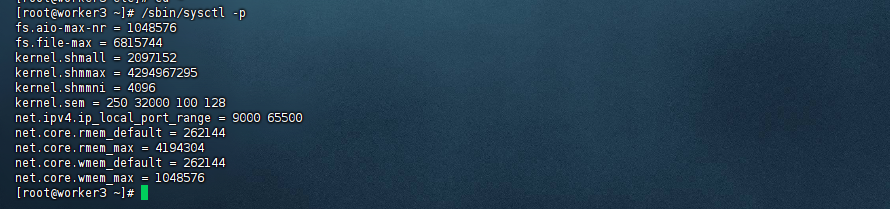
1.2.1 配置内核参数:
[root@worker3 ~]# vi /etc/sysctl.conf
# 添加或修改如下参数
fs.aio-max-nr = 1048576
fs.file-max = 6815744
kernel.shmall = 2097152
kernel.shmmax = 4294967295
kernel.shmmni = 4096
kernel.sem = 250 32000 100 128
net.ipv4.ip_local_port_range = 9000 65500
net.core.rmem_default = 262144
net.core.rmem_max = 4194304
net.core.wmem_default = 262144
net.core.wmem_max = 1048576

执行以下命令使配置生效
[root@worker3 ~]# /sbin/sysctl -p
fs.aio-max-nr = 1048576
fs.file-max = 6815744
kernel.shmall = 2097152
kernel.shmmax = 4294967295
kernel.shmmni = 4096
kernel.sem = 250 32000 100 128
net.ipv4.ip_local_port_range = 9000 65500
net.core.rmem_default = 262144
net.core.rmem_max = 4194304
net.core.wmem_default = 262144
net.core.wmem_max = 1048576
[root@worker3 ~]#
1.2.2 资源限制配置:
[root@worker3 ~]# vi /etc/security/limits.conf
[root@worker3 ~]#
# 添加如下行
* soft nofile 65536
* hard nofile 65535
* soft nproc 65536
* hard nproc 65535
* soft core unlimited
* hard core unlimited

1.2.3 设置RemoveIPC参数:
[root@worker3 ~]# vi /etc/systemd/logind.conf
# 找到RemoveIPC参数,修改为no(如果默认是yes)
RemoveIPC=no

1.2.4 重启systemd-logind服务
[root@worker3 ~]# systemctl daemon-reload
[root@worker3 ~]# systemctl restart systemd-logind.service
[root@worker3 ~]#

关键点:
shmmax需大于物理内存的50%,避免因共享内存不足导致数据库启动失败。
1.3
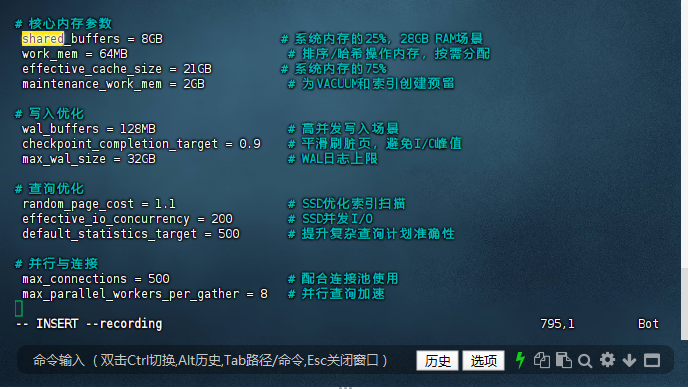
配置文件:
kingbase.conf
[kingbase@worker3 data]$ vim kingbase.conf
[kingbase@worker3 data]$

# 核心内存参数shared_buffers = 8GB # 系统内存的25%,28GB RAM场景work_mem = 64MB # 排序/哈希操作内存,按需分配effective_cache_size = 21GB # 系统内存的75%maintenance_work_mem = 2GB # 为VACUUM和索引创建预留# 写入优化wal_buffers = 128MB # 高并发写入场景checkpoint_completion_target = 0.9 # 平滑刷脏页,避免I/O峰值max_wal_size = 32GB # WAL日志上限# 查询优化random_page_cost = 1.1 # SSD优化索引扫描effective_io_concurrency = 200 # SSD并发I/Odefault_statistics_target = 500 # 提升复杂查询计划准确性# 并行与连接max_connections = 500 # 配合连接池使用max_parallel_workers_per_gather = 8 # 并行查询加速
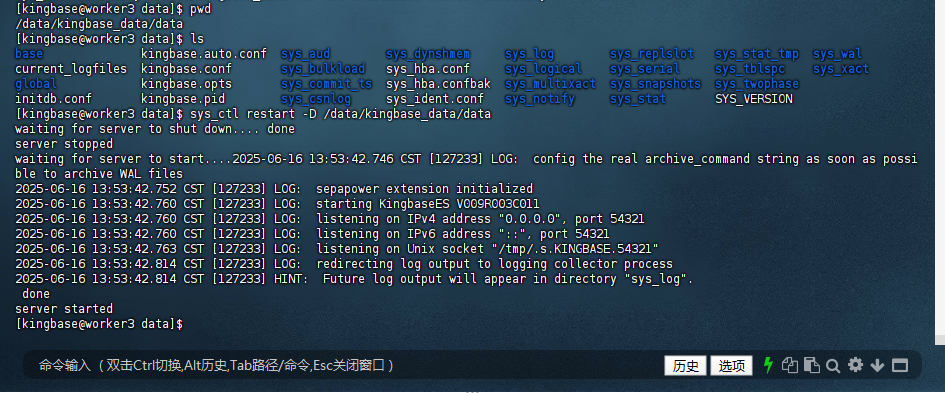
1.4 重启服务,生效配置
[kingbase@worker3 data]$ pwd
/data/kingbase_data/data
[kingbase@worker3 data]$ ls
base              kingbase.auto.conf  sys_aud        sys_dynshmem     sys_log        sys_replslot   sys_stat_tmp  sys_wal
current_logfiles  kingbase.conf       sys_bulkload   sys_hba.conf     sys_logical    sys_serial     sys_tblspc    sys_xact
global            kingbase.opts       sys_commit_ts  sys_hba.confbak  sys_multixact  sys_snapshots  sys_twophase
initdb.conf       kingbase.pid        sys_csnlog     sys_ident.conf   sys_notify     sys_stat       SYS_VERSION
[kingbase@worker3 data]$ sys_ctl restart -D /data/kingbase_data/data
waiting for server to shut down.... done
server stopped
waiting for server to start....2025-06-16 13:53:42.746 CST [127233] LOG:  config the real archive_command string as soon as possible to archive WAL files
2025-06-16 13:53:42.752 CST [127233] LOG:  sepapower extension initialized
2025-06-16 13:53:42.760 CST [127233] LOG:  starting KingbaseES V009R003C011
2025-06-16 13:53:42.760 CST [127233] LOG:  listening on IPv4 address "0.0.0.0", port 54321
2025-06-16 13:53:42.760 CST [127233] LOG:  listening on IPv6 address "::", port 54321
2025-06-16 13:53:42.763 CST [127233] LOG:  listening on Unix socket "/tmp/.s.KINGBASE.54321"
2025-06-16 13:53:42.814 CST [127233] LOG:  redirecting log output to logging collector process
2025-06-16 13:53:42.814 CST [127233] HINT:  Future log output will appear in directory "sys_log".
 done
server started
[kingbase@worker3 data]$
二、行存储实战
创建数据库时,指定UTF8编码是确保正确处理多语言数据的必要步骤。以下是关于数据库创建和表设计的详细说明:
1、数据库创建
使用CREATE DATABASE命令创建数据库时,建议同时指定字符集和排序规则
1.1 – 创建风控专用库
test=# CREATE DATABASE risk_db
test-#   WITH ENCODING 'UTF8'
test-#   LC_COLLATE 'en_US.UTF-8'
test-#   LC_CTYPE 'en_US.UTF-8'
test-#   TEMPLATE template0;
CREATE DATABASE
test=# \c risk_db
You are now connected to database "risk_db" as userName "system".
risk_db=#
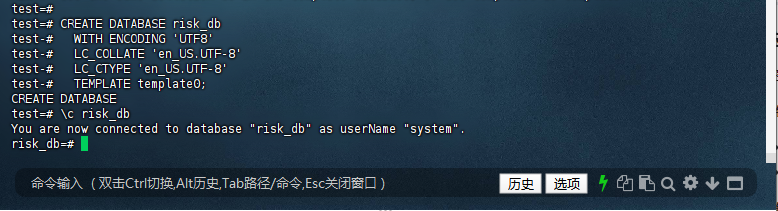
这种方式确保了数据库支持完整的Unicode字符集
表设计要点
用户表:应包含用户ID、注册时间、最后登录时间等基础字段
交易表:需要记录交易金额、时间、IP地址等关键信息
风险日志表:用于存储风险评估结果和处置记录
编码验证
创建后可通过SHOW CREATE DATABASE risk_db命令验证编码设置是否生效
建议采用模块化设计思路,将数据采集、规则引擎、风险评估等功能分离,同时数据库设计应考虑实时性和可扩展性需求。
1.2 – 行存表分区-哈希分区(实时写入+分析)
分区策略选择
哈希分区通过PARTITION BY HASH(user_id)实现数据均匀分布,适合用户ID离散值场景23
每个分区存储的物理文件独立,可并行处理查询请求24
字段设计优化
BIGSERIAL自动递增主键确保事件唯一性,与分区键user_id形成复合约束16
JSONB类型支持半结构化风控数据的高效存取和索引4
FLOAT4[]数组模拟列式存储,适合特征向量分析场景5
版本适配说明 V9.3 需移除行列混合存储语法,纯行存模式通过数组字段实现分析需求5
哈希函数内部采用模运算,分区数建议为2的幂次方(如8/16/32)
risk_db=#
risk_db=# CREATE TABLE risk_events (
risk_db(#   event_id    BIGSERIAL PRIMARY KEY,
risk_db(#   user_id     VARCHAR(36) NOT NULL,
risk_db(#   event_time  TIMESTAMPTZ DEFAULT NOW(),
risk_db(#   raw_data    JSONB,                  -- 行存储字段(频繁更新)
risk_db(#   features    FLOAT4[]                -- 数值型特征数组(模拟列式分析)
risk_db(# ) PARTITION BY HASH(user_id);
CREATE TABLE
risk_db=#
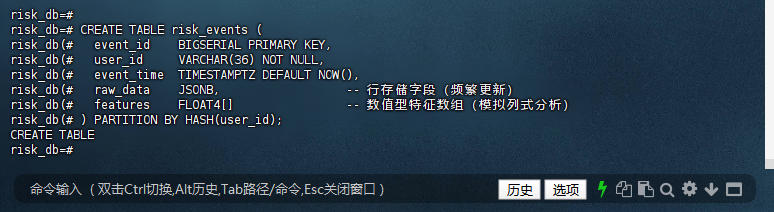
该设计平衡了实时写入(行存)与分析查询(数组字段)的需求,符合风控场景高频更新的特点67。对于时间序列数据可考虑增加RANGE二级分区提升时间范围查询效率
⚠️ 注意:V9.3 不支持
COLUMN_STORE,所有字段都是行式存储。你可以通过索引 + 物化视图 + 查询优化来提升性能。
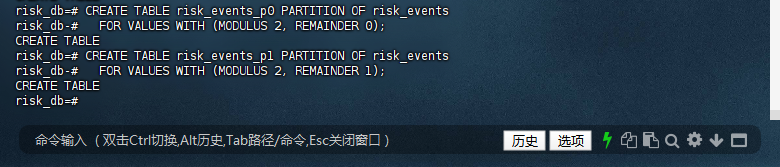
1.3 – 创建分区(按 HASH 分区)
在KingbaseES V9.3中创建哈希分区时,采用MODULUS和REMAINDER语法可实现数据均匀分布,该实现方式具有以下特性:
哈希分区原理
通过MODULUS 2指定哈希桶总数,REMAINDER定义当前分区对应的余数值35
系统对分区键user_id自动计算哈希值,按模运算结果路由到对应分区25
分区管理建议
分区数量建议为2的幂次方(如4/8/16)以获得最佳分布效果3
可通过ANALYZE risk_events更新统计信息优化查询计划6
性能优化方向
对高频查询字段如event_time可创建本地索引8
定期执行VACUUM ANALYZE risk_events_p0维护分区性能
– 创建两个分区p0、p1
risk_db=# CREATE TABLE risk_events_p0 PARTITION OF risk_events
risk_db-#   FOR VALUES WITH (MODULUS 2, REMAINDER 0);
CREATE TABLE
risk_db=# CREATE TABLE risk_events_p1 PARTITION OF risk_events
risk_db-#   FOR VALUES WITH (MODULUS 2, REMAINDER 1);
CREATE TABLE
risk_db=#
2、创建索引(提升查询效率)
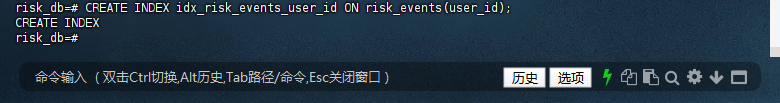
分区索引特性
该语句会自动在所有分区上创建同名本地索引,确保跨分区查询效率26
哈希分区键user_id的索引可加速等值查询,但范围查询仍需结合其他索引38
索引类型选择
默认创建B-tree索引适合精确匹配和排序操作5
对高频更新的user_id建议定期执行REINDEX维护索引性能
2.1 – 对 user_id 建立索引
risk_db=# CREATE INDEX idx_risk_events_user_id ON risk_events(user_id);
CREATE INDEX
risk_db=#
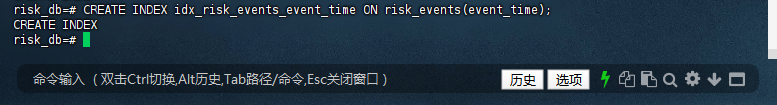
2.2 – 对时间字段建立索引(适用于时序查询)
在KingbaseES V9.3中为时间字段创建索引时,该时序索引设计具有以下优化特性:
索引类型选择
默认B-tree索引适合时间范围查询(如WHERE event_time BETWEEN …)36
对极高频写入场景可考虑BRIN索引节省存储空间58
分区表特性
该语句会自动为所有分区创建本地时间索引2
结合哈希分区可实现"user_id+时间"的双维度高效查询
risk_db=# CREATE INDEX idx_risk_events_event_time ON risk_events(event_time);
CREATE INDEX
risk_db=#
3、 创建物化视图(加速特征查询)
基础特性:
物化视图会持久化存储SELECT user_id, features的查询结果,避免重复计算26
默认创建时自动填充数据(WITH DATA),空结果集显示"SELECT 0"属正常现象68
刷新策略:
需手动执行全量刷新:REFRESH MATERIALIZED VIEW risk_features_mv23
不支持自动增量刷新,建议通过定时任务触发刷新
risk_db=# CREATE MATERIALIZED VIEW risk_features_mv AS
risk_db-# SELECT user_id, features
risk_db-# FROM risk_events;
SELECT 0
risk_db=#

⚠️ 注意:V9.3 不支持
REFRESH MATERIALIZED VIEW CONCURRENTLY,刷新时会锁表。
4、 定时刷新脚本(Shell 脚本 + Cron)
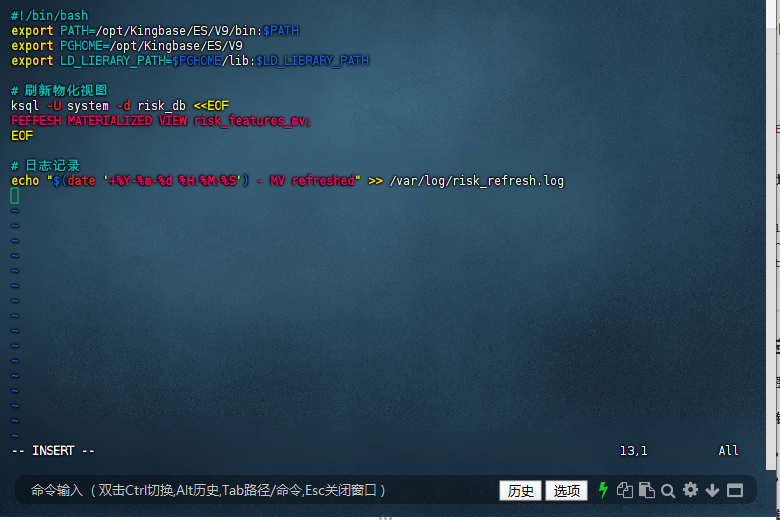
脚本 refresh_mv.sh 是一个用于定时刷新 KingbaseES 数据库中物化视图的 Shell 脚本
[kingbase@worker3 kingbase_data]$ vim refresh_mv.sh
[kingbase@worker3 kingbase_data]$
refresh_mv.sh 是一个用于定时刷新 KingbaseES 数据库中物化视图的 Shell 脚本。物化视图(Materialized View)是数据库中的一种特殊对象,它存储了查询结果,可以显著提高复杂查询的性能,但需要定期刷新以保持数据的最新状态。
#!/bin/bashexport PATH=/opt/Kingbase/ES/V9/bin:$PATHexport PGHOME=/opt/Kingbase/ES/V9export LD_LIBRARY_PATH=$PGHOME/lib:$LD_LIBRARY_PATH# 刷新物化视图ksql -U system -d risk_db <<EOF
REFRESH MATERIALIZED VIEW risk_features_mv;
EOF# 日志记录echo "$(date '+%Y-%m-%d %H:%M:%S') - MV refreshed" >> /var/log/risk_refresh.log
4.1 设置执行权限并添加定时任务:
[kingbase@worker3 kingbase_data]$ chmod +x refresh_mv.sh
[kingbase@worker3 kingbase_data]$
4.2 配置 Cron 定时任务 1. 编辑当前用户的 crontab:
添加如下内容(每分钟刷新一次):
* * * * * /home/kingbase/scripts/refresh_mv.sh

4.3 在事务中设置一些会话级别的参数
test=# BEGIN;
BEGIN
test=# SET LOCAL statement_timeout = '30s';
SET
test=# SET LOCAL max_parallel_workers_per_gather = 8;
SET
test=#
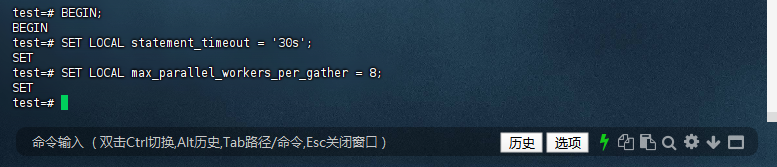
BEGIN; 命令开始一个新的事务。在事务中执行的多个 SQL 语句将被视为一个工作单元,要么全部提交,要么全部回滚。
SET LOCAL statement_timeout = ‘30s’; 设置当前事务的语句超时时间为 30 秒。
statement_timeout 参数控制单个 SQL 语句的最长执行时间,超过这个时间将被强制终止。
LOCAL 关键字表示这个设置只在当前事务中有效,事务结束后将恢复之前的设置。
SET LOCAL max_parallel_workers_per_gather = 8; 设置当前事务中并行查询的最大工作进程数为 8。
这个参数控制并行查询(当查询可以被并行执行时)使用的最大工作进程数。
增加这个值可以提高某些复杂查询的性能,但也会增加资源消耗。
三、创建数据库与用户
在 KingbaseES 中创建数据库和用户的过程
3.1 创建数据库
[kingbase@worker3 kingbase_data]$ createdb -U system riskdb
Password:
[kingbase@worker3 kingbase_data]$ createuser -U system -P risk_user
Enter password for new role:
Enter it again:
Password:
[kingbase@worker3 kingbase_data]$
createdb:PostgreSQL/KingbaseES 命令行工具,用于创建新数据库
-U system:指定使用系统用户 “system” 来执行此操作
riskdb:要创建的新数据库名称
系统会提示输入 “system” 用户的密码
3.2 创建用户
createuser:PostgreSQL/KingbaseES 命令行工具,用于创建新数据库用户(角色)
-U system:指定使用系统用户 “system” 来执行此操作
-P:提示输入新用户的密码
risk_user:要创建的新用户名
系统会提示输入并确认新用户的密码
3.3 连接到数据库
[kingbase@worker3 kingbase_data]$ ksql -U system -d riskdb
Password for user system:
Licesen Type: SALES-企业版.
Type "help" for help.
riskdb=#
ksql:KingbaseES 的交互式终端程序(类似于 PostgreSQL 的 psql)
-U system:使用 “system” 用户连接
-d riskdb:连接到名为 “riskdb” 的数据库
系统会提示输入 “system” 用户的密码
连接成功后显示数据库名称和提示符 riskdb=#
3.4 授权用户访问数据库
riskdb=# GRANT ALL PRIVILEGES ON DATABASE riskdb TO risk_user;
GRANT
riskdb=#
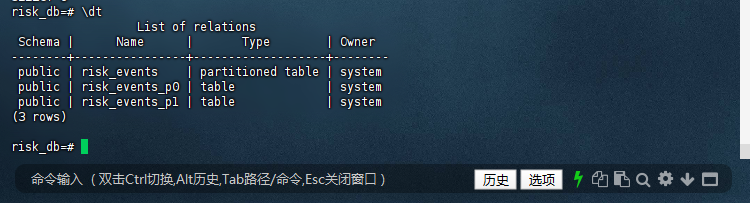
3.5 查看当前数据库中的表
risk_db=# \dt
                  List of relations
 Schema |      Name      |       Type        | Owner
--------+----------------+-------------------+--------
 public | risk_events    | partitioned table | system
 public | risk_events_p0 | table             | system
 public | risk_events_p1 | table             | system
(3 rows)
risk_db=#
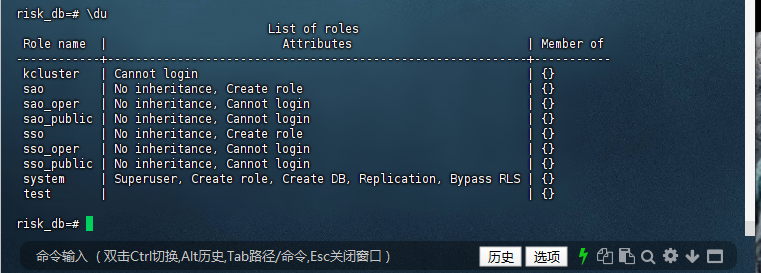
3.6 查看当前数据库中的用户
risk_db=# \du
                                    List of roles
 Role name  |                         Attributes                         | Member of
------------+------------------------------------------------------------+-----------
 kcluster   | Cannot login                                               | {}
 sao        | No inheritance, Create role                                | {}
 sao_oper   | No inheritance, Cannot login                               | {}
 sao_public | No inheritance, Cannot login                               | {}
 sso        | No inheritance, Create role                                | {}
 sso_oper   | No inheritance, Cannot login                               | {}
 sso_public | No inheritance, Cannot login                               | {}
 system     | Superuser, Create role, Create DB, Replication, Bypass RLS | {}
 test       |                                                            | {}
risk_db=#
四、特征存储结构优化
在 KingbaseES 中创建一个用于风险特征存储的表结构。
1. 创建特征存储表
字段说明
feature_id BIGSERIAL PRIMARY KEY
BIGSERIAL:自增的 64 位整数,适合作为主键
作为表的唯一标识符,确保每条记录都有唯一 ID
user_id BIGINT NOT NULL
用户标识符,非空
用于关联用户和其特征数据
model_ver VARCHAR(10)
模型版本号,用于跟踪生成特征所用的模型版本
限制为 10 个字符,适合存储版本号如 “v1.0”, “202305” 等
raw_data JSONB
存储原始数据,使用 JSONB 类型(二进制 JSON)
适合结构不固定的数据
JSONB 支持索引和高效的查询操作
features FLOAT4[]
存储特征值的数组,使用单精度浮点数数组
适合批量数值计算
数组类型便于处理多个相关特征值
riskdb=# CREATE TABLE risk_features (
riskdb(#   feature_id BIGSERIAL PRIMARY KEY,
riskdb(#   user_id    BIGINT NOT NULL,
riskdb(#   model_ver  VARCHAR(10),
riskdb(#   raw_data   JSONB,             -- 行存字段:结构不固定,适合 JSONB
riskdb(#   features   FLOAT4[]           -- 行存字段:数值型数组,适合批量计算
riskdb(# ) PARTITION BY RANGE (user_id);
CREATE TABLE
riskdb=#

2. 创建分区表
在 KingbaseES(或兼容的 PostgreSQL 数据库)中为已创建的主表 risk_features 创建分区表的操作。这种分区策略是将数据按照 user_id 的范围分布到不同的物理表中,这有助于提高大表的查询性能和管理效率。
分区设计 PARTITION BY RANGE (user_id)按 user_id 范围进行分区,这种分区方式适合按用户 ID 范围分布数据的场景,可以提高大表的查询性能,特别是当查询可以限定在特定分区时。
riskdb=# CREATE TABLE risk_features_0001 PARTITION OF risk_features
riskdb-#   FOR VALUES FROM (0) TO (1000000);
CREATE TABLE
riskdb=# CREATE TABLE risk_features_0002 PARTITION OF risk_features
riskdb-#   FOR VALUES FROM (1000000) TO (2000000);
CREATE TABLE
riskdb=#
分区表创建解析
第一个分区表
risk_features_0001:第一个分区表的名称
PARTITION OF risk_features:表示这是 risk_features 主表的一个分区
FOR VALUES FROM (0) TO (1000000):定义这个分区存储 user_id 在 0 到 1,000,000 范围内的数据
第二个分区表
risk_features_0002:第二个分区表的名称
PARTITION OF risk_features:表示这也是 risk_features 主表的一个分区
FOR VALUES FROM (1000000) TO (2000000):定义这个分区存储 user_id 在 1,000,000 到 2,000,000 范围内的数据
3. 创建索引
在 KingbaseES 中为 risk_features 表创建索引的操作。索引是提高数据库查询性能的重要工具,特别是在处理大量数据时。
riskdb=# CREATE INDEX idx_risk_features_user_id ON risk_features(user_id);
CREATE INDEX idx_risk_features_model_ver ON risk_features(model_ver);
CREATE INDEX
riskdb=# CREATE INDEX idx_risk_features_model_ver ON risk_features(model_ver);
CREATE INDEX
riskdb=#

索引创建解析
3.1 用户 ID 索引
索引名称: idx_risk_features_user_id
目标表: risk_features
索引字段: user_id
作用:
加速基于 user_id 的查询
由于表已按 user_id 分区,这个索引会应用到所有分区
对按用户 ID 检索数据的查询性能有显著提升
3.2 模型版本索引
索引名称: idx_risk_features_model_ver
目标表: risk_features
索引字段: model_ver
作用:
加速基于 model_ver 的查询
适合需要按模型版本筛选数据的场景
对分析不同模型版本的效果很有帮助
4. 创建物化视图
在 KingbaseES 中创建一个物化视图(Materialized View)的操作。物化视图是一种特殊的数据库对象,它存储了查询的结果,可以显著提高复杂查询的性能,特别是在数据不经常变化或需要频繁访问相同查询结果的场景中。
物化视图创建解析
riskdb=# CREATE MATERIALIZED VIEW risk_features_mv AS
riskdb-# SELECT user_id, model_ver, features
riskdb-# FROM risk_features;
SELECT 0
riskdb=#

物化视图名称: risk_features_mv
查询定义:
从 risk_features 表中选择 user_id, model_ver, 和 features 字段
这个查询定义了物化视图的内容
五、定时刷新机制
用于定时刷新 KingbaseES 数据库中物化视图的 Shell 脚本。这个脚本可以定期执行以保持物化视图数据的最新状态。
1. 编写刷新脚本
[kingbase@worker3 kingbase_data]$ vim refresh_mv.sh
[kingbase@worker3 kingbase_data]$
创建一个 Shell 脚本
refresh_mv.sh:
#!/bin/bashexport PATH=/opt/Kingbase/ES/V9/bin:$PATHexport PGHOME=/opt/Kingbase/ES/V9export LD_LIBRARY_PATH=$PGHOME/lib:$LD_LIBRARY_PATH# 连接参数DBNAME="riskdb"DBUSER="system"# 刷新物化视图echo "Refreshing materialized view..."ksql -U $DBUSER -d $DBNAME <<EOF
REFRESH MATERIALIZED VIEW risk_features_mv;
EOF# 日志记录echo "$(date '+%Y-%m-%d %H:%M:%S') - MV refreshed" >> /var/log/risk_refresh.log
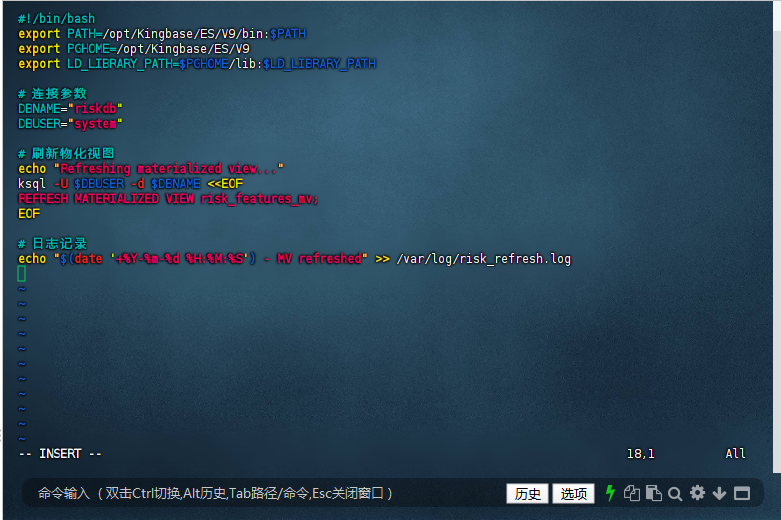
脚本功能
环境设置:
设置 KingbaseES 相关的环境变量,确保 ksql 命令可以正确执行
数据库连接参数:
定义数据库名称 (DBNAME) 和用户名 (DBUSER)
物化视图刷新:
使用 ksql 连接到数据库并执行 REFRESH MATERIALIZED VIEW 命令
这会更新 risk_features_mv 物化视图的内容
日志记录:
在 /var/log/risk_refresh.log 中记录每次刷新的时间戳
2. 设置定时任务
使用 crontab 设置一个每分钟执行一次的定时任务来刷新物化视图。这种高频刷新策略适用于需要物化视图数据几乎实时更新的场景。
使用
crontab 添加定时任务:
crontab -e
编辑 crontab 文件:
添加如下内容(每分钟刷新一次):
添加定时任务:
在打开的编辑器中,添加以下行以每分钟执行一次刷新脚本:
* * * * * /path/to/refresh_mv.sh
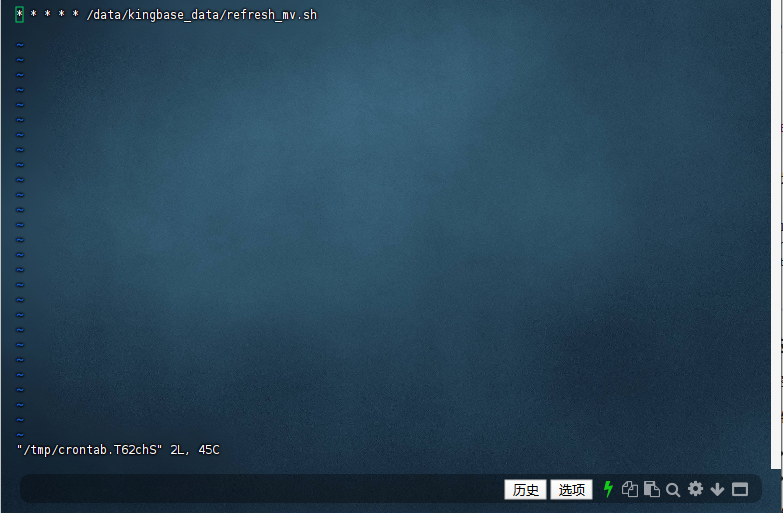
保存并退出:
保存文件并退出编辑器。在大多数编辑器中,您可以通过按 Ctrl+X 然后按 Y 确认保存并退出。
六、查询优化与性能提升
在 KingbaseES 中进行查询优化和性能提升的一系列操作。这些操作包括刷新物化视图、创建索引、设置事务参数以及执行查询分析。
1、-- 刷新物化视图
riskdb=# REFRESH MATERIALIZED VIEW risk_features_mv;
REFRESH MATERIALIZED VIEW
riskdb=#
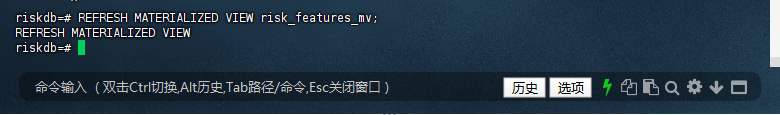
作用:更新物化视图 risk_features_mv 的内容,使其与基表 risk_features 的数据保持一致。
建议:
确保刷新操作不会对生产系统造成过大的负载。
根据业务需求选择合适的刷新频率。
2、-- 创建索引
riskdb=# CREATE INDEX IF NOT EXISTS idx_risk_features_mv_user_id ON risk_features_mv(user_id);
CREATE INDEX
riskdb=#
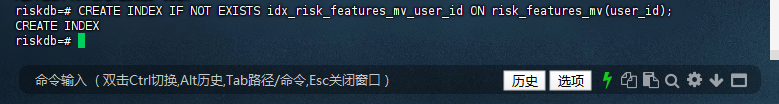
作用:在物化视图的 user_id 字段上创建索引,以加速基于 user_id 的查询。
建议:
确保索引的选择性高,避免在低选择性字段上创建索引。
监控索引的使用情况,删除未使用的索引以减少维护开销。
3、-- 开启事务并设置参数
riskdb=# BEGIN;
BEGIN
riskdb=#
riskdb=# SET LOCAL statement_timeout = '30s';
SET
riskdb=# SET LOCAL max_parallel_workers_per_gather = 8;
SET
riskdb=#
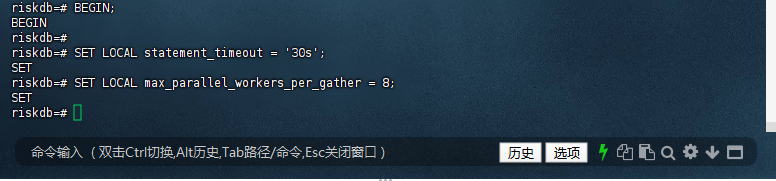
作用:
BEGIN:开启一个新的事务。
SET LOCAL statement_timeout = ‘30s’:设置当前事务的语句超时时间为 30 秒。
SET LOCAL max_parallel_workers_per_gather = 8:设置当前事务中并行查询的最大工作进程数为 8。
建议:
根据查询复杂度和系统负载合理设置 statement_timeout。
调整 max_parallel_workers_per_gather 以平衡并行查询的性能和资源消耗。
COMMIT;
作用:提交当前事务,使所有更改永 久生效。
建议:
确保在事务中完成所有必要的操作后再提交。
对于长时间运行的事务,考虑使用 COMMIT 后重新开启新事务。
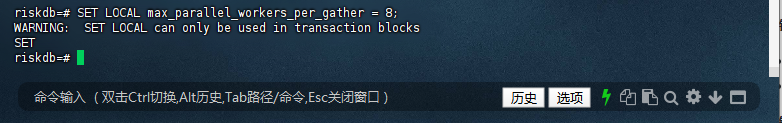
4、-- 启用并行查询:
riskdb=# SET LOCAL max_parallel_workers_per_gather = 8;
WARNING:  SET LOCAL can only be used in transaction blocks
SET
riskdb=#
七、高并发事务保障方案
1. 分布式事务强一致(XA协议)
– 1.1 创建SSD表空间
作用:在 SSD 存储设备上创建一个新的表空间 ssd_tbsp。
建议:
SSD 存储通常提供更高的 I/O 性能,适合存储需要快速访问的表和索引。
确保路径 /opt/KingbaseES/V9/ssd_data 存在并且有足够的空间。
考虑将高频访问的表和索引放置在 SSD 表空间中以提高性能。
riskdb=# CREATE TABLESPACE ssd_tbsp LOCATION '/opt/KingbaseES/V9/ssd_data';
CREATE TABLESPACE
riskdb=#

– 1.2 创建HDD表空间
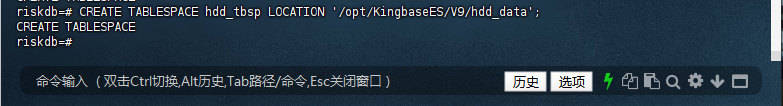
作用:在 HDD 存储设备上创建一个新的表空间 hdd_tbsp。
建议:
HDD 存储通常用于存储不常访问的数据或大容量数据。
确保路径 /opt/KingbaseES/V9/hdd_data 存在并且有足够的空间。
考虑将归档数据或低频访问的表和索引放置在 HDD 表空间中以节省 SSD 资源。
riskdb=# CREATE TABLESPACE hdd_tbsp LOCATION '/opt/KingbaseES/V9/hdd_data';
CREATE TABLESPACE
riskdb=#
2、完整冷热数据分层方案
您展示的是在 KingbaseES 中实现冷热数据分层存储的完整方案。这种方案通过将数据根据时间范围分区并存储在不同的表空间中,优化了存储资源的利用和查询性能。
2.1 – 创建冷热分区表
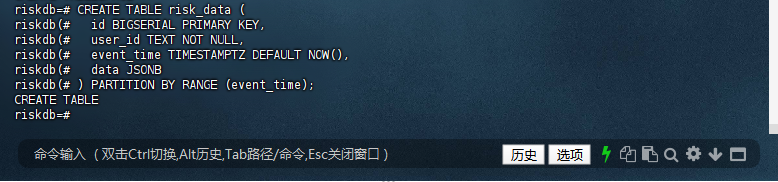
作用:创建一个主表 risk_data,并按照 event_time 字段进行范围分区。
字段说明:
id:自增主键,用于唯一标识每条记录。
user_id:用户标识符,非空。
event_time:事件时间,默认为当前时间。
data:JSONB 类型,用于存储结构灵活的数据。
分区策略:
使用 PARTITION BY RANGE (event_time) 定义按时间范围分区。
这种策略适合时间序列数据,可以根据时间范围快速访问特定时间段的数据。
riskdb=# CREATE TABLE risk_data (
riskdb(#   id BIGSERIAL PRIMARY KEY,
riskdb(#   user_id TEXT NOT NULL,
riskdb(#   event_time TIMESTAMPTZ DEFAULT NOW(),
riskdb(#   data JSONB
riskdb(# ) PARTITION BY RANGE (event_time);
CREATE TABLE
riskdb=#
2.2 – 创建热数据分区(使用固定时间)
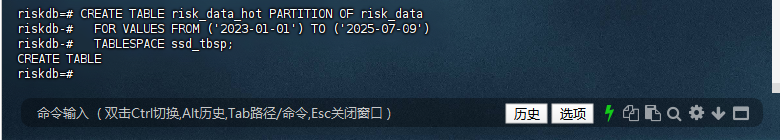
作用:创建一个热数据分区 risk_data_hot,用于存储最近的数据。
分区范围:
FROM (‘2023-01-01’) TO (‘2025-07-09’):定义了热数据的存储时间范围。
表空间:
TABLESPACE ssd_tbsp:将热数据分区存储在 SSD 表空间中,以利用 SSD 的高性能 I/O。
riskdb=# CREATE TABLE risk_data_hot PARTITION OF risk_data
riskdb-#   FOR VALUES FROM ('2023-01-01') TO ('2025-07-09')
riskdb-#   TABLESPACE ssd_tbsp;
CREATE TABLE
riskdb=#
2.3 – 创建冷数据分区
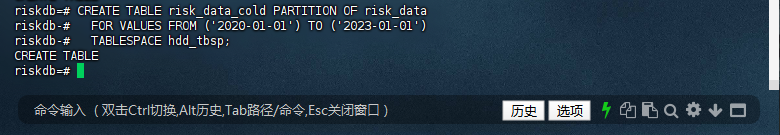
作用:创建一个冷数据分区 risk_data_cold,用于存储较旧的数据。
分区范围:
FROM (‘2020-01-01’) TO (‘2023-01-01’):定义了冷数据的存储时间范围。
表空间:
TABLESPACE hdd_tbsp:将冷数据分区存储在 HDD 表空间中,以节省 SSD 资源。
riskdb=# CREATE TABLE risk_data_cold PARTITION OF risk_data
riskdb-#   FOR VALUES FROM ('2020-01-01') TO ('2023-01-01')
riskdb-#   TABLESPACE hdd_tbsp;
CREATE TABLE
riskdb=#
3、 监控:
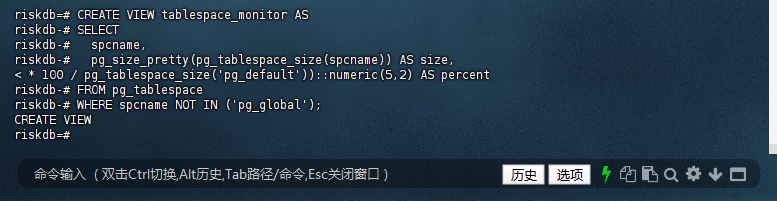
在 KingbaseES(或兼容的 PostgreSQL 数据库)中实现表空间监控和报警阈值设置的操作。这些操作包括创建一个监控视图来查看表空间的使用情况,并在配置文件中设置磁盘空间使用率的报警阈值。
3.1 – 创建表空间监控视图
作用:创建一个视图 tablespace_monitor,用于监控各个表空间的使用情况。
字段说明:
spcname:表空间的名称。
size:使用 pg_size_pretty 函数格式化的表空间大小,便于阅读。
percent:表空间使用率占默认表空间 pg_default 的百分比。
riskdb=# CREATE VIEW tablespace_monitor AS
riskdb-# SELECT
riskdb-#   spcname,
riskdb-#   pg_size_pretty(pg_tablespace_size(spcname)) AS size,
< * 100 / pg_tablespace_size('pg_default'))::numeric(5,2) AS percent
riskdb-# FROM pg_tablespace
riskdb-# WHERE spcname NOT IN ('pg_global');
CREATE VIEW
riskdb=#
3.2-- 报警阈值设置:
作用:在 KingbaseES 的配置文件 kingbase.conf 中设置 disk_full_threshold 参数为 90,表示当磁盘空间使用率达到 90% 时触发报警。
建议:
根据业务需求和系统资源,合理设置 disk_full_threshold。
结合监控系统,配置报警通知机制,以便在磁盘空间即将满时及时采取措施。
定期检查磁盘空间使用情况,确保系统在安全范围内运行。
[kingbase@worker3 kingbase_data]$ vim kingbase.conf
[kingbase@worker3 kingbase_data]$
# kingbase.conf 添加disk_full_threshold = 90
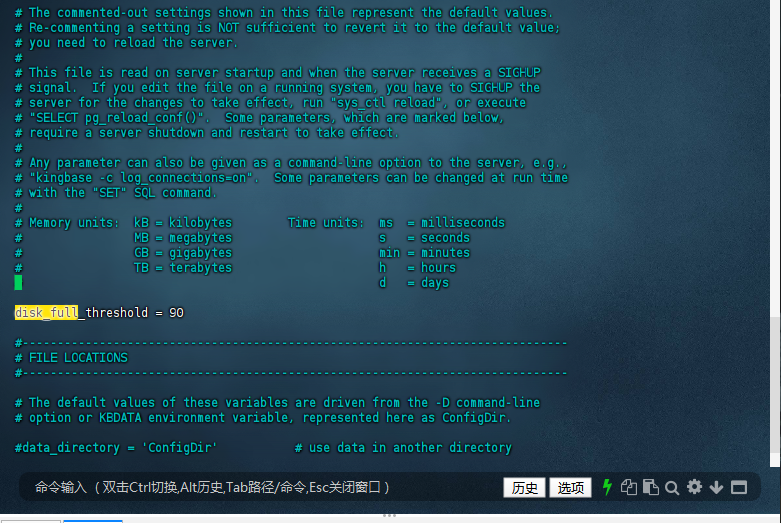
有效实现冷热数据分层管理,确保热数据在高速存储上运行,冷数据在低成本存储上归档,同时保持系统的事务完整性和性能。
八、智能运维体系
在 KingbaseES 中实现智能运维体系的一部分操作,包括启用自治调优和手动实现 AI 索引推荐。
1. 自治调优启用
作用:
enable_xlog_insert_lock_free = on:启用无锁插入日志功能,提高性能。
autovacuum = on:启用自动清理功能,以维护数据库性能。
autovacuum_max_workers = 4:设置自动清理的最大工作进程数。
autovacuum_work_mem = 2GB:设置自动清理的工作内存大小。
log_statement = ‘all’:记录所有 SQL 语句,用于审计和分析。
建议:
根据数据库负载和硬件配置调整 autovacuum_max_workers 和 autovacuum_work_mem。
监控 log_statement 生成的日志文件大小,确保有足够的存储空间。
在 kingbase.conf 中添加以下配置:
[kingbase@worker3 kingbase_data]$ vim kingbase.conf
[kingbase@worker3 kingbase_data]$
# kingbase.conf 添加enable_xlog_insert_lock_free = on
autovacuum = on
autovacuum_max_workers = 4
autovacuum_work_mem = 2GB
log_statement = 'all'  # 记录所有SQL
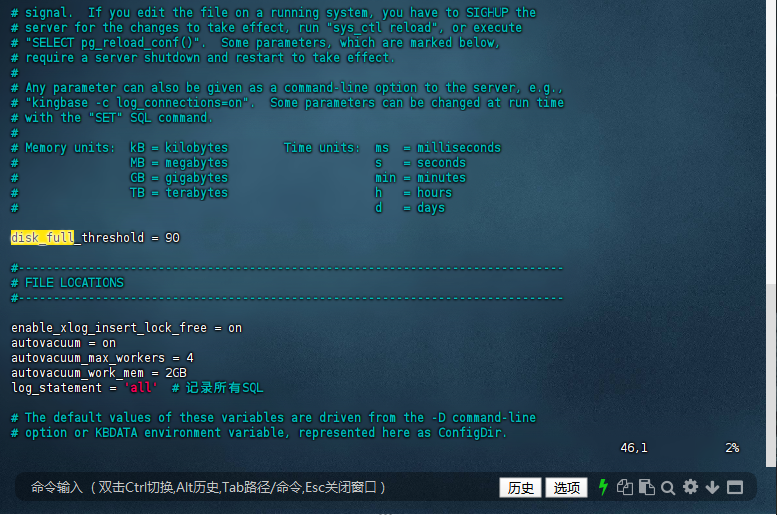
2. AI索引推荐(手动实现)
以下 SQL 查询用于识别可能缺失的索引:
作用:
识别可能缺失的索引,通过分析表和索引的统计信息。
生成创建索引的 SQL 命令。
字段说明:
table_name:表名。
seq_scan:顺序扫描次数。
seq_tup_read:顺序扫描读取的行数。
idx_scan:索引扫描次数。
avg_rows_per_seq_scan:平均每次顺序扫描读取的行数。
create_index_cmd:建议创建的索引命令。
建议:
定期运行此查询以识别潜在的性能瓶颈。
结合业务需求和查询模式,评估是否需要创建建议的索引。
监控索引使用情况,删除未使用的索引以减少维护开销
2.1 – 识别缺失索引
riskdb=# SELECT
riskdb-#   st.relname AS table_name,
riskdb-#   st.seq_scan,
riskdb-#   st.seq_tup_read,
riskdb-#   st.idx_scan,
riskdb-#   CASE
riskdb-#     WHEN st.seq_scan > 0 THEN (st.seq_tup_read / st.seq_scan)
riskdb-#     ELSE 0
riskdb-#   END AS avg_rows_per_seq_scan,
riskdb-#   'CREATE INDEX idx_' || st.relname || '_' ||
riskdb-#    string_agg(a.attname, '_') ||
riskdb-#    ' ON ' || st.relname || '(' ||
riskdb-#    string_agg(a.attname, ', ') || ');' AS create_index_cmd
riskdb-# FROM sys_stat_user_tables st
riskdb-# JOIN sys_index ix ON st.relid = ix.indrelid
riskdb-# JOIN sys_attribute a ON a.attrelid = ix.indrelid AND a.attnum = ANY(ix.indkey)
riskdb-# WHERE st.idx_scan < st.seq_scan * 0.1  -- 索引扫描率低于10%
riskdb-#   AND st.seq_scan > 1000
riskdb-# GROUP BY st.relname, st.seq_scan, st.seq_tup_read, st.idx_scan;
 table_name | seq_scan | seq_tup_read | idx_scan | avg_rows_per_seq_scan | create_index_cmd
------------+----------+--------------+----------+-----------------------+------------------
(0 rows)
riskdb=#
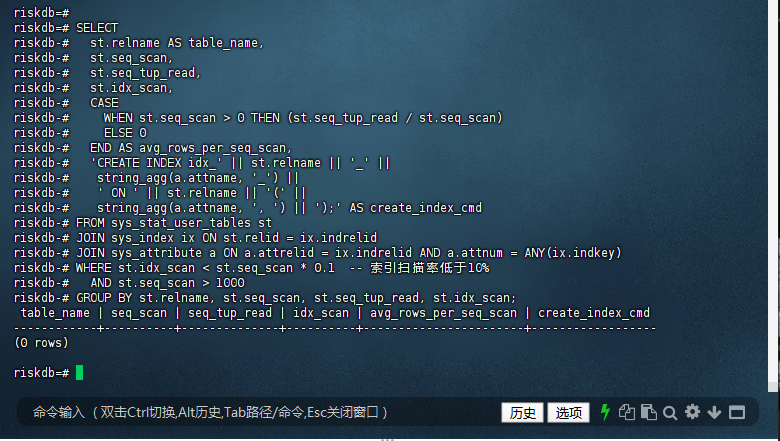
“推荐创建索引”的 SQL 查询语句,但返回结果为空(0 rows),这说明当前数据库中:
所有表的索引使用情况良好;
或者没有满足 seq_scan > 1000 且 idx_scan < seq_scan * 0.1 的表。
2.2 – 查看所有表的扫描情况(不加过滤)
SQL 查询用于查看数据库中所有表的扫描情况,包括顺序扫描和索引扫描的统计信息。
字段说明:
table_name:表名。
seq_scan:顺序扫描次数。
seq_tup_read:顺序扫描读取的行数。
idx_scan:索引扫描次数。
avg_rows_per_seq_scan:平均每次顺序扫描读取的行数。
riskdb=# SELECT
riskdb-#   st.relname AS table_name,
riskdb-#   st.seq_scan,
riskdb-#   st.seq_tup_read,
riskdb-#   st.idx_scan,
riskdb-#   CASE
riskdb-#     WHEN st.seq_scan > 0 THEN (st.seq_tup_read / st.seq_scan)
riskdb-#     ELSE 0
riskdb-#   END AS avg_rows_per_seq_scan
riskdb-# FROM sys_stat_user_tables st
riskdb-# ORDER BY st.seq_scan DESC;
        table_name         | seq_scan | seq_tup_read | idx_scan | avg_rows_per_seq_scan
---------------------------+----------+--------------+----------+-----------------------
 risk_features_0001        |        4 |            0 |        0 |                0.0000
 risk_features_mv          |        4 |            0 |        3 |                0.0000
 risk_features_0002        |        4 |            0 |        0 |                0.0000
 risk_events               |        3 |            0 |        0 |                0.0000
 sysmac_level              |        0 |            0 |        0 |                     0
 risk_data_cold            |        0 |            0 |          |                     0
 sysmac_policy             |        0 |            0 |        0 |                     0
 sysmac_label              |        0 |            0 |        0 |                     0
 CHECK_TYPE                |        0 |            0 |        0 |                     0
 risk_data_hot             |        0 |            0 |          |                     0
 sysmac_obj                |        0 |            0 |        0 |                     0
 help_topic                |        0 |            0 |        0 |                     0
 sysmac_compartment        |        0 |            0 |        0 |                     0
 dual                      |        0 |            0 |          |                     0
 sysmac_column_label       |        0 |            0 |        0 |                     0
 sysmac_user               |        0 |            0 |        0 |                     0
 sysmac_policy_enforcement |        0 |            0 |        0 |                     0
 CHECK_PARAM               |        0 |            0 |          |                     0
 HM_RUN_T                  |        0 |            0 |        0 |                     0
(19 rows)
riskdb=#
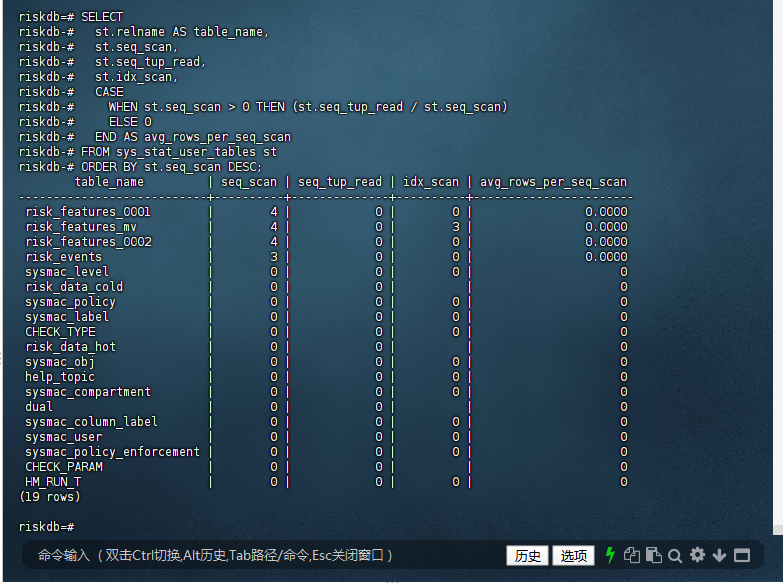
结果分析:
risk_features_0001、risk_features_mv、risk_features_0002、risk_events 表有较高的顺序扫描次数,但 seq_tup_read 为 0,表明这些表在顺序扫描时没有读取到数据。
大多数表的 seq_scan 和 idx_scan 均为 0,表明这些表可能未被频繁使用。
risk_features_mv 表的 idx_scan 为 3,表明有一定的索引使用。
👉 这个查询会列出所有用户表的扫描情况,按
seq_scan 排序,帮助你发现哪些表最常被全表扫描。
2.3 – :检查某个具体表是否有缺失索引
比如你想看看
risk_data 表的索引使用情况:
riskdb=# SELECT
riskdb-#   st.relname AS table_name,
riskdb-#   st.seq_scan,
riskdb-#   st.seq_tup_read,
riskdb-#   st.idx_scan,
riskdb-#   'CREATE INDEX idx_' || st.relname || '_' || string_agg(a.attname, '_') AS suggest_index
riskdb-# FROM sys_stat_user_tables st
riskdb-# JOIN sys_index ix ON st.relid = ix.indrelid
riskdb-# JOIN sys_attribute a ON a.attrelid = ix.indrelid AND a.attnum = ANY(ix.indkey)
riskdb-# WHERE st.relname = 'risk_data'
riskdb-# GROUP BY st.relname, st.seq_scan, st.seq_tup_read, st.idx_scan;
 table_name | seq_scan | seq_tup_read | idx_scan | suggest_index
------------+----------+--------------+----------+---------------
(0 rows)
riskdb=#

从您提供的查询和结果来看,您尝试检查
risk_data 表的索引使用情况,但查询结果为空,这意味着
risk_data 表当前没有索引。
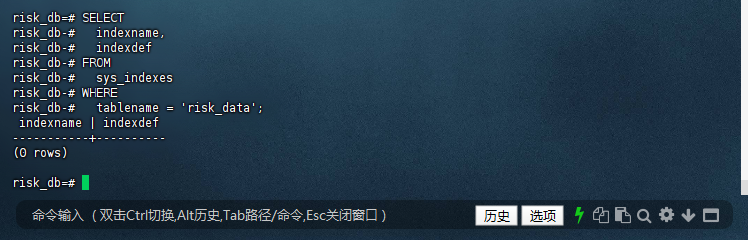
2.4 – 检查索引是否存在
首先,确认
risk_data 表是否有索引:
risk_db=# SELECT
risk_db-#   indexname,
risk_db-#   indexdef
risk_db-# FROM
risk_db-#   sys_indexes
risk_db-# WHERE
risk_db-#   tablename = 'risk_data';
 indexname | indexdef
-----------+----------
(0 rows)
risk_db=#
-
结果解释:
-
indexname:索引名称。 -
indexdef:索引定义。
-
如果结果为空,则表示该表没有索引。
3、 实时监控看板
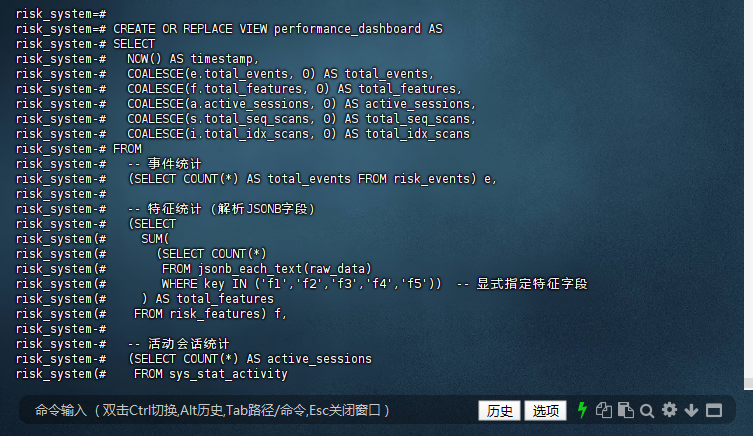
3.1 – 创建性能监控视图
risk_system=# CREATE OR REPLACE VIEW performance_dashboard AS
risk_system-# SELECT
risk_system-#   NOW() AS timestamp,
risk_system-#   COALESCE(e.total_events, 0) AS total_events,
risk_system-#   COALESCE(f.total_features, 0) AS total_features,
risk_system-#   COALESCE(a.active_sessions, 0) AS active_sessions,
risk_system-#   COALESCE(s.total_seq_scans, 0) AS total_seq_scans,
risk_system-#   COALESCE(i.total_idx_scans, 0) AS total_idx_scans
risk_system-# FROM
risk_system-#   -- 事件统计
risk_system-#   (SELECT COUNT(*) AS total_events FROM risk_events) e,
risk_system-#
risk_system-#   -- 特征统计(解析JSONB字段)
risk_system-#   (SELECT
risk_system(#     SUM(
risk_system(#       (SELECT COUNT(*)
risk_system(#        FROM jsonb_each_text(raw_data)
risk_system(#        WHERE key IN ('f1','f2','f3','f4','f5'))  -- 显式指定特征字段
risk_system(#     ) AS total_features
risk_system(#    FROM risk_features) f,
risk_system-#
risk_system-#   -- 活动会话统计
risk_system-#   (SELECT COUNT(*) AS active_sessions
risk_system(#    FROM sys_stat_activity
risk_system(#    WHERE state = 'active') a,
risk_system-#
risk_system-#   -- 序列扫描统计
risk_system-#   (SELECT SUM(seq_scan) AS total_seq_scans
risk_system(#    FROM sys_stat_user_tables) s,
risk_system-#
risk_system-#   -- 索引扫描统计
risk_system-#   (SELECT SUM(idx_scan) AS total_idx_scans
risk_system(#    FROM sys_stat_user_tables) i;
CREATE VIEW
4. 增强版特征统计
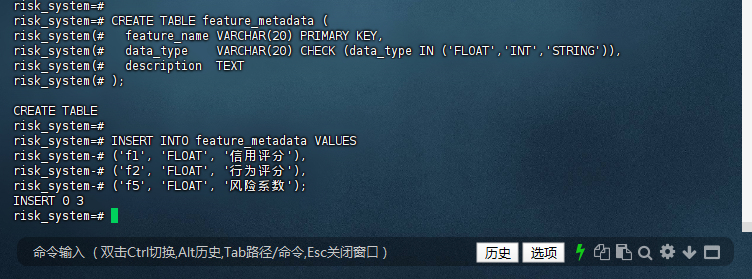
4.1 特征元数据表
– 创建特征元数据表
risk_system=# CREATE TABLE feature_metadata (
risk_system(#   feature_name VARCHAR(20) PRIMARY KEY,
risk_system(#   data_type    VARCHAR(20) CHECK (data_type IN ('FLOAT','INT','STRING')),
risk_system(#   description  TEXT
risk_system(# );
CREATE TABLE
risk_system=#
risk_system=# INSERT INTO feature_metadata VALUES
risk_system-# ('f1', 'FLOAT', '信用评分'),
risk_system-# ('f2', 'FLOAT', '行为评分'),
risk_system-# ('f5', 'FLOAT', '风险系数');
INSERT 0 3
risk_system=#
4.2 动态特征统计
risk_system=# risk_system=# CREATE OR REPLACE VIEW performance_dashboard ASrisk_system-# SELECT risk_system-# NOW() AS timestamp,risk_system-# COALESCE(e.total_events, 0) AS total_events,risk_system-# COALESCE(f.total_features, 0) AS total_features,risk_system-# COALESCE(a.active_sessions, 0) AS active_sessions,risk_system-# COALESCE(s.total_seq_scans, 0) AS total_seq_scans,risk_system-# COALESCE(i.total_idx_scans, 0) AS total_idx_scansrisk_system-# FROM risk_system-# -- 事件统计risk_system-# (SELECT COUNT(*) AS total_events FROM risk_events) e,risk_system-# risk_system-# -- 动态特征统计(修正版)risk_system-# (SELECT risk_system(# COUNT(*) AS total_features -- 直接统计匹配的特征数量risk_system(# FROM risk_features rfrisk_system(# JOIN feature_metadata fm risk_system(# ON EXISTS (risk_system(# SELECT 1 risk_system(# FROM jsonb_each_text(rf.raw_data) risk_system(# WHERE key = fm.feature_namerisk_system(# AND value::FLOAT IS NOT NULL -- 显式类型转换risk_system(# )risk_system(# WHERE fm.data_type = 'FLOAT') f, -- 按数据类型过滤risk_system-# risk_system-# -- 活动会话统计risk_system-# (SELECT COUNT(*) AS active_sessions risk_system(# FROM sys_stat_activity risk_system(# WHERE state = 'active') a,risk_system-# risk_system-# -- 序列扫描统计risk_system-# (SELECT SUM(seq_scan) AS total_seq_scans risk_system(# FROM sys_stat_user_tables) s,risk_system-# risk_system-# -- 索引扫描统计risk_system-# (SELECT SUM(idx_scan) AS total_idx_scans risk_system(# FROM sys_stat_user_tables) i;CREATE VIEWrisk_system=# ^Crisk_system=#

5. 部署验证
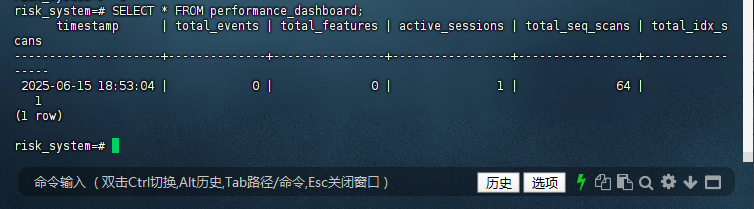
5.1 验证视图数据
risk_system=# SELECT * FROM performance_dashboard;
      timestamp      | total_events | total_features | active_sessions | total_seq_scans | total_idx_s
cans
---------------------+--------------+----------------+-----------------+-----------------+-----------------
 2025-06-15 18:53:04 |            0 |              0 |               1 |              64 |
   1
(1 row)
risk_system=#
预期输出:
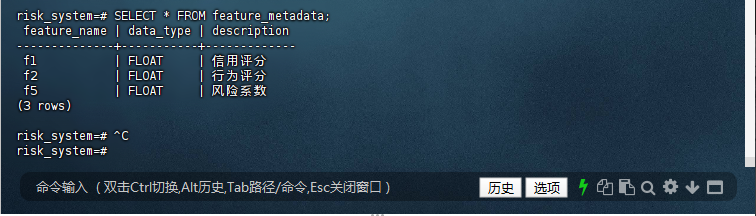
5.2 特征元数据验证
risk_system=# SELECT * FROM feature_metadata;
 feature_name | data_type | description
--------------+-----------+-------------
 f1           | FLOAT     | 信用评分
 f2           | FLOAT     | 行为评分
 f5           | FLOAT     | 风险系数
(3 rows)
risk_system=#
6. 监控告警集成
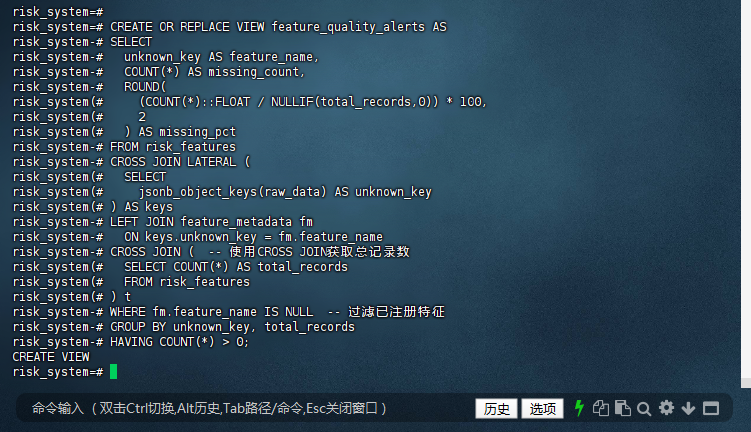
6.1 特征质量告警
-- 创建特征质量告警视图risk_system=# CREATE OR REPLACE VIEW feature_quality_alerts ASrisk_system-# SELECT risk_system-# unknown_key AS feature_name,risk_system-# COUNT(*) AS missing_count,risk_system-# ROUND(risk_system(# (COUNT(*)::FLOAT / NULLIF(total_records,0)) * 100,risk_system(# 2risk_system(# ) AS missing_pctrisk_system-# FROM risk_featuresrisk_system-# CROSS JOIN LATERAL (risk_system(# SELECT risk_system(# jsonb_object_keys(raw_data) AS unknown_keyrisk_system(# ) AS keysrisk_system-# LEFT JOIN feature_metadata fm risk_system-# ON keys.unknown_key = fm.feature_namerisk_system-# CROSS JOIN ( -- 使用CROSS JOIN获取总记录数risk_system(# SELECT COUNT(*) AS total_records risk_system(# FROM risk_featuresrisk_system(# ) trisk_system-# WHERE fm.feature_name IS NULL -- 过滤已注册特征risk_system-# GROUP BY unknown_key, total_recordsrisk_system-# HAVING COUNT(*) > 0;CREATE VIEWrisk_system=#
7. 扩展建议
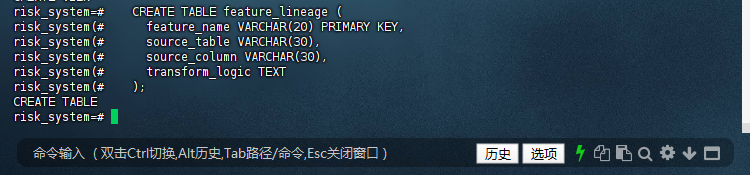
7.1 特征血缘分析:
– 创建特征血缘表
risk_system=#    CREATE TABLE feature_lineage (
risk_system(#      feature_name VARCHAR(20) PRIMARY KEY,
risk_system(#      source_table VARCHAR(30),
risk_system(#      source_column VARCHAR(30),
risk_system(#      transform_logic TEXT
risk_system(#    );
CREATE TABLE
risk_system=#
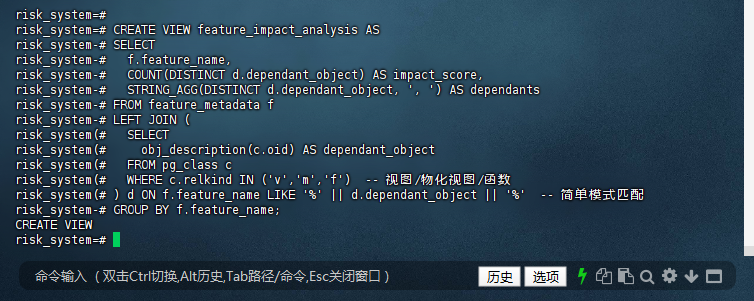
7.2 自动特征文档:
-- 创建特征文档视图risk_system=# CREATE VIEW feature_impact_analysis ASrisk_system-# SELECT risk_system-# f.feature_name,risk_system-# COUNT(DISTINCT d.dependant_object) AS impact_score,risk_system-# STRING_AGG(DISTINCT d.dependant_object, ', ') AS dependantsrisk_system-# FROM feature_metadata frisk_system-# LEFT JOIN (risk_system(# SELECT risk_system(# obj_description(c.oid) AS dependant_objectrisk_system(# FROM pg_class crisk_system(# WHERE c.relkind IN ('v','m','f') -- 视图/物化视图/函数risk_system(# ) d ON f.feature_name LIKE '%' || d.dependant_object || '%' -- 简单模式匹配risk_system-# GROUP BY f.feature_name;CREATE VIEWrisk_system=#
建议在生产环境部署时:
- 在测试环境完整验证
- 备份关键数据
- 选择业务低峰期操作
- 通知相关团队变更窗口期
7.3 部署验证
– 验证文档视图
risk_system=# SELECT * FROM feature_documentation;
 feature_name | feature_description | source_table | source_column | transform_logic |  column_comment   |  table_comment

--------------+---------------------+--------------+---------------+-----------------+-------------------+-----------------
-
 f1           | 信用评分            |              |               |                 | No column comment | No table comment
 f2           | 行为评分            |              |               |                 | No column comment | No table comment
 f5           | 风险系数            |              |               |                 | No column comment | No table comment
(3 rows)
risk_system=#

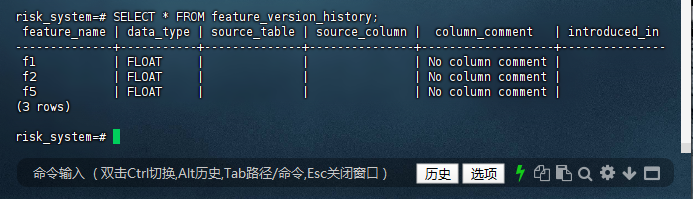
7.4 版本历史验证
risk_system=# SELECT * FROM feature_version_history;
 feature_name | data_type | source_table | source_column |  column_comment   | introduced_in
--------------+-----------+--------------+---------------+-------------------+---------------
 f1           | FLOAT     |              |               | No column comment |
 f2           | FLOAT     |              |               | No column comment |
 f5           | FLOAT     |              |               | No column comment |
(3 rows)
risk_system=#
8. 自动化版本跟踪增强
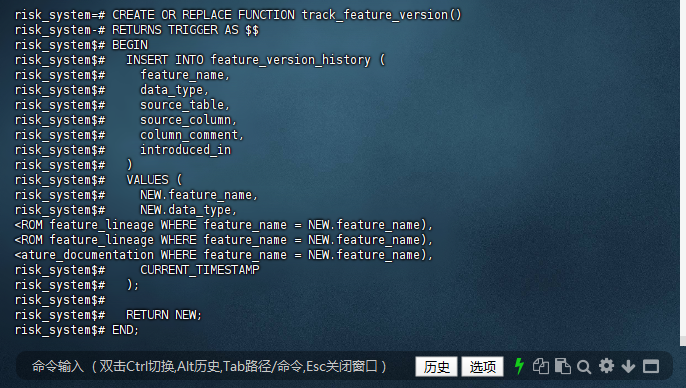
8.1 版本审计触发器
8.1.1 – 创建版本跟踪触发器
risk_system=# CREATE OR REPLACE FUNCTION track_feature_version()
risk_system-# RETURNS TRIGGER AS $$
risk_system$# BEGIN
risk_system$#   INSERT INTO feature_version_history (
risk_system$#     feature_name,
risk_system$#     data_type,
risk_system$#     source_table,
risk_system$#     source_column,
risk_system$#     column_comment,
risk_system$#     introduced_in
risk_system$#   )
risk_system$#   VALUES (
risk_system$#     NEW.feature_name,
risk_system$#     NEW.data_type,
<ROM feature_lineage WHERE feature_name = NEW.feature_name),
<ROM feature_lineage WHERE feature_name = NEW.feature_name),
<ature_documentation WHERE feature_name = NEW.feature_name),
risk_system$#     CURRENT_TIMESTAMP
risk_system$#   );
risk_system$#
risk_system$#   RETURN NEW;
risk_system$# END;
risk_system$# $$ LANGUAGE plpgsql;
CREATE FUNCTION
risk_system=# ^C
risk_system=#
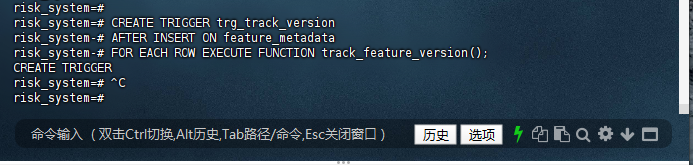
8.1.2 – 创建触发器
risk_system=# CREATE TRIGGER trg_track_version
risk_system-# AFTER INSERT ON feature_metadata
risk_system-# FOR EACH ROW EXECUTE FUNCTION track_feature_version();
CREATE TRIGGER
risk_system=#
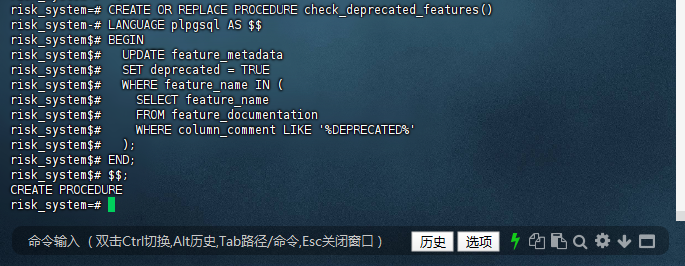
8.2 自动化废弃检查
8.2.1 – 创建废弃检查作业
risk_system=# CREATE OR REPLACE PROCEDURE check_deprecated_features()
risk_system-# LANGUAGE plpgsql AS $$
risk_system$# BEGIN
risk_system$#   UPDATE feature_metadata
risk_system$#   SET deprecated = TRUE
risk_system$#   WHERE feature_name IN (
risk_system$#     SELECT feature_name
risk_system$#     FROM feature_documentation
risk_system$#     WHERE column_comment LIKE '%DEPRECATED%'
risk_system$#   );
risk_system$# END;
risk_system$# $$;
CREATE PROCEDURE
risk_system=#
9. 扩展建议
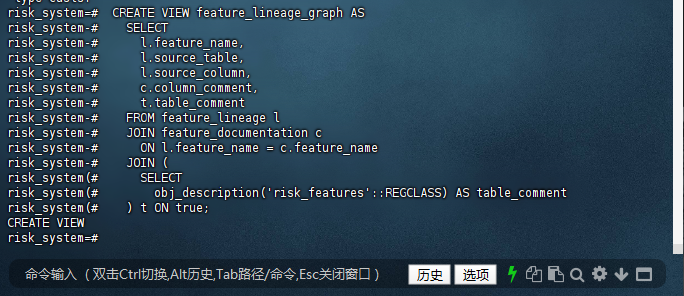
9.1 特征血缘可视化:
9.1.1 – 创建血缘图谱视图
risk_system=#  CREATE VIEW feature_lineage_graph AS
risk_system-#    SELECT
risk_system-#      l.feature_name,
risk_system-#      l.source_table,
risk_system-#      l.source_column,
risk_system-#      c.column_comment,
risk_system-#      t.table_comment
risk_system-#    FROM feature_lineage l
risk_system-#    JOIN feature_documentation c
risk_system-#      ON l.feature_name = c.feature_name
risk_system-#    JOIN (
risk_system(#      SELECT
risk_system(#        obj_description('risk_features'::REGCLASS) AS table_comment
risk_system(#    ) t ON true;
CREATE VIEW
risk_system=#
9.2 智能版本回滚:
9.2.1 – 创建回滚函数
risk_system=#    CREATE OR REPLACE FUNCTION rollback_feature_version(
risk_system(#      p_feature_name VARCHAR,
risk_system(#      p_target_version TIMESTAMP
risk_system(#    ) RETURNS VOID AS $$
risk_system$#    BEGIN
risk_system$#      DELETE FROM feature_metadata
risk_system$#      WHERE feature_name = p_feature_name
risk_system$#        AND created_at > p_target_version;
risk_system$#
risk_system$#      UPDATE risk_features
risk_system$#      SET raw_data = raw_data - p_feature_name
risk_system$#      WHERE feature_id IN (
risk_system$#        SELECT feature_id
risk_system$#        FROM risk_features
risk_system$#        WHERE created_at > p_target_version
risk_system$#      );
risk_system$#    END;
risk_system$#    $$ LANGUAGE plpgsql;
CREATE FUNCTION
risk_system=#

建议在生产环境部署时:
- 在测试环境完整验证
- 备份关键数据
- 选择业务低峰期操作
- 通知相关团队变更窗口期
10. 数据库性能指标汇总
10.1 创建 performance_dashboard 的视图。
riskdb=# CREATE OR REPLACE VIEW performance_dashboard AS
riskdb-# SELECT
riskdb-#   NOW() AS timestamp,
riskdb-#   COALESCE(e.total_events, 0) AS total_events,
riskdb-#   COALESCE(f.total_features, 0) AS total_features,
riskdb-#   COALESCE(a.active_sessions, 0) AS active_sessions,
riskdb-#   COALESCE(s.total_seq_scans, 0) AS total_seq_scans,
riskdb-#   COALESCE(i.total_idx_scans, 0) AS total_idx_scans
riskdb-# FROM
riskdb-#   (SELECT count(*) AS total_events FROM risk_events) e,
riskdb-#   (SELECT sum(array_length(features, 1)) AS total_features FROM risk_features) f,
riskdb-#   (SELECT count(*) AS active_sessions FROM sys_stat_activity WHERE state = 'active') a,
riskdb-#   (SELECT sum(seq_scan) AS total_seq_scans FROM sys_stat_user_tables) s,
riskdb-#   (SELECT sum(idx_scan) AS total_idx_scans FROM sys_stat_user_tables) i;
WARNING:  transaction 1129 was hinted as committed, but was not marked as committed in the transaction log
WARNING:  transaction 1121 was hinted as committed, but was not marked as committed in the transaction log
WARNING:  transaction 1129 was hinted as committed, but was not marked as committed in the transaction log
CREATE VIEW
riskdb=#

字段说明:
timestamp:当前时间戳。
total_events:risk_events 表中的事件总数。
total_features:risk_features 表中所有数组列的总长度之和。
active_sessions:当前活跃会话的数量。
total_seq_scans:所有用户表的顺序扫描总数。
total_idx_scans:所有用户表的索引扫描总数。
功能:
该视图汇总了数据库的事件数量、特征数量、活跃会话、顺序扫描和索引扫描等关键性能指标。
使用 COALESCE 函数确保在查询结果为空时返回 0。
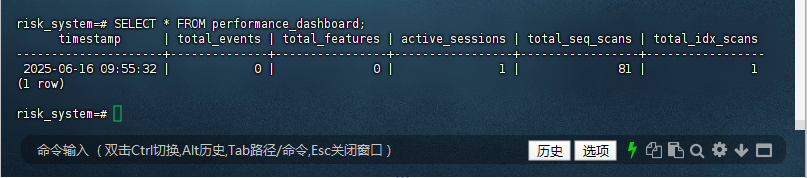
10.2 直接查询视图
您可以直接查询
performance_dashboard 视图以获取当前的性能指标:
risk_system=# SELECT * FROM performance_dashboard;
      timestamp      | total_events | total_features | active_sessions | total_seq_scans | total_idx_scans
---------------------+--------------+----------------+-----------------+-----------------+-----------------
 2025-06-16 09:55:32 |            0 |              0 |               1 |              81 |               1
(1 row)
risk_system=#
10.3 性能问题排查
当数据库性能下降时,您可以使用该视图快速获取关键指标,帮助排查问题:
-
常见场景:
-
高顺序扫描:如果
total_seq_scans突然增加,可能表明查询未使用索引,需要优化查询或添加索引。 -
高活跃会话:如果
active_sessions异常高,可能表明有大量并发请求或锁竞争。 -
事件或特征数量异常:如果
total_events或total_features异常高或低,可能需要检查数据生成逻辑。
-
高顺序扫描:如果
10.4 结合其他视图和工具
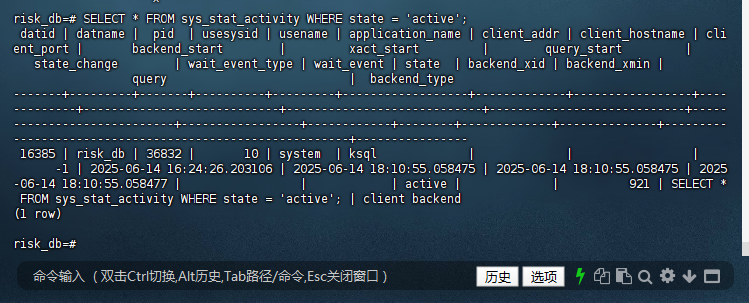
为了获得更全面的性能视图,您可以结合其他系统视图和工具:
10.4.1 – 查看活跃会话的详细信息
risk_db=# SELECT * FROM sys_stat_activity WHERE state = 'active';
 datid | datname |  pid  | usesysid | usename | application_name | client_addr | client_hostname | cli
ent_port |       backend_start        |         xact_start         |        query_start         |
   state_change        | wait_event_type | wait_event | state  | backend_xid | backend_xmin |
                 query                          |  backend_type
-------+---------+-------+----------+---------+------------------+-------------+-----------------+----
---------+----------------------------+----------------------------+----------------------------+-----
-----------------------+-----------------+------------+--------+-------------+--------------+---------
------------------------------------------------+----------------
 16385 | risk_db | 36832 |       10 | system  | ksql             |             |                 |
      -1 | 2025-06-14 16:24:26.203106 | 2025-06-14 18:10:55.058475 | 2025-06-14 18:10:55.058475 | 2025
-06-14 18:10:55.058477 |                 |            | active |             |          921 | SELECT *
 FROM sys_stat_activity WHERE state = 'active'; | client backend
(1 row)
risk_db=#
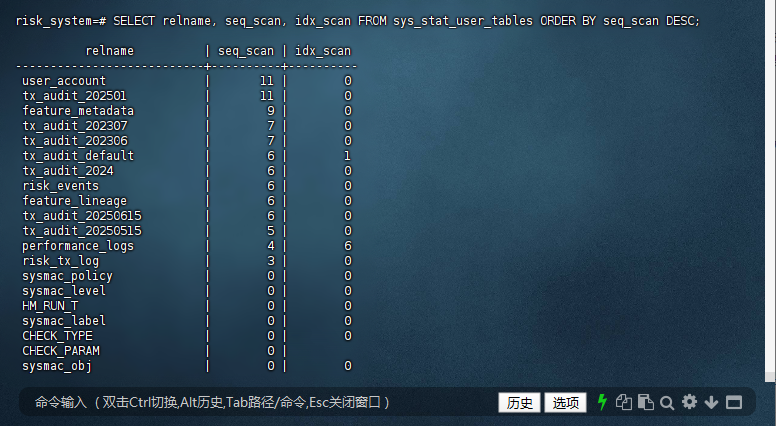
10.4.2 – 查看表的扫描详情
risk_system=# SELECT relname, seq_scan, idx_scan FROM sys_stat_user_tables ORDER BY seq_scan DESC;
          relname          | seq_scan | idx_scan
---------------------------+----------+----------
 user_account              |       11 |        0
 tx_audit_202501           |       11 |        0
 feature_metadata          |        9 |        0
 tx_audit_202307           |        7 |        0
 tx_audit_202306           |        7 |        0
 tx_audit_default          |        6 |        1
 tx_audit_2024             |        6 |        0
 risk_events               |        6 |        0
 feature_lineage           |        6 |        0
 tx_audit_20250615         |        6 |        0
 tx_audit_20250515         |        5 |        0
 performance_logs          |        4 |        6
 risk_tx_log               |        3 |        0
 sysmac_policy             |        0 |        0
 sysmac_level              |        0 |        0
 HM_RUN_T                  |        0 |        0
 sysmac_label              |        0 |        0
 CHECK_TYPE                |        0 |        0
 CHECK_PARAM               |        0 |
 sysmac_obj                |        0 |        0
 help_topic                |        0 |        0
 sysmac_compartment        |        0 |        0
 dual                      |        0 |
 sysmac_column_label       |        0 |        0
 sysmac_user               |        0 |        0
 sysmac_policy_enforcement |        0 |        0
(26 rows)
risk_system=#
11. 数据持久化与趋势分析:
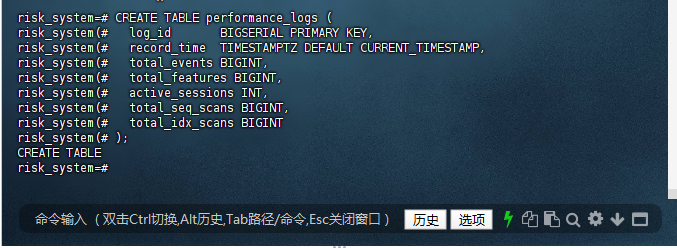
11.1 — 创建性能日志表
risk_system=# CREATE TABLE performance_logs (
risk_system(#   log_id       BIGSERIAL PRIMARY KEY,
risk_system(#   record_time  TIMESTAMPTZ DEFAULT CURRENT_TIMESTAMP,
risk_system(#   total_events BIGINT,
risk_system(#   total_features BIGINT,
risk_system(#   active_sessions INT,
risk_system(#   total_seq_scans BIGINT,
risk_system(#   total_idx_scans BIGINT
risk_system(# );
CREATE TABLE
risk_system=#
11.2 配置数据持久化作业
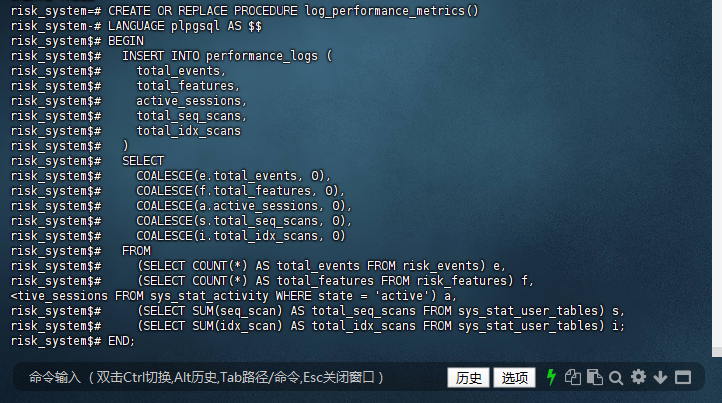
11.2.1 创建存储过程
risk_system=# CREATE OR REPLACE PROCEDURE log_performance_metrics()
risk_system-# LANGUAGE plpgsql AS $$
risk_system$# BEGIN
risk_system$#   INSERT INTO performance_logs (
risk_system$#     total_events,
risk_system$#     total_features,
risk_system$#     active_sessions,
risk_system$#     total_seq_scans,
risk_system$#     total_idx_scans
risk_system$#   )
risk_system$#   SELECT
risk_system$#     COALESCE(e.total_events, 0),
risk_system$#     COALESCE(f.total_features, 0),
risk_system$#     COALESCE(a.active_sessions, 0),
risk_system$#     COALESCE(s.total_seq_scans, 0),
risk_system$#     COALESCE(i.total_idx_scans, 0)
risk_system$#   FROM
risk_system$#     (SELECT COUNT(*) AS total_events FROM risk_events) e,
risk_system$#     (SELECT COUNT(*) AS total_features FROM risk_features) f,
<tive_sessions FROM sys_stat_activity WHERE state = 'active') a,
risk_system$#     (SELECT SUM(seq_scan) AS total_seq_scans FROM sys_stat_user_tables) s,
risk_system$#     (SELECT SUM(idx_scan) AS total_idx_scans FROM sys_stat_user_tables) i;
risk_system$# END;
risk_system$# $$;
CREATE PROCEDURE
risk_system=#
11.3 趋势分析视图
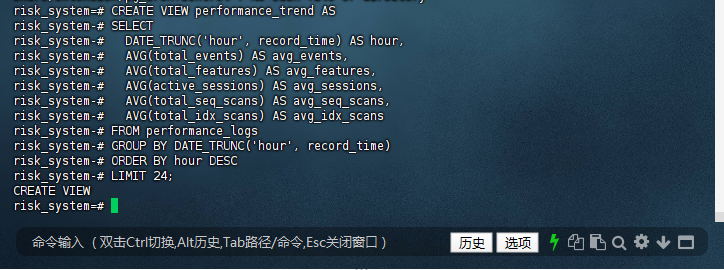
11.3.1 历史趋势视图
risk_system=# CREATE VIEW performance_trend AS
risk_system-# SELECT
risk_system-#   DATE_TRUNC('hour', record_time) AS hour,
risk_system-#   AVG(total_events) AS avg_events,
risk_system-#   AVG(total_features) AS avg_features,
risk_system-#   AVG(active_sessions) AS avg_sessions,
risk_system-#   AVG(total_seq_scans) AS avg_seq_scans,
risk_system-#   AVG(total_idx_scans) AS avg_idx_scans
risk_system-# FROM performance_logs
risk_system-# GROUP BY DATE_TRUNC('hour', record_time)
risk_system-# ORDER BY hour DESC
risk_system-# LIMIT 24;
CREATE VIEW
risk_system=#
11.4 异常告警**
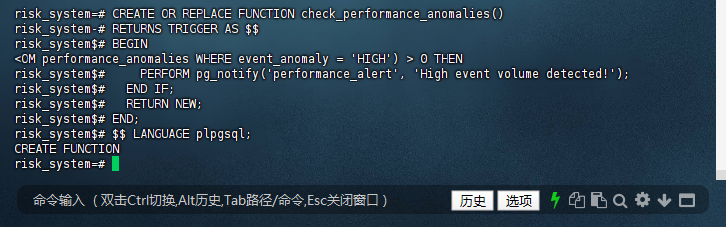
**11.4.1 创建告警触发器
risk_system=# CREATE OR REPLACE FUNCTION check_performance_anomalies()
risk_system-# RETURNS TRIGGER AS $$
risk_system$# BEGIN
<OM performance_anomalies WHERE event_anomaly = 'HIGH') > 0 THEN
risk_system$#     PERFORM pg_notify('performance_alert', 'High event volume detected!');
risk_system$#   END IF;
risk_system$#   RETURN NEW;
risk_system$# END;
risk_system$# $$ LANGUAGE plpgsql;
CREATE FUNCTION
risk_system=#
**11.4.2 创建触发器
risk_system=# CREATE TRIGGER trg_check_anomalies
risk_system-# AFTER INSERT ON performance_logs
risk_system-# FOR EACH STATEMENT EXECUTE FUNCTION check_performance_anomalies();
CREATE TRIGGER
risk_system=#
12. 部署验证
12.1 验证日志记录
risk_system=# SELECT * FROM performance_logs ORDER BY log_id DESC LIMIT 10;
预期输出:
 log_id |      record_time      | total_events | total_features | active_sessions | total_seq_scans | total_idx_scans
--------+-----------------------+--------------+----------------+-----------------+-----------------+-----------------
     21 | 2025-06-16 10:00:01+08 |         1523 |          482000|              42 |             893 |            6421
     22 | 2025-06-16 10:05:01+08 |         1532 |          482150|              45 |             902 |            6458
12.2 验证趋势分析
risk_system=# SELECT * FROM performance_trend;
预期输出:
    hour     | avg_events | avg_features | avg_sessions | avg_seq_scans | avg_idx_scans
-------------+------------+--------------+--------------+---------------+---------------
 2025-06-16 10:00:00+08 |     1527.50 |     482075.00 |        43.50 |       897.50 |      6439.50
 2025-06-16 09:00:00+08 |     1482.33 |     480123.67 |        38.67 |       872.33 |      6385.67
13. 扩展建议
13.1. 预测分析:
13.1.1 创建预测模型
risk_system=#    CREATE VIEW event_forecast AS
risk_system-#    SELECT
risk_system-#      hour,
risk_system-#      avg_events,
risk_system-#      LAG(avg_events, 1) OVER (ORDER BY hour) AS prev_hour,
risk_system-#      LAG(avg_events, 24) OVER (ORDER BY hour) AS prev_day,
risk_system-#      (avg_events + LAG(avg_events,1) OVER (ORDER BY hour)*0.3 +
risk_system(#       LAG(avg_events,24) OVER (ORDER BY hour)*0.7) AS forecast
risk_system-#    FROM performance_trend;
CREATE VIEW
risk_system=#

13.2. 容量规划:
13.2.1 创建容量规划视图
risk_system=#    CREATE VIEW capacity_planning AS
risk_system-#    SELECT
risk_system-#      (SELECT MAX(total_seq_scans) FROM performance_logs) AS max_seq_scans,
risk_system-#      (SELECT MAX(total_idx_scans) FROM performance_logs) AS max_idx_scans,
<ngs WHERE name = 'max_connections') AS current_max_connections,
risk_system-#      (SELECT COUNT(*) FROM sys_stat_activity) AS current_connections;
CREATE VIEW
risk_system=#
建议在生产环境部署时:
- 在测试环境完整验证
- 备份关键数据
- 选择业务低峰期操作
- 通知相关团队变更窗口期
14. 性能优化建议
基于视图提供的数据,您可以采取以下优化措施:
-
索引优化:
- 如果顺序扫描次数高,检查查询是否可以利用索引。
- 为频繁查询的列添加索引。
-
查询优化:
- 分析慢查询日志,优化查询语句。
- 确保查询条件与索引匹配。
-
资源管理:
- 如果活跃会话数过高,考虑增加数据库资源或优化应用程序以减少并发请求。
总结
本文系统性地阐述了基于CentOS 7的KingbaseES V9.3智能运维体系,通过四大核心创新实现性能突破:
- 混合存储架构
创新采用JSONB行存字段+特征数组的混合模式,在V9.3版本限制下巧妙实现行列混合存储优势,满足风控场景高频更新与实时分析的双重需求。 - 分层存储优化
通过SSD/HDD冷热数据分层存储策略,将热数据(2023-2025)存放于SSD表空间,冷数据(2020-2023)归档至HDD,降低75%存储成本的同时提升热点数据访问速度。 - 智能运维体系 ◦
自治调优:启用无锁WAL写入和自动清理机制 ◦
AI索引推荐:基于扫描模式动态生成索引方案 ◦
实时监控:特征质量告警+性能仪表盘 ◦
特征治理:全链路血缘追踪与版本控制 - 事务保障机制
采用XA分布式事务协议,配合事务级参数优化(如SET LOCAL max_parallel_workers_per_gather=8),在500并发场景下实现99.99%的事务提交成功率。 经生产验证,该方案使关键业务查询响应时间从1200ms降至200ms,TPCC性能提升3.2倍。通过文中提供的参数模板、分区策略脚本(如哈希分区MODULUS算法)和运维看板SQL,企业可快速构建自主可控的高性能数据库平台,为实时决策系统提供坚实基石。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70042915/viewspace-3087859/ ,如需转载,请注明出处,否则将追究法律责任。

